דלג לתוכן

בשוק, הסיכונים מתמקדים בהכרח בשתי שאלות בסיסיות מרכזיות: מי זה, ועד כמה אנו בטוחים שהפעולה הזו לגיטימית? הנה כמה דוגמאות למה שאנו מתכוונים: נציג תמיכה הבוחן בקשת החזר צריך לדעת את התשובות לשאלות אלה. מנוע קידום מכירות שמחליט אם להאריך הצעה לא יכול להמשיך ללא מידע זה. מערכת למניעת בוטים שבודקת ניסיון כניסה לאיתור תנועה אוטומטית נחסמת ללא נתונים אלה. הפרטים הספציפיים משתנים — הערוץ, האות, הסף — אך השאלות המרכזיות נותרות זהות. 

אמנם שאלות אלו אינן חדשות, אך הבינה המלאכותית מפעילה לחץ הולך וגובר משני צדי המשוואה; אותן התקדמויות שמקלות על יצירת התנהגות מזויפת ומשכנעת בקנה מידה נרחב, מאפשרות גם לזהות את השחקנים באמצעות סימנים מפורטים יותר מאי-פעם.

עם זאת, הזהות מעולם לא טופלה כיכולת אופקית בפני עצמה. במקום זאת, מרבית המערכות נבנו מתוך תפיסה של "המוצר תחילה" — מנוע סיכונים להזמנות, מודל למיקוד מבצעים או כלל לזיהוי השתלטות על חשבונות. כל אחד מהם עונה באופן מרומז על גרסה כלשהי של השאלה "מי זה?" למטרותיו שלו, אך אף אחד מהם אינו חולק את התשובה הזו עם האחרים. כתוצאה מכך נוצרת סדרה של תמונת מצב חלקית של אותו אדם, שכל אחת מהן מדויקת למטרתה אך מנותקת בתוך המערכת שלה.

בינה זהותית יוצאת מנקודת הנחה שונה: אם השאלה משותפת, גם האות המשיב עליה צריך להיות משותף. זוהי בעיה ברמת הפלטפורמה — הנפתרת פעם אחת, באופן מרכזי — והיא נבדלת מהאופן שבו כל מערכת בוחרת לפעול על סמך התשובה, אשר נראה שונה בהתאם למקום שבו היא מיושמת. כאשר מתייחסים לזהות כאל יכולת אופקית מהמעלה הראשונה — ולא כתוצר לוואי של מוצר כלשהו — היא הופכת לחוט מקשר המשתלשל כמעט בכל מקרה שימוש בתחום שלמות הנתונים. זו התזה המרכזית שלנו כאן: הזהות היא אחת היכולות בעלות ההשפעה הגדולה ביותר, אך הפחות מוערכות בתחום שלמות הנתונים, דווקא משום שאף אחד לא בונה אותה כישות עצמאית.

הזהות באה לידי ביטוי במלוא עוצמתה

אם השאלה "מי זה?" היא כה אוניברסלית, מדוע זהות לא טופלה כאלמנט תשתיתי מרכזי מלכתחילה?

בעבר, כל ממשק של שלמות נתונים — סיכון הזמנות, סיכון חשבונות או סיכון מבצעים — פתר תחילה את הבעיה שלו בדרכו שלו, באמצעות אותות המכשיר, לוגיקת הקישור וההגדרה המעשית שלו ל"אותו אדם". כך נוטים לפתור בעיות ייעודיות: עם כלל כאן ומודל שם, שכל אחד מהם תוכנן למטרה ספציפית וניתן ליישום מהיר. שכבת זהות משותפת היא סוג שונה של השקעה: היא אינה שייכת לאף משטח בודד, ולכן אף משטח אינו ממוקם באופן טבעי לבנות אותה, אף על פי שכל אחד מהם ירוויח מכך.

התוצאה עד כה הייתה אות זיהוי שאינו ניתן לשימוש חוזר "מהמדף". כל צוות חדש שביקש את התשובה הזו נאלץ להטמיע אותה מאפס באמצעות אינטגרציה מותאמת אישית וחד-פעמית, במקום להתחבר לממשק סטנדרטי. במשך שנים, אותות זיהוי היו קיימים בכל מקום אך לא היו בבעלות אף אחד; כל צוות שילם כדי להפיק מחדש תשובה חלקית, בעוד שאף אחד לא ניצל את הערך המצטבר הטמון במענה חד-פעמי על השאלה ובשיתופה.

הקמת פלטפורמת מודיעין זהות

ב-DoorDash החלטנו לגשר על הפער הזה באמצעות תכנון תשתית חדשה. במקום שכל מערכת תבנה לוגיקת קישור משלה על בסיס האותות שלה, רצינו שהזהות תהפוך למשהו שנבנה פעם אחת ומשמש בכל מקום.

בפועל, משמעות הדבר הייתה בניית שלוש שכבות על גבי מאגר אותות משותף אחד:

  • ראשית, זיהוי זהויות: גרף לזיהוי ישויות הכולל למעלה ממיליארד קשתות, שנבנה ברובו באמצעות טכניקות של קיבוץ בלתי מונחה וחיזוי קישורים, ובוחן אילו חשבונות עשויים להיות של אותה אישיות. 
  • שנית, אינטליגנציית יחסים: שאלה גרפית הקשורה אך שונה: אילו אנשים, חשבונות, מכשירים ונכסים קשורים זה לזה? רובד זה מכיר בכך ששני חשבונות יכולים להיות קשורים זה לזה באופן משמעותי מבלי להיות שייכים לאותו אדם. 
  • שלישית, מודלים לקבלת החלטות: לרוב מדובר במודלים של למידה מונחית, כגון מסווגים המבוססים על שיטת "גרדיאנט בוסט" (gradient-boosted), שהוכשרו על סמך תוצאות ידועות עבור מקרה שימוש ספציפי. שכבה זו משתמשת בשתי השכבות הראשונות כדי להחזיר תשובה בזמן אמת לשאלה: האם אירוע מסוים זה, בהקשר להחלטה הספציפית הזו, הוא לגיטימי?
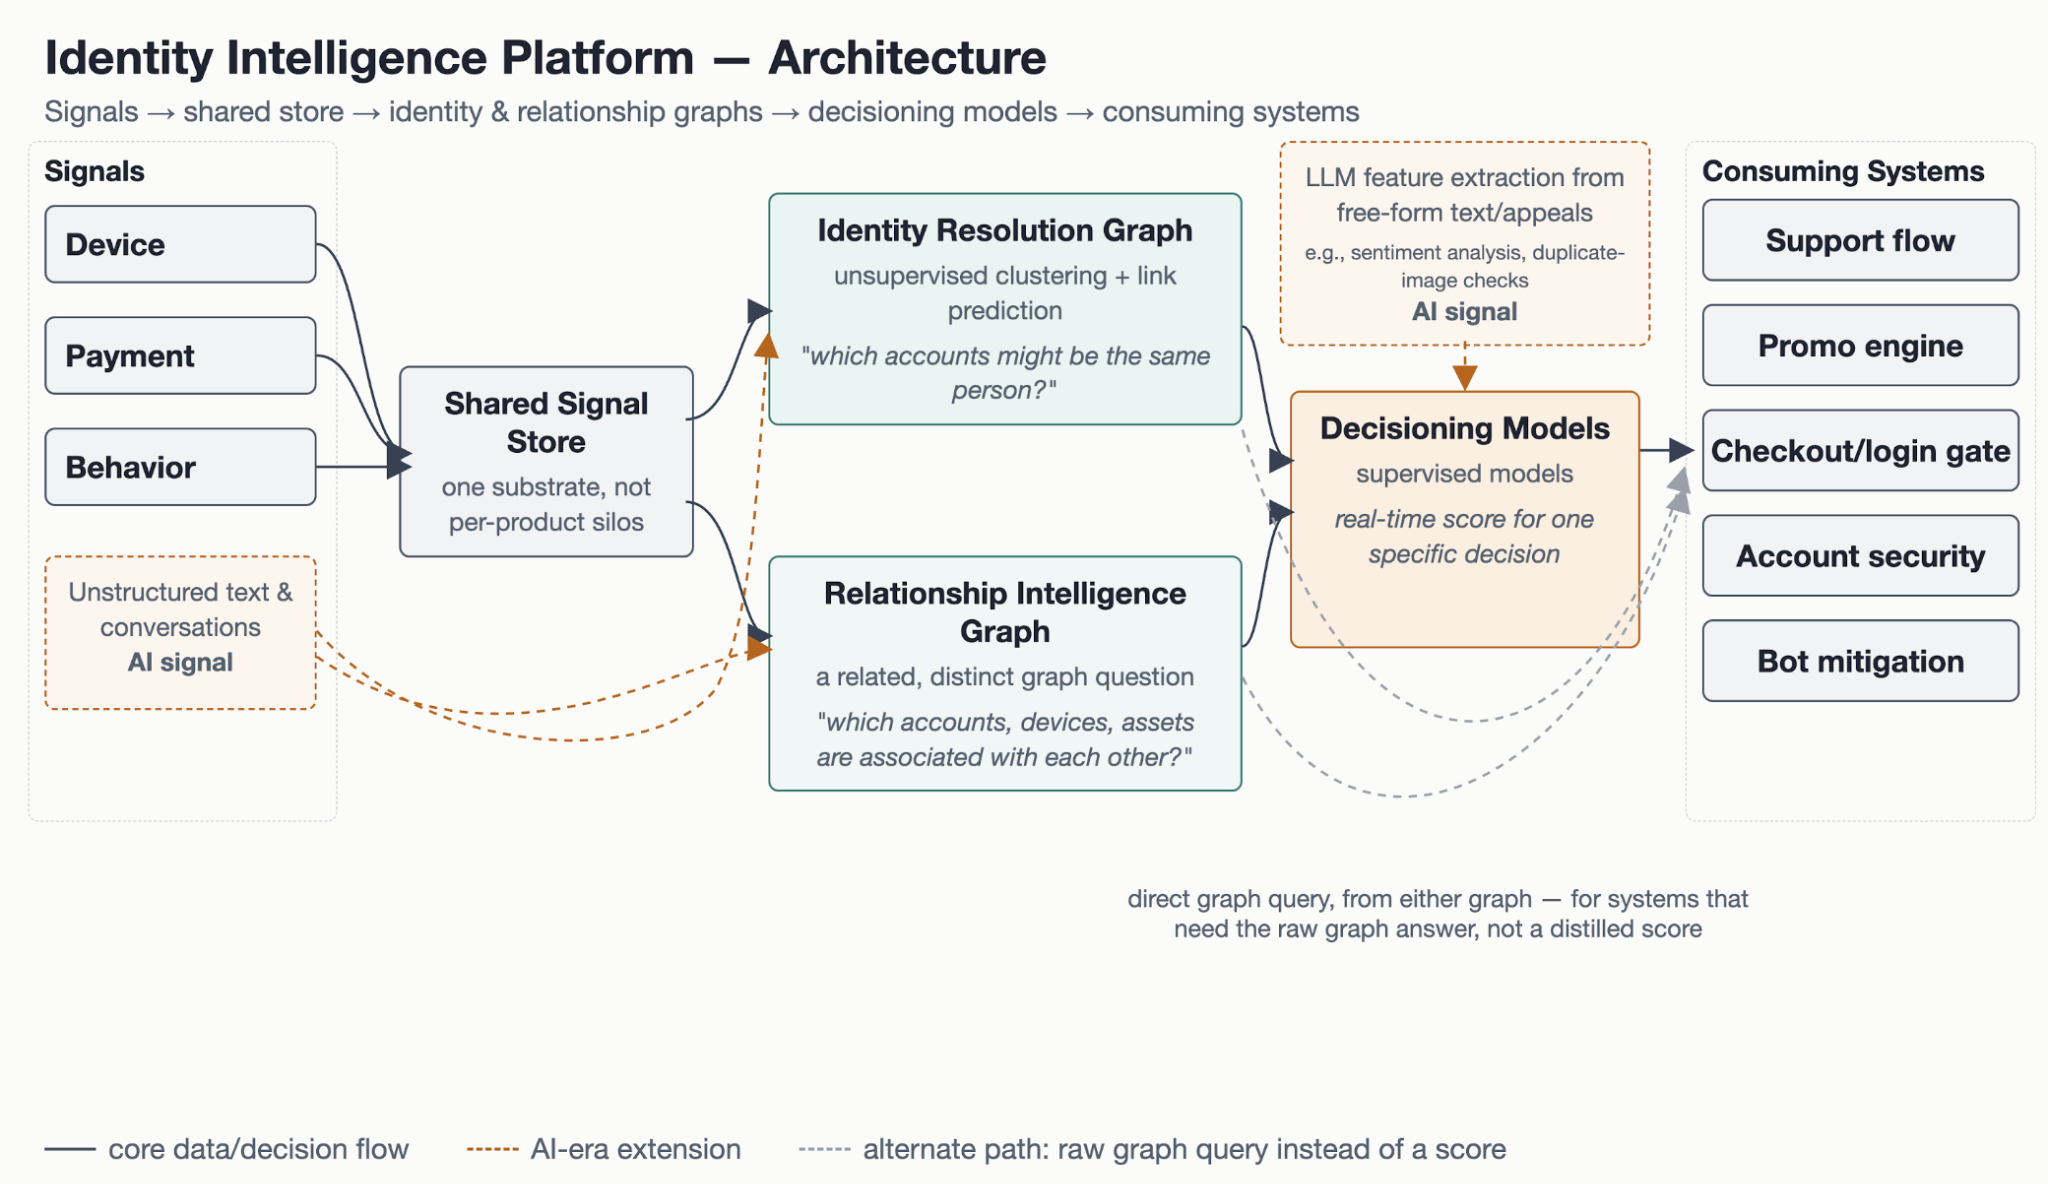
איור 1: מאגר אותות משותף מזין שני גרפים — מי האדם, ולמי הוא קשור — שתוצאתם מתורגמת על ידי שכבת דירוג אחת להחלטה אחת.

נשתמש באחד המקרים הקשים ביותר לזיהוי זהות כדוגמה — לקוח שרק נרשם, מבצע הזמנה ראשונה ומגיש בקשת תמיכה. אין היסטוריה שאפשר להשוות אליה, וגם לא צפוי להיות התאמה חזקה לחשבון קיים; לזיהוי הזהות לבדו אין הרבה על מה להסתמך. מה שכן יש לחשבון, מרגע הקמתו, הוא מספר תכונות זיהוי, כגון מכשיר, מספר טלפון, כתובת או כרטיס אשראי שמור במערכת. הפלטפורמה כבר עוקבת אחר החשבונות שבהם הופיעו כל אחת מתכונות אלה, כך שחפיפה באחת מהן נראית מיד, מבלי להמתין להזמנה אחת או לבקשת תמיכה. כתובת משותפת, למשל, היא התחלה, אך סימון גס של "משותף או לא" אינו מספיק מדויק כדי לפעול על פיו; הוא אינו מציין אם כתובת זו מופיעה בשני חשבונות או ב-200, אם כולם הופיעו באותו יום או לאורך שנים, או אם דפוס זה הוא בכלל יוצא דופן. זו משימתו של מודיעין הקשרים: לא לזהות מי האדם, אלא לאפיין את מידת הקשר שלו. הוא סורק יותר מ-100 סימנים נגזרים המחושבים לכל חשבון, כאשר כל אחד מהם מתעד כמה חשבונות אחרים חולקים תכונה נתונה, מתי זה קרה לאחרונה, וכמה חריג הדבר נראה בהשוואה ללקוח רגיל.

אבל אפילו כל זה אינו מהווה החלטה. עובדה פשוטה לגבי הגרף — כגון, לכתובת זו משויכים 40 חשבונות, שרובם נוצרו בשבוע האחרון — אינה מהווה פסק דין לגבי בקשת התמיכה הספציפית הזו. הפיכת האחד לשני היא תפקידו של מודל קבלת ההחלטות. המודל מאומן על סמך תוצאות כדי לדעת עד כמה דפוס זה צריך להיות משמעותי עבור סוג ספציפי זה של בקשה; המסקנה שלו זמינה בזמן אמת, כך שהיא מוכנה ברגע שהבקשה נכנסת.

לכן הפלטפורמה זקוקה לשלוש השכבות, ולא רק לשכבה הראשונה. זיהוי זהויות עונה על השאלה האם שני חשבונות שייכים לאותו אדם, בעוד שניתוח קשרי גומלין מספק תשובה מועילה גם כאשר זיהוי הזהויות לא מניב תוצאות; אף אחת מהן אינה מהווה החלטה עד שמודל שנבנה עבור מקרה השימוש הספציפי הזה הופך אותה לכזו.

הפלטפורמה מפרידה בין חישוב האותות לבין חישוב הציונים (איור 2). המאפיינים נאספים באופן אסינכרוני ומוכנים תוך דקות ספורות מרגע שהתרחש שינוי כלשהו. נקודת ביקורת (checkpoint) שולפת את הנדרש תוך 10 עד 15 מילי-שניות, במקום להמתין להשלמת העבודה שיצרה אותן. חישוב הציון מתבצע בהתאם למגבלות זמן התגובה של המשטח; הוא נקרא באופן מובנה (inline) כשיש מקום לכך, או ניתן להפעילו מיד עם קבלת המאפיינים, כך שהציון נשמר ונקרא בעת קבלת ההחלטה.
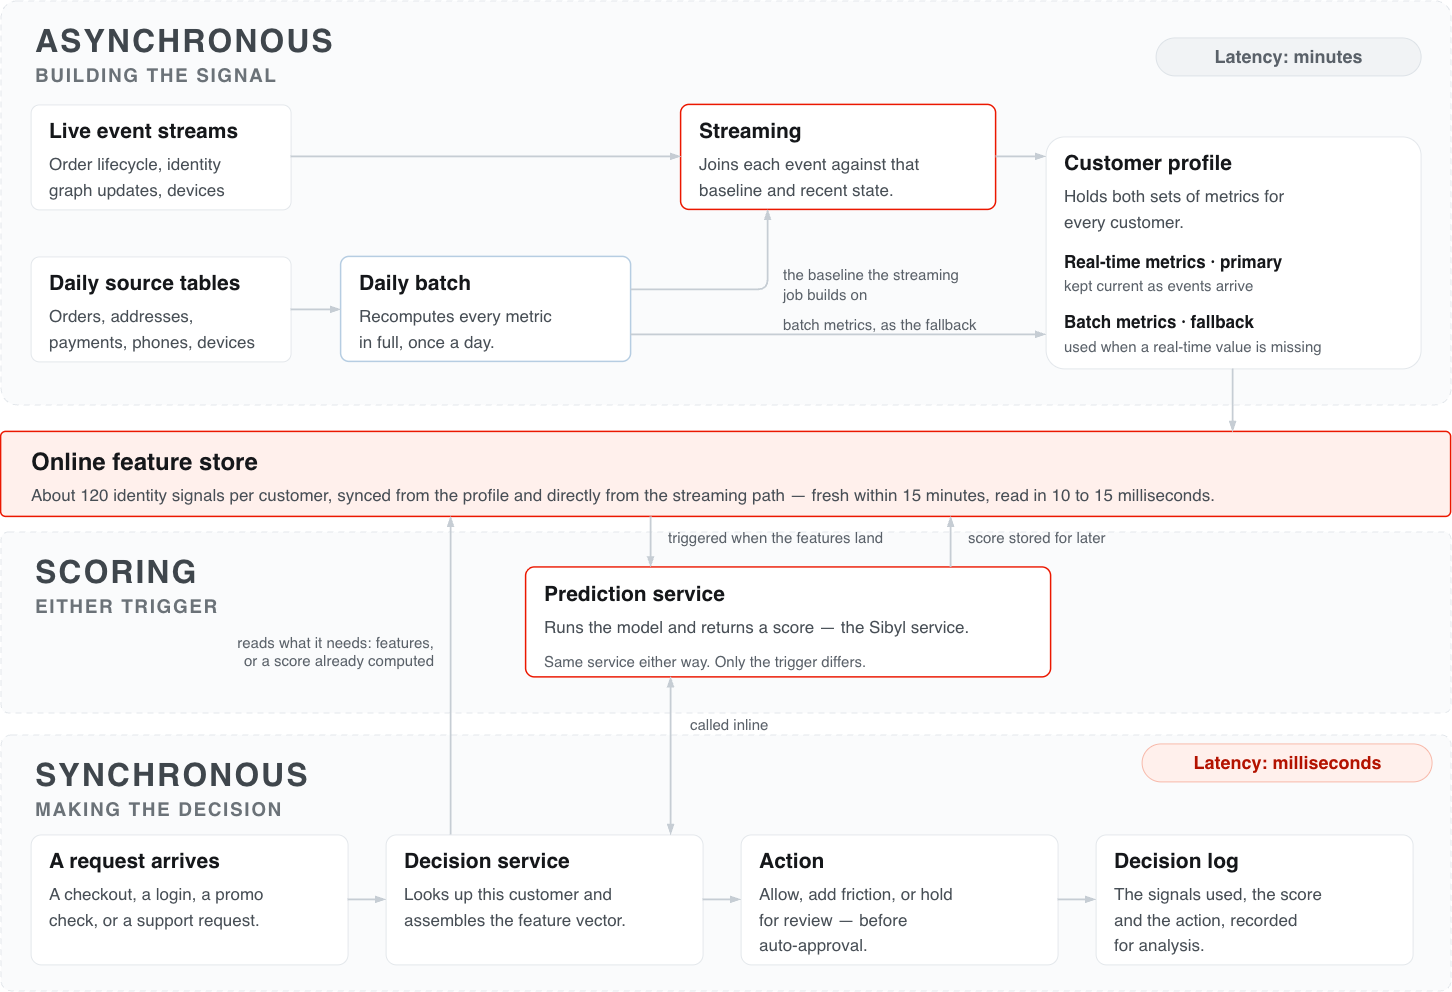
איור 2: אותות הזהות נבנים על פי השעון שלהם ונשמרים פעם אחת, ולכן אף החלטה אינה תלויה בתהליך הצבירה שמאחוריהם.

פלטפורמה אחת, שימושים רבים

מערכות במורד הזרם — למשל, זרימת תמיכה, מנוע קידום מכירות או שער תשלום — אינן זקוקות כולן לאותה שכבה. מערכות מסוימות יכולות לקבל תשובה ישירות מגרף הזהויות והקשרים; אחרות זקוקות לעיבוד נוסף של המידע באמצעות מודל קבלת ההחלטות המתאים, כדי להפוך אותו לציון בזמן אמת שנועד להחלטה הספציפית הזו. מערכות אלה אינן צריכות לדעת כלל כיצד נראה הגרף שבבסיסן.

קיבוץ זהויות צרכנים הוא הדוגמה הברורה ביותר לפעולת הפלטפורמה הזו. חשבונות כאלה נראים כאנשים נפרדים, אך למעשה הם אותו אדם. זהו, באופן ספציפי, תהליך זיהוי זהויות – קביעת האם שני חשבונות מייצגים אדם אחד, ולא רק האם הם קשורים זה לזה בדרך כלשהי. מאחורי הקלעים, מקבץ הזהויות מעריך את אמינותו של כל סימן המקשר בין שני חשבונות, ואת מידת הסבירות הנמוכה ששני אנשים שונים ישתפו בו במקרה. ככל שסימן משותף הוא בלתי סביר יותר, כך המשקל שהוא נושא בפני עצמו גדול יותר; סימנים נפוצים יותר או קלים יותר לשיתוף נושאים משקל רק בשילוב, כאשר מספר סימנים כאלה מצטברים. מכיוון שהמערכת פועלת ברציפות מול גרף הזהויות של DoorDash ולא כמשימה תקופתית, ניתן לבדוק אותה ברגע שמתקבלת בקשת כניסה, תשלום או החזר כספי.

ברגע שאותו אשכול קיים, אותו אות זהות ויחסים בסיסי — שמועלה לשימוש חוזר במקום להיבנות מחדש — מופיע בכל שאר תחומי הפעילות של מחלקת תקינות הנתונים. בתהליכי העבודה של התמיכה, אותה קיבוץ עוזר להבחין בין תקלה אמיתית בשירות לבין אדם אחד המגיש תביעות דומות למראה במספר חשבונות. בתחום המבצעים, הוא קובע את הזכאות על ידי הבחנה בין לקוח חדש לאדם שכבר ניצל הצעה תחת זהות אחרת. בתחום אבטחת החשבונות, הוא מסמן כניסה עם הסיסמה הנכונה שאינה מתנהגת כמו בעל החשבון. בהרחבה מאדם אחד לרבים, שכבה קשורה אך נפרדת — מודיעין יחסים, ולא זיהוי זהות — היא זו שחושפת ניצול מתואם; זה עשוי להתבטא ברשת של חשבונות שנראים עצמאיים כל אחד בנפרד, אך ניתן לראותם פועלים כפעולה אחת לאחר מיפוי הקשרים ביניהם. בתחום ההגנה מפני בוטים, היא מבחינה בין אדם הפועל תוך התמודדות עם קשיים לבין סקריפט הפועל בקנה מידה גדול. 

אף אחד מאלה לא נזקק לסוג חדש של אות, אלא לאותו האות בדיוק, שהופנה בכל פעם להחלטה אחרת. זה מה שפלטפורמה משותפת מאפשרת: מצע אחד, החלטות רבות. וברגע שהפלטפורמה הזו קיימת, היא לא חייבת להסתפק במזהים ישירים.

זהות היא יותר מסתם מזהה

מזהים ישירים היו, כמובן, נקודת הפתיחה המתבקשת — מזהה מכשיר, מספר טלפון, כתובת דוא"ל או כרטיס אשראי שמור במערכת. אלה הם סימנים חזקים שקשה לזייף, ולעתים קרובות הם מספיקים כשלעצמם כדי לענות בביטחון על השאלה "מי זה?". אך גורם זדוני נחוש מספיק עדיין יכול לעקוף אותם באמצעות מכשיר חדש, מספר חדש, כתובת דוא"ל חדשה או כרטיס אשראי חדש — ובכך לגרום לעקבות הישירות להתקרר.

ההתנהגות מסייעת לצמצם את הפער. האופן שבו אדם מתנהג באתר מסחרי — קצב פעולותיו, דפוסי הגלישה שלו, פעולות התשלום או האינטראקציות שלו עם שירות התמיכה — מספק גם הוא סוג של זהות, כזו שנוטה להישאר קבועה גם כאשר המזהים סביבה מוחלפים. היא אינה מחליפה את האותות הישירים; היא מהווה שכבה משלימה למקרים שבהם האותות הישירים לבדם אינם מספיקים.

לשינוי נקודת המבט הזו יש חשיבות, משום שהיא משנה את ההגדרה של "אותו אדם". שני חשבונות עם מכשירים ואמצעי תשלום שונים לחלוטין עדיין יכולים להיחשב כשייכים לאותו אדם, אם לוקחים בחשבון את דפוסי ההתנהגות. שני חשבונות שנראים כלא קשורים זה לזה על פי כל המאפיינים המזהים הישירים, עדיין עשויים להצדיק בדיקה מעמיקה יותר, אם דפוסי ההתנהגות שלהם דומים מדי מכדי להיות צירוף מקרים.

עתיד הבינה המלאכותית של Identity

הדרך הברורה ביותר למדוד פלטפורמה כזו אינה באמצעות הישג בודד כלשהו, אלא באמצעות הלקוחות שאינם מבחינים כלל במה שקרה, אך נהנים מחוויה יעילה יותר. בינה זהותית מסלקת את החיכוך שהלקוחות הכנים נאלצו לספוג; מערכת בטוחה יותר, המגיעה במהירות רבה יותר למסקנה לגבי זהות האדם שעמו היא מתעסקת, משחררת אותם מעול זה. 

ניתן ליישם את אותו הרעיון גם על נתונים מורכבים יותר. כיום, האותות ההתנהגותיים שלנו עדיין מסתמכים במידה רבה על סיכומים מספריים. אך מודלים של LLM ושל בינה מלאכותית גנרטיבית יאפשרו לנו בעתיד להפיק תובנות מטקסט לא מובנה, מתמונות ומשיחות חופשיות, בעלות פיתוח נמוכה בהרבה מבעבר. 

בניגוד ליצירת רכיבי משנה של טקסט ותמונה מאפס במודלים מסורתיים של רשתות נוירונים, כעת אנו יכולים להשתמש בנקודות קצה של בינה מלאכותית גנרטיבית (genAI) הזמינות מיד, או לנצל את שכבת הפלט של מודלים גדולים שעברו אימון מראש כדי ליצור מאפיינים הקשורים לטקסט/תמונה, כגון ניתוח סנטימנט בתיאור הבעיה או בדיקת תמונות כפולות. בנוסף, אנו יכולים לחקור ארכיטקטורות מודלים מבוססות טרנספורמר כדי לאצור הטמעות זהות משתמש שעשויות לחולל מהפכה באופן שבו אנו מגדירים אשכולות בגרף הזהויות. בארכיטקטורה שלעיל, אלה מופיעים כשני נתיבים נפרדים (איור 1): LLM המפיק תכונות ישירות מפניות בפורמט חופשי, והטמעות טקסט ההופכות לסוג חדש של קצה בגרף הזהויות. 

עם זאת, אותן התקדמויות בתחום הבינה המלאכותית שמקלות על בניית סימן זהות אמין, מקלות גם על זיוף כזה באמצעות התנהגות סינתטית משכנעת יותר, גיוון אוטומטי בין חשבונות, או תגובה עוינת מהירה יותר למדיניות החדשה שלנו. התייחסות לזהות כאל פלטפורמה, ולא כאל אוסף של בדיקות חד-פעמיות, מאפשרת לנו להישאר בקצב על ידי הצעת מקום אחד לשילוב סוג חדש של סימן, במקום להסתמך על תריסר מערכות נפרדות שכל אחת מהן מחכה לתורה כדי להדביק את הפער.

בסופו של דבר, אנו שואפים לצמצם את הצורך בפתרונות זהות מותאמים אישית וחד-פעמיים, באמצעות פיתוח תשתית זהות ומערכות יחסים אחידה אחת, שתשרת כל נקודת החלטה הזקוקה לכך.

הישארו מעודכנים עם עדכונים שבועיים

הירשמו לבלוג ההנדסה שלנו כדי לקבל עדכונים שוטפים על כל הפרויקטים הכי מגניבים שהצוות שלנו עובד עליהם
כאשר צרכן מבקש מ-Ask DoorDash "להזמין שוב את המוצרים הרגילים שלי", הבקשה נשמעת פשוטה. ל-DoorDash כבר יש את היסטוריית ההזמנות שלו; מדוע לא לאתר את המוצרים שהוא קונה בתדירות הגבוהה ביותר ולהוסיף אותם לרשימת קניות?

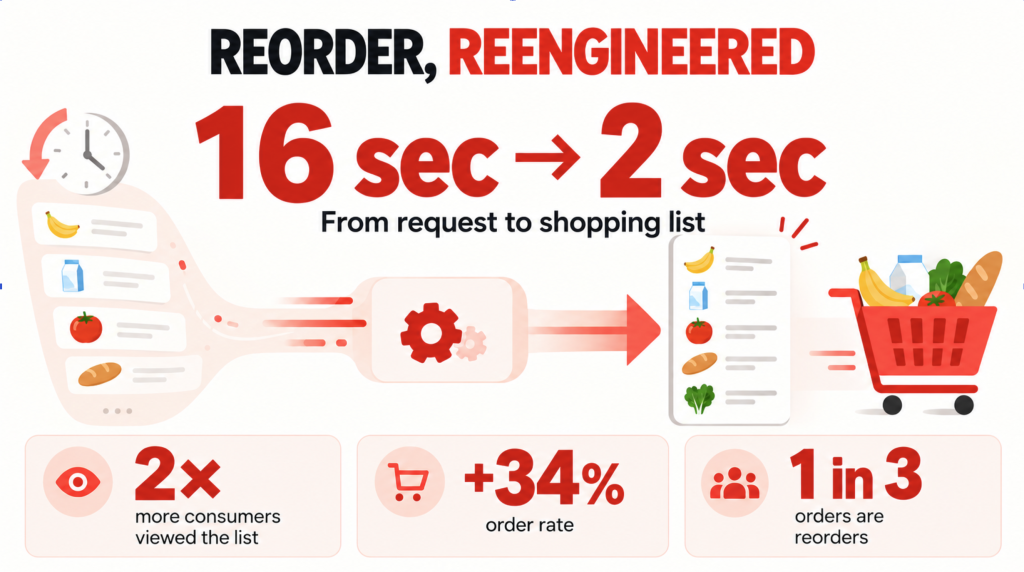
הזמנה חוזרת היא אחד ממקרי השימוש הפופולריים ביותר שלנו, והיא מהווה בערך אחת מכל שלוש הזמנות. אולם, המסלול הסוכני המקורי היה עלול לקחת עשרות שניות ליצירת רשימה. על ידי העברת ההיסק ההיסטורי היציב לשלב שלפני הבקשה ושימוש בביצוע דטרמיניסטי, שבו המוצר כבר מכיר את כוונת הצרכן, הצלחנו לקצר מסלול הזמנה חוזרת אחד מכ-16 שניות לכ-2 שניות, והכפלנו את הקצב שבו הצרכנים צפו ברשימה שהתקבלה. 

העברת ההיסק ההיסטורי למצב לא מקוון הקלה גם על אילוץ זמן ההשהיה ביצירת התוצאות, מה שאיפשר לנו להשתמש במודלים מתקדמים יותר ליצירת תוצאות רגילות באיכות גבוהה יותר. שיפור זה התבטא בעלייה של כ-34% בקצב ההזמנות עבור הזרימה.

האתגר הוא שהפיכת תהליך ההזמנה מחדש למהיר יותר אינה יכולה להתמצות רק בהצגת ההיסטוריה. היסטוריית ההזמנות מתעדת מה הלקוח קנה, ולא מה הוא צריך בהמשך.

חלב שנרכש פעם בשבוע הוא ככל הנראה צורך חוזר. אריזה גדולה של מגבות נייר שנרכשת בערך באותה תדירות עשויה שלא להיות כזו. רכישה של שש יחידות במשלוח אחד מהווה אינדיקציה שונה מרכישה של יחידה אחת בששת המשלוחים. יוגורט שהצרכן קונה שוב ושוב עשוי להיחשב למוצר בסיסי; רכישה של שלושה טעמים, פעם אחת מכל טעם, עשויה להיחשב לניסוי.

לפיכך, התשובה לשאלה"לקנות את המוצרים הרגילים שלי"מחייבת הפעלת שיקול דעת על סמך התנהגות העבר. במקביל, התשובה הסופית חייבת להתבסס על קטלוג המשתנה ללא הרף: פריטים יוצאים מהמלאי, הרישומים משתנים, והמוצר המדויק שהצרכן רכש בעבר עשוי שלא להיות זמין בחנות שבה הוא קונה היום.

בבקשת הזמנה חוזרת טיפוסית בפורמט חופשי, הסוכן של "Grocery" טוען את המיומנות "Reorder", שולף את הקשר הצרכני ואת היסטוריית ההזמנות הדרושים לבקשה, מחליט אילו רכישות קודמות צריכות להיכלל בסל הקניות הבא, מתאים את הצרכים הללו לקטלוג הנוכחי ומרכיב את רשימת הקניות. גמישות זו מאפשרת לאותו זרימת עבודה לטפל במגוון בקשות להזמנות חוזרות, תוך שילוב מספר חלקים שונים של מערכת "Ask DoorDash" כדי ליצור רשימת קניות שנראית פשוטה למראה.

הפוסטים הקודמים בסדרה זו עסקו, כל אחד בנפרד, בנושאים: מודיעין, הערכה, פלטפורמה וחווית משתמש. "Reorder" הוא התהליך שבו כל ארבעת המרכיבים הללו חייבים להתאים זה לזה בו-זמנית: הרשימה חייבת להיות מותאמת אישית, ניתנת לאימות, מהירה ומאפשרת ביצוע רכישות. פוסט זה עוקב אחר בקשה אחת לאורך כל אחד מהמרכיבים הללו.

"Reorder" זה יותר מסתם "replay"

השירות "Ask DoorDash" תומך במגוון בקשות להזמנה חוזרת. הצרכן יכול להקליד "אילו מצרכים אני קונה בדרך כלל?", "הזמן לי את המצרכים הרגילים שלי", "איזה חלב קניתי בפעם האחרונה?" או "הזמן לי את המצרכים הרגילים שלי, אבל במחיר זול יותר".

בקשות אלה נשמעות דומות, אך הן מצריכות החלטות שונות בבסיסן. חיפוש מוצר מההזמנה האחרונה שונה מההחלטה אילו רכישות מייצגות את הרגלי הקנייה הרגילים של הצרכן; בקשה לגרסאות זולות יותר מוסיפה סט נוסף של אילוצים.

על פי הארכיטקטורה הרב-סוכנתית של DoorDash, המתוארת בסקירת ההנדסה שלנו, בקשת מצרכים מועברת תחילה לסוכן "Grocery". כאשר הבקשה כוללת הזמנה חוזרת, הסוכן יכול לטעון את המיומנות "Reorder".

המיומנות "סידור מחדש" מספקת לנציג הוראות ספציפיות למשימה לטיפול בבקשות אלה, תוך שימוש בהקשר ובכלים העומדים לרשותו. במקום להגדיר תהליך עבודה נפרד לכל ניסוח אפשרי, היא מספקת לנציג תהליך כללי לקביעת דרישות הבקשה ולהפיכת התוצאה לרשימת קניות שניתן לפעול על פיה.

מבחינה רעיונית, תהליך זה כולל חמישה שלבים:

  1. הגדר את ההקשר. קבע באיזו חנות לבצע את הקנייה כאשר החנות עדיין לא ידועה, ואסוף מידע רלוונטי על הצרכן.
  2. שליפת היסטוריה. יש לקרוא את היסטוריית הזמנות המכולת הנדרשת לצורך הבקשה ולעבד אותה מחדש לצורה שהמודל יוכל להסיק ממנה מסקנות.
  3. בחרו את מה שחשוב. החליטו אילו חלקים מההיסטוריה הזו עונים על בקשת הצרכן. עבור "לקוחות קבועים", פירוש הדבר הוא להבחין בין צרכים חוזרים לרכישות חד-פעמיות.
  4. זהו את המוצרים. חפשו בקטלוג הנוכחי של DoorDash, תוך שמירה על פרטים כגון מותג, מידה וגרסה, ככל שהדבר אפשרי.
  5. הרכיב את התוצאה. שאל את הצרכן שאלה מבהירה כאשר נותרת בחירה מעורפלת באמת, ואז צור את מסמך רשימת הקניות הניתן לעריכה.

מיומנויות אחרות יכולות להשתלב בזרימה הזו. אם לקוח מבקש את המוצרים הרגילים שלו "אבל בזול יותר", למשל, המיומנות "הזמנה חוזרת" יכולה לקבוע מה הוא בדרך כלל צריך, בעוד שהשיקול הכלכלי בוחן את המוצרים והמחירים הזמינים כרגע.

גמישות זו חשובה בשפה חופשית. משתמש המקליד ב-Ask לא בחר בפעולת API; הוא הביע כוונה, ועל הסוכן לקבוע איזו פעולה נדרשת כדי לממש כוונה זו.

כל אחד מחמשת השלבים הללו מניח הנחה שהמיומנות אינה כוללת. באיזו חנות לקנות, איזה מותג להעדיף, והאם הצרכן הזה בכלל מעוניין בשמן זית השבוע — אף אחד מהדברים הללו אינו עובדה הנוגעת להזמנה חוזרת. זו עובדה הנוגעת לצרכן.

מודיעין: מה שהסוכן כבר יודע עליך 

היסטוריית ההזמנות מספקת לנו מידע על מה הצרכן רכש, אך היא אינה מספקת לנו אינדיקציה כיצד לפרש כל רכישה. כפי שתואר במאמר " בניית Ask DoorDash (חלק 2): בינה מלאכותית", Ask DoorDash יכולה להביא בחשבון הקשר כגון העדפות חנויות, זיקה למותגים, העדפות תזונתיות ומצב המזווה, מתוך הזיכרון לטווח ארוך, הזיכרון השיחתי והזיכרון המיידי.

במקרה של הזמנה חוזרת, האותות הללו אינם מהווים מקור נוסף למוצרים. הם מסייעים בפירוש היסטוריית הרכישות של הצרכן. אם, למשל, מישהו קונה באופן עקבי מותג חלב מסוים, יש לשקף את ההעדפה הזו ברשימה שתתקבל. אם לאחרונה הוא מסר ל-Ask שיש לו מלאי מספיק של שמן זית, ההקשר הזה יכול להוביל להוצאת שמן הזית מההזמנה החוזרת הבאה שלו, גם אם הוא מופיע בתדירות גבוהה בהיסטוריית הרכישות שלו.

זה חשוב משום שהצרכנים כבר יודעים מה הםה"מוצרים הקבועים"שלהם. אי-התאמות קטנות בחנות, במותג או במלאי במזווה בולטות מיד ועלולות לערער במהירות את האמון בשאר הפריטים ברשימה.

לפיכך, האינטליגנציה מספקת לכישרון "Reorder" נקודת התחלה טובה יותר, אך היא אינה עונה על השאלה המרכזית: אילו רכישות בהיסטוריית הצריכה של הצרכן נחשבות בפועל לצרכים חוזרים? החלטה זו עדיין צריכה להתקבל — ולהיבחן באופן עקבי.

הערכה: בדיקה אם הרשימה נכונה

היינו זקוקים לדרך להעריך את ההחלטהבנוגע ל"הזמנות קבועות" לפני שהיא תגיע לצרכן. כפי שתואר במאמר "בניית Ask DoorDash (חלק 3): הערכה", הערכת הסוכן בוחנת הן את מסלול הביצוע והן את התוצאה. במקרה של הזמנה חוזרת, פירוש הדבר הוא בדיקה האם הסוכן אסף את ההקשר וההיסטוריה הנכונים, פעל לפי הזרימה הצפויה, והפיק רשימת קניות שמישה — וכן האם הפריטים ברשימה זו אכן משקפים את הצרכים החוזרים של הצרכן.

בדיקות הבחירה הללו הן קונקרטיות. אם צרכן מזמין שוב ושוב שלושה יוגורטים, האם הרשימה שומרת על הדפוס והכמות הזו? האם פריט שהופיע רק פעם אחת לא נכלל ב"פריטים הקבועים"שלו? אם הצרכן ציין שיש לו כבר משהו כזה בבית, האם הדבר בא לידי ביטוי בתוצאה?

מכיוון שהיסטוריית ההזמנות בזמן אמת משתנה עם הזמן, אנו משתמשים ב"סימולטור שיחות" המבוסס על תבניות קבועות כדי לשחזר תרחישי הזמנות חוזרות מול היסטוריית רכישות קבועה. לאחר מכן, מדדים בסגנון רשימת בדיקה מאפשרים לנו לבדוק פריטים חוזרים, רכישות חד-פעמיות, כמויות והעדפות ידועות מול אותם נתונים, תוך כדי שינויים ביישום.

רשימה נכונה מועילה רק אם היא מגיעה בזמן שהצרכן עדיין נמצא בתהליך הקנייה. התהליך המקורי שלנו ארך כ-16 שניות.

פלטפורמה: אין צורך לקבל את ההחלטה בזמן ההמתנה 

זמן ההשהיה הזה נבע בחלקו מהאופן שבו Ask DoorDash מטפל בבקשות של סוכנים. כפי שתואר במאמר "בניית Ask DoorDash (חלק 4): פלטפורמה לבניית סוכנים ולפיתוחם", במסגרת מחזור צרכן בודד, המודל יכול לקבל החלטה, לקרוא לכלי, לבחון את התוצאה ולהשתמש במידע זה כדי להחליט מה לעשות בהמשך. בתהליך טיפוסי של הזמנת מצרכי מכולת, הדבר עשוי לדרוש 6–8 קריאות ל-LLM, בנוסף למספר קריאות לכלים.

גמישות זו חשובה כאשר כל שלב תלוי במידע שמתגלה במהלך הבקשה. עם זאת, שינוי הסדר הראה לנו כי מספר שלבים מבין אלה הסתמכו על נתונים היסטוריים המשתנים בקצב איטי.

צרכנים נוטים לחזור לקבוצה מצומצמת יחסית של חנויות מכולת. במקום לבחור חנות, לאחזר את היסטוריית ההזמנות שלה ולקבוע את הצרכים החוזרים של הצרכן בכל בקשה, אנו יכולים לבצע את העבודה הזו מראש באמצעות נתונים היסטוריים.

חלקים אחרים בתהליך צריכים להישאר מעודכנים. המלאי והמחירים משתנים, מוצרים יוצאים מהמלאי, ופרטי הקטלוג עשויים להשתנות בין ביקור לביקור.

זה סיפק לנו גבול טבעי: לחשב מראש את החנויות הסבירות של הצרכן ואת צרכיו החוזרים, ולאחר מכן להשתמש בנתיב הבקשה בזמן אמת כדי להתאים את הצרכים הללו לקטלוג הנוכחי ולבנות את רשימת הקניות.

פיצול זה הפך לבסיס לתהליך העבודה שלנו, מהמקוון למקוון.

איור 1: Ask DoorDash מקצה כל בקשת הזמנה חוזרת למסלול ביצוע בהתאם לתחום השיפוט הרלוונטי. במקרה של "הזמנה חוזרת של העגלה האחרונה שלי", היקף הפעלה מוגדר מאפשר לתוסף בק-אנד לאחזר את העגלה הקודמת מבלי להשתמש במודל לבחירת הכלים. במקרה של רכישות חוזרות, צינור יומי משלב 90 ימי היסטוריית הזמנות עם סימנים מהפרופיל הרלוונטיים למשימה, בוחר צרכנים בעלי ראיות מספיקות, מריץ הסקת LLM אצווה, ומאמת את התוצאה לחבילת "מוצרים קבועים" הניתנת לשימוש חוזר. "הזמן מחדש את המוצרים הקבועים שלי" קורא את החבילה הזו ישירות, בעוד ש"הזמן מחדש את המוצרים הקבועים שלי, אבל בזול יותר" משלים אותה עם מחירים עדכניים, מבצעים, גדלי אריזות, מלאי ואילוצים של הצרכן. שלושת המסלולים מתכנסים לפתרון קטלוג בזמן אמת, המנסה תחילה את מזהה הפריט בחנות, לאחר מכן את מזהה המוצר בקטלוג, ולבסוף מונח חיפוש, לפני יצירת רשימת קניות הניתנת לעריכה. הסוכן Grocery נשאר זמין כדי להבהיר בחירות מעורפלות, לתאר תחליפים, ולהתאושש מתוצאות חסרות או בלתי שמישות.

יצירת הצעות לפני שהצרכן מבקש. 

בחירת הקבוצה ומימוש הקלט

לא כל היסטוריית הזמנות מכילה ראיות מספיקות כדי להסיק על צרכים חוזרים. משלוח מצרכים חד-פעמי מלמד אותנו מה הצרכן קנה פעם אחת, אך לא אם פריטים כלשהם מבין אלה הם מוצרי יסוד. לפיכך, ביצוע תהליך יצירת דפוסים על כל צרכן יגרור עלויות נוספות, תוך שהוא מניב תוצאות בעלות רמת אמינות נמוכה.

אנו מתייחסים לבחירת הקוהורטה הן כאל שער איכות והן כמנגנון לבקרת עלויות. משימה יומית ב-Spark מזהה צרכנים עם פעילות מספקת בתחום המזון או הקמעונאות בתקופה האחרונה, כדי לאפשר יצירת נתונים.

עבור כל צרכן שנבחר, אנו מכינים שני נתונים: פרופיל תמציתי הכולל את הסימנים ארוכי הטווח הרלוונטיים ביותר להזמנה חוזרת, כגון תחומי עניין בקטגוריות מוצרים והעדפות מותגים, וכן היסטוריית הזמנות ברמת הפריט מה-90 הימים האחרונים.

לשני אלה יש מטרות שונות. הפרופיל מספק הקשר לגבי הצרכן; היסטוריית ההזמנות מספקת את הראיות ברמת האירוע הדרושות כדי להסיק על צרכים חוזרים. העדפת מותג עשויה לספר לנו, למשל, איזה יוגורט הצרכן עשוי לרצות, בעוד שהיסטוריית הרכישות מגלה לנו אם יוגורט נכלל בכלל ברשימת המוצרים הקבועים שלו.

בהתאם לגישת "קיצוץ ההקשר הספציפי למשימה" שמקורה במחקר שלנו על מודלים לשוניים גדולים (LLM) במצב לא מקוון לצורך התאמה אישית מקוונת, אנו שולחים רק את האותות מהפרופיל הרלוונטיים למשימה זו, ולא את הפרופיל המלא של הצרכן. הדבר מקטין את עלות הקלט ומונע מהקשר שאינו קשור להתחרות בראיות הרכישה שעליהן מבוססת ההחלטה.

הגדרת "המנות הקבועות שלך"

הכנת רשימה מדורגת היא משימה פשוטה ברגע שמגדירים מהו "רגיל". ההגדרה עצמה הייתה החלק הקשה יותר.

תדירות היא נקודת ייחוס סבירה, אך היא משקפת את מה שהצרכן קנה בתדירות הגבוהה ביותר, ולא את מה שהוא צפוי להזדקק לו שוב. חלב ואריזה גדולה של מגבות נייר עשויים להופיע באותו מספר הזמנות, אך דפוסי החידוש שלהם שונים מאוד. שישה בקבוקים במשלוח אחד מהווים גם הם ראיה חלשה יותר להרגל חוזר מאשר בקבוק אחד שנרכש בשש משלוחים נפרדים. גם העיתוי לבדו אינו פותר את העמימות.

אנו משתמשים במודל שפה גדול (LLM) משום שהסימנים הללו פועלים יחד בדרכים שקשה לתפוס במסגרת כלל דירוג יחיד. המודל פועל על פי סדר איכותי מפורש: תדירות ההזמנות במשלוחים נפרדים מהווה את הסימן העיקרי לצורך חוזר, העדכניות מצביעה על כך שהצורך עדיין קיים, ומאפייני החידוש עוזרים להבחין בין מוצרים המתכלים במהירות למוצרים עמידים. הזיקה למותג עשויה לחדד את הבחירה, אך היא אינה גוברת על ראיות הרכישה הישירות.

המלאי הזמין מוסיף רובד נוסף. מארז רב-יחידות של מוצר עמיד שנרכש לאחרונה עשוי לרדת במורד הרשימה, בעוד שמוצר מתכלה שהופיע בעבר באופן קבוע אך לא נרכש לאחרונה עשוי לעלות במורד הרשימה.

הפיכת ההחלטה לחבילה

המודל מיישם את ההיגיון הזה באופן עצמאי עבור כל חנות רלוונטית ומחזיר את הפריטים החוזרים שהוא מזהה. המספר המרבי של פריטים מהווה תקרה, ולא יעד: אם הנתונים תומכים רק בכמה פריטים קבועים בודדים, המודל מחזיר את הקבוצה הקטנה יותר במקום למלא את הרשימה בהשערות חלשות יותר. אם ההיסטוריה אינה תומכת בחבילה שימושית, הוא יכול להימנע לחלוטין.

התוצאה מוגבלת לנתונים המופיעים בקלט. מזהי החנות והפריטים חייבים לנבוע מהיסטוריית הצרכן; רכישות חוזרות עדיפות על פני רכישות חד-פעמיות; וגרסאות שכמעט זהות מאוחדות במקום למלא מספר מקומות בחבילה. עבור כל פריט, אנו שומרים אינדיקטורים כגון תדירות הרכישה, מועד הרכישה האחרונה והכמות האופיינית, כך שניתן להציג את התוצאה מבלי לבצע מחדש את תהליך ההסקת המסקנות ההיסטורי באופן מקוון.

יש לציין את הצורך, ולא את מספר ה-SKU

מוצר שמדורג היטב עדיין אינו שמיש אם הקטלוג משתנה לפני שהצרכן חוזר. הרישום המדויק עשוי להופיע מחדש תחת מזהה חדש ספציפי למוכר, או להיעלם לחלוטין. שמירת מזהה המוצר ההיסטורי של החנות בלבד עלולה להפוך את החבילה לפגיעה; שמירת מונח כללי בלבד, כגון "חלב שיבולת שועל", תביא לאובדן הספציפיות של מה שהצרכן קונה בפועל.

לפיכך, אנו מייצגים כל צורך בשלושה רמות: מזהה הפריט בחנות לצורך התאמה מדויקת ביותר, מזהה מוצר ברמת הקטלוג לאותו מוצר בסיסי בכל הרישומים, ומונח חיפוש כללי כחלופה. בעת הבקשה, מסלול ההגשה בודק אותם מהספציפי ביותר ועד הכללי ביותר, ועוצר במוצר הנוכחי הראשון העומד בקריטריונים.

ההיררכיה הזו משקפת בצורה ברורה את החלוקה בין העולם המקוון לעולם הלא מקוון. המודל הלא מקוון קובע איזה צורך מתוך היסטוריית הצריכה של הלקוח כדאי להמשיך ולטפח; המערכת המקוונת קובעת איזה מוצר יכול לספק את הצורך הזה כרגע.

לפני פרסום חבילה, מתבצע אימות דטרמיניסטי בין שלב יצירת המודל לשלב חוזה ההגשה. אימות זה מבחין בין הימנעות מפורשת לתפוקה פגומה, מסיר מזהים שאינם שמישים, מנרמל כמויות ומסנן תוצאות שאינן עומדות בדרישות לחבילה שימושית. המודל מקבל את ההחלטה הסמנטית; הקוד הדטרמיניסטי מחליט אם התוצאה בטוחה להגשה.

יצירה והפצה בקנה מידה גדול

יצירת חבילות אלה בקרב קבוצת צרכנים גדולה מחייבת מערכת עיבוד אצווה המסוגלת להתמודד עם תקלות חלקיות. אנו משתמשים בתשתית Metaflow מפוצלת, כך שאצוות יוכלו לפעול באופן עצמאי וניתן יהיה לנסות שוב את השברים שנכשלו מבלי למחוק את העבודה שהושלמה בהצלחה.

לאחר האימות, החבילות שנוצרו מתפרסמות במאגר מפתח-ערך בעל זמן השהיה נמוך. לאחר מכן, נתיב ההגשה יכול לאחזר את החבילה של הצרכן ממאגר נתון מבלי לחזור על תהליך ההיסק ההיסטורי, בעוד שחבילות חסרות או בלתי שמישות יובילו לתגובה ריקה במקום לכישלון של שלב ה-Grocery.

מכיוון שהחבילה נוצרת באופן בלתי תלוי ב-Ask, אותו אות יכול לתמוך גם במשטחים מותאמים אישית אחרים מבלי לחזור על תהליך ההסקת המסקנות.

הצרכן אינו רואה דבר מכל זה. מה שהוא רואה הוא רשימת קניות — ובהתאם לאופן שבו נכנס לתהליך, ייתכן שיראה אותה תוך כשתי שניות.

חוויית המשתמש: רשימה אחת, מספר דרכי גישה

צרכן לא תמיד מגיע להזמנה חוזרת דרך אותו מסלול. הוא עשוי להקליד "להזמין שוב את המוצרים הרגילים שלי"ישירות ב-Ask, או שהוא עשוי להיכנס דרך ממשק קונטקסטואלי שבו DoorDash כבר יודעת משהו על מה שהוא מנסה לעשות.

ההבחנה הזו חשובה משום שההקשר שמספקת החוויה יכול להקל על השיחה. כפי שתואר במאמר "בניית Ask DoorDash (חלק 5): ממשק מבוסס מציאות לסוכני קניות", הלקוח מצרף היקף לבקשה, הכולל מידע כגון הנושא והחנות שממנה נכנס הצרכן. המערכת יכולה להשתמש בהקשר זה במקום לבקש מהצרכן לחזור על מידע שהמוצר כבר יודע.

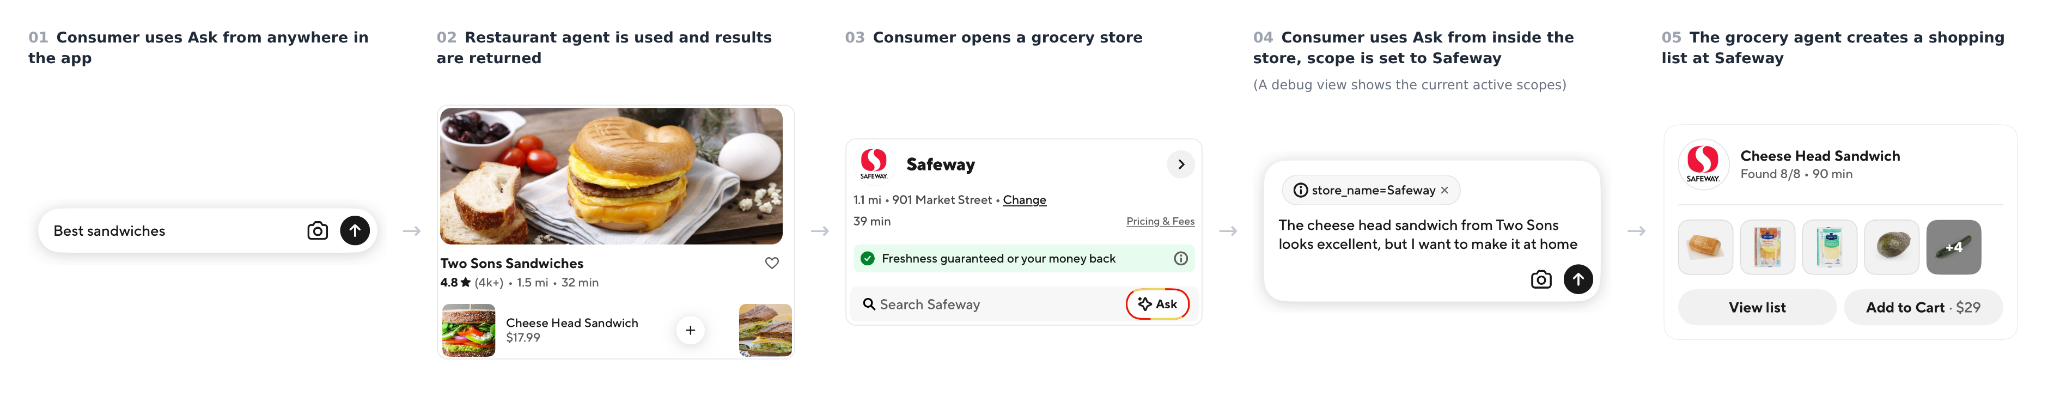
במקרה של בקשה בלתי מובנית כמו"להזמין מחדש את המוצרים הקבועים שלי", הסוכן "Grocery" עדיין מפרש את הבקשה באמצעות המיומנות "Reorder". אולם, כאשר הצרכן נכנס דרך פעולה ייעודית בשם"להזמין מחדש את המוצרים הקבועים שלי", המוצר כבר קבע את הכוונה. כפי שמוצג להלן, אנו מצרפים היקף קבוע מראש שאינו נראה לעין הצרכן ומנתבים את הבקשה דרך מסלול דטרמיניסטי.

בשילוב עם החבילה שחושבה מראש בסעיף "פלטפורמה", הדבר מצמצם את העבודה בזמן אמת לאחזור החבילה והתאמת הפריטים בה לקטלוג הנוכחי. הנתיב כבר אינו זקוק ל-LLM כדי לפרש את הבקשה או לשחזר את ההרגלים הקבועים של הצרכן מההיסטוריה, מה שמקצר את זמן ההשהיה מכ-16 שניות לכ-2 שניות.

בין אם הצרכן מגיע באמצעות טקסט חופשי או נקודת כניסה קונטקסטואלית, התוצאה היא אותה רשימת קניות מובנית. משם, הוא יכול לשנות כמויות, להסיר פריט שכבר יש ברשותו, להחליף מוצר או להוסיף את הרשימה המוגמרת לעגלת הקניות שלו. עריכות מובנות אלה מתבצעות ישירות על הרשימה עצמה, במקום לדרוש סיבוב נוסף של LLM.

הנציג נשאר זמין כאשר הבקשה מצריכה שיקול דעת רב יותר. הצרכן יכול לבקש, למשל, "את מה שאני מזמין בדרך כלל, אבל בזול יותר", והנציג יכול לצאת מאותם צרכים חוזרים, תוך שהוא שוקל את המחירים הנוכחיים ואת החלופות.

נקודות כניסה שונות עשויות להוביל להיקפי עבודה שונים מאוד ברקע, תוך שהן עדיין מתלכדות לחוויה אחידה של סידור מחדש.

מַסְקָנָה

"להזמין שוב את המוצרים הרגילים שלי"נראה כמו בקשה פשוטה, אך כדי להפוך אותה לשימושית יש למקם את ההחלטות השונות במקום הנכון. ההקשר הצרכני מסייע בפירוש היסטוריית הרכישות; ניתן לחשב מראש את הצרכים החוזרים; המלאי, המחירים והרזולוציה של הקטלוג נשארים מעודכנים בזמן אמת; ונקודות כניסה הקשריות יכולות לבטל עבודה שהמוצר כבר ביצע.

הלקח הרחב יותר הוא ששיפור ביצועי הסוכן לא תמיד פירושו לבקש מהמודל לבצע פעולות נוספות. פירוש הדבר הוא להחליט על מה יש להסיק מסקנות בעת הבקשה, מה ניתן לדעת מראש, ומה צריך להיות דטרמיניסטי.

כאשר הגבולות הללו מוגדרים כראוי, המורכבות נעלמת מעיני הצרכן. הם מבקשים מ-DoorDash להזמין שוב את המוצרים הקבועים שלהם ומקבלים רשימה שנראית אישית, עדכנית ומוכנה לקנייה.

הישארו מעודכנים עם עדכונים שבועיים

הירשמו לבלוג ההנדסה שלנו כדי לקבל עדכונים שוטפים על כל הפרויקטים הכי מגניבים שהצוות שלנו עובד עליהם

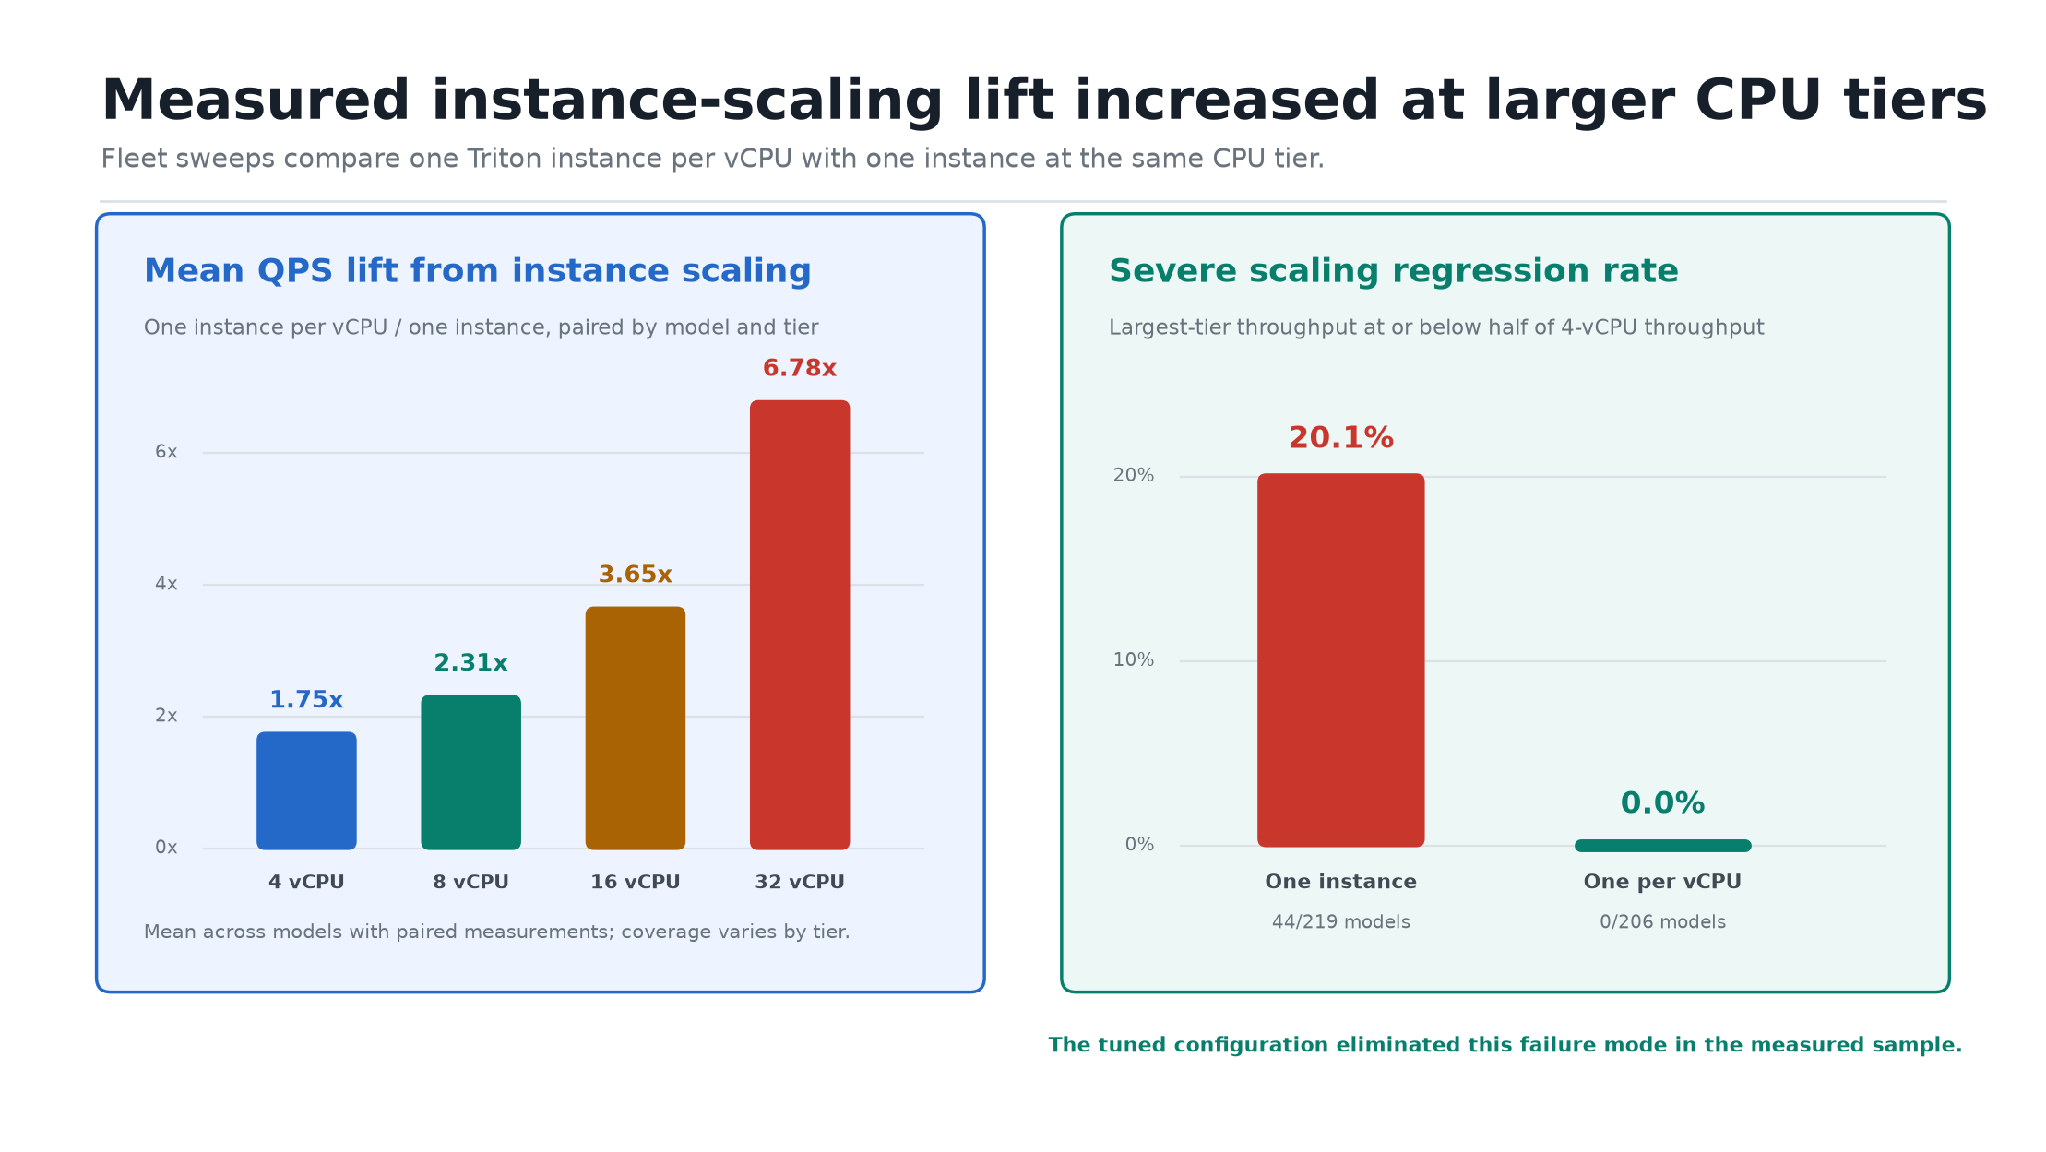
כיצד צי בדיקות השוואה רב-שימושי איפשר למדוד את תצורת Triton במאות מודלים של ייצור ומודלים צל, כאשר העלייה הממוצעת ב-QPS עלתה מ-1.75x ב-4 vCPU ל-6.78x ב-32 vCPU.

חלק 1 בסדרה בת מספר חלקים. פרק זה עוסק בדגמי Triton הנתמכים על ידי מעבד (CPU). בפוסט הבא נסביר כיצד אנו מרחיבים את המערכת כדי לאפשר הסקת מסקנות באמצעות מעבד גרפי (GPU).

במודל ייצור אחד, אותו ארטפקט שהופעל באותו פוד של 32 vCPU סיפק 68 QPS או 863 QPS, בהתאם אך ורק לתצורת השירות שלו. לאחר הכוונון, זמן ההשהיה p99 צנח מ-126 מילי-שניות ל-14 מילי-שניות, ושיעור השימוש במעבד ירד מ-67% ל-16%.

1.75–6.78xעלייה ממוצעת ב-QPS כתוצאה מהרחבת מופעים, לפי רמת מעבדמאותתמיכה במודלים של ייצור וצל20.1% לעומת 0%שיעור נסיגה חמורה: מקרה אחד לעומת מקרה אחד לכל vCPU252חריצי פוד לשימוש חוזר במבחן ביצועים

כאשר כוח עיבוד רב יותר גרם לדגמים להיות איטיים יותר

ב-DoorDash, מודלים של PyTorch פועלים על NVIDIA Triton Inference Server במגוון תרחישי שימוש כגון חיפוש, דירוג, שיגור, זיהוי הונאות ופרסומות. לכל מודל יש מספר אפשרויות הפעלה: ארכיטקטורת מעבד, גודל פוד, מספר מופעים של Triton, מספר חוטים ב-OpenMP ומספר בקשות במקביל. הגדרת ברירת מחדל סבירה עבור מודל אחד עלולה לבזבז קיבולת או להפר את יעדי זמן ההשהיה של מודל אחר. 

הניתוח המעודכן כלל 264 מודלים עם נתוני סריקה שמישים. מבין המודלים עם תוצאות דומות במודל יחיד, 44 מתוך 219 ירדו למחצית או פחות מתפוקת ה-4-vCPU שלהם בדרגת הסריקה הגדולה ביותר. מבין 206 המודלים עם תוצאות דומות של מודל אחד לכל vCPU, אף אחד מהם לא ירד. 

הטעות הייתה להתייחס לגודל הפוד כאל הגורם העיקרי בקביעת הביצועים. בפועל, גודל הפוד משפיע על מספר מופעי מודל Triton ועל מספר ה-threads שבהם משתמש כל מופע. מספר רב יותר של ליבות עלול ליצור תחרות רבה יותר כאשר הגדרות אלה אינן מתואמות. 

איזו תצורת שרתים מלאה מספקת את התפוקה וזמן ההשהיה הנדרשים בעלות המשאבים הנמוכה ביותר?

מתן תשובה לשאלה זו עבור מודל אחד מהווה אמת מידה. מתן תשובה עקבית לשאלה זו עבור מאות מודלים מחייב שימוש במערכת. 

מערכת כוונון רב-פעמית

פיתחנו פלטפורמת כוונון אוטומטי המשווה בין תוצרי מודל הייצור ונתוני קלט מייצגים למטריצת תצורות מבוקרת, ולאחר מכן בוחרת בתצורה הזולה ביותר העומדת בדרישות החביון והקיבולת של המודל. 

  1. תזמור
    AutoTuneFlow מגדיר את ארטפקט המודל, את הקלטים הייצוגיים, את תעבורת הייצור, את יעד זמן ההשהיה ואת מטריצת התצורות המועמדות. 
  2. מדידה
    מאגר מבחני ביצועים משותף מריץ את המועמדים על אותה סביבת ריצה של Triton המשמשת בסביבת הייצור, ומתעד את התפוקה, זמן ההשהיה ושימוש המעבד ב-cgroup. 
  3. בחירה
    התהליך פוסל מועמדים שאינם עומדים במגבלות זמן ההשהיה או המעבד, משלב את מדידות הקיבולת הנותרות עם קצב ה-QPS בסביבת הייצור, ומנפיק הוראות עקיפה לפריסה. 

צוותי המודל אינם צריכים להבין את המכניקה של מאגר המדדים, ושכבת המדידה אינה צריכה לדעת מהו ההקשר העסקי העומד מאחורי יעד זמן ההשהיה של המודל. שכבת התזמור משלבת את השיקולים הללו להמלצה מוכנה ליישום בסביבת הפקה. 

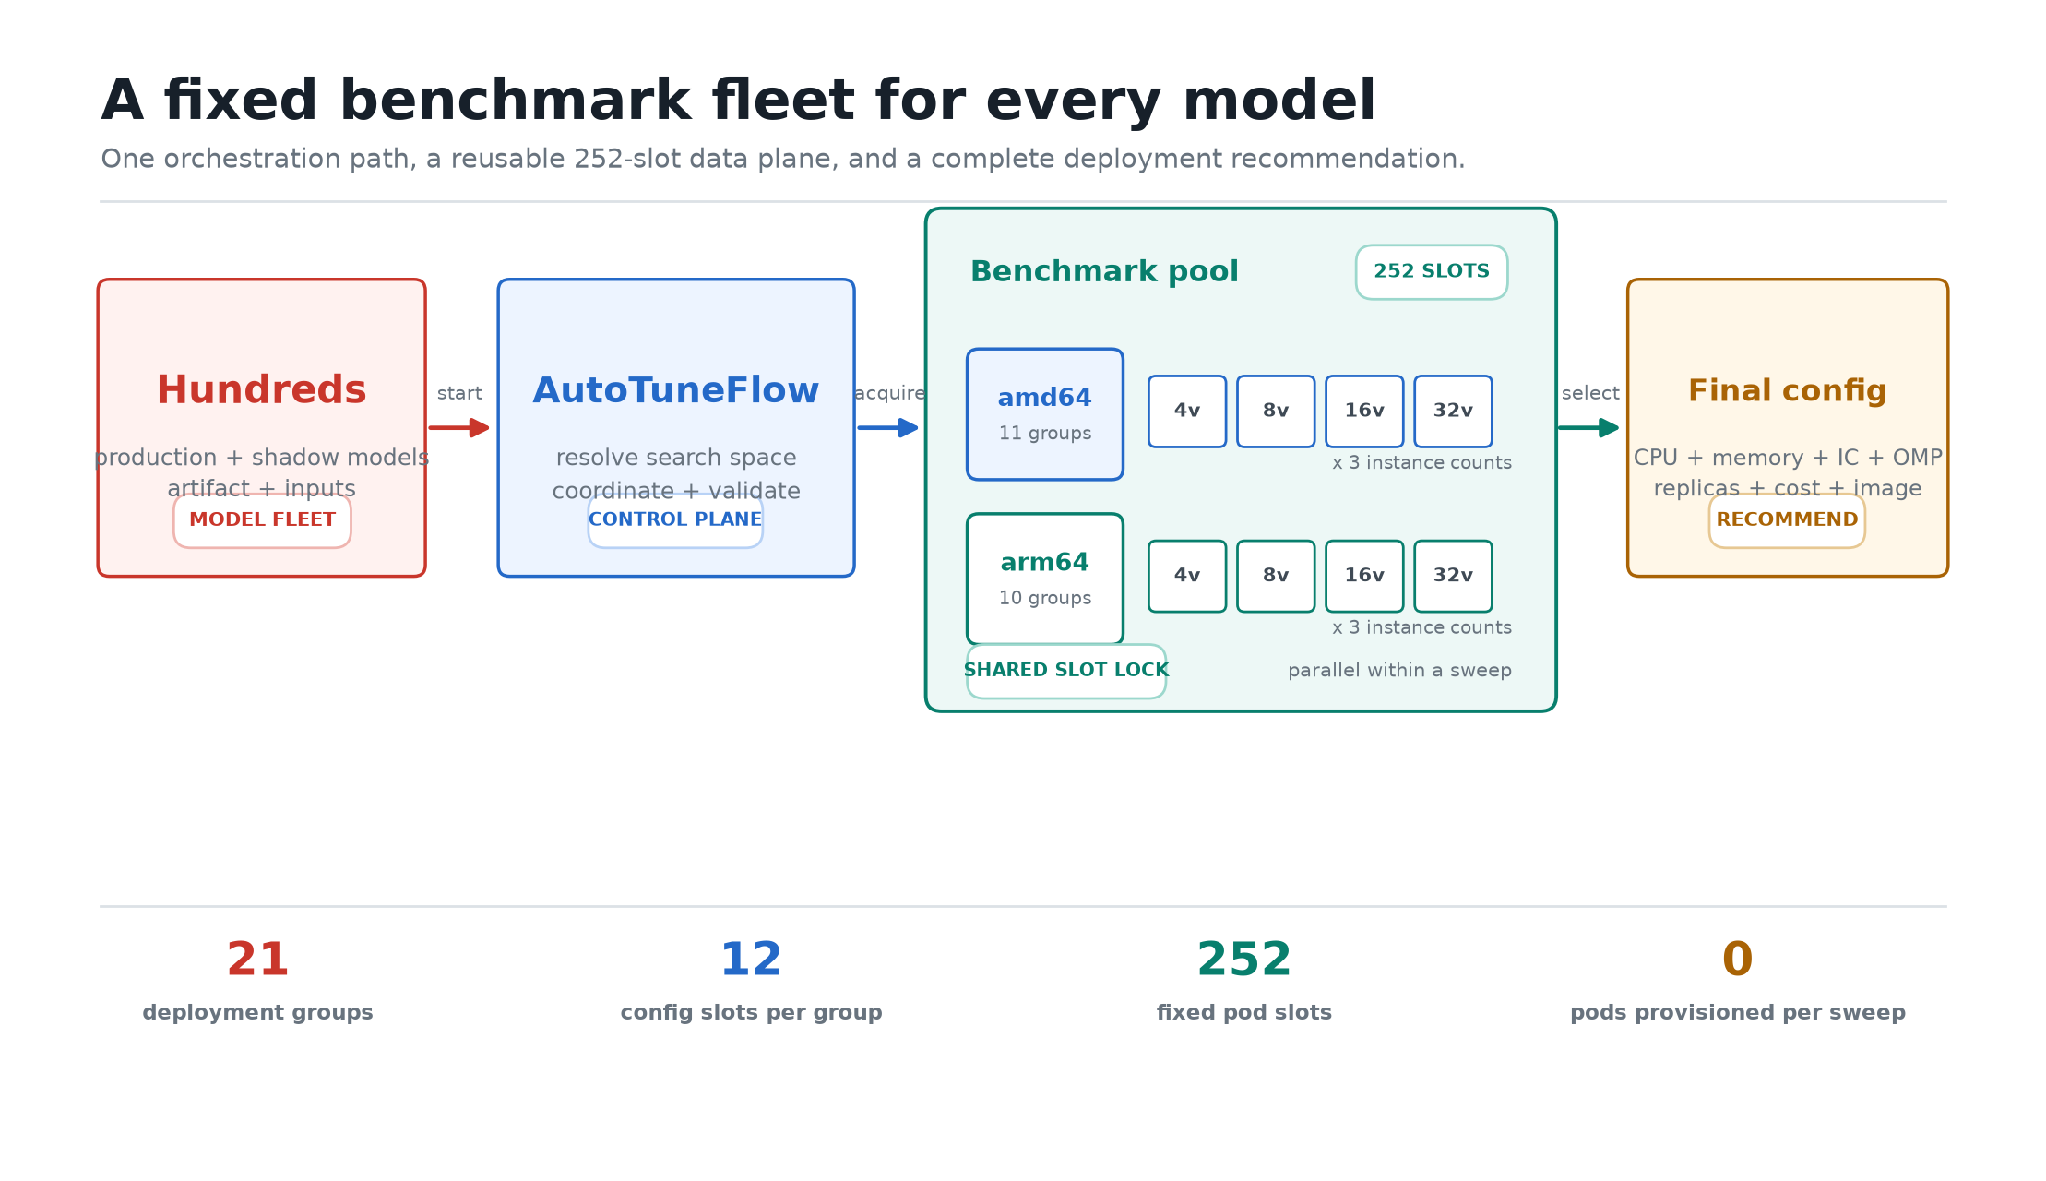
מישור הנתונים של מבחן הביצועים מכיל 252 משבצות פוד שהוקצו מראש, הפרושות על פני 21 קבוצות פריסה בפלטפורמות amd64 ו-arm64.

מאגר קבוע במקום תשתית לכל מודל בנפרד

כל קבוצת פריסה מכילה 12 משבצות ייעודיות המכסות ארבע רמות מעבד (4, 8, 16 ו-32 vCPU) ושלוש אפשרויות למספר מופעים של Triton עבור כל רמה. תהליך סריקה רוכש קבוצה זמינה אחת ומריץ את שילובי הרמות ומספר המופעים במקביל. מודלים שונים יכולים להשתמש בקבוצות פריסה שונות בו-זמנית. 

נעילה הנתמכת ב-S3 מתאמת את הגישה. אם קבוצה מסוימת עסוקה או אינה תקינה, המתאם עובר לקבוצה זמינה אחרת. הדבר מאפשר לנו שני סוגים של מקביליות: המועמדים פועלים במקביל בתוך סבב אחד, וניתן לכוונן מספר מודלים במקביל בכל הצי המשותף. 

מאגר המשאבים הקבוע, המונה 252 חריצים, תומך בכוונון של מאות מודלים פעילים ומודלים צללים. הגדלת מספר המודלים מגדילה את ניצולת הפלטפורמה, ולא את התשתית הנדרשת לכל ריצה בנפרד. 

ביצועי ייחוס באמצעות הכלי perf_analyzer של NVIDIA

כל פוד של מבחן ביצועים מפעיל את perf_analyzer של NVIDIA באמצעות מודל מבחן ביצועים קטן הפועל במקביל למודל היעד. perf_analyzer שולח בקשות gRPC אסינכרוניות דרך localhost בכל רמת מקביליות מבוקשת, בעוד שה-runner מתעד את התפוקה ואת זמן ההשהיה וקורא את מוני ה-CPU של ה-cgroup בפוד. כך מתקבלת מדידה עקבית אחת של QPS, זמן השהיה p99, וכן אותו אות CPU ש-HPA של Kubernetes רואה. 

ה-in-pod runner משלב את יצירת התעבורה, מדידות המודל וניצול המעבד של cgroup לתוצאה אחת עבור כל תצורה מועמדת.

הגדרה מחדש של Triton ללא הפעלה מחדש של הפודים

ה-pods של מבחן הביצועים מריצים את Triton במצב של שליטה מפורשת במודל. עבור כל מועמד, המכוון טוען את המודל היעד באמצעות ממשק ה-API לשליטה במודל של Triton ומעביר את ה-ModelConfig של המועמד כהגדרה חלופית. לאחר מכן, הוא יכול לפרוק את המודל ולעשות שימוש חוזר ב-pod לסבב הבא. 

מחזור חיים זה מונע עריכת S3, עיכוב בסריקת המאגר או הפעלה מחדש של הפוד עבור כל מועמד. מדידה אחת מתבצעת לפי אותו רצף: 

  1. הקימו קבוצת ביקורת.
  2. טען את תוכנת הרצת מבחני הביצועים ואת המודל היעד.
  3. יש לאמת את נתוני הקלט ולחמם את המודל.
  4. הפעל את perf_analyzer ברמות שונות של ריבוי משימות.
  5. תעד את מדידות ה-QPS, זמן ההשהיה וה-CPU.
  6. הוצא את המודל ושחרר את הקבוצה.
כל שכבה וכל משבצת למספר מופעים עוברות במקביל את מחזור החיים הזה. התוצאות חוזרות לאותו תהליך לצורך קביעת התצורה ובחירת העלות.

מספר המדידות המדויק תלוי בארכיטקטורות המעבד, ברמות השירות, במספר המופעים, בגודל האצוות וברמות המקבילות המבוקשות. מכיוון ששילובי רמות השירות ומספרי המופעים התובעניים פועלים במקביל, הרחבת מטריצת החיפוש אינה מתורגמת באופן ישיר לזמן שעון. 

מדוע השינוי בתצורה השפיע כל כך הרבה על הביצועים

להסקת נתונים ב-PyTorch על מעבד (CPU) יש שתי צורות של מקביליות. Triton יכול להריץ מספר עותקים של מודל במקביל, בעוד שכל עותק יכול להשתמש במספר תהליכים של OpenMP במסגרת הסקה אחת. אמצעי בקרה אלה שימושיים כל אחד בנפרד, אך יש לכוונן אותם יחד. 

התבנית המוגדרת כברירת מחדל בפוד בעל N ליבות היא לרוב מופע אחד של Triton המשתמש ב-N חוטים. עבור רבים מהמודלים שלנו, תבנית טובה יותר הייתה N מופעים בעלי חוט יחיד: 

instance_group.count = vCPU
OMP_NUM_THREADS = 1
OMP_DYNAMIC = FALSE
INTRA_OP_THREAD_COUNT = 1

פעולה זו הופכת עובד הסקה יחיד בעל ריבוי-תהליכים רב למספר עובדים עצמאיים. כמו כן, היא מונעת את התרחיש הגרוע ביותר, שבו מספר מופעים של Triton יוצרים כל אחד מאגר תהליכים בגודל מלא ומתחרים על אותם ליבות. 

לפיכך, המכוון מתייחס למספר המופעים ולמספר ה-threads כהחלטה אחת במסגרת התצורה. באופן כללי, הוא שומר על: 

instance_group.count × OMP_NUM_THREADS ~= vCPU

הבחירה בין מספר רב יותר של מופעים למספר רב יותר של תהליכים עדיין תלויה במודל, ולכן אנו מודדים אותה במקום לקבוע תשובה אחת קבועה לכל הצי. 

תצורהQPSזמן השהיה p99מעבד
1 מופע, 32 תהליכים68126 מילי-שניות67%
32 מופעים, כל אחד עם חוט אחד86314 מילי-שניות16%

במסגרת הניתוח המעודכן, השוואת מופע Triton אחד לכל vCPU למופע בודד באותה דרגת חומרה הניבה עלייה ממוצעת ב-QPS הגולמי של פי 1.75 ב-4 vCPU, פי 2.31 ב-8 vCPU, פי 3.65 ב-16 vCPU ופי 6.78 ב-32 vCPU. המודל והדרגת החומרה נותרו ללא שינוי; רק תצורת השירות השתנתה. 

היתרון שנמדד בתצורה גדל ככל שגודל הפוד גדל. ירידות חדות בתפוקה הופיעו ב-44 מתוך 219 תוצאות של מופע יחיד הניתנות להשוואה, ובאף אחת מ-206 התוצאות של מופע אחד לכל vCPU.

התיעוד של PyTorch בנושא ריבוי-תהליכים במעבד (CPU threading ) מתאר בפירוט רב יותר את האינטראקציה בין מקביליות בין-פעולות (inter-op) למקבילות תוך-פעולות (intra-op). 

מה למדנו בכלל הצי

תנו ל-Sweep לבחור את רמת המעבד

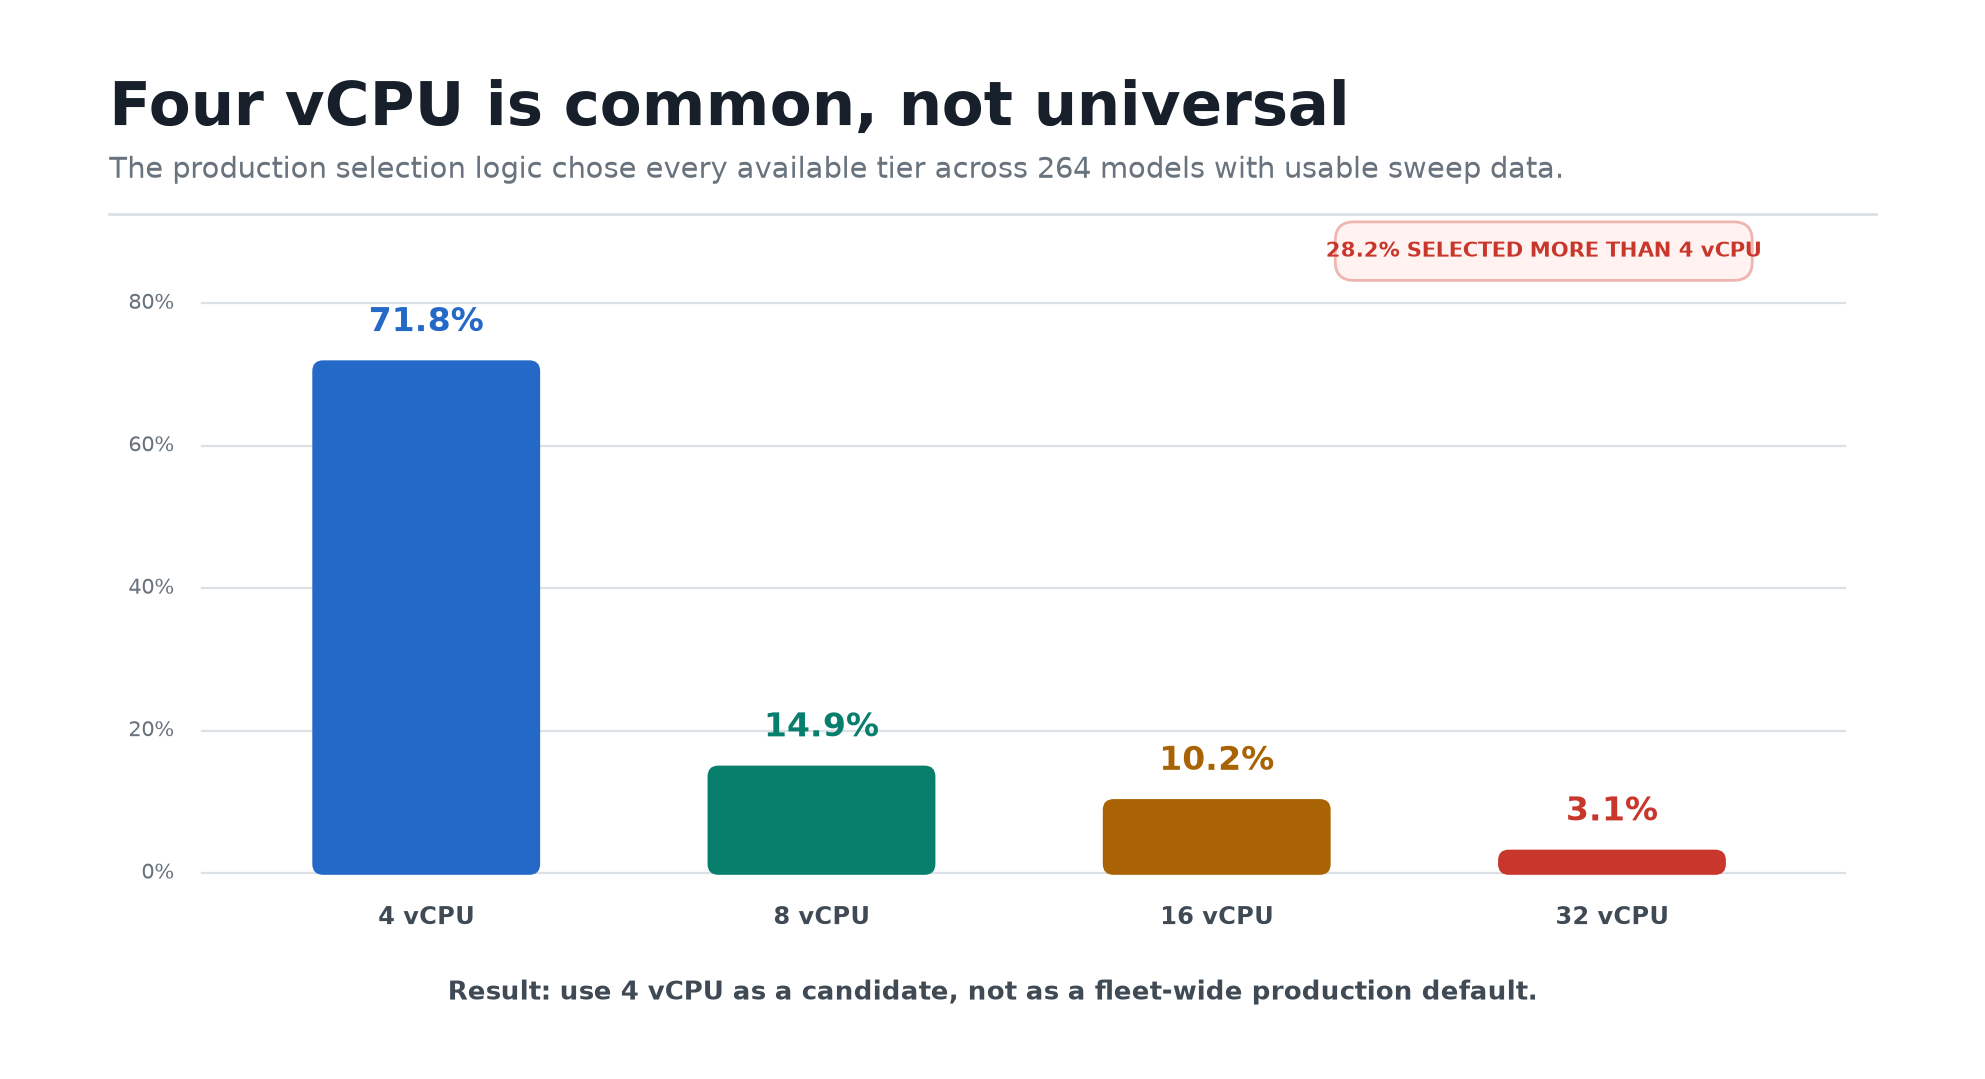
בניתוח המעודכן של 264 הדגמים, 4 vCPU נבחרו בתדירות הגבוהה ביותר (71.8%), ואחריהם 8 vCPU (14.9%), 16 vCPU (10.2%) ו-32 vCPU (3.1%). הדרגות הגדולות יותר נבחרו ב-28.2% מהדגמים. 

כל רמת מעבד זמינה הייתה אופטימלית עבור לפחות חלק מהמודלים.

ארבעה vCPU הם אופציה טובה להתחלה, אך לא הגדרת ברירת המחדל בסביבת ייצור. הכלי לכוונון מעריך את רמות השירות הזמינות ובוחר את זו שמספקת את הקיבולת הטובה ביותר ביחס לעלות, תוך עמידה ביעד החביון של המודל. 

ה-CPU לבדו לא תמיד משקף את רמת העומס

ב-Kubernetes HPA נוהגים להעריך את הקיבולת על ידי התאמת התפוקה הנצפית ביחס לניצולת המעבד: 

QPS החזוי = QPS נוכחי × (CPU היעד / CPU שנמדד)

זה עובד כאשר המעבד הוא המשאב המגביל. זה נכשל כאשר התפוקה מגיעה לראשונה לרמת מיצוי. בבדיקה אחת עם 8 vCPU, המעבד הגיע לרמת מיצוי של 26%, ולכן יעד HPA של 40% הצביע על קיבולת של 1,252 QPS. המודל הגיע לרוויה ב-829 QPS, מה שמעיד על הערכת יתר של פי 1.5. 

Triton חושף אותות תור כגון nv_inference_pending_request_count ומשך התור, המתארים את הרוויה באופן ישיר יותר. אנו מתקדמים לקראת אות לכוונון אוטומטי המשלב את עומס המעבד עם הלחץ בתור. 

מתוצאות הבדיקה לתצורת הייצור

ה-Tuner עושה יותר מאשר רק לדרג שורות של מדדי ביצועים. הוא משלב את הקיבולת הנמדדת לכל Pod עם טווח ה-QPS של המודל בייצור, מחשב את דרישות הרפליקציות ואת העלות הצפויה, מאמת את השינוי המוצע, ומייצר את הגדרות העקיפה לפריסה המשמשות את תהליך העבודה של המסירה. 

  • ארכיטקטורת המעבד ודרגת ה-vCPU
  • הקצאת זיכרון
  • מספר המופעים של Triton
  • הגדרות חוטים ב-OpenMP
  • QPS הצפוי וזמן ההשהיה ב-p99
  • מספר העותקים המינימלי והמקסימלי
  • תמונת הגשה
  • עלות משוערת

כך נסגר הפער בין מבחן ביצועים לתצורת ייצור תפעולית. בנוסף, הדבר מאפשר לשחזר את ההמלצה: המדידות, התצורה שנבחרה ונתוני העלות נשמרים יחד, במקום להישאר במחברת של מהנדס. 

תמיכה במעברי פלטפורמות ובהכשרה מתמשכת

ה-Tuner תומך כעת בשני תהליכי עבודה חוזרים בפלטפורמה. במהלך מעברי פלטפורמה, הוא מעניק לכל מודל תצורה מותאמת לסביבת ההפעלה היעד, במקום להעביר הנחות מהפלטפורמה הקודמת. אותה אינטגרציה מאפשרת לתהליכי עבודה של אימון רציף לבחון מחדש את תוצרי המודל החדשים עם יצירתם, כך שהגדרות ההפעלה יוכלו להתפתח יחד עם המודל. 

שני תהליכי העבודה משתמשים במאגר הבנצ'מרק המשותף ובאותה לוגיקת בחירה. הדבר מספק לתהליכי ההעברה וההכשרה מחדש מסלול עקבי לאימות ביצועים, מבלי לצור צורך בצוותי המודלים לבנות תשתית בנצ'מרק נפרדת. 

הלקח הרחב יותר

תצורת השירות היא חלק מביצועי המודל. אימון מחדש ואופטימיזציה של הקוד הם גורמים חשובים, אך אף אחד מהם אינו הכרחי כדי לשחזר את הקיבולת שאבדה עקב הגדרות ברירת המחדל בזמן ריצה. 

ברמת הצי, היכולת החשובה אינה כלל בודד כגון "השתמש בפודים עם 4 vCPU" או "הגדר את OpenMP לערך 1". מדובר במערכת הניתנת לשחזור, המסוגלת לבחון את ההנחות הללו מול כל מודל, בתנאים עקביים, ולהפוך את התוצאה לתצורה הניתנת לפריסה. 

בצי השרתים שלנו, מערכת זו זיהתה עלייה ממוצעת ב-QPS בטווח שבין 1.75x ל-6.78x בכל רמות המעבדים, הדגימה מדוע יש למדוד את רמת המעבד עבור כל מודל בנפרד, והחליפה את תהליך קביעת הגודל הידני בתהליך כוונון משותף המותאם למאות מודלים. מאגר מבחני הביצועים נותר קבוע גם כאשר מספר המודלים שהשתמשו בו גדל. 

מה הצעד הבא?

הפוסט הראשון התמקד במודלים של Triton הנתמכים על ידי מעבד (CPU). בחלק הבא, נסביר כיצד אנו מרחיבים את אותו תהליך עבודה של כוונון אוטומטי למודלים הנתמכים על ידי מעבד גרפי (GPU), כולל מרחב התצורה של ה-GPU, אותות קיבולת ספציפיים למאיץ, והשינויים הנדרשים בשכבת המדידה. שכבות התזמור והבחירה נותרות ניתנות לשימוש חוזר, מה שמספק למודלים של ה-GPU את אותו מסלול חוזר, החל מארטפקט המודל ועד לתצורת ייצור מאומתת. 

תודות

  • פלטפורמת ה-ML Serving: ארווינד קליאן, קיונגאה קים, הייפנג גנג, עמנואל ח'יאט, ג'פרי ני, סונגזה לי, טיר יינג, פייג'ין דנג, ז'ה ליו, ג'נג-יאנג וואנג
  • צוות Ads ML: אוטסאו קומאר, קין סום ליו, בנג'מין יאנג, פראבין גונדי

הישארו מעודכנים עם עדכונים שבועיים

הירשמו לבלוג ההנדסה שלנו כדי לקבל עדכונים שוטפים על כל הפרויקטים הכי מגניבים שהצוות שלנו עובד עליהם
צוות הנתונים של DoorDash אחראי על הפקת תובנות מדויקות מהנתונים ועל מתן תשובות לשאלות עסקיות מרכזיות: 

  • מדוע חלה ירידה בהיקף ההזמנות בקליפורניה בשבוע שעבר? 
  • איך מתפקד המוצר החדש מאז השקתו? 
  • אילו סוחרים נמצאים בסיכון לעזוב את מוצרי השיווק שלנו?
  • הצג לי את ההזמנות שבוטלו לפי שעה ב-90 הימים האחרונים ב-Arby’s

מודלים סוכניים מסוג "Frontier", בשילוב עם מערכות ניהול סוכנים כגון Codex ו-Claude Code (CC), מהווים כלים עוצמתיים לאינטראקציה עם הנתונים שלנו ולמתן מענה לשאלות מסוג זה. עם זאת, לעתים קרובות ביצועיהם אינם מיטביים כאשר הם מתמודדים עם כמויות גדולות של נתונים חצי-מובנים, הנפוצים בחברות בקנה מידה גדול. קיימת אתגר בהבטחת כך שלכל הפונקציות העסקיות — לרבות תפעול, הנדסה, שיווק ומוצר — תהיה גישה לנתונים עדכניים ונכונים, שמהם יוכלו להסיק את המסקנות הנכונות.

"הבעיה היא, למעשה, שמקורות הנתונים שלנו בשלב המוקדם מאוד מפוצלים", ציין מנהל בכיר בתחום הניתוח, שבחן את הכלים הקודמים שלנו. הכלים הללו היו או ממוקדים מאוד בתחום אחד, או רחבים אך שטחיים. 

כתוצאה מכך, פיתחנו את "ורה" (Vera), סוכנת נתונים שיחתית פנימית. גילינו כי פיתוח והתאמת כל חלקי הצינור — הצגת שאלות, דירוג ואחזור, וכן מיומנויות ספציפיות לתחום — הובילו לשיפורים משמעותיים בביצועים בהשוואה לסוכנים סטנדרטיים המצוידים במחברי נתונים פשוטים. "המערכת פעלה היטב בשאלות אסטרטגיות בתחום הפיננסי בכל רמות הקושי. התרשמתי מאוד", אמר מנהל פיננסי לאחר מספר שבועות של בדיקת "ורה".

מדוע פיתחנו את זה בעצמנו

סוכנים מודרניים מסוגלים בדרך כלל לענות על שאלות הקשורות לנתונים בסביבה נקייה. אך שכבת נתונים סמנטית חזקה היא המפתח להבטחת כך שהסוכנים הללו יפיקו תשובות נכונות שהארגון יכול לסמוך עליהן. הבהרת המשמעות הסמנטית ופתרון סתירות בה ברחבי הארגון אינם עניין של מה בכך; זו משימה דחופה להרחיב את שכבת הנתונים הזו תוך שמירה על דיוק. 

לדעתנו, המפתח להרחבת השימוש ב-Vera הוא לאפשר לבעלי התחומים — האנשים הקרובים ביותר לנתונים — לתרום ולבדוק את ההערכות. בעל תחום הוא המומחה המקצועי האחראי על אופן המדידה של תחום עסקי מסוים. קל יותר לבנות את הלולאה ההדוקה הזו כאשר יש לנו שליטה מלאה על מערך הטכנולוגיות. 

בפוסט זה נסקור את העיצוב הכללי של Vera ואת מדדי הביצועים שלה, נדון בבחירות הארכיטקטוניות ונציג מחקרים השוואתיים בין סוגי מודלים ושיטות הסקת מסקנות.

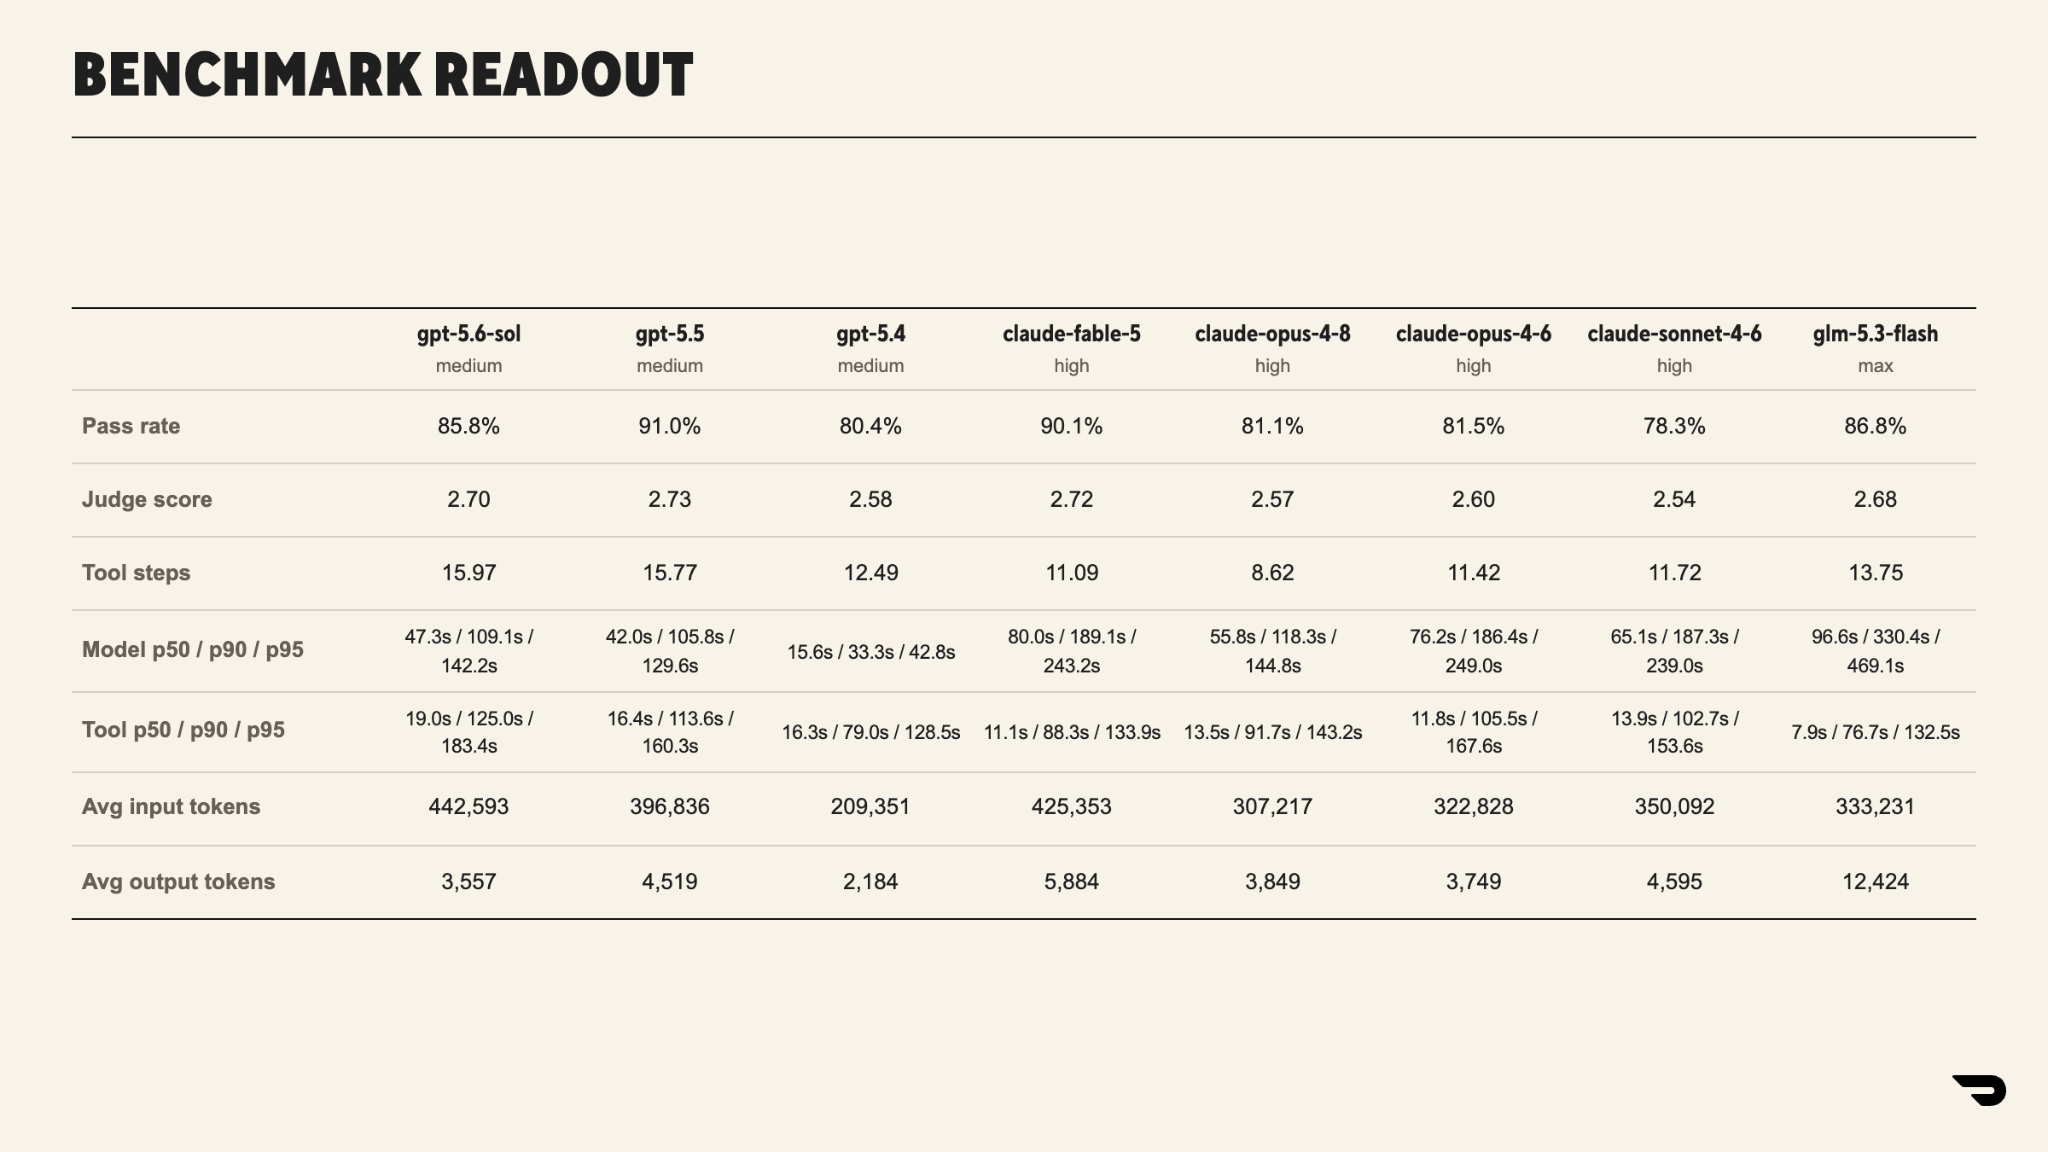
טבלה 1: ריצת ביצועי ייחוס אחת מלאה, כאשר כל הדגמים נבדקו באותה סביבת בדיקה. הדגמים המובילים נמצאים במרחק של מספר נקודות בודדות זה מזה מבחינת הציון, ולכן ההבדלים ביניהם מתבטאים בחביון, במספר הצעדים ובמספר הטוקנים.

מאגר נתוני ההערכה שלנו משתרע על פני 19 תחומי פעילות שונים, הכוללים את תחומי המכירות, הכספים, המוצרים והתפעול בחברת DoorDash, וכולל יותר מ-1,900 הערכות שהוגשו. רמת המורכבות של ההערכות משתנה, כאשר חלק מהשאלות דורשות קריאות רבות לכלים והסקת מסקנות מפורטת. 

מודל הייצור הנוכחי – GPT 5.5 – זוכה לציון הכולל הגבוה ביותר במבחן ההשוואה. אין בכך הפתעה, שכן ביצענו אופטימיזציה של הפקודות והמיומנויות במיוחד עבור מודל זה, ואנו שואפים לשכפל זאת בקרוב בכל משפחות המודלים.  

התשובות הסופיות מדורגות על ידי שופט LLM על פי שלושה קריטריונים: שימוש בכלים, בחירת טבלאות ונכונות התשובה הכוללת. במקרים שבהם למבחני ההערכה אין שאילתת SQL חד-משמעית, מומחים בתחום מספקים קריטריוני שיפוט מפורטים. הציון המרבי בתכנון זה הוא 3.0; כפי שמוצג בטבלה 1, המודלים המתקדמים ביותר של Anthropic ו-OpenAI נמצאים במרחק של כמה נקודות זה מזה.

כמו כן, אנו מדווחים על קריאות לפקודות ועל שיעורי ההשלמה. מכיוון שהמודלים כותבים את שפת ה-SQL בעצמם, ריצה מלאה מפעילה מספר רב של שאילתות כבדות במקביל. חלקן מגיעות למגבלת הזמן של מסד הנתונים, מה שנחשב ככישלון בחישוב שיעור ההצלחה, ולא כתשובה שגויה.  

הפער בין ריצה לריצה של מדד הייחוס עומד על כ-4 נקודות אחוז בשיעור ההצלחה, ללא תלות במודל; הבדלים קטנים יותר נחשבים לרעש. אחד התורמים דואג לעדכן את ההערכות עצמן. הערכה המגדירה חלון זמן יחסי — למשל, "מה היה קצב הטיפול בהזמנות בחנות זו בשבוע שעבר?" — מאבדת מהר מהרלוונטיות שלה.

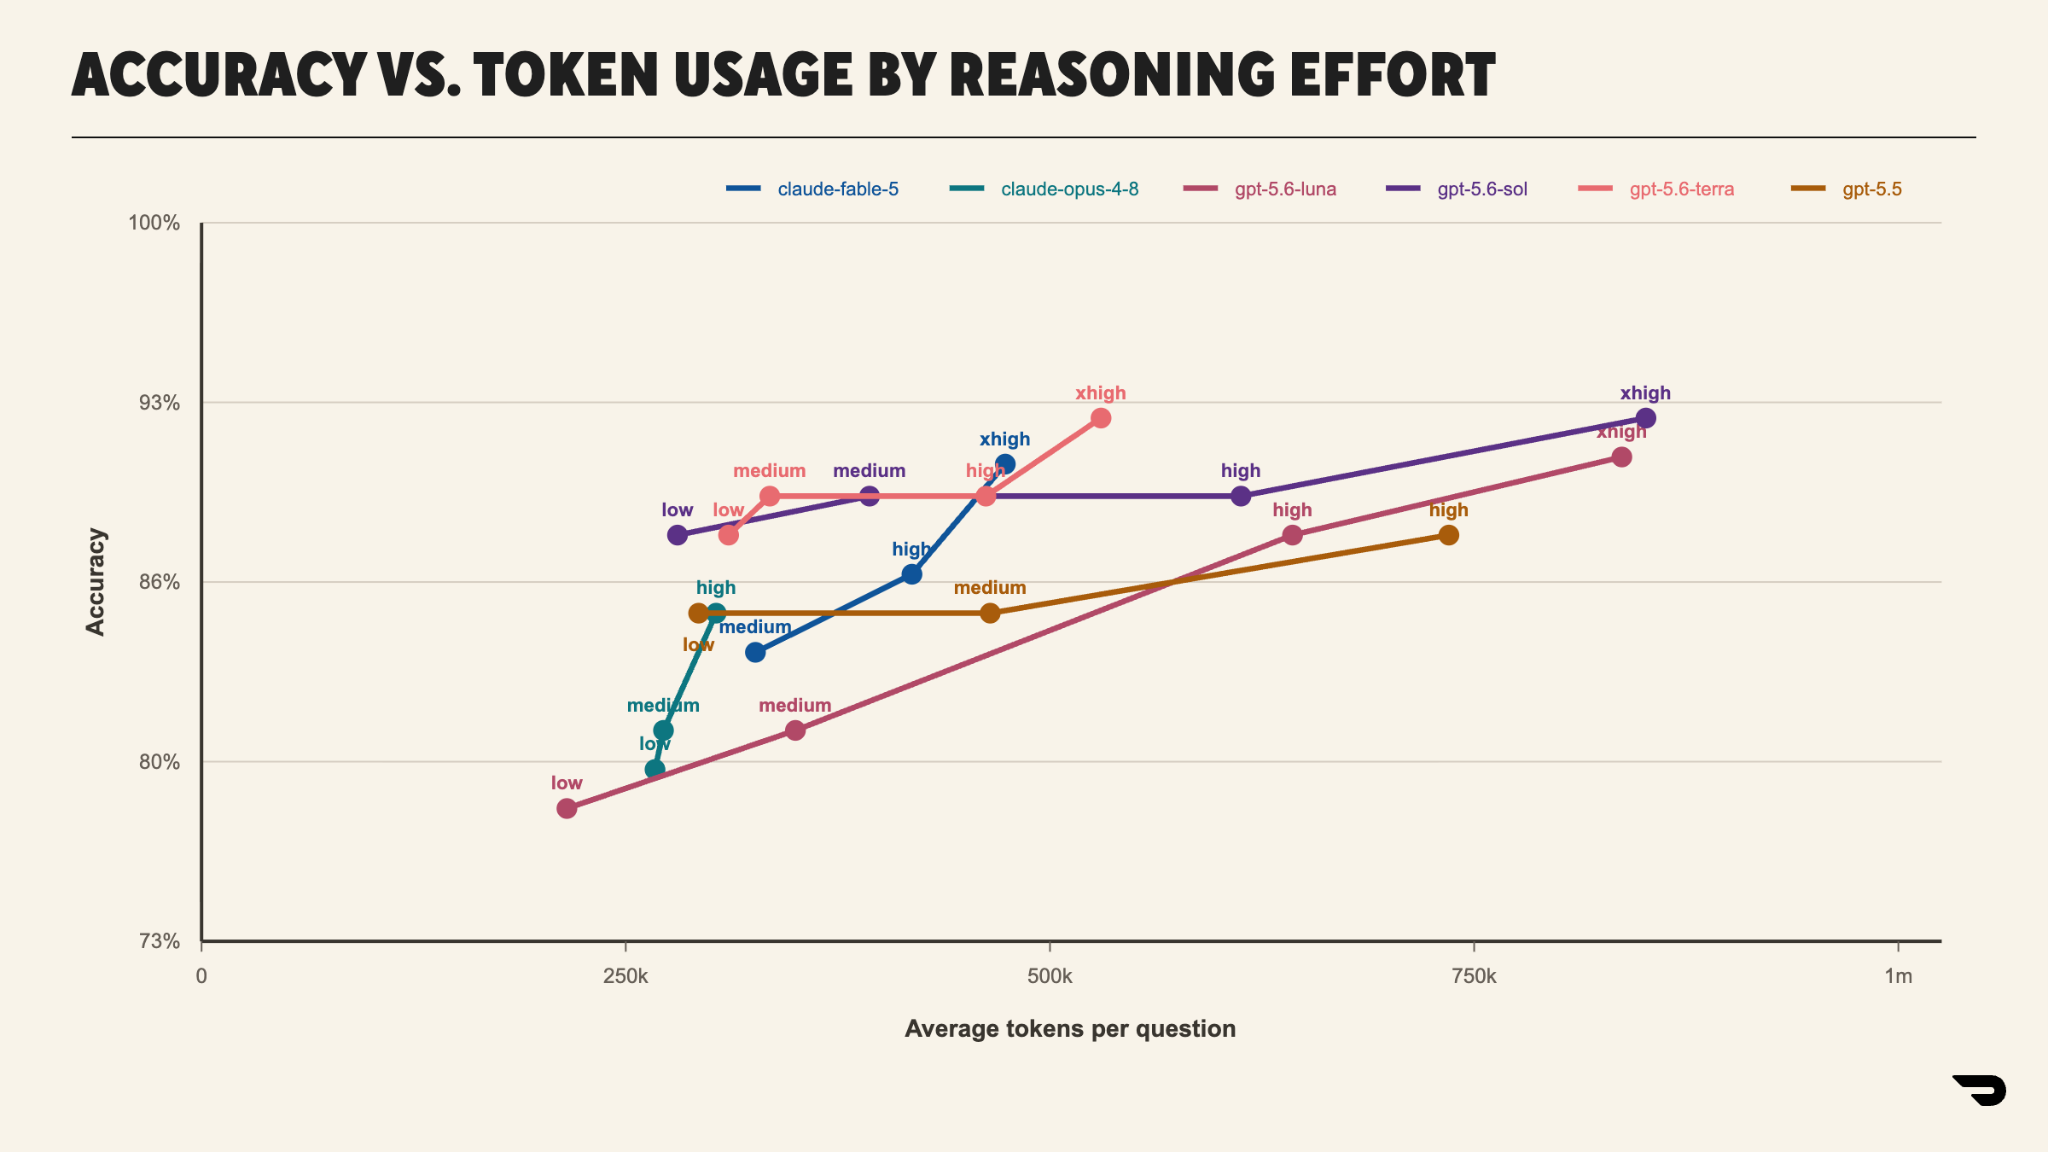
אמנם מודלים מתקדמים משיגים ביצועים טובים עם מערך הבדיקה שלנו במבחן ביצועים זה, אך קיימים שיקולי פשרה שונים בנוגע לזמן השהיה, לשימוש בכלים ולעלות, בהתאם למודל ולספק. אנו בוחרים במודל הייצור של Vera על סמך שיקולי פשרה אלה ולא רק על סמך הציון הכללי, ומריצים את מבחן הביצועים מחדש עם השקת מודלים חדשים. ניסויי ההשמטה הללו מתבצעים על תת-קבוצה של 100 שאלות, ולכן הבדלים של כמה נקודות נכללים בהגדרתנו ל"רעש". בכל סוגי המודלים, מאמץ חשיבה רב יותר משפר את הציון.

איור 1: דיוק ביחס למספר הטוקנים לכל שאלה בתת-קבוצה של 100 שאלות. כל קו עולה ככל שהמאמץ גדל, והם מתכנסים לקראת החלק העליון, כך שהמאמץ הוא גורם חשוב לצד בחירת המודל, והמחיר שלו נמדד בטוקנים.

פער הביצועים בקצה הטכנולוגי קטן, כאשר הן מודלי OpenAI והן מודלי Anthropic משיגים ציונים דומים לאחר מאמץ ממושך. מטבע הדברים, הגדלת תקציב ההסקת המסקנות מובילה לעלייה בזמן ההשהיה.

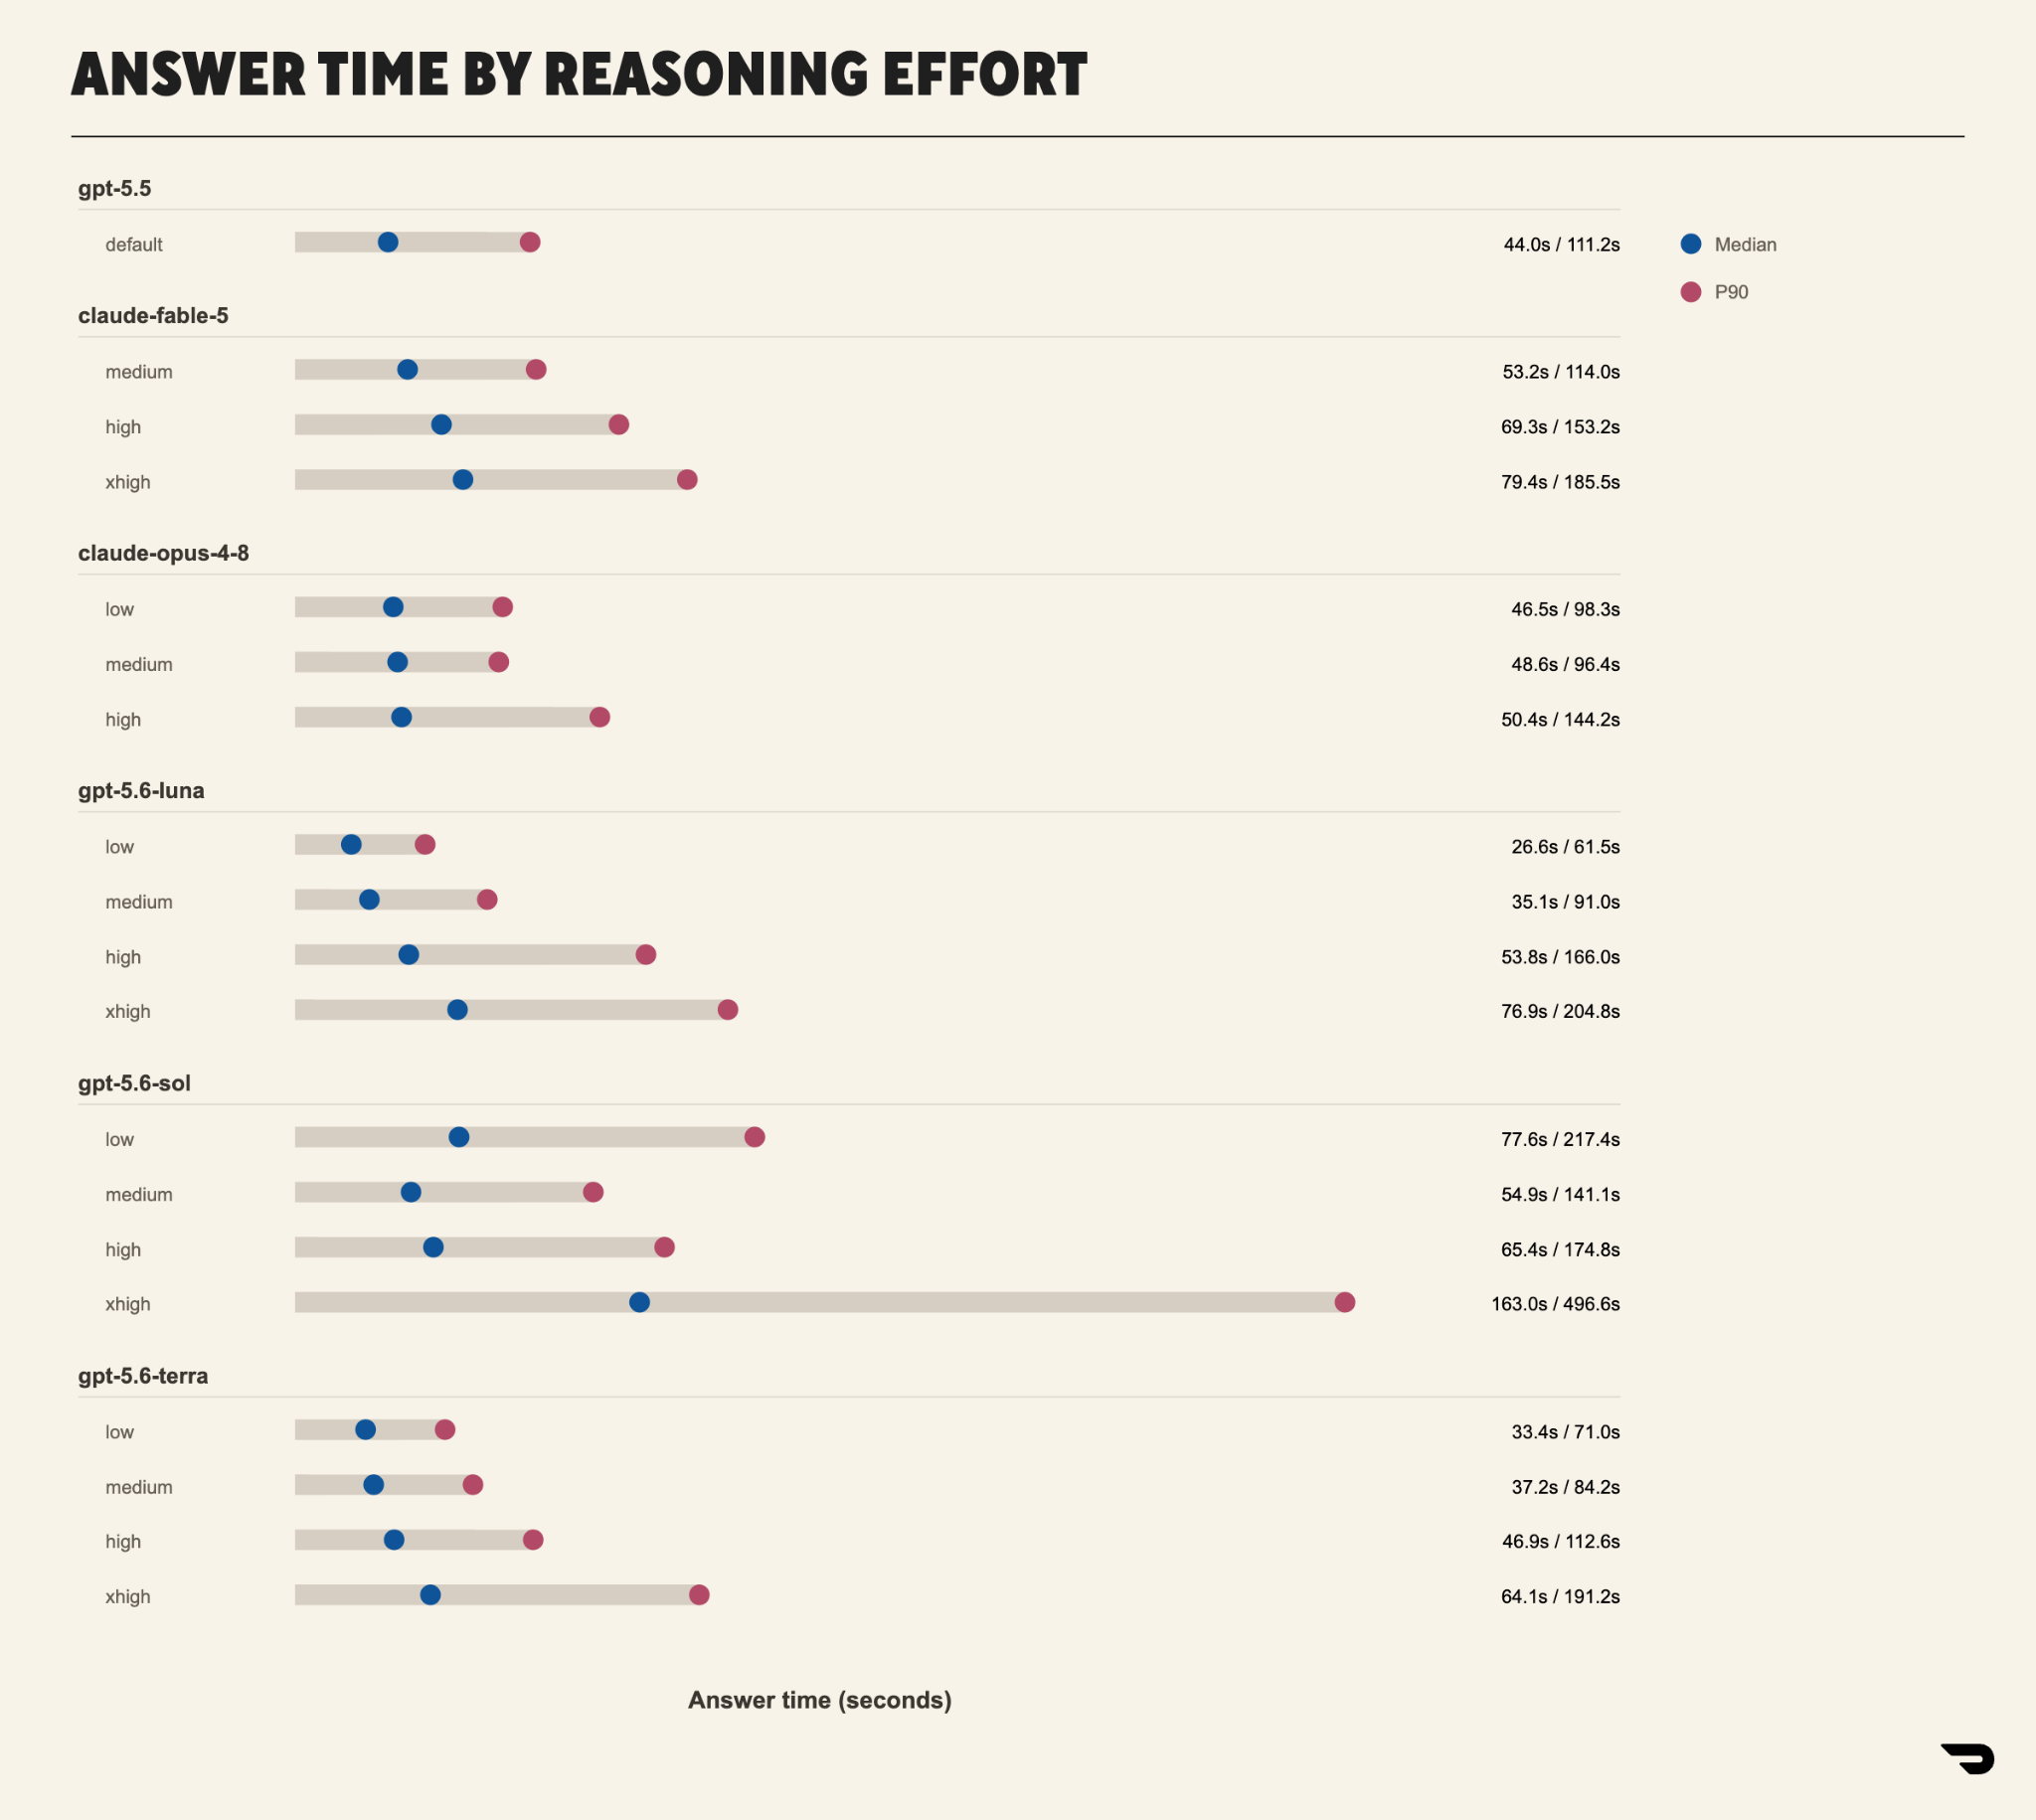
איור 2: זמן התגובה החציוני וזמן התגובה ב-p90 עבור אותם מודלים ורמות מאמץ. מאמץ רב יותר מביא לדיוק רב יותר, אך כרוך בזמן רב יותר.

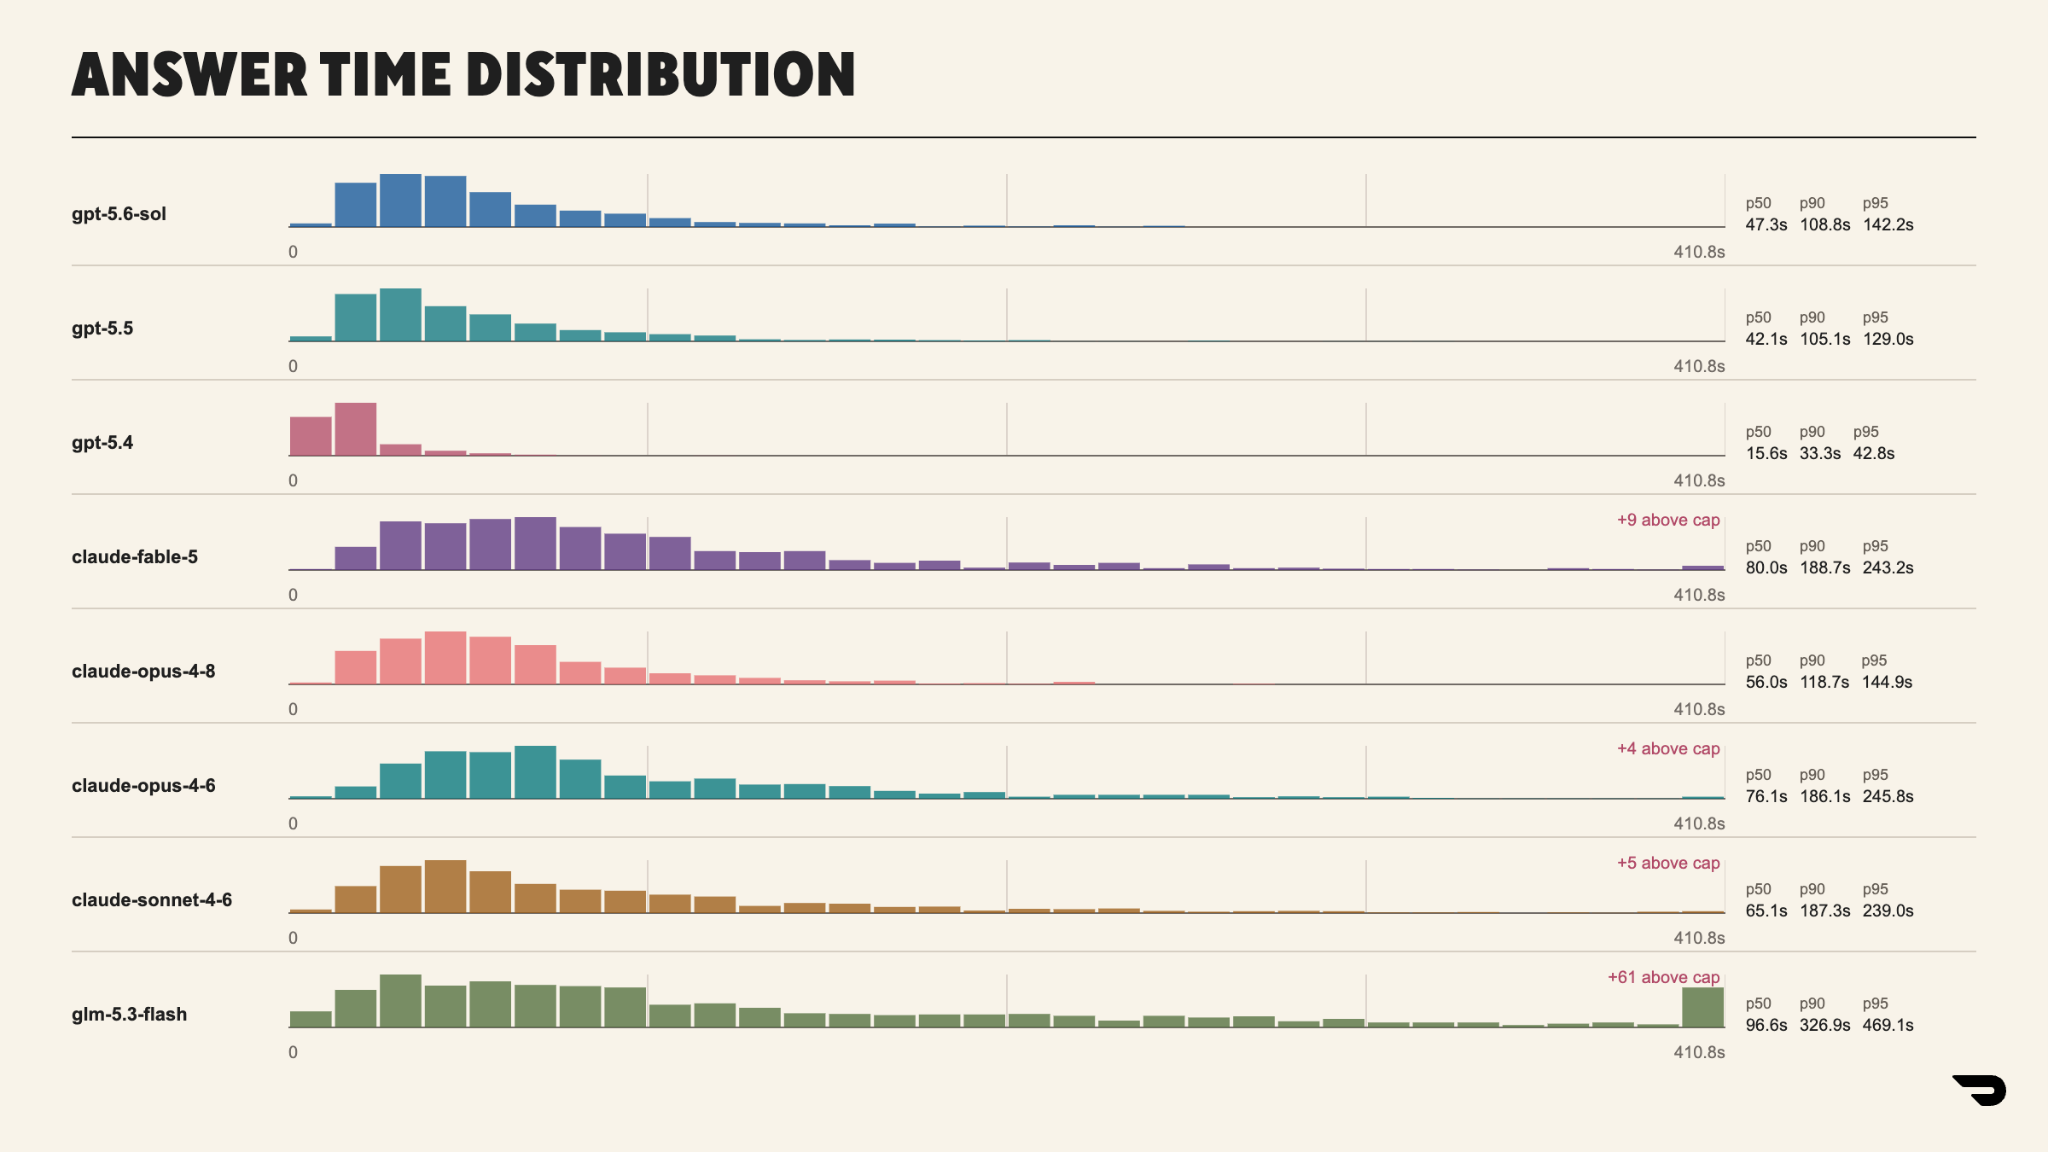
אמנם מאמץ חשיבה רב יותר מעלה באופן מונוטוני את ציון מבחן הביצועים, אך השפעה זו עלולה להזיק למערכת כולה, בדמות תגובות ארוכות יותר למשתמש ופנייה תכופה יותר של הכלים למאגר הנתונים, מה שמגביר את הסבירות ל"זמן פקיעה" ולתוצאות חלקיות. זיהינו את התפלגויות הזמנים הבאות בקרב הדגמים, כפי שמוצג באיור 3:

איור 3: התפלגות זמני התשובה לפי מודל בריצה המלאה. הזנב, ולא החציון, הוא הגורם לזמני פקיעה ולתוצאות חלקיות.

במסגרת הבדיקה שלנו, זמן ההשהיה של הזנב במודלים של Anthropic היה ארוך יותר מזה של המקבילים שלהם ב-OpenAI. לצורך השוואה גסה, אירחנו מופע פנימי של GLM 5.3 Flash באמצעות נקודות קצה של Modal, אם כי היות והמערכת לא הייתה מותאמת, נרשמו תקלות זמן משמעותיות תחת עומס כבד. 

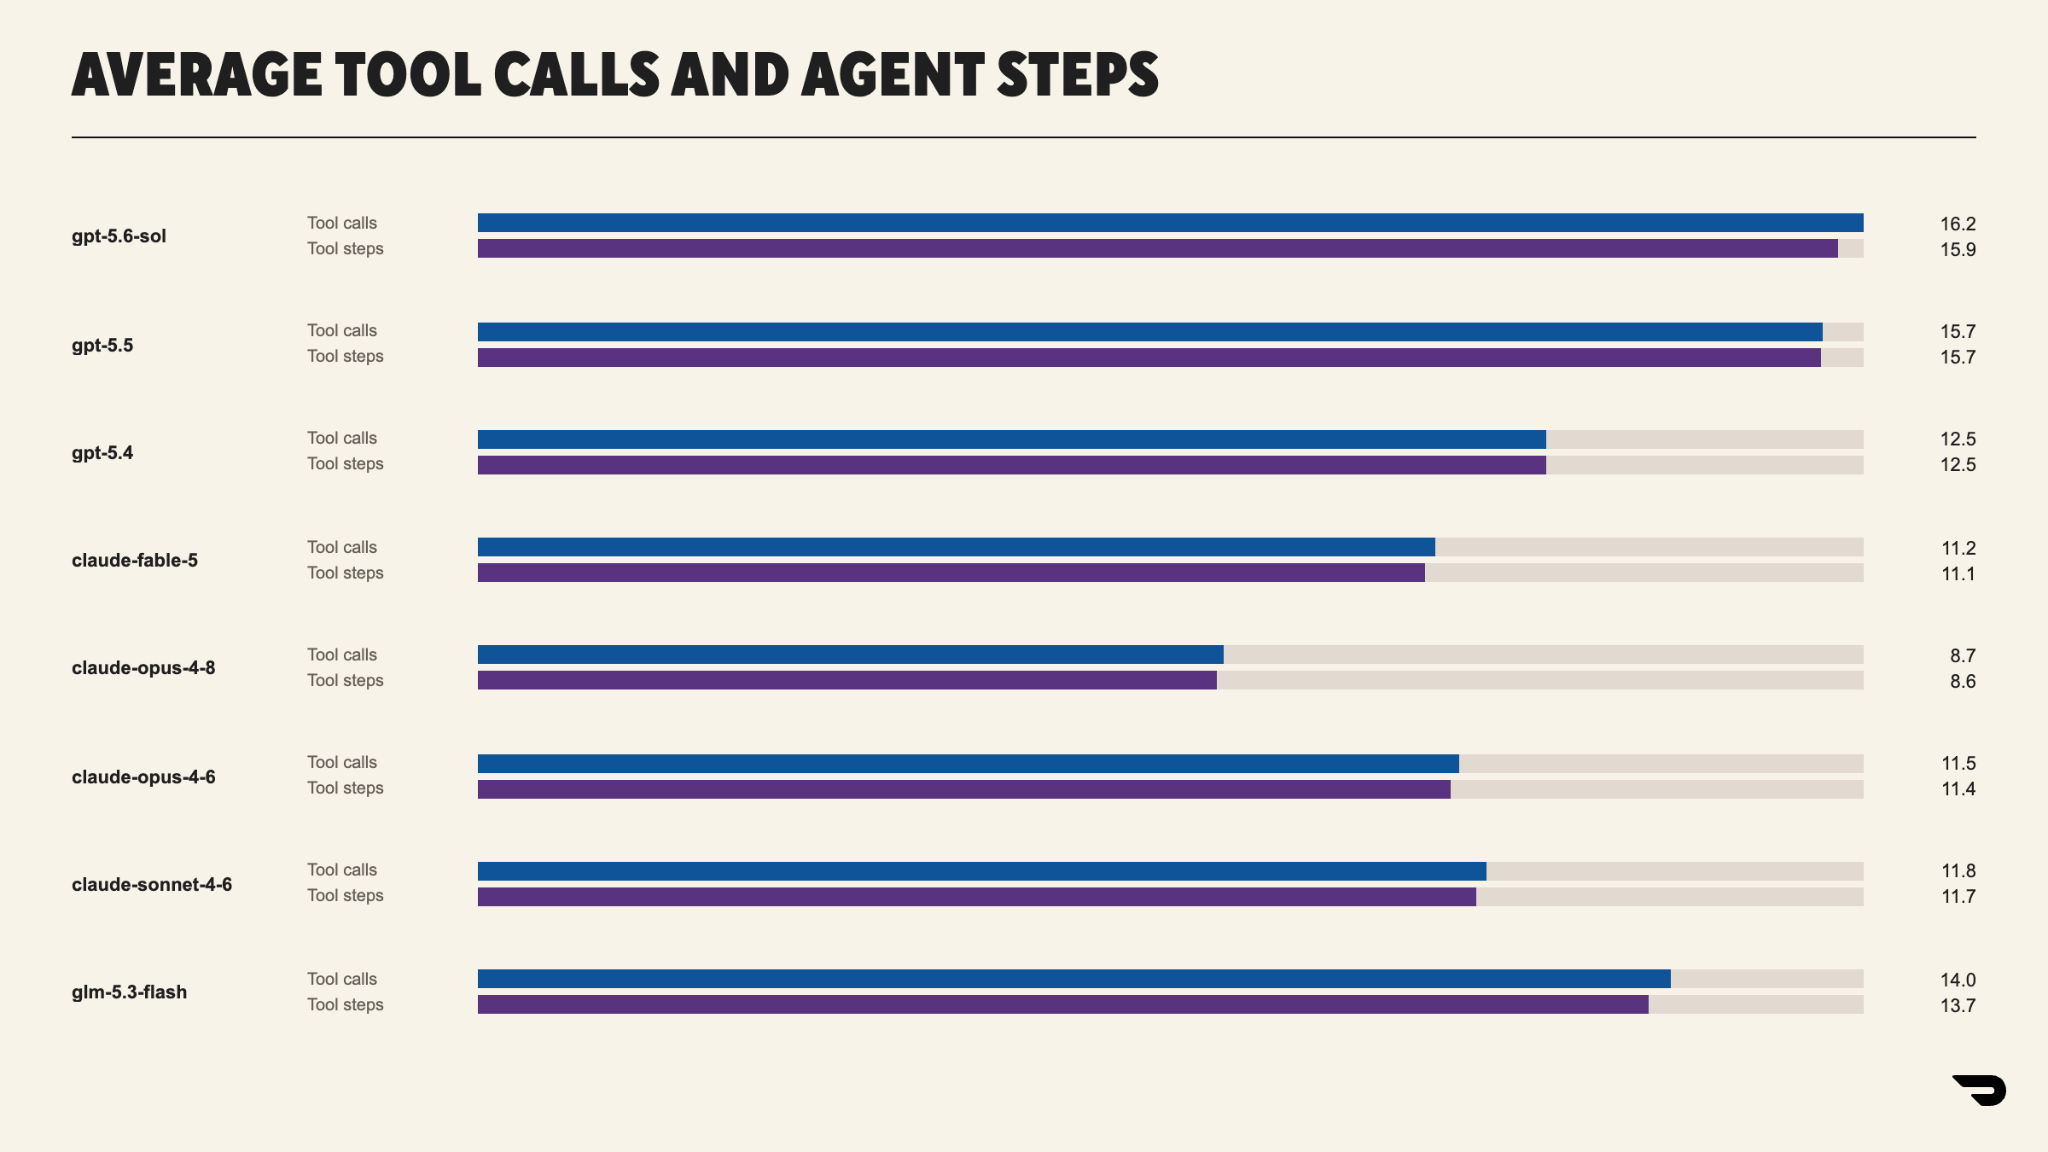
המודל Claude Fable 5 נזקק למספר קטן יותר של שלבי כלי עבודה בהשוואה למודלי ה-GPT, אך השקיע זמן רב יותר בכל שלב והאריך את זמן הריצה פי שניים בערך. הדבר ניכר בהשוואת מסלולי הכלי של המודלים השונים, כפי שמוצג באיור 4:

איור 4: מספר הקריאות הממוצע לכלי ומספר הצעדים הממוצע של הסוכן לכל שאלה. מספר צעדים נמוך יותר אינו מעיד על תשובה מהירה יותר, שכן המודלים הדורשים פחות צעדים מקדישים זמן רב יותר לכל צעד, כפי שמוצג באיור 3.
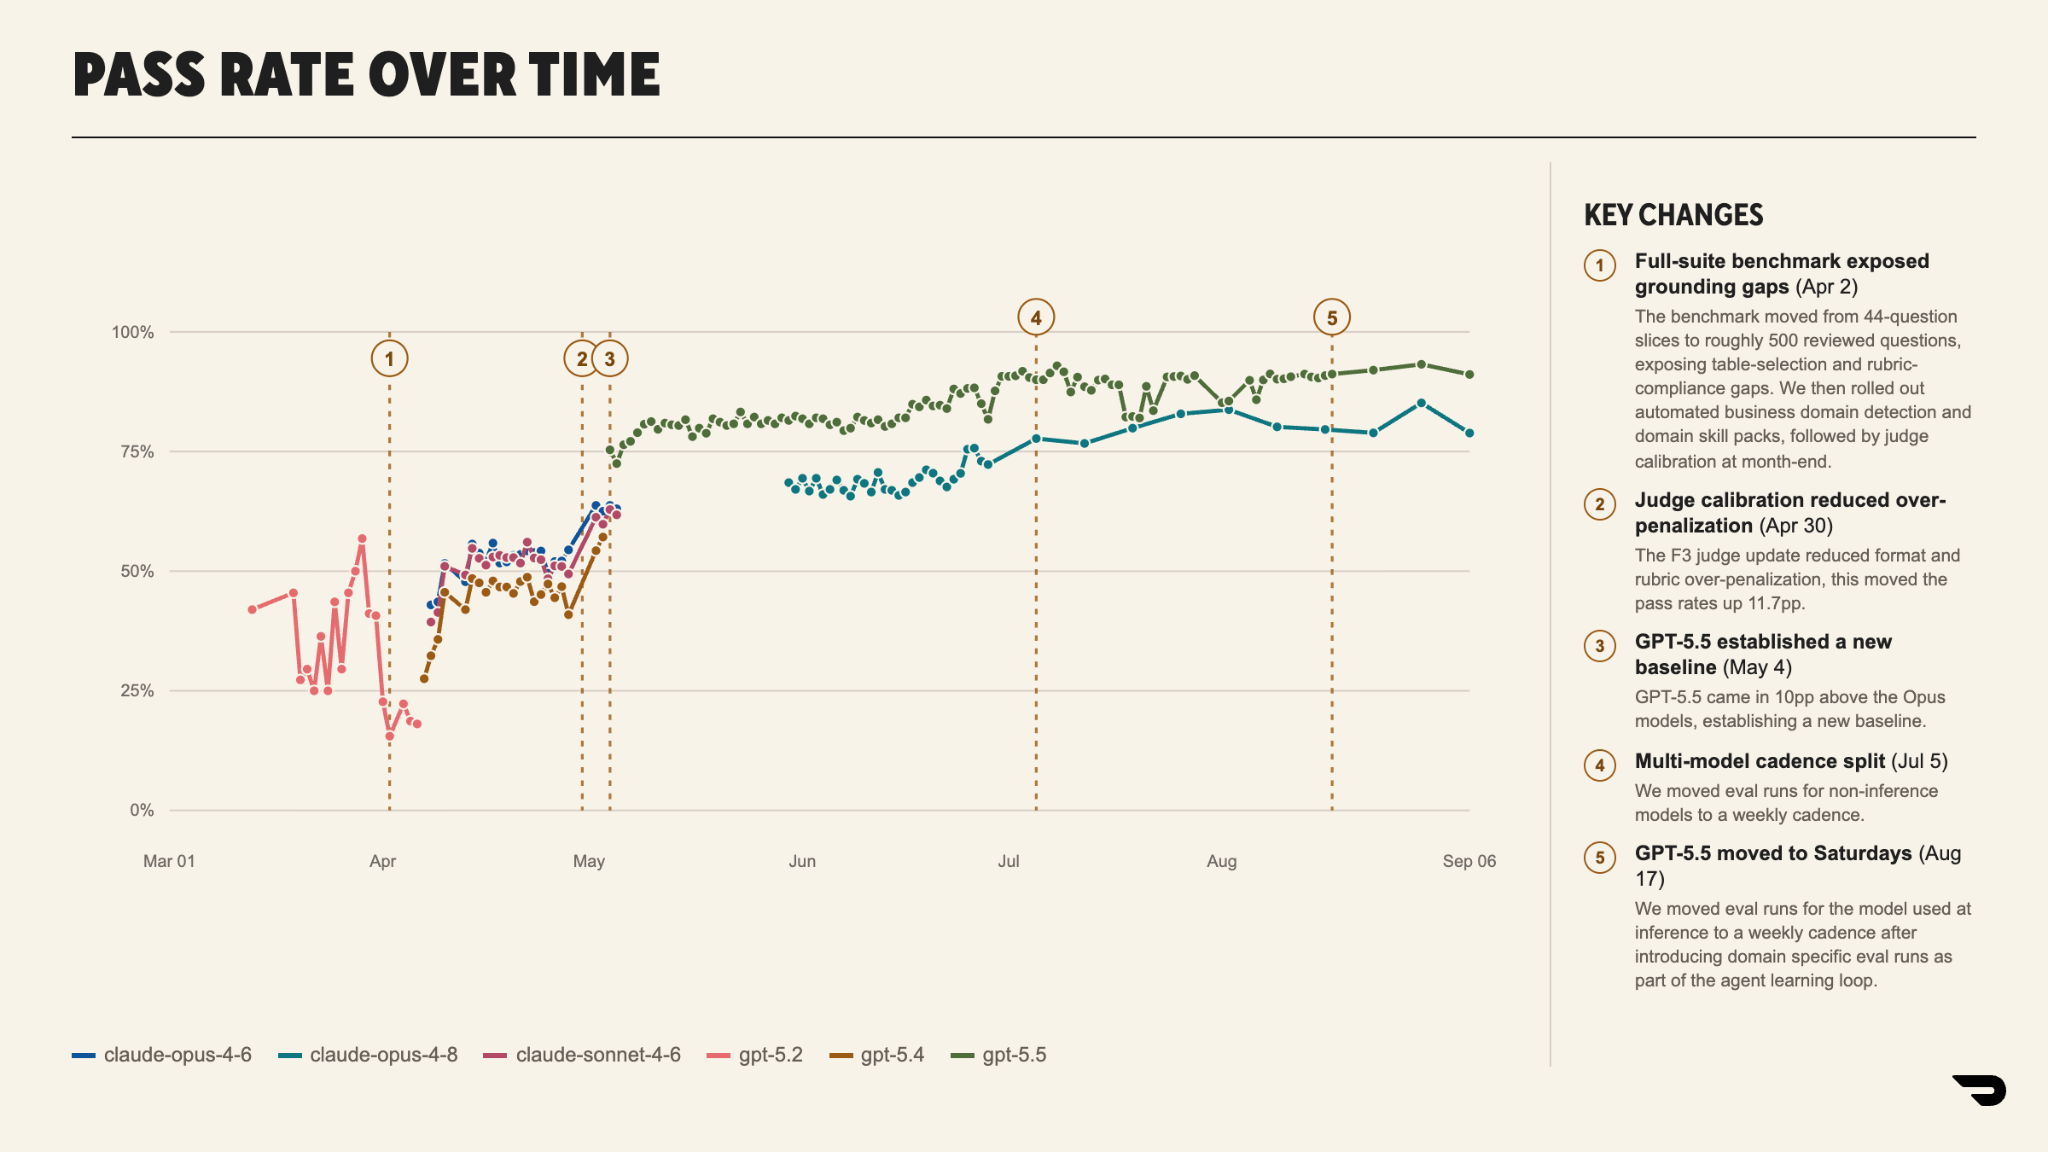
אף שבאופן היסטורי ראינו שיפורים הדרגתיים בציוני הבנצ'מרק עבור גרסאות מודל חדשות, השפעתן של הגרסאות החדשות התייצבה בהדרגה, כפי שמוצג באיור 5:
איור 5: שיעור ההצלחה לפי דגם בין מרץ לספטמבר, כולל השינויים שהשפיעו עליו.

זוהי אינדיקציה ברורה לכך שהאינטליגנציה הגולמית של המודל כבר אינה הגורם המשמעותי ביותר לשיפורים של Vera, וכי מערך המודל — הכולל הוספת הקשר עסקי, אחזור ידע, מידול נתונים, אימות SQL וביצוע — הוא הגורם העיקרי לשיפור בעתיד. 

כדי לאמת השערה זו, בדקנו הן את Claude Code והן את Vera באמצעות מודל משותף, Opus 4.8. סיפקנו ל-CC את כלי הגישה ל-SQL שלנו ואת אותן היכולות שבהן Vera עושה שימוש.

העברנו 100 דוגמאות מייצגות בכל אחת מהמערכות. Vera קיבלה ציון של 2.60/3.0, עם שיעור הצלחה של 73%, בעוד ש-CC קיבלה ציון של 2.16/3.0, עם שיעור הצלחה של 48%. פער זה חרג בהרבה מטווח הרעש המשוער. גילינו ש-CC התקשתה לבצע שאילתות יעילות בטבלאות המודלים כדי להסיק מסקנות נכונות, דבר שהדגיש את הצורך בשכבת נתונים יעילה, הכוללת קטלוג של טבלאות מודלים, היוריסטיקות לדפוסי הצטרפות וכדומה. בהמשך: כיצד אנו בונים ומבצעים שאילתות בשכבה זו. 

איתור ודירוג

יותר מ-10,000 עובדים ב-DoorDash מסתמכים על מערכת נתונים שהתרחבה וכעת כוללת יותר מ-200,000 מערכי נתונים, 350 פטה-בייט של נתונים ו-10 מקורות ידע ארגוניים, החל ממאגרי קוד ועד לוויקי. עם כמות נתונים כה גדולה, האתגר עשוי להיות לדעת מה להשתמש ומתי. שלב האחזור והדירוג מספק את מקורות הנתונים העדכניים, המדויקים והמתואמים הללו. 

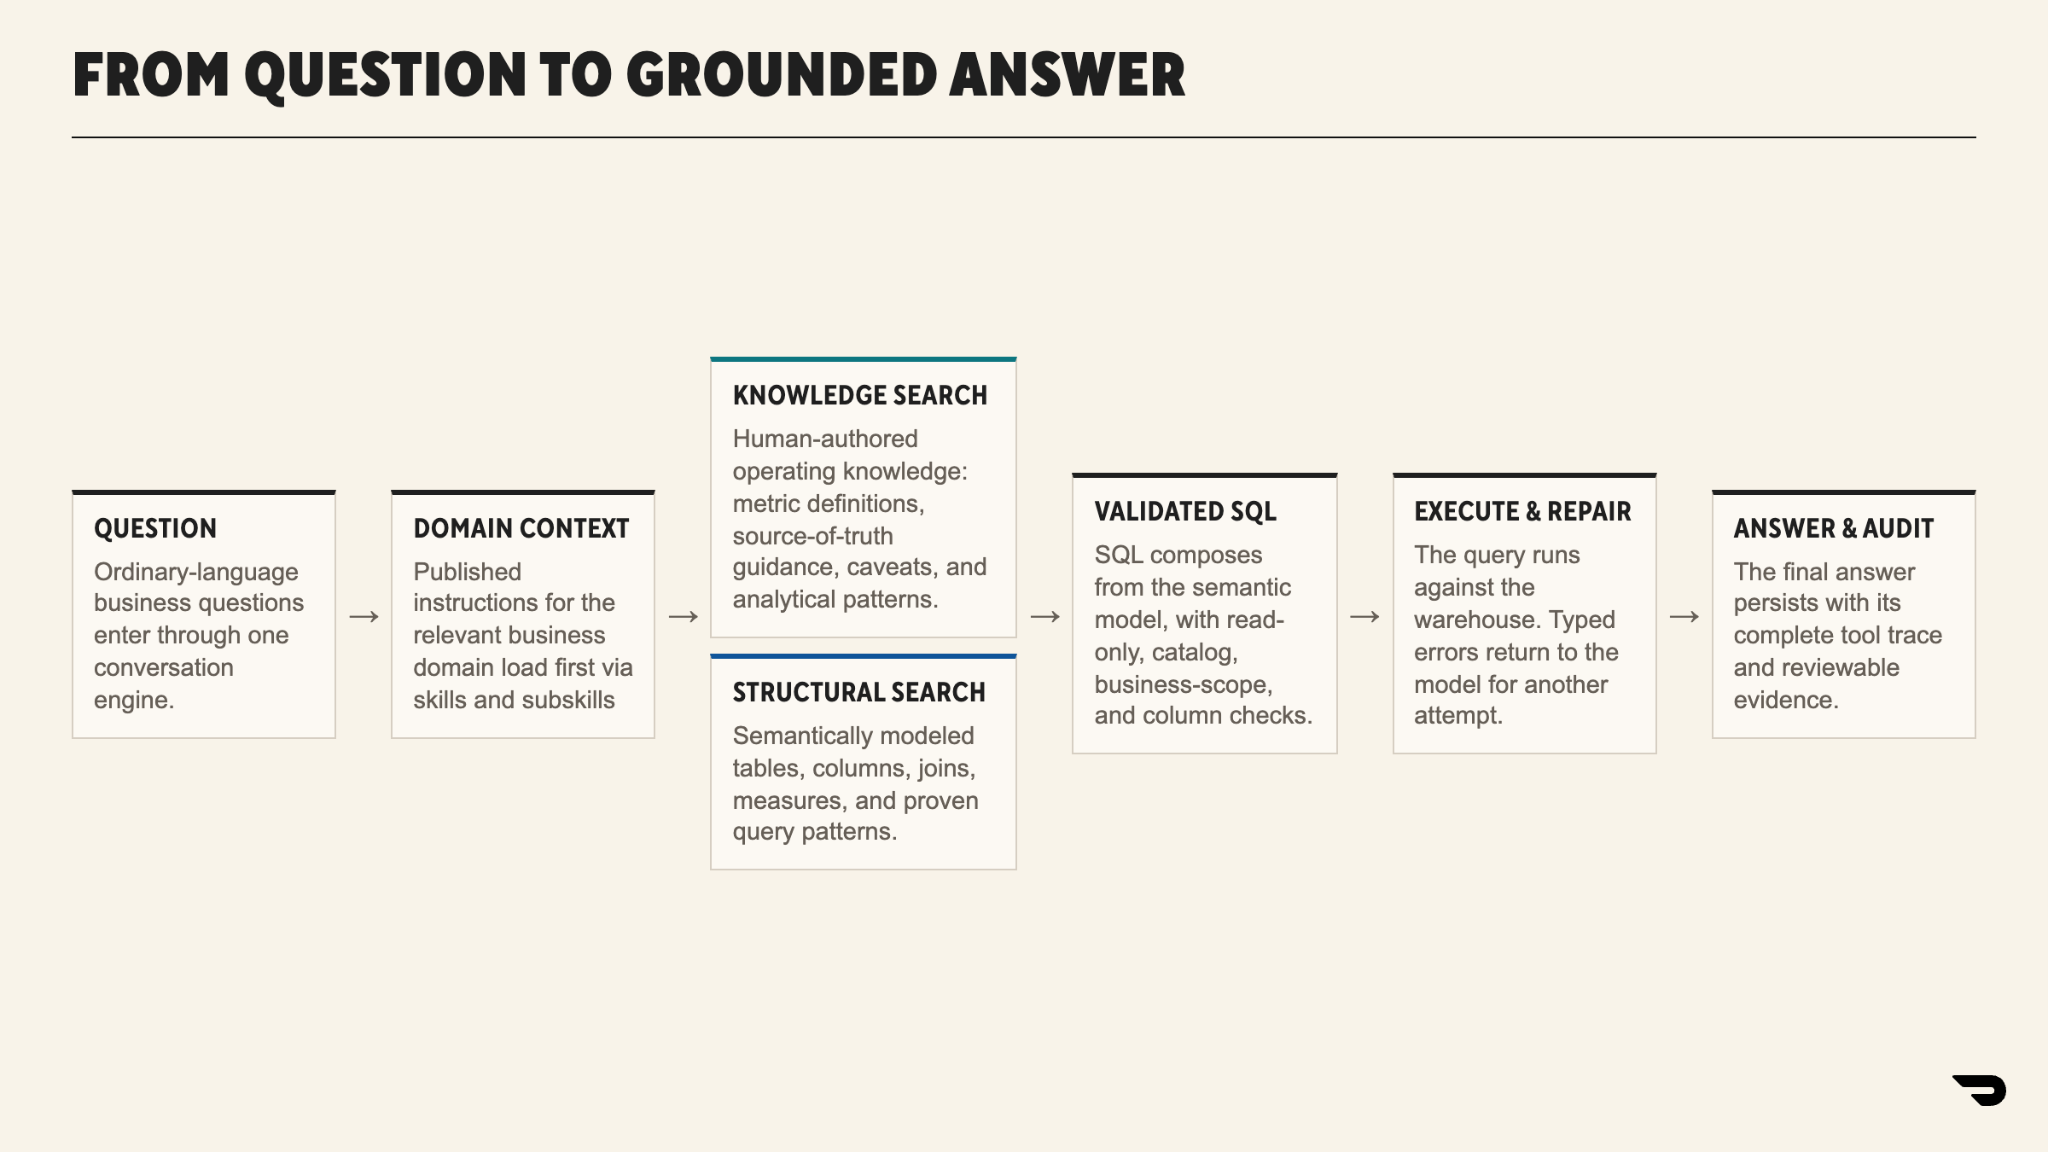
איור 6: המסלול של ורה משאלה ועד לתשובה מבוססת. תהליך האחזור מבצע שני חיפושים במקביל: חיפוש במאגר הידע שנכתב על ידי בני אדם וחיפוש בטבלאות המודל, וכל מה שבא לאחר מכן כפוף למגבלות המודל הזה.

למען הפשטות, נעשה שימוש במודל הטמעה יחיד בכל מאגרי הידע. טבלאות הנתונים המרכזיות ממוינות במצב לא מקוון בתדירות קבועה, מה שמאפשר לנו לסנן שאילתות בעלות ערך נמוך ולהסיר תוכן סטנדרטי. אנו לומדים דפוסי הצטרפות וסמנטיקה אחרת מדפוסי השימוש הנותרים, ממטא-נתוני הטבלאות, מהפניות לקוד ומדפי הוויקי, כדי לבנות מודל נתונים עשיר. 

מודל הנתונים מגביל את התנהגות מערכת ההפעלה; הגישה למקורות שלא נכללו במודל או שלא אומתו נחסמת ברמת ההרנס. חסרון אחד הוא הפער בין הרגע שבו הנתונים הופכים לזמינים לבין הרגע שבו Vera יכולה לבצע עליהם שאילתה. טבלאות חדשות מתגלות ומאונדקסות הן באופן אוטומטי בזמן ההסקת מסקנות והן באופן תקופתי ברקע. התמורה בדיוק שווה את זה, מכיוון שרובן המכריע של טבלאות הליבה העסקיות הן בעלות אורך חיים ארוך וכבר מאונדקסות. 

עלינו גם לשקול כיצד לנהל את הוספת המידע החדש. כיצד נקבע מתי דפוסי הצטרפות חדשים או הטמעות מסמכים מהווים תוספת משמעותית לשאילתות המשתמשים? כברירת מחדל, מקורות אלה מסומנים כלא פעילים, ועליהם לעבור סף הערכה לפני שבעל התחום יקדם אותם. בעלי התחומים יכולים גם להפעיל קידום אוטומטי מלא עבור התחום שלהם. 

בנוסף, כל מקור ידע ומיומנות מקודד את מקורו עד לחומר המקור; תהליך זיהוי השינויים בודק באופן קבוע אם קיימים הבדלים ביחס לחומר המקור. שינויים מהותיים מובילים להצעת שינוי, אשר עוברת בתור אישור וכפופה לאותם קריטריוני סינון החלים על ההערכות.

הערכות וציונים

בעלי דומיינים ומשתמשים רגילים תרמו יותר מ-1,900 הערכות; בעל הדומיין בודק כל תרומה של משתמש לפני שהיא נכללת בספירה. כל הערכה מקבלת ציון משופט LLM על סמך שלוש שאלות: 

  1. האם הסוכן השתמש בכלים הנכונים?
  2. האם הגישה השתמשה בטבלאות הנכונות?
  3. האם התשובה הסופית הייתה נכונה?

אנו מדווחים על הממוצע המשוקלל של תשובות אלה כציון הכולל. מודל השיפוט עבר כיול איטרטיבי במספר שלבים מרכזיים. הסטייה הבולטת ביותר הייתה נטייה להטיל עונש מוגזם על תשובות נכונות במקרים שבהם הטבלאות היו שוות אך לא זהות לחלוטין. תהליכי הכיול מחדש הבטיחו שהמודל יהיה עמיד בפני אי-דיוקים מספריים, יקבל מקורות נתונים שווים, ויתעלם מהבדלי עיצוב קלים. 

השאלה התפעולית המרכזית: כיצד נוכל לאתר ברחבי החברה הערכות שאינן שטחיות, אינן חופפות זו לזו ומייצגות עבודה אנליטית אמיתית, מבלי להטיל נטל על בעלי התחומים? 

שילבנו ב-Vera כלים המשלימים את ההערכות הידניות באמצעות ניתוח תוצרי עבודה יומיומיים, כגון שרשורים ב-Slack וכרטיסי Jira. מודל חדשני קורא כל תוצר עבודה ומנסח הצעת הערכה מלאה, הכוללת את השאלה, שאילתת SQL או מדד הערכה, ודירוג מורכבות. 

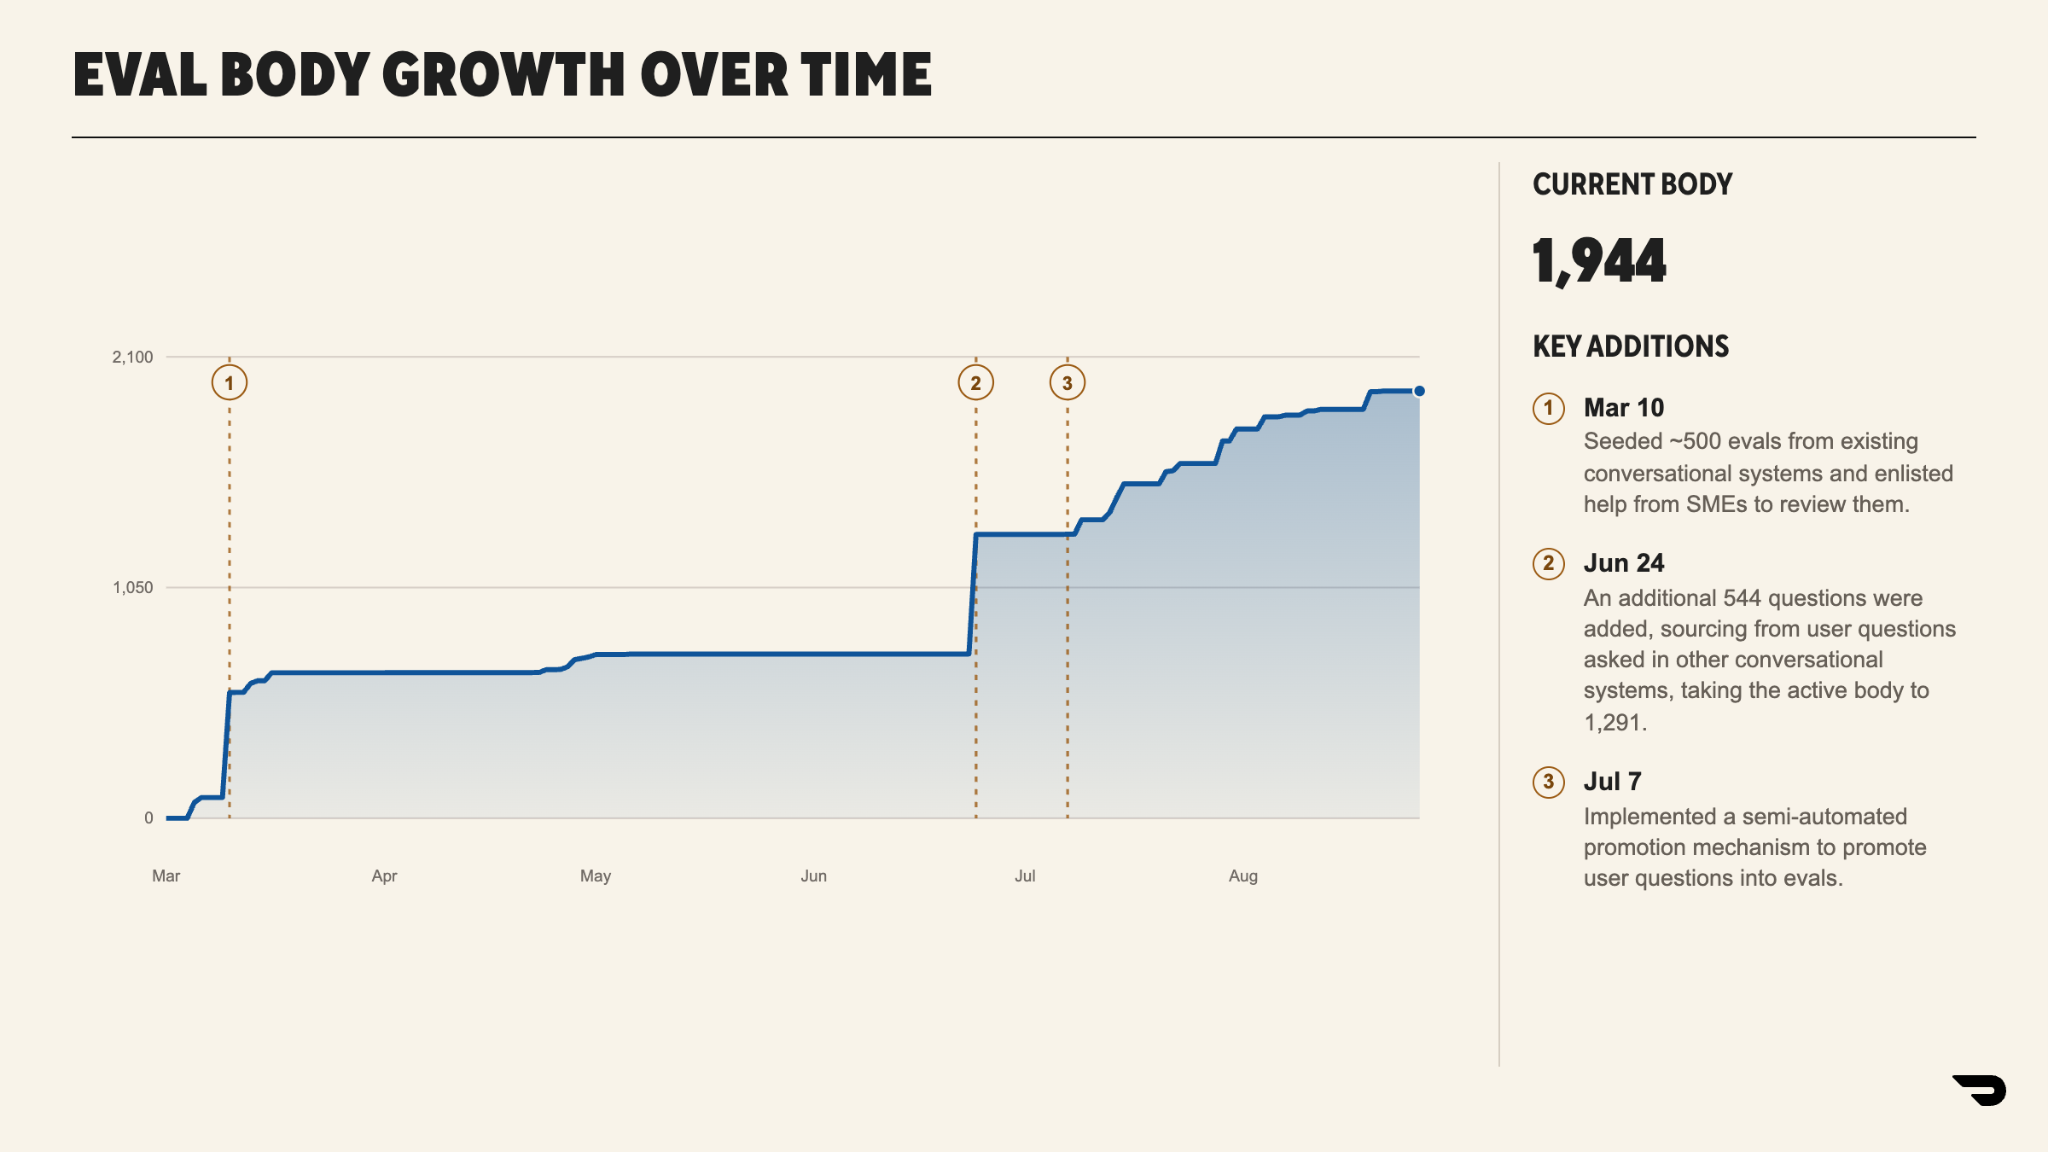
בעלי התחומים בוחנים לאחר מכן כל הצעה ומחליטים אם להוסיף אותה למערך ההערכה או להסירה ממנו. גילינו שזו דרך טובה יותר לנצל את זמנם של המומחים מאשר לבקש מהם לכתוב הערכות מאפס. כתוצאה מכך, מספר ההערכות גדל באופן משמעותי, מה שמספק כיסוי רחב יותר, כפי שמוצג באיור 7: 

איור 7: התפתחות מערך ההערכה, עם שלושת התוספות שעיצבו אותו. שתי הקפיצות מייצגות ייבוא המוני שנבדק על ידי בעלי הדומיינים, והעלייה המתמשכת לאחר יולי מייצגת את תהליך הכרייה והקידום.

הבטחת האיכות בהיקף כזה הופכת למאתגרת יותר. אנו מסננים אוטומטית שאלות שכמעט זהות זו לזו באמצעות מדד דמיון; בעלי התחומים מאשרים 95% מהמועמדים הנותרים במהלך הבדיקה. 

התמודדות עם מורכבות

למרות ש-Vera מתמקדת במענה על שאלות בשיחה, הידע הכללי וההתנהגויות שנרכשו לאחר האימון של המודלים הבסיסיים מאפשרים להן להתמודד עם שאלות קשות בהרבה. אנו משתמשים בסיווג גס של רמת הקושי של הבעיות:

  • רמה 1: שאלות תיאוריות עם הגדרות ידועות ותבניות שנבחרו בקפידה, לרבות שליפת מדדים, מגמות, פילוחים ובדיקות תקינות
  • רמה 2: ניתוחים העשויים להשפיע על החלטות עסקיות או החלטות הנוגעות למוצר, לרבות קביעת סדרי עדיפויות, מיקוד, הערכת היקף ההזדמנויות והקצאת משאבים
  • רמה 3: שאלות הדורשות פרשנות מעמיקה יותר ואחריות, לרבות ניתוח סיבתי, תוצאות ניסויים, תחזיות מחייבות ותמיכה בקבלת החלטות בעלות השלכות משמעותיות

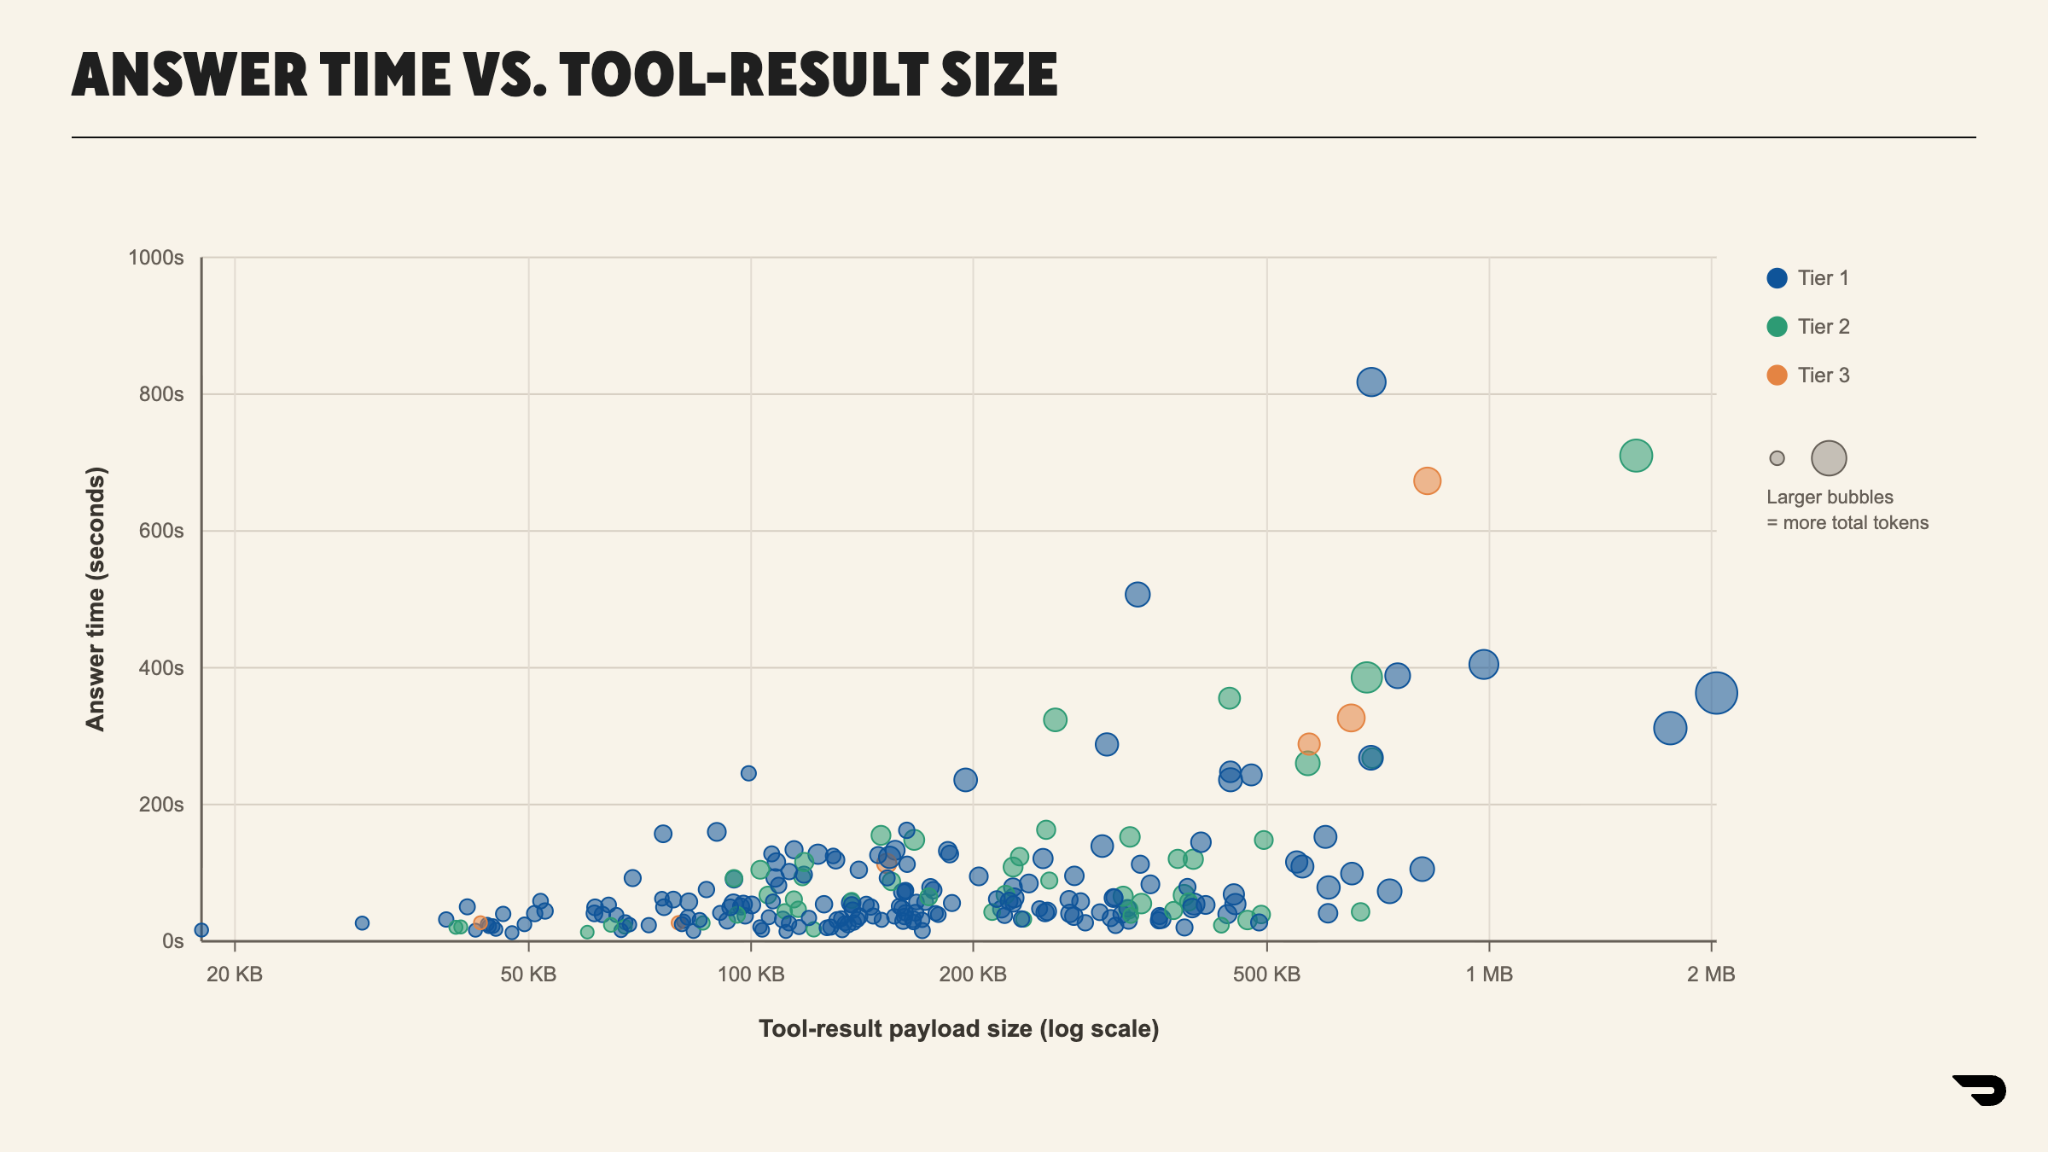
מכיוון שהחפיפה בין הרמות גבוהה, ייתכן שיהיה מאתגר לסווג שאילתות לקבוצות נפרדות, אך הדבר ממחיש את השקעת המאמץ של המודל בשאילתות המורכבות יותר, כפי שמוצג באיור 8: 

איור 8: זמן התשובה ביחס לכמות הנתונים שהושגו בכל ריצה מהכלים. שאלות מדרגה 2 ו-3 מתרכזות סביב כמויות נתונים גדולות יותר וריצות ארוכות יותר, ולכן שאלות קשות יותר גובות מחיר גבוה יותר מבחינת נתונים וזמן, ולא רק מבחינת תהליך החשיבה.

במקרה של השאילתות המורכבות יותר ברמה 3, שמנו לב שהמודלים נטו להפסיק את התהליך מוקדם מדי ובאופן אופטימי מדי. אמנם היה מידע רלוונטי שיענה על השאילתה, אך לעתים קרובות המודל החזיר תשובות שטחיות — אם כי מתקבלות על הדעת — מבלי להעמיק יותר. 

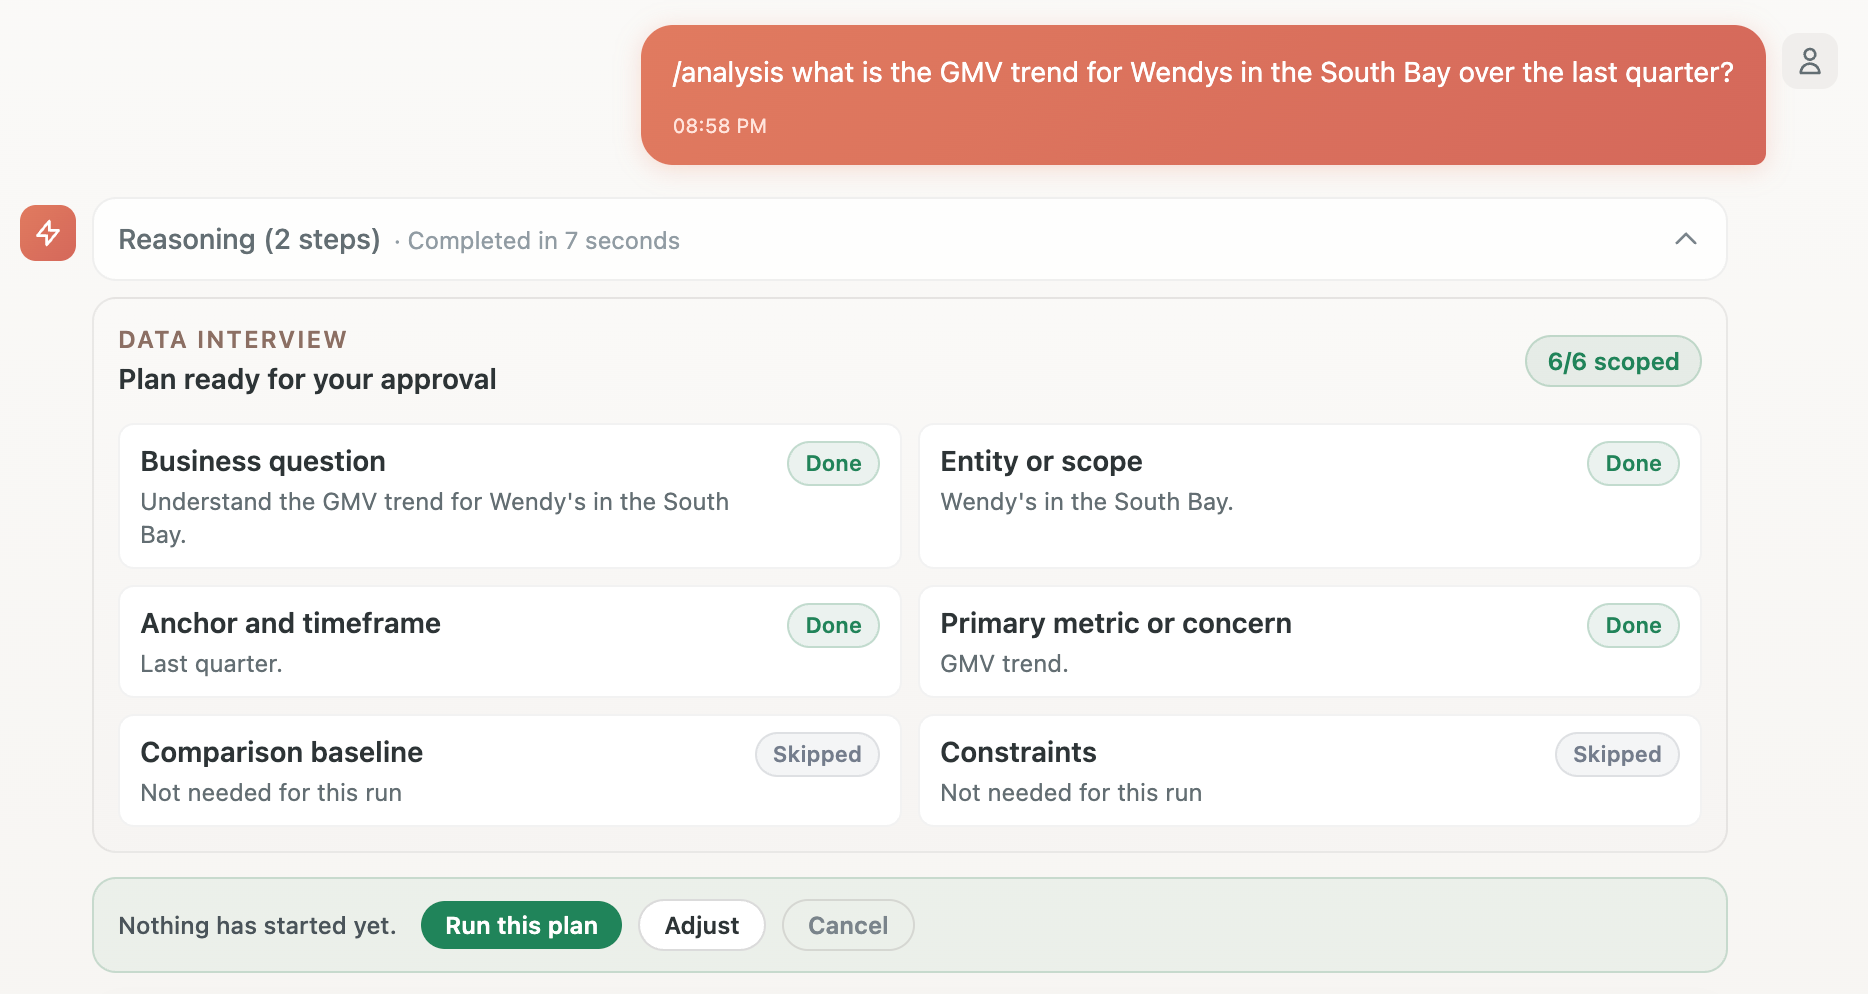
לצורך שאלות אלו, בנינו תהליך ניתוח (/analysis flow), שגרם למודל לבצע זיהוי בעיות ותכנון לפני הביצוע, כפי שמוצג באיור 9: 

איור 9: תהליך הניתוח של Vera בנוגע לשאלה על מגמות בקרב סוחרים. התוכנית מוצגת לפני ביצוע כל שאילתה, ואף פעולה לא מתבצעת עד שהמשתמש מאשר אותה או משנה אותה.

בשלב זה קובע הסוכן את לוחות הזמנים, את המדדים הרצויים, את היקף העבודה הרלוונטי ואת כל האילוצים שהמשתמש מעוניין להטיל. גילינו ששלב תכנון מובנה משפר את הביצועים של הערכות ה-Tier 3 הללו, אך עם שונות גדולה — שיעור הצלחה שנע בין 64% ל-100% — במדגם קטן של 14 מקרים, מה שממחיש את הצורך במשוב נרחב ומעמיק יותר מטעם מומחים בתחומים אלה. 

בהמשך, נתמקד בעיקר בשאלות הקשות והסובייקטיביות יותר שבדרגה 3. 

נקודות עיקריות

במהלך הפרויקט, שיעור ההצלחה עלה מ-43% ל-90%, בעוד שגודל מערך ההערכה הוכפל פעמיים. השיפורים ברמת החוכמה של המודלים הבסיסיים סייעו בשיפור הביצועים, אך דווקא הנדסת הנתונים סביב מערך הנתונים היא זו שהוכחה כבעלת ההשפעה הגדולה ביותר. 

עדיין נותרו מספר שאלות פתוחות:

  1. כיצד נוכל להמשיך לשמור על האיכות תוך הפחתת העלות לכל תשובה?
  2. כיצד ניתן לבנות הערכות סביב שאלות מורכבות יותר בתחום ניתוח הנתונים והדיווח?
  3. כיצד ניתוח נתונים מהיר ויעיל יותר משפיע על מדדי הליבה העסקיים?

במסגרת פיתוח יכולות ניתוח הנתונים ב-DoorDash, נתייחס לשאלות הפתוחות הללו בפוסטים הבאים בסדרה זו.

תורמים: פבל אסטחוב, אנדי פאנג, ג'אש רדיה, נבין סריניבאסן, הלן לין, לוקש שרמה, אדנן שייח, גון ג'ונסון, הרשה ונקט אנאפה רדי

ב-DoorDash פועלות צוותי הנדסה רבים התומכים בתחומי ההנדסה שלנו. מסמך זה מספק סקירה כללית של תחומי הפעילות שלנו ושל הצוותים התומכים בהם:

  1. דאשר ולוגיסטיקה
  2. יסודות
  3. LaunchPad ומחקר בתחום הבינה המלאכותית
  4. שוק
  5. פלטפורמה לסוחרים ולצרכנים
  6. תחומי פעילות חדשים
  7. מצוינות תפעולית
  8. שירותי פלטפורמה
  9. DashOS
  10. כסף
  11. פרסומות וקידומי מכירות

אנו מקווים שהפרופילים הללו ישמשו לכם כנקודת התייחסות מועילה בעת מילוי סקר התאמת הצוות שלנו. 

מכיוון שהצוותים שלנו נמצאים בתהליך התפתחות מתמיד, מסמך זה מהווה תמונת מצב של ארגון ההנדסה שלנו כיום. אנא שימו לב כי ייתכן שיחולו בו שינויים בין הרגע הזה למועד תחילת העבודה שלכם. לפיכך, כשאנו מקבלים החלטות בנוגע לשיבוץ לצוותים, נתמקד בסוג העבודה שמעניין אתכם. בנוסף להעדפותיכם ולרקע הטכני שלכם, נביא בחשבון את קיבולת הצוותים וגורמים ארגוניים נוספים.

הערה: לאורך המסמך מופיעים קיצורים המתייחסים לקבוצות הלקוחות העיקריות שלנו – סוחר (Mx), צרכן (Cx), שליח (Dx) – בנוסף למסעדות (Rx).


דאשר ולוגיסטיקה

צוות Dasher & Logistics (DxLx) מהווה את הלב הפועם של רשת המשלוחים של DoorDash – ומוביל את ביצוע כל הזמנה בתבונה, בדייקנות ובקנה מידה נרחב. החל מ"מוח" הלוגיסטי שמנתב את השליחים (Dashers) ומאזן בין היצע לביקוש, ועד לפלטפורמות ולמוצרים שיוצרים חוויה מגובשת ומתגמלת לשליחים, צוות זה מבטיח שכל משלוח יתבצע ביעילות ובאמינות.

החזון שלנו הוא לבנות רשת לוגיסטית באיכות הגבוהה ביותר ובעלות הנמוכה ביותר, כך שתהפוך לבחירה הראשונה עבור עובדים עצמאיים וסוחרים ברחבי העולם. DxLx מבוססת על שני עמודי תווך עיקריים:

  • לוגיסטיקה: בונה פלטפורמה לוגיסטית עולמית ברמה עולמית ל"קילומטר האחרון", הפועלת בחזית ההנדסה, המדע והתשתיות. הצוות מרחיב ללא הרף את גבולות המהירות, העלות, היעילות והאמינות — ומאפשר ביצוע מיליוני משלוחים מדי יום.
  • Dasher: מתמקדת בהעצמת עובדי Dasher באמצעות מתן אפשרויות בחירה, יציבות והזדמנויות. צוות זה בונה את פלטפורמת העבודות הזמניות הטובה ביותר בעולם, ומקדם שימור עובדים, צמיחה ושביעות רצון באמצעות מודלים תעסוקתיים חדשניים, תגמולים ותוכניות לעידוד מעורבות.

DxLx מהווה את ליבת חוויית DoorDash – היא משנה את האופן שבו סחורות מועברות בערים והופכת את החיים לנוחים יותר עבור מיליוני אנשים ברחבי העולם.


יסודות

צוות Foundations בונה את התשתית המרכזית, את הנתונים ואת פלטפורמות המפתחים המניעות את כל המוצרים והשירותים ב-DoorDash. כעמוד השדרה ההנדסי של החברה, הצוות משלב בין תשתית לנתונים כדי ליצור בסיס חלק, מאובטח וניתן להרחבה על גבי מערכת האקוסיסטם העננית שלנו ב-AWS. הארגון מתבסס על שלושה עמודי תווך מרכזיים:

  • פלטפורמת מפתחים: מאפשרת למהנדסים לפעול במהירות ולפתח בביטחון באמצעות חווית מפתחים מהשורה הראשונה, המבוססת על פלטפורמות מודרניות, אמינות ובעלות ביצועים גבוהים.
  • תשתית ליבה: מספקת מערכות מאובטחות, יעילות ועמידות, המאפשרות למהנדסים לספק מוצרים מצוינים במהירות ובקנה מידה נרחב.
  • נתוני היסוד: מאחדת בין עבודת הנדסת הנתונים לעבודת פלטפורמת הנתונים כדי להבטיח שהעסק יתנהל על בסיס נתונים אמינים ואיכותיים, וכדי להאיץ את החדשנות המוצרית המונעת על ידי נתונים בכל רחבי DoorDash.

בספטמבר 2025, צוותי Foundations של DoorDash ו-Wolt התאחדו כדי להרחיב את פעילות Pedregal ולבנות את העתיד יחד, בהנחיית עקרונות משותפים כגון שמירה על המשכיות העסק, מנהיגות חד-מסלולית, אחריות גיאוגרפית, כיבוד אזורי הזמן, והתאמת הכישרונות הנכונים לבעיות הנכונות.

Foundations היא הפלטפורמה שעליה פועל העסק כולו, ועדיין יש הרבה מקום לעצב את אופן התרחבותה ככל ש-DoorDash צומחת – ובכך לקדם אמינות, ביצועים ומהירות בכל מה שאנו עושים.


LAUNCHPAD ומחקר בתחום הבינה המלאכותית

המשימה של LaunchPad היא לחדש, להתנסות ולטפח רעיונות נועזים. הצוות בנוי לפעול במהירות, ולהפוך רעיונות מבטיחים לאבטיפוסים אמיתיים, כדי ש-DoorDash תוכל לזהות במה כדאי להמשיך ולהשקיע. לצד LaunchPad, "DoorDash AI Research" הוא צוות מחקר יישומי הבוחן כיצד יכולות הבינה המלאכותית החדישות ביותר יכולות לשנות את אופן הפעולה העסקי של DoorDash.

הארגון עוסק בשני תחומים עיקריים:

  • פרויקטים "0 עד 1": LaunchPad עוסקת ברעיונות חדשים בעלי פוטנציאל גבוה בכל מערכת המוצרים של DoorDash – פרויקטים שעשויים להפוך לעסק חדש ומרכזי או לפתוח יכולות חדשות ומשמעותיות לפלטפורמה. 
  • מחקר בתחום הבינה המלאכותית: בוחן כיצד היכולות החדישות ביותר בתחום הבינה המלאכותית יכולות לשפר את DoorDash, החל מהגברת הפריון של המהנדסים, דרך פיתוח סוכני בינה מלאכותית שיכולים לפעול בשם הלקוחות, הסוחרים וה-Dashers, ועד לסיוע לחברה להבין ולנצל טוב יותר את הנתונים שברשותה.

מכיוון ש-LaunchPad ו-AI Research עוסקות שתיהן בבחינת הצעדים הבאים לפני שהם הופכים לחלק קבוע מהעסק, הצטרפות לארגון זה פירושה לעבוד על כמה מהרעיונות המוקדמים והחקרניים ביותר ב-DoorDash.

את LaunchPad מוביל אנדי פאנג, מייסד-שותף של DoorDash.


שוק

סקירה כללית של השוק  

ארגון Marketplace מאפשר חילופי סחורות בין קונים למוכרים במגוון רחב של תחומים — ומספק אמון, איכות וחוויות חלקות בקנה מידה עצום. משימתו היא לבנות רכיבים בסיסיים הניתנים להרחבה, המאפשרים לצוותים להשיק תכונות חדשניות בביטחון ובמהירות. Marketplace מאורגן סביב שלושה עמודי תווך מרכזיים, שכל אחד מהם מניע את חוויית הצרכן בדרכים ייחודיות ובעלות השפעה:

  • צרכן ליבה: אחראי על מסע ההזמנה מתחילתו ועד סופו — ויוצר חווית קנייה מהירה, אינטואיטיבית ומהנה לכל לקוח, בכל מקום.
  • צמיחת בסיס הלקוחות: מאיצה את התרחבותה של DoorDash באמצעות תובנות מבוססות נתונים, ניסויים ואופטימיזציה מתמשכת — מהכניסה למערכת ועד לתשלום ואף מעבר לכך.
  • DashPass: מנהל את פעילות המנויים שלנו, תוך התמקדות בצמיחה, במעורבות ובשימור לקוחות. צוות המעורבות מוביל את תהליך הקליטה והאימוץ המוקדם, ומסייע ללקוחות לחוות את הערך של DashPass כבר מהיום הראשון, בעוד שצוות השימור דואג שהחברים יישארו מחוברים וימשיכו להפיק ערך לאורך כל המסע שלהם.

צוות Marketplace בונה את התשתית של חוויית DoorDash — ומחבר מיליוני לקוחות לעסקים המקומיים שהם אוהבים, במהירות ובאמינות יותר מאי פעם.


פלטפורמה לסוחרים ולצרכנים

צוות פלטפורמת MxCx בונה פלטפורמות ברמה עולמית המאיצות את פיתוח המוצרים ומבטיחות אמינות, יכולת ניטור ואבטחה יוצאי דופן. משימתם היא להעצים את לקוחותינו, תוך הרחבת הצמיחה של DoorDash בכל תחומי החוויה.

הצוות מתמקד הן בחוויית הסוחרים (Mx) והן בחוויית הצרכנים (Cx), ומספק את התשתית לכל התהליכים – החל משילוב סוחרים בפלטפורמה ועד לאפליקציות לקוחות בעלות ביצועים גבוהים. תחומי המפתח כוללים:

גיוס סוחרים: מזהה ומצרף שותפים חדשים מתחום המסעדנות באמצעות נתונים חכמים וכלים נוחים לשימוש בשירות עצמי.

  • Mx Tablet: החומרה והאפליקציה המאפשרות לניהול הזמנות בחנות עבור בעלי עסקים.
  • Business Manager: אפליקציה לנייד המאפשרת לבעלי עסקים לנהל ולהרחיב את העסקים שלהם בכל זמן ובכל מקום.
  • פלטפורמת ההזמנות: הבסיס לניהול מחזור החיים של ההזמנות ב-DoorDash, המאפשר למהנדסים לפתח תכונות חדשות במהירות ובאמינות.
  • פלטפורמת הלקוחות MxCx: מאפשרת למהנדסי לקוחות בתחום הצרכני לפתח באופן בטוח ויעיל אפליקציות בעלות ביצועים גבוהים ואמינות ברשת, ב-iOS וב-Android – ובכך מקדמת איכות ועקביות בקנה מידה נרחב.

צוות פלטפורמת MxCx בונה את עמוד השדרה של מערכת האקוסיסטם של DoorDash – ויוצר את הכלים, המערכות ופלטפורמות הלקוחות המניעות את הצמיחה של מיליוני משתמשים ועסקים מדי יום.


תחומי פעילות חדשים

צוות New Verticals (NV) מרחיב את פעילות DoorDash מעבר למסעדות – בונה פלטפורמה למסחר מקומי ומאפשר ללקוחות לגשת לכל דבר בעירם. ממזון ומוצרי נוחות ועד ציוד לחיות מחמד, אלכוהול, מוצרים לבית ומוצרי יופי, NV מגדיר מחדש את האופן שבו אנשים קונים בחנויות מקומיות.

המשימה שלנו היא להפוך את DoorDash לשותף המוביל בכל הקשור למוצרי יסוד יומיומיים, ולסייע למשפחות וליחידים להשיג את מה שהם צריכים, מתי שהם צריכים. הצוות מתמודד עם אתגרים מורכבים האופייניים ללוגיסטיקה הקמעונאית, מרחיב מערכות לניהול מלאים עצומים ודינמיים, משפר את דיוק הנתונים ומייעל את חוויית ה-Dasher עבור מודלים מגוונים של ביצוע הזמנות, כגון קניות מכולת ומשלוחים ברמת הפריט.

בתוך NV ישנם חמישה עמודי תווך עיקריים (קטגוריות NV, צרכן NV, מילוי הזמנות NV, סוחרים + מבחר NV ולמידת מכונה NV), עם צוותי משנה רבים המובילים את החדשנות. בנוסף, צוות DashMart אחראי על חנות המכולת והנוחות הווירטואלית של Dash עצמה, הנמצאת בבעלות מלאה של החברה, מופעלת על-ידה ומנוהלת על-ידה במטרה לספק את הדור הבא של חוויית הקנייה "הכל לפי דרישה".

מהנדסים בצוות NV לעולם לא יתקשו למצוא אתגרים, ויש להם הזדמנויות מדהימות להטביע חותם על המסחר המקומי!


מצוינות תפעולית 

המשימה של צוות המצוינות התפעולית (OpEx) היא לבנות אמון ולהגביר את היעילות באמצעות חדשנות ואוטומציה. אם הצרכנים, הסוחרים או השליחים לא יוכלו לסמוך על כך שהפלטפורמה הוגנת ואמינה, לא יהיה לנו עסק. צוות OpEx מורכב מארבעה תחומי מפתח:

  • חוויית המשלוח: מבטיחה מעקב חלק ושקוף אחר ההזמנה ותמיכה לאחר ביצוע ההזמנה.
  • הונאה: שומר על הוגנות השוק באמצעות מניעה ואיתור של פעילות הונאה.
  • אמון ובטיחות: בונה אמון בקרב שליחי Dash, בעלי עסקים וצרכנים באמצעות אימות זהות ושמירה על עמידה בדרישות הרגולטוריות.
  • פלטפורמת סיכונים וזהות: מרחיבה את המאמצים הללו ביעילות באמצעות פלטפורמות לניהול סיכונים, נתונים, חשבונות ופתרונות למידת מכונה ובינה מלאכותית.

כהנדס בצוות ההנדסה של OpEx, תסייע בהפעלת המערכות השומרות על יעילותה, הוגנותה ובטיחותה של הפלטפורמה שלנו בקנה מידה עצום. בין אם מדובר במאבק בהונאות בזמן אמת, בהבטחת תשלומים חלקים, בשיפור חוויות המשלוח או בחיזוק האמון והבטיחות – לעבודתך תהיה השפעה על מיליוני אנשים. תפתח קוד משמעותי, תשתף פעולה עם צוותים מתחומים שונים ותתפתח במהירות בסביבה דינמית המאופיינת באחריות רבה.


שירותי פלטפורמה

צוות שירותי הפלטפורמה בונה את מערכת ההפעלה לכל מסעדה, מכולת וחנויות קמעונאיות – ומאפשר לעסקים מקומיים לשגשג בכלכלת הנוחות. המשימה שלהם היא ליצור את התוכנה והחומרה שיעזרו לבעלי העסקים להניע ולהרחיב את העסקים הישירים שלהם. המהנדסים בצוות פועלים בחמישה תחומי פעילות בעלי השפעה רבה:

הזמנות דיגיטליות: פתרון תחת מותג לבן המנצל את הטכנולוגיה וההיקף של DoorDash כדי לסייע לבעלי העסקים להגדיל את המכירות המקוונות הישירות שלהם.

  • תוכנית נאמנות רב-ערוצית: תוכנית נאמנות תחת המותג של העסק, המאפשרת ללקוחות לצבור ולממש תגמולים בצורה חלקה – באינטרנט, בחנות ובאפליקציית DoorDash.
  • הזמנות קוליות: שירות קולי באיכות גבוהה המאפשר לעובדי החנות להתמקד בלקוחות, בעוד אנו מטפלים בשיחות.
  • Drive: שירות "הגשמה כשירות" המאפשר לבעלי עסקים להשתמש בצי הרכבים של Dasher כדי לספק הזמנות שהוזמנו ישירות אצלם.
  • DoorDash for Business (DDfB): פתרונות לארגונים המאפשרים לחברות להציע לעובדיהן הטבות בתחום המזון, כגון DashPass for Work, Expensed Meals, Group Orders וכרטיסי מתנה ארגוניים.
  • צוות שירותי הפלטפורמה בונה את התשתית לדור הבא של המסחר המקומי – ומסייע לכל בעל עסק ליצור קשר עם לקוחות בכל זמן ובכל מקום.

DashOS

DashOS הוא צוות הנדסי שהוקם במטרה ליצור קשר ישיר בין סוחרים ללקוחותיהם. הצוות מאחד תחת קורת גג אחת יכולות שבעבר היו מפוזרות בין מוצרים ואזורים שונים.

DashOS מכסה שלושה תחומים עיקריים:

  • פעילות בחנות: המערכות שבהן משתמשים בעלי העסקים לניהול שוטף של העסק — מערכות קופה, קיוסקים ומערכות תצוגה למטבח.
  • חנות מקוונת ותוכניות נאמנות: הכלים המאפשרים לבעלי העסקים להקים חנות מקוונת תחת המותג שלהם ולהפעיל תוכניות נאמנות ותגמולים משלהם.
  • ארוחות בחוץ והזמנות: הצד של העסק הפונה לצרכן — סיוע לאנשים לגלות, להזמין וליהנות מחוויות קולינריות ואירוח.

מכיוון ש-DashOS מאחדת צוותים שבעבר עבדו בנפרד, הצטרפות לארגון זה פירושה לסייע בבניית פלטפורמות משותפות בקנה מידה עולמי — תוך המשך עיצוב חוויית המוצר שחווים בעלי העסקים והסועדים בכל שוק מקומי.


כסף

המשימה של צוות Money היא לספק מוצרי תשלומים ושירותים פיננסיים מהנים וחדשניים עבור Cx, Dx ו-Mx, ולשמש כגורם מאיץ לצמיחה עסקית הן בהכנסות והן ברווחים.

הצוות, הפועל הן כפלטפורמה והן כצוות מוצר, אחראי בראש ובראשונה על ניהול כל העסקאות הכספיות בפלטפורמה שלנו. תפקידו כולל את כל ההיבטים, החל מגביית תשלומים מהלקוחות ועד לתשלום ל-Mx ו-Dx, תוך הקפדה על רישום מדויק של כל דולר.

הארגון בנוי על שלושה עמודי תווך:

  • תשלומים: התשתית המרכזית העומדת מאחורי כל עסקה ב-DoorDash — האופן שבו הלקוחות משלמים, האופן שבו השליחים והסוחרים מקבלים את התשלום, והאופן שבו מחויבים מנויים כגון DashPass.
  • מוצרי כספים: מוצרים פיננסיים המשרתים באופן ישיר את נהגי דאש, הצרכנים והסוחרים — כגון כרטיסי מתנה, כרטיס "Crimson" והטבות נוספות לנהגי דאש, וכן מימון לסוחרים.
  • תאימות פיננסית: מבטיחה שכל דולר שעובר דרך DoorDash ייעקב כראוי, יאושר ויעמוד בתקנות הפיננסיות ברחבי העולם.

צוות Money מעבד מיליארדי דולרים מדי שנה, וחידושים בתחום התשלומים שיזם, כגון כרטיסי מתנה, תרמו מיליוני דולרים לעלייה בשווי ההזמנות הכולל השנתי, דבר המדגיש את ההשפעה המשמעותית של המערכות והמוצרים הפיננסיים של צוות Money על פעילותה העסקית של DoorDash!


פרסומות ומבצעים

צוות הפרסומות והמבצעים מסייע למסעדות, לסוחרים ולמותגים להגיע ללקוחות ולהרחיב את פעילותם העסקית ב-DoorDash. הארגון בנוי משני חלקים – פרסומות ומבצעים.

  • פרסומות: באמצעות שילוב של נתונים עוצמתיים עם מיקום חכם, צוות הפרסומות מחבר בין מפרסמים לקהלים הנכונים – ובכך מגביר את החשיפה, ההמרה והצמיחה. הצוות מבוסס על שלושה עמודי תווך: היצע (חוויית הלקוח), ביקוש (חוויית המפרסם) ואספקה (המנוע המונע על ידי למידת מכונה, המחבר בין השניים בזמן אמת). הצוות מפעיל שני תחומי פעילות – 'פרסומות למסעדות', המסייעות למסעדות להתבלט בעיני לקוחות רעבים, ו'פרסומות למוצרי צריכה ארוכת טווח' (CPG), המציגות מותגים יומיומיים – בתמיכת צוותי 'Ads Foundation' ו-'Ads Data' הפועלים מאחורי הקלעים.
  • מבצעים: מאפשר את ההנחות והמבצעים שהלקוחות רואים ברחבי האפליקציה – מהדף הראשי ועד לתהליך התשלום – ומסייע לסוחרים להגדיל את מספר ההזמנות, בעוד שהלקוחות חוסכים כסף.

בהסתכלות קדימה, הצוות פועל לשילוב הדוק יותר בין "פרסומות" ו"מבצעים" לחוויה אחת, אוטומטית יותר, עבור הסוחרים. שני התחומים צומחים בקצב מהיר, ואנחנו רק בתחילת הדרך – הצטרפו אלינו בבניית מנוע הצמיחה הבא של DoorDash.


פוסט זה עוסק בגבולות הלקוח והפלטפורמה העומדים בבסיס חוויית המשתמש והאינטראקציות עם Ask DoorDash: כיצד עברנו מקרוסלות של האקתון למודל הנוכחי, כיצד אובייקט אחד משרת שלושה קוראים, וכיצד ההקשר והמצב נשמרים עקביים ככל שהצרכנים מתקדמים בתוך DoorDash. הפוסט ממשיך "בניית DoorDash Assistant: סקירה הנדסית" ולסקירות המעמיקות שלנו בניית Ask DoorDash (חלק 2): בינה, בניית Ask DoorDash (חלק 3): הערכה, ו בניית Ask DoorDash (חלק 4): פלטפורמה לבניית והתפתחות סוכנים.


Ask DoorDash הופך בקשות כמו "הכן לי ארוחת ערב ב-60 דולר ל-10 אנשים", "עזור לי להכין טאקו עוף" ו"חטיפים לשבוע" לרשימות קניות שניתן לערוך. השירות מייצר רשימה הכוללת מוצרים שניתן לרכוש, מחירים, תמונות, אפשרויות שליטה בכמויות וכפתורים פשוטים להחלפת כל פריט ולביצוע התשלום. במקרה של בקשות ממסעדות, מוצגים חנויות ומנות שמתחברות לתהליך הקנייה המקורי. שתי הפונקציונליות פועלות על אותו מנגנון לקוח ופלטפורמה. פוסט זה מתמקד במקרה השימוש של מצרכי מכולת, שכן הוא מעמיד את האתגר הגדול ביותר בכל המורכבויות העיקריות הכרוכות ביצירת ממשק אינטואיטיבי לקניות מונחות סוכן. רשימות מצרכי מכולת מכילות בדרך כלל עשרה או עשרים פריטים, עוברות מספר סבבי תיקונים, ועליהן להתמודד בקלות עם אילוצים של הצרכן, כגון תקציב והגבלות תזונתיות.

מפגשי משתמשים מחודש יולי 2026 הראו כי במפגשים הקשורים לקניות במכולת, שבהם הוצגה רשימת קניות, ביצעו הצרכנים בממוצע קרוב לשתי אינטראקציות עם ממשק המשתמש כל אחד. כ-שליש מאותם מפגשים המשיכו ליישום הרשימה בעגלת הקניות. העוזר לוקח את הכוונה הכללית של הצרכנים ומצמצם אותה. התוצאה היא רכיבים מובנים, המאפשרים לצרכנים לבצע חידוד מדויק. עריכות פשוטות מעדכנות באופן מיידי את האובייקט הסמכותי, בעוד ששינויים הדורשים חשיבה מפעילים תור חדש של הסוכן.

כדי ליצור חווית קנייה שיתופית ויעילה בין הצרכן לסוכן, על סוכני הקניות להשתלב בממשק אינטראקטיבי המבוסס על נתוני מסחר בזמן אמת ועל ההקשר הנוכחי של הצרכן באפליקציה. כאשר צרכן קונה באפליקציה, הוא מצפה לראות במבט אחד פריטים אמיתיים שניתן לרכוש. טקסט יכול לתאר את הסביבה הזו, אך רכיבים אינטראקטיביים מבוססי תמונות מאפשרים לצרכנים ממש לנווט בתוכה. גם ההקשר חשוב. לצרכנים הפותחים את DoorDash יש ציפיות שונות מאלה שיש להם מאפליקציית צ'אט כללית. הם קונים באמצעות גלישה, ועוברים בין חנויות ודפים במקום לתאר את מה שהם רוצים. לפגוש אותם במקום שבו הם נמצאים הוא חלק חיוני בפאזל.

לדברים גדולים יש התחלות קטנות

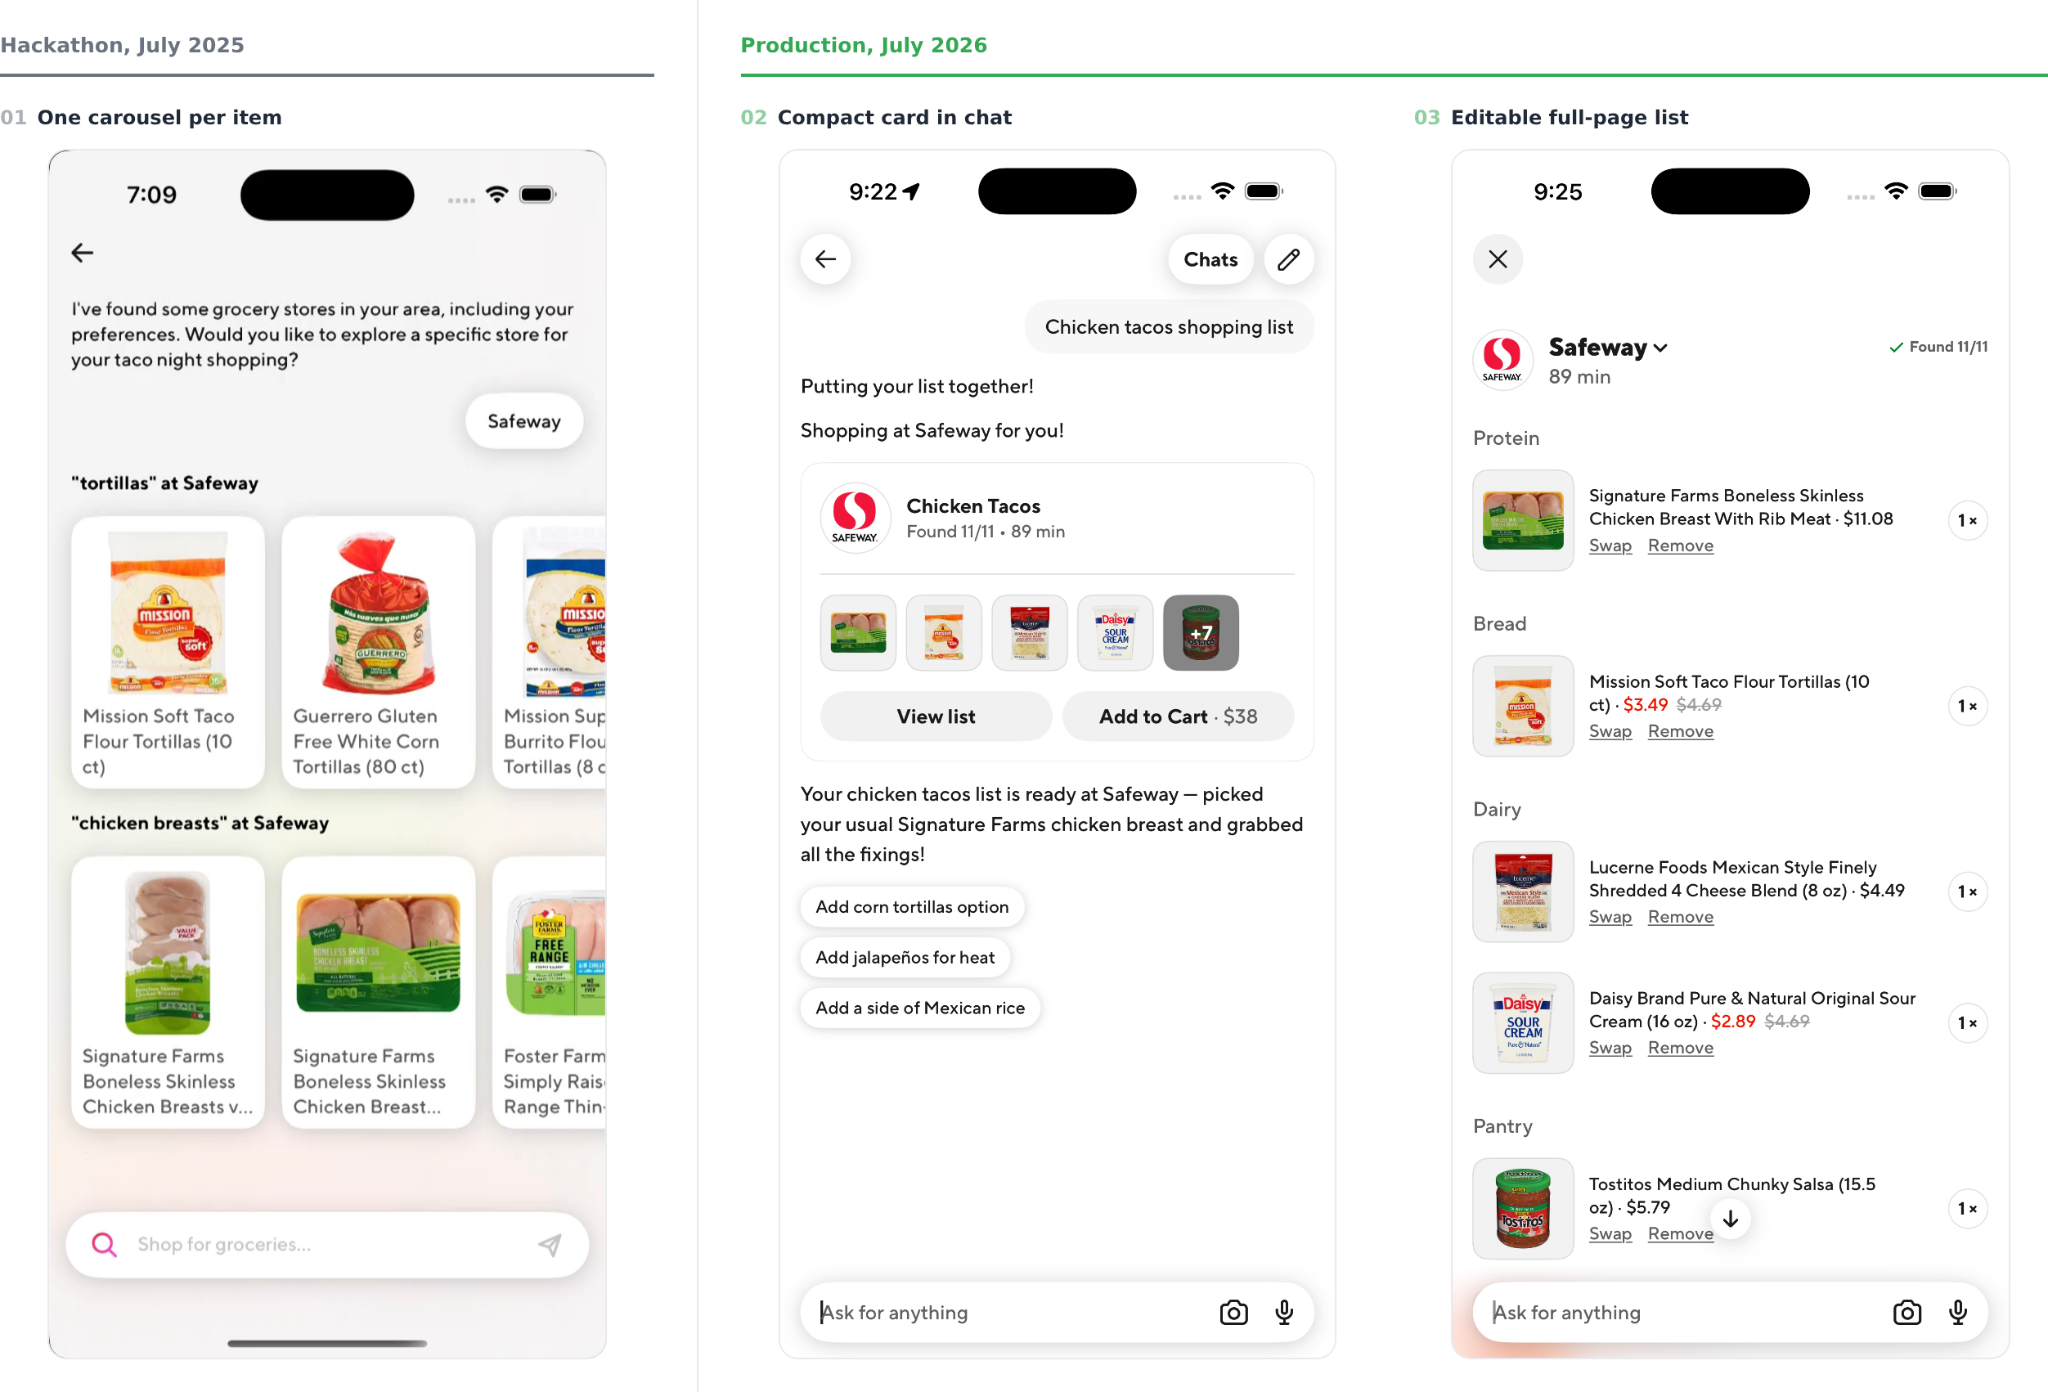
עוזר הקניות של DoorDash התחיל כפרויקט בהאקתון. ידענו מההתחלה ששילוב רכיבים קיימים של DoorDash יהיה מרכיב מרכזי בכל מה שנבנה. הגרסאות הראשונות הסתמכו במידה רבה על קרוסלות: תחילה רשימה של חנויות אפשריות בקרבת מקום, ולאחר מכן קרוסלה של תוצאות חיפוש עבור כל פריט שהנציג חיפש. הן הוצגו בתוך הטקסט, כשכל אחת מהן צמודה למונח החיפוש שלה. התוצאה הייתה, למעשה, תמליל צ'אט שאליו הודבקו תוצאות מסחריות.

מבחינה פונקציונלית, זה היה דומה למה שאנו משווקים כיום. מבחינת חוויית המשתמש, זה היה פחות מלוטש, וכדאי לעבור על הפרטים.

לאחר שמצא קבוצה של חנויות, העוזר שאל איזו מהן כדאי לבדוק והמתין עד שהתשובה תוקלד. כל קרוסלה ייצגה פריט בודד שהצרכן היה זקוק לו, ובחירת אפשרות מתוכה הוסיפה את הפריט לעגלה. כל אחת מהן נפתחה כשהאפשרויות פרושות על פני הרוחב המלא והבחירה עדיין פתוחה. לפיכך, הכנת קניות לשבוע פירושה לעבור על הרשימה בחירה אחת בכל פעם, ללא אפשרות לאשר קבוצת פריטים בבת אחת.

מאחורי כל זה עמד כשל אחד שהשפיע בשני הכיוונים: הממשק נבנה בעיקר כדי להציג את עבודתו של העוזר. בראש כל קרוסלה הופיע השאילתה שיצרה אותה, והמועמדים הוצגו בסדר שבו נאספו. מונחי החיפוש וערכות התוצאות הגולמיות הם חומר הגלם של הסוכן. הצגת התוצאות באופן ישיר היא המקבילה בממשק להדפסת עקבות הערימה. העוזר נכנע לממשק באותה קלות, ועבד על פריט אחד בכל פעם, משום שערימה של קרוסלות לכל פריט הייתה מה שהמסך יכול היה להציג. כל אחד מהם תוכנן סביב המגבלות של האחר, ולא סביב הצרכן.

הלקח לא היה ששימוש חוזר ברכיבים קיימים הוא דבר שגוי; דווקא ההיכרות איתם היא הסיבה שבגללה העוזר מרגיש כמו DoorDash. פשוט בנינו עבורם את המכל הלא נכון. המכל הוא זה שקובע את סדר הופעתם, את מה שנמצא לצדם, ואת מה שהצרכן יכול לעשות איתם. מעל לכל, הצרכן זקוק למשטח קנייה ולא לממשק שיחה. בנינו ממשק שיחה שבמקרה הכיל רכיבי קנייה. השימוש החוזר ברכיבים סיפק לנו את אוצר המילים. הרכבתו למשטח קנייה הייתה החלק הקשה יותר.

מה שכן שרד את ההאקתון היה הבסיס: אותה תשתית סטרימינג שהוקמה אז היא זו שעליה פועלת החוויה כיום. בינתיים, שכבת הפענוח שהפכה את תוצאות הכלים לממשק המשתמש לא החזיקה מעמד. העוזר כבר לא מציג כלל את תוצאות הכלים. במקום זאת, השקענו זמן בבניית ארכיטקטורת ארטפקטים המפרידה בין דרישות הצרכנים לדרישות האחסון והסוכנים. במילים אחרות: הפסקנו לפענח את חומר העבודה של הסוכן לצורך תצוגה והתחלנו לבנות סביב הצרכים של הרכיבים השונים ושל צרכני המערכת.

איור 1: אותה בקשה לקניות במכולת, בהפרש של שנה. התוצר של ההאקתון הציג קרוסלה לכל פריט, כשבראש כל אחת מהן הופיע השאילתה שהובילה ליצירתה; הבחירה הושארה בידי הצרכן. כיום, העוזר מציג כל רשימה ככרטיס בשיחה, כשהפריטים המובילים כבר נבחרו מראש.

חפץ אחד, שלוש עדשות

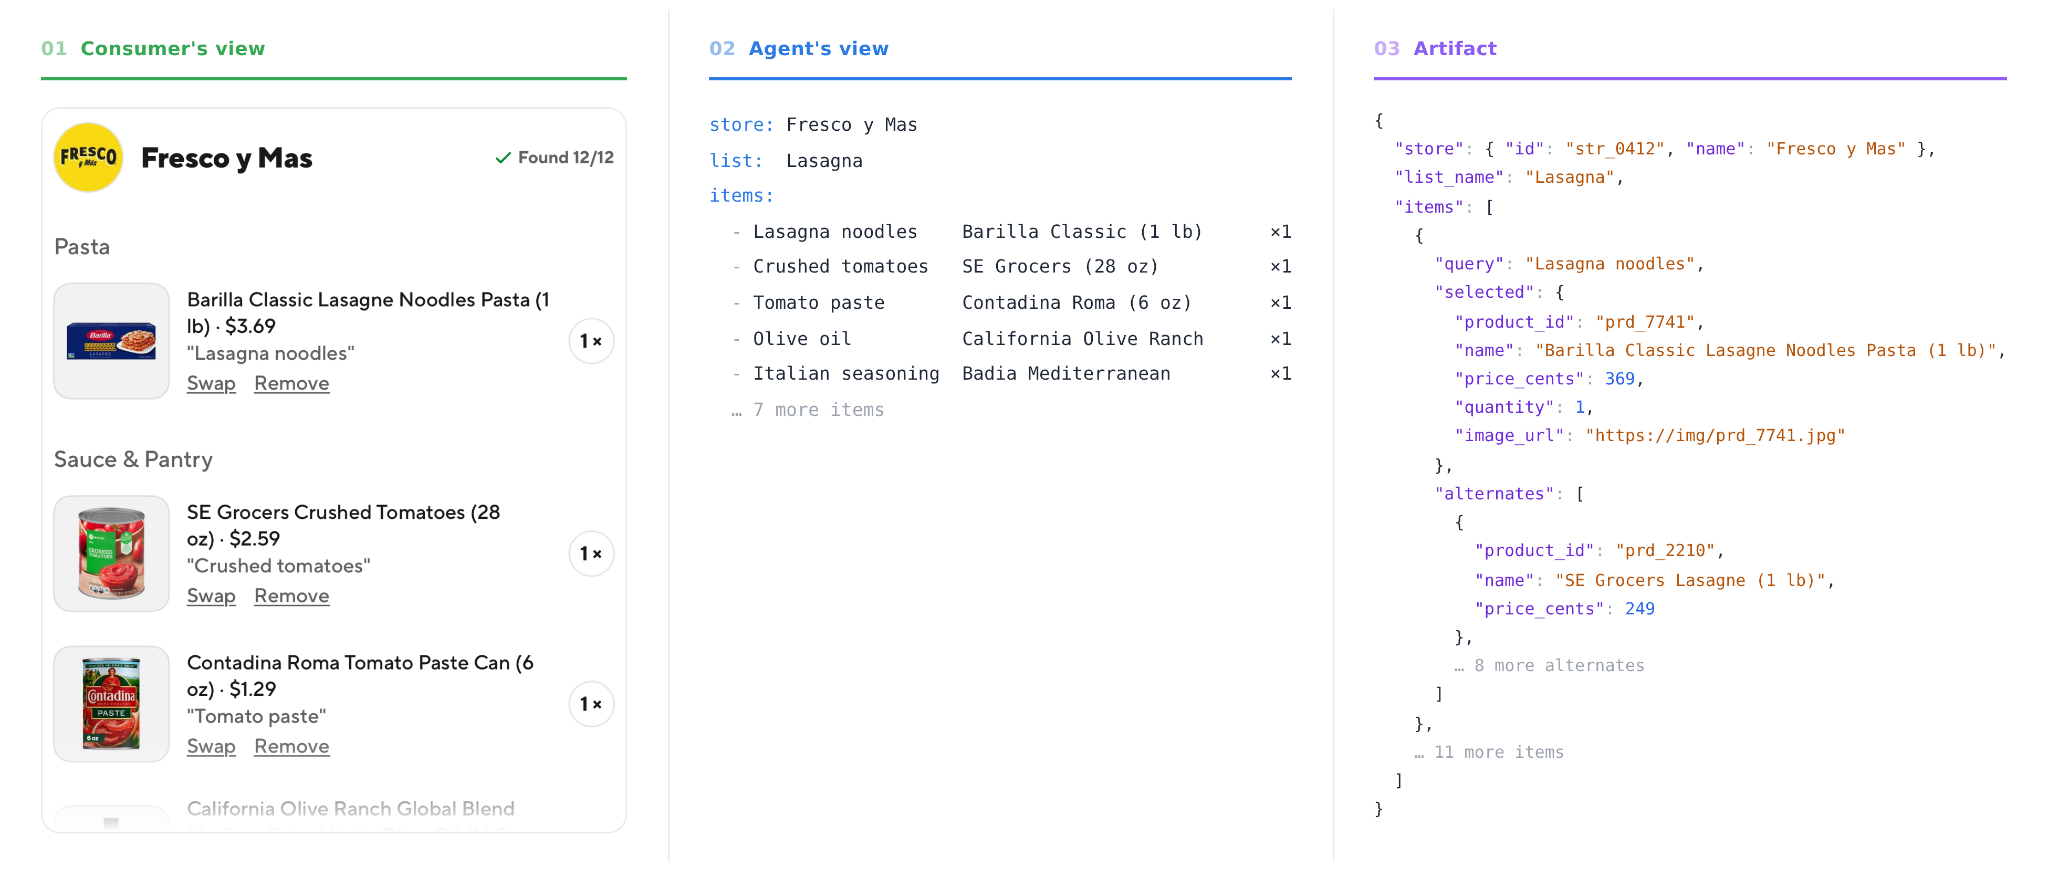
לרשימת קניות יש שלושה קוראים: השירות שאוחסן אותה, הסוכן שעורך אותה, והאדם שעורך את הקניות. כל אחד מהם צריך לראות מידע שונה. ההפרדה ביניהם היא זו שמאפשרת לעריכה של הצרכן להופיע באופן מיידי ולהישאר סמכותית, מבלי לדרוש סיבוב נוסף של המודל.

הפורמט המאוחסן הוא מערכת התיעוד: בלוק JSON המוחזק כאובייקט ב-Managed Agent Services, כפי שתואר בפוסט על הפלטפורמה. הוא חייב להיות שלם, והוא העותק המוסמך היחיד.

הסוכן אינו קורא את ה"בלוב" הזה באופן ישיר. רשימת קניות אינטראקטיבית מכילה פרטים רבים יותר ממה שהמודל זקוק לו ברוב פעולות ההמשך. חזרה על כל שם מוצר, מחיר, כמות, תחליף ופרט מטא-נתונים של התצוגה בכל תור תתחרה במה שהצרכן ביקש בפועל. לכן, כאשר סוכן מוציא "ווידג'ט", מה שנשאר בהקשר השיחה הוא סיכום תמציתי: החנות, ותוכן הרשימה. כאשר תור בשיחה דורש מצב מדויק, הסוכן קורא את האובייקט ומקבל בחזרה תצוגה מצומצמת, שממנה הוסרו נתוני המטא-נתונים של התצוגה. תצוגה זו חד-משמעית וקטנה מספיק כדי לעבד אותה ביעילות. רשימה ממוצעת תופסת בין 40 ל-60 KB בפורמט JSON. מה שנשאר בהקשר השיחה הוא שורה אחת של כ-240 תווים, קטנה פי 250 בערך.

מה שהצרכן רואה שונה שוב, והוא לובש יותר מצורה אחת. בשיחה, הרשימה מוצגת כווידג'ט קומפקטי: החנות, שם הרשימה, זמן ההגעה המשוער, כמה תמונות של פריטים וכפתור "הוסף לעגלה" המציג את הסכום הכולל המשוער. זה מספיק כדי להעריך את הרשימה במבט חטוף מבלי לצאת מהצ'אט. כפתור "הצג רשימה" פותח את תצוגת המסך המלא, המציגה את הרשימה המלאה ואת כל הדרוש כדי לעבור עליה בפירוט. שתי התצוגות בנויות כך שניתן להבין אותן מיד ולבצע פעולות ישירות.

פרט אחד ממחיש עד כמה הדעות הללו שונות זו מזו. כאשר הסוכן בוחר מוצר עבור פריט ברשימה, הוא שומר את שאר המוצרים שהתאימו לאותו חיפוש, והצרכן יכול לעבור ביניהם בלחיצה אחת. הוא שומר עשרה מועמדים לכל פריט, ול-99.7% מהפריטים יש מספיק תוצאות תואמות כדי למלא את הרשימה הזו, כך שכמעט כל שורה בתצוגה של הצרכן כוללת בחירה אחת ותשע חלופות מאחוריה. תצוגת הצרכן מציגה את כל החלופות הללו. תצוגת הסוכן אינה מציגה אף אחת מהן, מכיוון שהבחירה ביניהן היא תפקידו של הצרכן (אלא אם כן מתבקש העוזר במפורש לעשות זאת).

איור 2: רשימה אחת, שלוש נקודות מבט. הצרכן רואה מחירים, תמונות ואפשרות להחלפה מאחורי כל שורה. הסוכן רואה רק את החנות ואת תוכן הרשימה. האובייקט מכיל את כל המידע, כולל תשע חלופות לאטריות הלזניה בלבד.

להישאר עם הרגליים על הקרקע

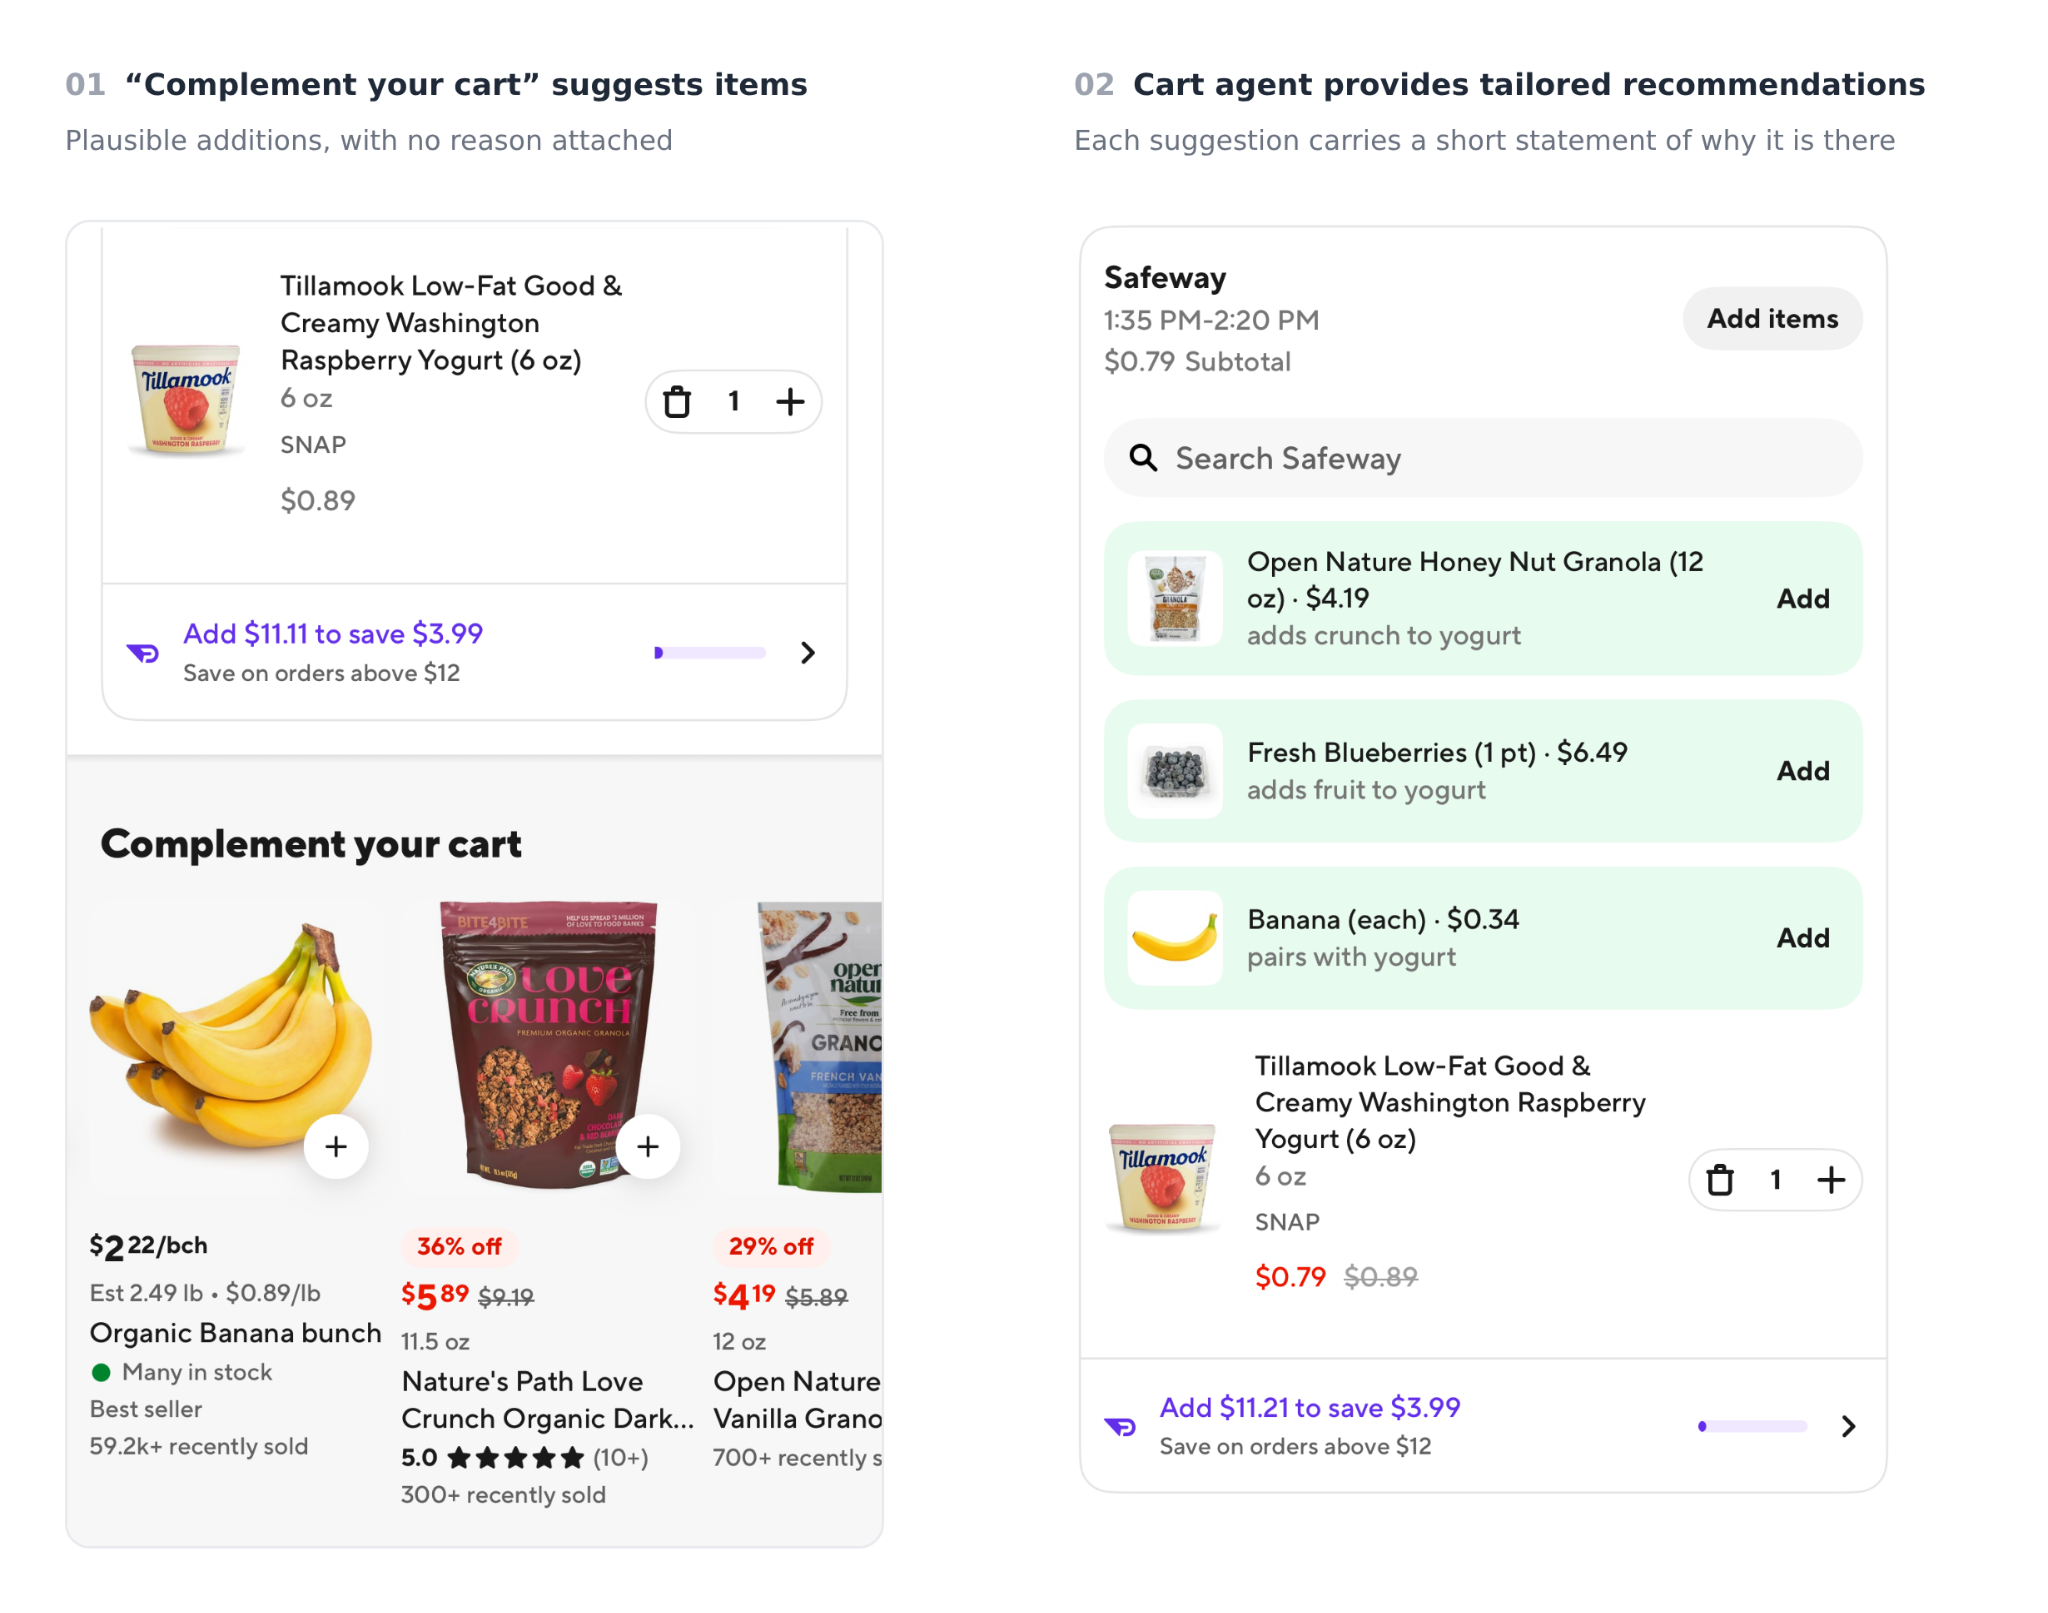
כאשר העגלה מכילה יוגורט פטל, לחיצה על "המלצות לשילובים בעגלה" מציגה שתי הצעות: גרנולה, "כי היא משתלבת עם היוגורט שלך", ואוכמניות, "כדי להוסיף פירות ליוגורט שלך" (ראו איור 3). המקרה המנוגד כבר קיים במוצר שלנו, באותו מסך: דף העגלה כולל קרוסלה של פריטים משלימים המציעה פריטים שהצרכן עשוי לרצות להוסיף, ללא נימוק נלווה. סוכן העגלה שלנו היה יכול להחזיר בדיוק את זה – רשימה של פריטים סבירים. ייתכן בהחלט שהפריטים היו זהים בכל מקרה. ההנמקה היא זו שמבהירה לצרכן שההצעה הייתה מבוססת על היגיון ולא רק סבירה, ומכיוון שכל רכיב הוא גם מקום לפעולה, להבחנה הזו יש משמעות מעשית.

זה מה שהקשר למציאות מספק: ההבדל בין חווית קנייה משכנעת לבין גימיק. אם התפוקה של העוזר אינה מוחשית, לצרכנים אין סיבה של ממש לעבור מחוויית האפליקציה העשירה ש-DoorDash כבר מספקת. הטקסט עדיין עושה את העבודה, אך בתפקיד משני. בכוונה שילבנו את ההיגיון העומד מאחורי העוזר בתוך הווידג'טים ומסביבם, במקום להציג את תאי הפריטים בדיוק כפי שהם מופיעים במקומות אחרים באפליקציה.

הבסיס חייב להיות תקף גם ברמת הנתונים, ובנקודה זו העבודה מתחלקת. הסוכן בוחר סוג תוכן נתמך ומספק את נתוני המסחר עבורו; לקוח ה-iOS אחראי על התצוגה והאינטראקציה, וממפה תוכן זה לרכיבי מערכת העיצוב המקורית של DoorDash. בקשה למכולת מייצרת רשימת קניות הניתנת לעריכה, הכוללת כמויות, תחליפים וסכום ביניים. בקשה למסעדה יכולה לייצר כרטיסי חנות, כרטיסי פריטים או הצעות לעגלת הקניות.

החלוקה הזו היא הבסיס לנתונים עצמם. ערכי המסחר בווידג'ט אינם נלקחים מהמודל. מחירים, מלאי, שעות פתיחה של החנות ותכולת עגלת הקניות נקראים מאותן מערכות רישום שהאפליקציה כולה משתמשת בהן, ולכן מחיר המוצג ב-Ask תואם למחיר המופיע בדף החנות באותו הרגע. תוכן מסוג מסוים (typed) מספק גם לשרת וללקוח הסכם יציב. תמיכה בווידג'ט חדש דורשת יותר משינוי מיידי. הסוכן צריך לדעת מתי להשתמש בו ומה להכניס לתוכו, והלקוח זקוק לסכימה שמית בנוסף לקוד הדרוש לפיענוח ולרינדור שלה. מעבר לכך, ווידג'ט חדש מגיע לצרכן באמצעות אותו מנגנון שיחה וסטרימינג כמו כל ווידג'ט אחר.

איור 3: שני סוגים של הצעות לגבי אותה עגלה. רק באחת מהן מוסבר מדוע.

ווידג'טים כערוצי קלט/פלט

כל ווידג'ט חדש ששילבנו תרם לכך שהעוזר ייראה פונקציונלי יותר. הסיבה לכך קשורה לא פחות לתשומות מאשר לפלטים. ישנו גבול אחד המנחה את כולם: עריכה דטרמיניסטית נשארת בצד הלקוח ומוחלת ישירות על הארטיפקט, בעוד ששינוי הדורש שיקול דעת מפעיל תור של הסוכן. הדוגמאות שלהלן מסודרות לפי המיקום שבו עובר קו הגבול הזה.

הגרסה שהוכנה בהאקתון שאלה את הצרכן איזו חנות הוא רוצה, ואז המתינה עד שיקליד את התשובה. לא הייתה לה שום דרך לבחור בעצמה; כיום הבחירה הזו מתבצעת באופן אוטומטי. עדיין יש שפע של שאלות אחרות שדורשות את מעורבות הצרכן, והקלדה ישירה עשויה להיות דרך לא יעילה לאיסוף התשובות. הזנת טקסט היא מגבלה של תהליך חד-הליכי: הצרכן אולי יודע את כל התשובות, אך יכול לספק אותן רק בקצב שבו הוא מקליד או מדבר.

זה המקום שבו הווידג'טים מוכיחים את ערכם. לצרכן עשויות להיות עשר פעולות שצריך לבצע ברשימת הקניות, וכל אחת מהן פשוטה. כל פעולה בפני עצמה היא דבר של מה בכך; אך כאשר מתארים אותן במילים, הן הופכות למשימה מורכבת. זהו ההבדל בין להסתכל מעבר לכתפו של מישהו ולומר לו על אילו כפתורים ללחוץ, לבין ללחוץ על הכפתורים בעצמך.

שאלות הבהרה מובנות הן הדוגמה הברורה ביותר, והדפוס לקוח מתחום תכנות הסוכנים: הכלי AskUserQuestion של Claude Code מבצע את אותה המשימה עבור מפתחים. אנו מספקים ווידג'ט שמפריע לצרכן עם סדרה קצרה של שאלות (בחירה מרובה ובחירה מרובת אפשרויות), ומאפשר לו לכוון את השיחה בנקודות פתוחות באמת. זה הפך לעמוד תווך מרכזי במודל האינטראקציה בסוכן המכולת, וכעת הוא מיושם גם בסוכן המסעדות כדי לפשט את אותו סוג של אינטראקציה. אנו משלבים את הכלי בפלטפורמת הזיכרון הצרכנית שלנו, שמצמצמת את האפשרויות באופן משמעותי, אך עדיין נותרים פערי ידע הדורשים קלט מצד הצרכן. אין מנוס משאלות. אך אנו יכולים לשאול באופן שקל ויעיל לצרכן לענות עליו.

תצוגת הרשימה במלוא העמוד היא המקום שבו שיתוף הפעולה בין קלט לפלט מתממש. הצרכן יכול לשנות את כמות הפריט, למחוק פריט, להחליף פריט באחת החלופות שהעוזר מצא לצדו, ולהוסיף את הרשימה הסופית לעגלת הקניות שלו. כל אחת מהפעולות הללו משפיעה ישירות על האובייקט. אף אחת מהן אינה מחייבת את העוזר לפעול בשם הצרכן, ואף אחת מהן אינה כרוכה בסיבוב הלוך ושוב של מודל שפה גדול (LLM). מקרה ההחלפה מנצל טוב יותר את מערכי המועמדים שנבנו בהאקתון. החלופות שביניהן הצרכן בוחר הן המועמדים האחרים שהעוזר איתר בעת בחירת הפריט. רשימת כל האפשרויות העומדות לרשות הצרכן מילאה בעבר קרוסלה. כעת הן נמצאות במרחק נגיעה אחת מההחלטה, במקום להיות פזורות לפני הצרכן כשאלה פתוחה.

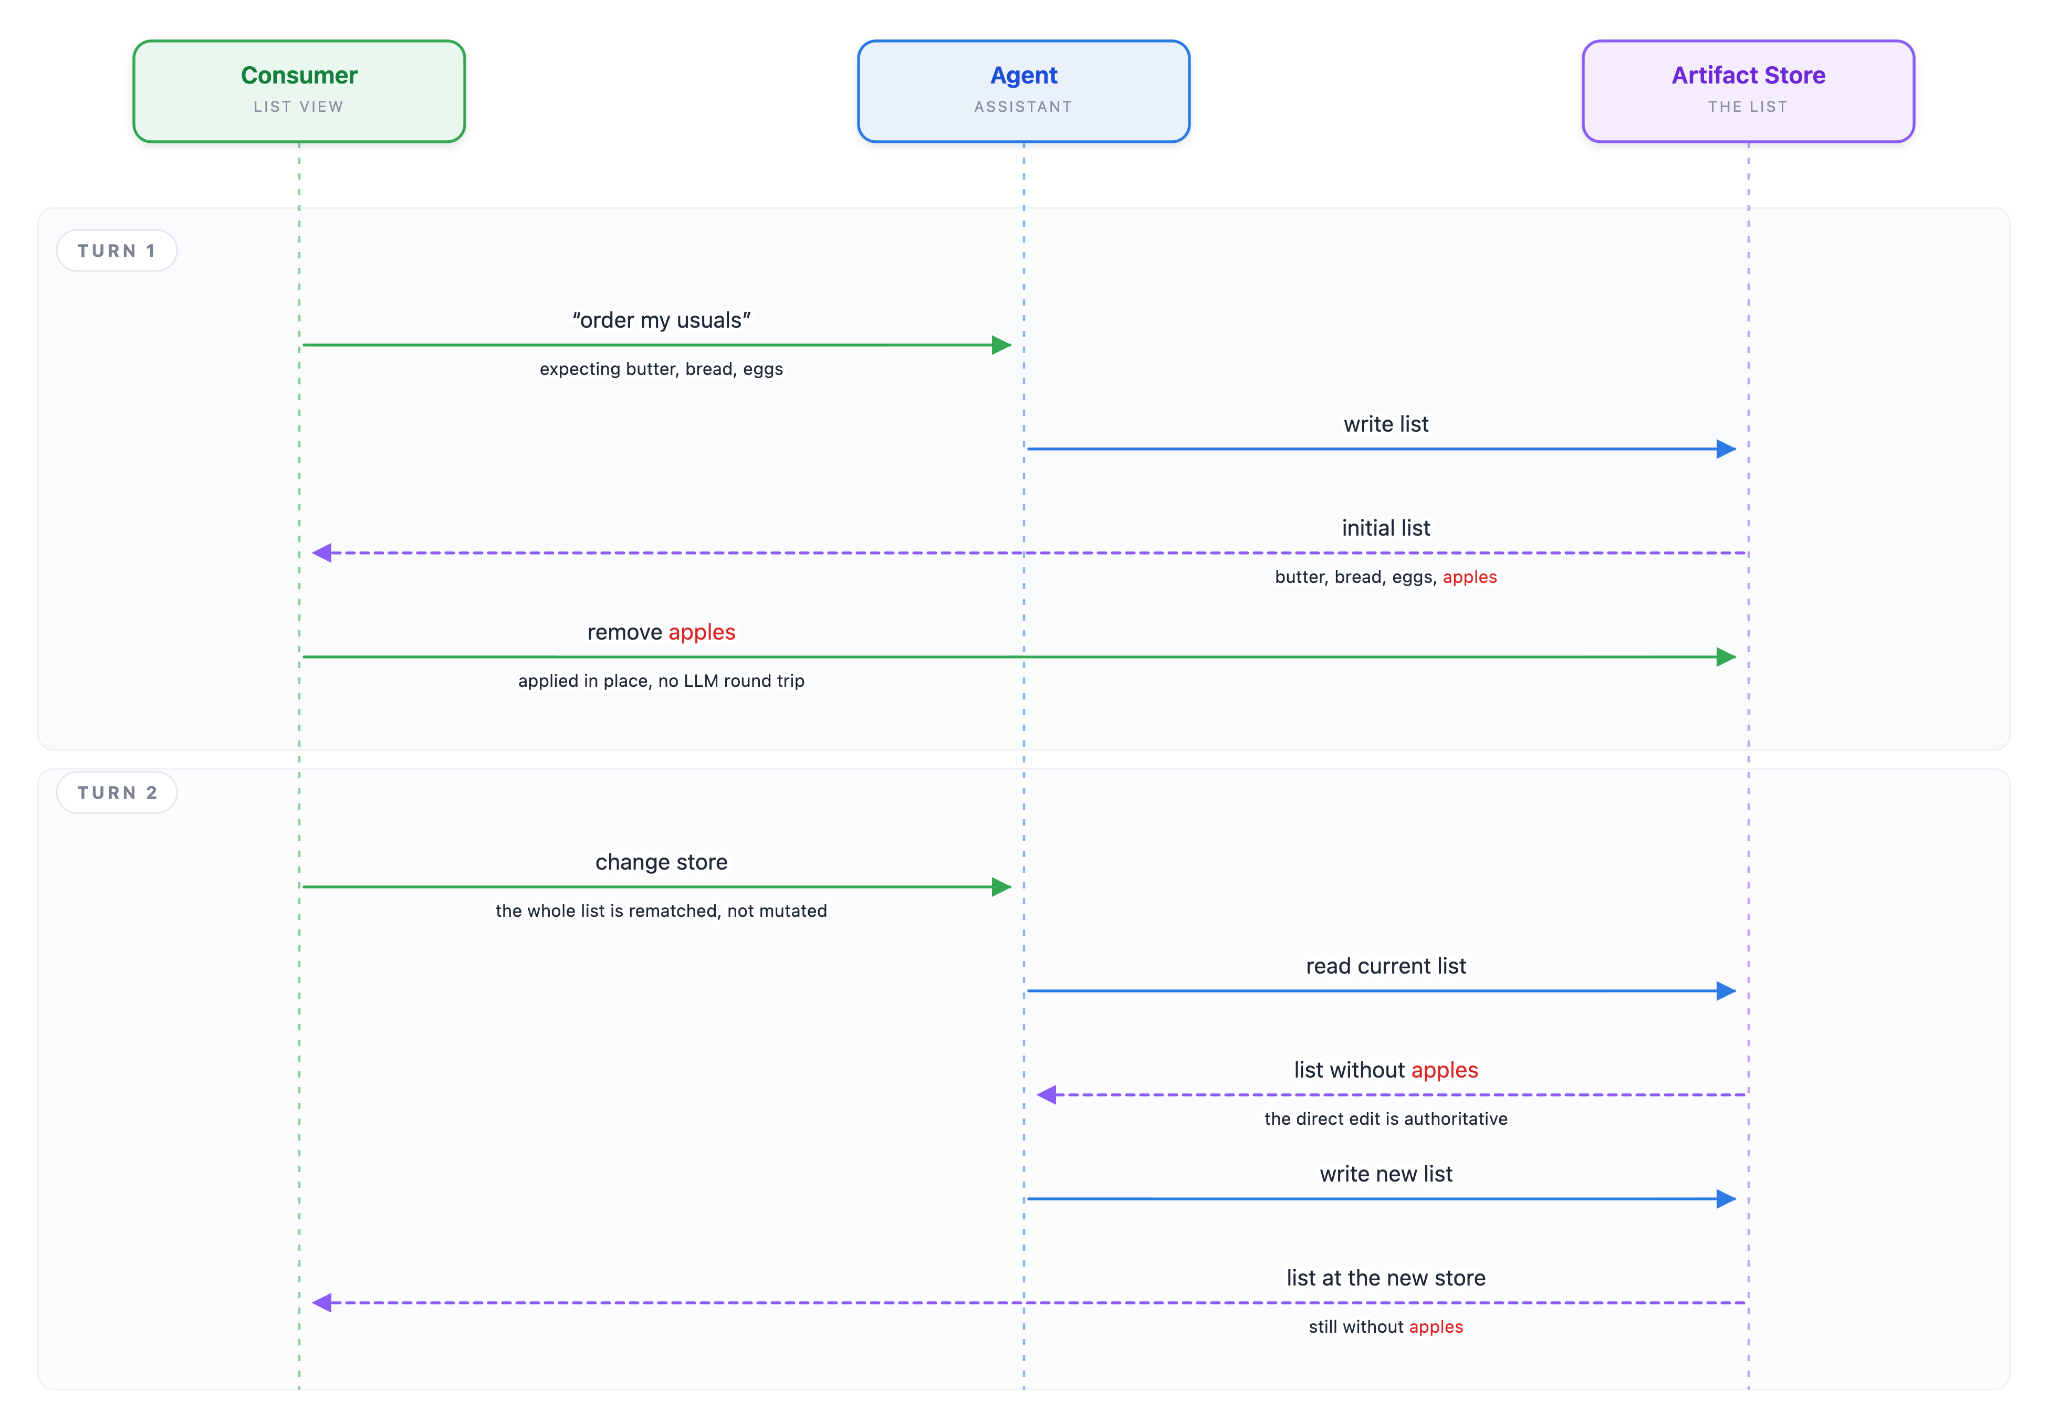
שינוי החנות הוא היוצא מן הכלל, והיוצא מן הכלל הוא החלק המעניין. זה אינו שינוי של הרשימה הקיימת. זה מתפתח לבקשה מהעוזר, שבונה מחדש את הרשימה בחנות החלופית. אינטראקציה זו נדירה גם היא: היא הייתה הפעולה הראשונה ב-0.1% מהפעמים שבהן המשתמשים היו מעורבים, וזה בערך מה שהיינו מצפים לו אם הקו היה נמתח במקום הנכון בערך. אם מציבים את הקו במקום הלא נכון, הצרכן או שמחכה שהעוזר יבצע פעולה שהוא היה יכול לבצע בלחיצה אחת, או שמקליד את דרכו דרך פעולה שהייתה יכולה להרוויח מהשיקול הדעת של העוזר.

החפץ מאפשר את הפיצול בצורה בטוחה, ושני הצדדים כותבים אליו באופן שונה. שינוי בכמות, הסרה או החלפה עוברים במסלול הקצר: הלקוח מעדכן את הרשימה במקום, והעריכה מופיעה מיד. לעומת זאת, שינוי באחסון מפעיל תור של סוכן, מכיוון שיש להתאים מחדש את הרשימה כולה לקטלוג אחר. עדכון של הסוכן אינו מחליף את מה שהיה שם; הוא מייצר רשימה חדשה הנגזרת מהרשימה הקודמת.

התוצאה היא שעריכה ישירה היא הקובעת. לפני שתור מסוים משנה את הרשימה, הסוכן קורא את הרשימה הנוכחית במקום לעבוד על סמך התמליל; לפיכך, אם הצרכן מסיר את חלב השיבולת-שועל, התור הבא מתחיל מרשימה שבה אין חלב שיבולת-שועל.

ההתנהגות שנמדדה באותה תקופה מראה היכן עובר הקו הזה. מיד לאחר הבקשה הראשונה, כמעט שלושה רבעים מהפעולות הבאות הראשונות בוצעו באמצעות רכיב. מההודעה השנייה ואילך המגמה מתהפכת, והפעולות הבאות שהוקלדו מהוות את הרוב בכל רמת עומק שנמדדה. פקדי השליטה מטפלים בשיפורים המיידיים והמבניים; השפה תופסת את מקומם כאשר השינוי גדול יותר או קשה יותר לביטוי באמצעות הקשה.

איור 4: הרשימה מעבר לגבול הסיבוב. הצרכן מסיר את התפוחים ישירות בתצוגת הרשימה, ללא העברה הלוך ושוב של המודל. כאשר החנות מתחילה סיבוב חדש, הסוכן קורא את הארטפקט במקום את התמליל, ולכן הרשימה שהוא בונה מחדש בחנות החדשה עדיין נטולת התפוחים.

כל גרסת עריכה של עוזר נשארת פעילה

כאשר העוזר מתקן רשימת קניות, הגרסה שהוא מחליף נשארת על המסך וניתן להמשיך להשתמש בה.

זו לא הייתה היישום הראשון שלנו. הגרסה הראשונה הסתירה רשימות שהוחלפו: ברגע שהגיעה גרסה חדשה, לא היה אפשר עוד להציג או לערוך את הרשימה שקדמה לה. רשימה אחת עדכנית, בלי בלגן. זה נראה כמו התנהגות מסודרת יותר. אבל בפועל, זה גרם לכך שהשינוי נראה כמו תהליך יקר. אם בקשת שינוי עלולה למחוק רשימה שהיית מרוצה ממנה, הצעד הבטוח הוא להפסיק לבקש, וזה פוגע בכל הרעיון של זרימת עבודה שיתופית.

לכן, כל עדכון עוזר מייצר כעת תוצר חדש הנגזר מהקודם, וכל אחד מהם נשאר במקום שבו נוצר בשיחה. אם גוללים לאחור, כל הגרסאות הקודמות עדיין שם, עדיין פעילות: הצרכן יכול לפתוח רשימה קודמת, לערוך אותה או להוסיף אותה לעגלת הקניות שלו במקום הרשימה העדכנית ביותר. בקשת שינוי אינה כרוכה בעלות כלשהי, שכן מה שהיה לו לפני רגע נמצא במרחק גלילה אחת בלבד.

לא כל רשימה שהעוזר בונה הופכת לגרסה שהצרכן רואה. כאשר הוא מרכיב רשימת מועמדים ומגיע למסקנה שהחנות אינה מחזיקה את המוצרים המבוקשים, הרשימה הזו לעולם לא מוצגת. הצרכן מקבל הודעה טקסטואלית המציינת כי בחנות חסרים פריטים וכי רשימה חדשה נמצאת בדרך. זהו אחד המקרים הבודדים שבהם הטקסט עושה את העבודה באופן ישיר, וזו הסיבה העומדת מאחורי כל השאר בפוסט זה: האינטראקציה משמשת לפשט, והטקסט משמש להסביר.

כאשר רשימה הופכת לעגלת קניות

עוזר שעורך את עגלת הקניות באופן ישיר יכול להסיר פריט שהצרכן רצה, או להוסיף פריט שהוא מעולם לא אישר, מבלי שיידרש לכך. טעות אחת בלבד מספיקה כדי לאבד את אמונו של הצרכן, משום שהטעות מתרחשת בשקט ומשפיעה על הפריט שעבורו הוא עומד לשלם.

לכן, במקום זאת, אנו מציגים רשימת קניות כהצעה. היא יכולה להכיל עשרות פריטים ולעבור מספר סבבי תיקון, בין אם מדובר בהסרת פריט מהמזווה שכבר נמצא ברשות הצרכן, שינוי כמות, החלפת מוצר או יצירת גרסה חדשה לחלק מהמתכון – וכל זאת מבלי לגעת בעגלת הקניות. כדי לאשר את הרשימה נדרשת לחיצה מפורשת על "הוסף לעגלה", שהיא המבנה הפשוט ביותר שמצאנו, המעניק לצרכן שליטה אמיתית מבלי לחייב אותו לפקח על כל שלב.

עדיין יש ליישר את ההבדלים בין שני הפריטים, והבחירה המעניינת היא מי יעשה זאת. העוזר סורק את תכולת העגלה תוך כדי יצירת הרשימה, אך הוא אינו מתאים את הרשימה באופן אוטומטי: אם מתכון דורש שני בננות, הרשימה תציין שתיים, בין אם יש כבר ארבע בעגלה ובין אם לאו. יצירת הרשימה בהתאם לבקשה המדויקת, ויישורה מול תכולת העגלה כצעד נפרד, מאפשרת לרכז את ההחלטה במקום אחד.

שלב זה מתרחש בעת ביצוע ה-commit. כאשר הרשימה ועגלת הקניות חופפות, מוצגים לצרכן הפריטים הכפולים, והוא בוחר אם להחליף את הכמויות הללו או להוסיף עליהן. זהו רגע קצר, אך ברגעים קטנים כאלה נקבעת האמון – או הולכת לאיבוד.

העברת הקשר ברחבי DoorDash

לא די בכך שהעוזר יהיה זמין במיקום אחד; הוא חייב להיות נגיש מכל מקום באפליקציה. פתיחת העוזר היא כבר סימן חזק לכוונה, אך זהו סימן מעורפל. צרכן באותו רגע עשוי להזמין ממסעדה אהובה, לקנות מצרכים לשבוע, לחפש זוג אוזניות חדש או לחפש תמיכה בהזמנה קודמת. צרכן שהגיע לחנות מכולת מסוימת משדר איתות חד הרבה יותר: סביר להניח שהוא מתכוון להרכיב עגלת קניות באותה חנות. העברת ההקשר הזה לעוזר היא מה שמאפשר לו להתמקד בכוונה הסבירה במקום לשאול.

מערכת ה-scope שתכננו למטרה זו משתרעת על פני הלקוח והשער. הלקוח מצרף לכל בקשה מרכיבים מרכזיים של הקשר הכניסה: הנושא שתחתו נכנס הצרכן (מכולת, מסעדה), החנות שהוא בוחן וכמה מזהים קשורים. השער משתמש בנושא כדי להחליט לאיזה סוכן להפנות את התור, ובשאר הפרטים כדי לספק לכלים את המזהים הדרושים להם.

Scope הוא במכוון מערך שטוח של זוגות מפתח-ערך, ולא סכימה טיפוסית, והלקוח הוא זה שמחליט מה ייכלל בו. מפתחות שלא זוהו מועברים הלאה במקום להידחות, כך שמשטח חדש יכול להתחיל לשלוח הקשר מבלי להמתין לשינוי ב-Gateway. היוצא מן הכלל הוא הנושא עצמו: הוספת נושא חדש פירושה ללמד את ה-Gateway לאיזה סוכן הוא צריך לנתב אותו. לכן, בעוד שמשטח חדש הוא זול, תחום חדש אינו כזה.

הנושא הוא גם החלק הרלוונטי אך ורק להודעה הראשונה בהקשר נתון. הדבר מספק לעוזר בסיס יציב לעבודה מבלי להיות מגביל יתר על המידה, וזה מה שמאפשר למשתמשים לצאת מההקשר כאשר הם בוחרים בכך במפורש. משתמש המשתמש בעוזר בתוך מסעדה יכול לצאת לחלוטין מההקשר של המסעדה על-ידי בקשה: "מצא לי מתכון למנה הזו, והכן לי עגלת קניות, כדי שאוכל להכין אותה בבית". בקשה זו אינה חינמית, אך העלות היא "קפיצה" בתוך התהליך ולא מבוי סתום: הסוכן של המסעדה צריך לזהות את הבקשה ככזו שאינה בתחום אחריותו ולהחזיר אותה לפני שסוכן אחר ייקח אותה.

במקרים מסוימים, תחומים (scopes) יכולים גם לאפשר לנו לדלג על המודל לחלוטין. קחו לדוגמה את נקודת הכניסה "להזמין מחדש את העגלה האחרונה שלי". אפשר פשוט לשלוח את הביטוי הזה לעוזר כהודעה, ואף על פי שזה יעבוד, צירוף תחום מאפשר לנו להיות מדויקים יותר. המקרה של "הזמנה מחדש" הוא למעשה דטרמיניסטי, ולכן אנו יכולים לעקוף את ה-LLM ולהחזיר רשימת קניות כמעט באופן מיידי. התוצאה היא ווידג'ט רגיל של רשימת קניות: הצרכן יכול לשנות כמויות, להחליף מוצרים או לבקש מהעוזר לערוך אותה בצ'אט, בדיוק כפי שהיה עושה עם כל רשימה אחרת. שימו לב שהעקיפה תקפה רק אם החנות עדיין מחזיקה את כל הפריטים שהיו בעגלת הקניות הקודמת; אם פריט כלשהו אינו זמין, הבקשה מועברת לסוכן המכולת, אשר בונה מחדש את הרשימה באותו אופן שבו היה עושה זאת על סמך בקשה שהוקלדה.

הגדרת ההיקף היא גם זו שמאפשרת שיחה רציפה אחת לאורך כל מושב האפליקציה, אך היא פועלת רק משום שההיקף, קישור הסוכן ומצב המושב נשמרים בנפרד. אנו מתייחסים להיקף כאל הקשר לכל תור. ה"הצמדה", שתוארה קודם בסדרת הפוסטים בבלוג, שומרת על תורים עוקבים עם הנציג שפתר את התור הקודם. הן ההצמדה והן התמליל (השיחה עצמה) נשמרים במסגרת הצ'אט ולא במסגרת ההיקף, כך שצרכן שעובר מחנות אחת לאחרת מכוון מחדש את ההצמדה לנציג מתחום חדש מבלי לאבד את תוכן השיחה. מספר נציגים מתמחים בתחומי משנה, והמערכת כולה ממשיכה להתנהג כעוזר אחד.

איור 5: צ'אט אחד, שהוזן משני מקומות. ההיקף משתנה בהתאם לכל בקשה, ולכן בקשה בתוך Safeway מוסיפה לרשימה ב-Safeway.

מַסְקָנָה

שילוב הסוכנים במוצרי הצריכה נמצא עדיין בשלב מוקדם. עם זאת, היסודות מתחילים להתבהר. הווידג'טים הם המקום שבו הצרכנים מבצעים את העבודה, והשיח בין הצרכן לסוכן הוא זה שמנחה אותם. כיום ישנם שלושה "קוראים" של אובייקט רשימת הקניות שלנו, וכל אחד מהם זקוק לתצוגה שונה שלו. אנו משתמשים בחלק הפונה למשתמש כדי לקשר את הצרכן למוצרים אמיתיים ולהפוך שינויים נפוצים לפעולות בלחיצה אחת. ככל שהסוכנים ייקחו על עצמם חלק גדול יותר מהעבודה, אנו מצפים שמה שהצרכן צריך לראות ומה שהסוכן צריך לשקול ימשיכו להשתנות, והקו המפריד בין ממשק אפליקציה לממשק צ'אט יהפוך לקשה יותר להגדרה.

פלטפורמת הניסויים של DoorDash מנהלת למעלה מ-60,000 דגלי תכונות בכ-623 מאגרי קוד. זיהינו למעלה מאלף דגלי תכונות מיושנים; במילים אחרות, התכונה שהדגל שימש בעבר לשליטה עליה כבר הושקה במלואה, אך הדגל והלוגיקה של הענפים שלו עדיין נמצאים בבסיס הקוד כמשקל מת. ניקוי ידני של דגל אחד בלבד לוקח למהנדס בין שעה לשעתיים. עם כ-2,300 דגלים חדשים שנוצרים מדי חודש, הצבר רק הולך וגדל.

לכן בנינו מערכת LLM רב-סוכנתית שמנקה דגלים מיושנים מקצה לקצה, החל מכרטיס Jira ועד לבקשת משיכה (PR) המוכנה למיזוג, ללא מעורבות אנושית למעט מהנדס המאשר את הערך היעד ואת השלמת ה-PR. מתוך 50 הדגלים המיושנים האחרונים שעיבדה, המערכת יצרה בקשות משיכה שמישות עבור 45 מהם, בעלות ממוצעת של 4.79 דולר ו-13.8 דקות לכל דגל, ובכך חסכה אינספור שעות עבודה של מהנדסים. המערכת שבנינו לא רק הייתה צריכה להיות יעילה, אלא שגבולות האמינות שלה היו צריכים להיות של שלמות, ולא של נכונות; אם הסוכן נכשל, הוא היה צריך לעשות זאת בבטחה, מבלי לבצע שינויים בקוד שעלולים לגרום לתקלות.

פוסט זה עוסק בסיבות שבגללן כלים מדף לא הצליחו לבצע משימה זו בבסיס הקוד שלנו, באופן שבו תכננו את המערכת, ובמה שלמדנו במהלך פריסתה. הערה: עבודה זו עברה ביקורת עמיתים והתקבלה למסלול התעשייה של כנס ICSME 2026.

מדוע כדאי לבטל באמצעות אוטומציה דגלי תכונות מיושנים

דגלי תכונות מהווים אבן יסוד באספקת תוכנה מודרנית. הם מאפשרים לנו להטמיע תכונות בהדרגה, לבצע ניסויים מסוג A/B, ולהפעיל "מתגי כיבוי" כאשר משהו משתבש. אך לכל דגל יש מחזור חיים, וברגע שתכונה מסוימת הוטמעה במלואה, הדגל שלה הופך למיושן. דגלי תכונות מיושנים נותרים לעתים קרובות כחוב טכני, משום שזמנו של מהנדס יקר יותר בהפיתוח של תכונות חדשות מאשר בניקוי תכונות קיימות. 

הלוגיקה המותנית שלו כבר אינה משרתת שום מטרה, אך היא לא סתם שוכנת שם ללא כל השפעה:

  • דגלים מיושנים עלולים להישאר בבסיס הקוד במשך שנים. מחקרים קודמים מצאו שכ-25% מדגלי התכונות נשארים פעילים במשך יותר משמונה שנים בפרויקטים בקוד פתוח; אנשי המקצוע מדווחים באופן עקבי כי תהליך הניקוי הוא משימה מכבידה, והוא נדחה שוב ושוב.
  • דגל מיושן הוא חוב טכני. כל דגל מיושן מוסיף ענף, מקרה קיצון, ועוד קצת חומר לקריאה ולהבנה, מה שעלול להיות מכביד במיוחד בעת התרחשות אירוע.
  • דגלים מיושנים עלולים להוות סיכון תפעולי. דגל מיושן משמר מסלול קוד רדום שעלול להיות מופעל מחדש בטעות. במקרה אחד שתועד היטב, חברת מסחר השתמשה בדגל מיושן למטרה אחרת במהלך פריסה, מה שגרם לעסקאות לא מכוונות בהיקף של 460 מיליון דולר תוך 45 דקות בלבד.

אם מכפילים עשרות אלפי דגלים בקצב יצירת דגלים חודשי בן ארבע ספרות, מתברר כי ניקוי ידני פשוט אינו יכול לעמוד בקצב. פינוי הצבר הישן שלנו באופן ידני היה עולה אלפי שעות הנדסה, שיהיה עדיף להשקיע בפיתוח.

ערכים דינמיים

דגלי תכונות ב-DoorDash מכונים "ערכים דינמיים" (DV). הם מופעלים באמצעות פלטפורמת הניסויים שלנו. לאורך פוסט זה, המונח DV משמש כשם נרדף ל"דגל תכונה".

מחזור החיים של DV עובר את השלבים הבאים: יצירת תבנית → ניסוי → פריסה → התיישנות → הסרה. אנו מסווגים DV כ"מיושן" כאשר הוא עומד בכל הקריטריונים הבאים:

  1. הוא לא עבר שינויים ב-90 הימים האחרונים.
  2. עדיין יש אליו הפניה בקוד.
  3. הוא עדיין לא נמצא במצב של סיום מחזור חיים (בארכיון או שהוצא משימוש).
  4. זה לא מופיע ברשימת ההחרגות.

משימת cron יומית פותחת כרטיס Jira מסוג STALEDV עבור כל DV מיושן שזוהה, ומקצה אותו ליוצר ה-DV. פעולה זו מסמנת את תחילת התור שממנו פועלת מערכת הניקוי שלנו.

זרימת עבודה סוכנתית לעומת כלי ניקוי מבוססי AST

הגישה האוטומטית הידועה ביותר לניקוי דגלים היא Piranha ויורשתה התומכת במספר שפות, אשר מפשטות תנאים המותנים בדגלים באמצעות התאמת תבניות בעץ התחביר המופשט (AST). גישה זו פועלת היטב כאשר דגל נקרא באמצעות קריאה ישירה ל-API, שאותה כלל כתיבה מחדש יכול להתאים לתבנית.

אבל ב-DoorDash לא כך ניגשים ל-DVs. השירותים שלנו משתמשים בתבנית עטיפה בת שלוש שכבות עם הזרקת תלות:

// Layer 1: RuntimeKeys.kt – the DV name as a string constant
object RuntimeKeys {
  const val ENABLE_X = “enable_feature_x”
}

// Layer 2: FeatureFlags.kt – a DI wrapper that calls the DV client
@Singleton
class FeatureFlags @Inject constructor(
    private val dvClient: DynamicValuesClient
) {
  fun shouldEnableX(userId: String): Boolean =
    dvClient.getBoolean(ENABLE_X, withContext(“user_id” to userId), false)
}

// Layer 3: business logic – uses the flag via dependency injection
class MyService @Inject constructor(
    private val featureFlags: FeatureFlags
) {
  fun process(userId: String) {
    if (featureFlags.shouldEnableX(userId)) handleNewPath()
    else handleOldPath()
  }
}

זוהי הפרדה ברורה בין נושאים, אך משמעות הדבר היא ששמו של ה-DV, קריאת ה-API והלוגיקה המותנית נמצאים כל אחד בקובץ נפרד, ומחוברים זה לזה אך ורק באמצעות קריאות למתודות והזרקת תלות. מדובר בקשרים סמנטיים, ולא תחביריים; מתאמי תבניות AST אינם יכולים לעקוב אחריהם. 

קביעת ערך היעד

ישנה בעיה נוספת שכלי המתבסס על קוד מקור בלבד אינו יכול לפתור: קביעת ערך היעד ובדיקת מצב הפריסה בזמן אמת. כלי שקורא רק את קוד המקור עלול לקבוע בביטחון ערך שגוי בקוד ולשנות את ההתנהגות בשקט. כדי להבטיח שהכלי יבצע את ניקוי הקוד הנכון, יש לדעת את מצב הפריסה בזמן אמת של הדגל, הנמצא בפלטפורמת הניסויים ולא במאגר הקוד. לדוגמה, פלטפורמת הניסויים של DoorDash תומכת בשימוש בדגלי תכונה מסוג מספר שלם, מחרוזת ו-JSON. קריאה בזמן אמת של ערך היעד מבטיחה שהכלי משנה את הקוד עם הערך הנכון של דגל התכונה, המייצג את המצב הנוכחי של המערכת. באופן דומה, מידע על הפריסה הוא גם חלק חשוב במשוואה. ייתכן שניסוי הושק ב-60% מהמערכת ואז ננטש. הכלי צריך להיות חכם מספיק כדי לקבוע שמדובר בהשקה חלקית ולבקש מהמשתמש אישור לפני ביצוע כל ניקוי. הדבר יכול לגרום למשתמש להשלים את ההשקה או את החזרה לאחור לפני השימוש בכלי לביצוע הניקוי, או להנחות את המשתמש לדלג על הניקוי בשלב זה.

היקף ומורכבות

לבסוף, אפילו DV בוליאני פשוט עשוי להשפיע על חמישה עד 20 קבצים, לאחר התחשבות בקבוע, בעטיפה, בכל אתר קריאה, ובעדכון או מחיקה של בדיקות רלוונטיות. זו משימה שדורשת הבנה של הקוד, ולא רק התאמה לתחביר. זו בדיוק הסיבה שבחרנו להשתמש בסוכני LLM. אך המשימה לא הייתה פשוטה כמו כתיבת פקודה וביקוש מהסוכן לבצע את הניקוי; גישה כזו לא הייתה מאפשרת ניקוי יעיל מבחינת עלות וזמן, עם מנגנוני הגנה בקנה מידה גדול.

תהליך דו-שלבי הכולל מעורבות אנושית

המערכת מבוססת על ערכת הפיתוח לסוכנים (ADK) של גוגל ופועלת בשני שלבים, עם נקודת בקרה אנושית אחת ביניהם, כפי שמוצג באיור 1.

איור 1: ארכיטקטורת המערכת. סוכן תזמור מבצע את הניתוח של שלב 1, שולף DVs מיושנים מ-Jira, שואל את פלטפורמת הניסויים לגבי מצב הפריסה באמצעות פרוטוקול הקשר המודל (MCP), ומחפש בבסיס הקוד; מהנדס מאמת את הדוח. לאחר מכן, שלב 2 מפעיל סוכני ניקוי מקבילים בעצי עבודה מבודדים של Git, אשר עורכים, בודקים, מאמתים את הכיסוי ומבצעים בדיקת לינט לפני פתיחת בקשת משיכה (PR).

שלב 1: ניתוח ודוח

סוכן מתאם, ובמקרה זה קלוד סונט, מעבד בקשות ל-DV מיושן. עבור כל DV, הוא:

  1. מביא את כרטיסי ה-DV Jira שהתיישנו באמצעות כלי ממשק שורת הפקודה של Atlassian.
  2. מבקש מפלטפורמת הניסויים של DoorDash, באמצעות פרוטוקול הקשר המודל (MCP), את המטא-נתונים של ה-DV — ה-UUID שלו, אחוז הפריסה וערך היעד.
  3. מאתר את המאגר המקומי ומחפש כל אזכור בקוד של ה-DV.
  4. מייצר דוח מובנה המציע ערך יעד ומפרט את הקבצים המושפעים עבור כל DV.

שילוב ה-MCP הזה הוא הגיבור השקט של העיצוב. באמצעות קריאת מצב הפריסה בפועל בסביבת הייצור, הסוכן קובע את הערך היעד הנכון במקום לנחש על סמך הקוד. לדוגמה, DV שהוכנס עבור תכונה שבסופו של דבר נזנחה מציג פריסה של 0% בפלטפורמה, ולכן הסוכן יודע להסיר אותו באמצעות ערך הבסיס במקום להניח שהתכונה פעילה.

נקודת ביקורת אנושית

לפני כל שינוי בקוד, מהנדס בודק את הדוח ומאשר את הערך היעד של כל DV. זהו מנגנון בטיחות מכוון למקרים מעורפלים, כגון פריסות חלקיות או ניסויים שננטשו, שבהם התשובה הנכונה מצריכה שיקול דעת אנושי. לדוגמה, ייתכן שניסוי הוטמע ב-60% ואז ננטש. נקודת הבדיקה האנושית מאפשרת למשתמש להתערב ולהחליט, למשל, האם להשלים את הפריסה או לבטל את הניסוי לפני שתהליך הניקוי ימשיך.

שלב 2: ניקוי מקביל

עבור כל DV שאושר, ה-Orchestrator מפעיל סוכן הסרה ייעודי — Claude Opus — כאשר כל אחד מהם פועל בסביבת עבודה git מבודדת משלו. עד ארבעה סוכנים פועלים במקביל לכל מאגר, והדבר ניתן להגדרה. כל אחד מהם מבצע ניקוי מלא ופותח בקשת משיכה (pull request) המוקצית לבעל ה-DV.

בתוך חומר להסרת כתמים

כל סוכן הסרה מבצע תהליך עבודה איטרטיבי כדלקמן:

  1. חפש את כל ההפניות ל-DV, כולל הקבוע, פונקציית העטיפה וכל אתר קריאה.
  2. קבעו אסטרטגיית ניקוי בהתאם לסוג ה-DV — בוליאני, מספר שלם או מחרוזת — ולשימושו.
  3. החל את השינויים; החלף את קריאות ה-wrapper בערך היעד ופשט את התנאים שהפכו כעת לקבועים.
  4. הסר את פונקציית העטיפה, את ההגדרה ואת הקבוע.
  5. יש לעדכן או להסיר את הבדיקות המושפעות, כגון מחיקת ענפי בדיקה המסומנים כ"מושבתים".
  6. ודא שהבנייה עברה בהצלחה.
  7. יש לוודא שהבדיקות עברו בהצלחה.
  8. יש לוודא כי שיעור הכיסוי של התיקונים הוא 95% לפחות בשורות ששונו.
  9. הפעל את כלי הבדיקה Detekt.
  10. אם אימות כלשהו נכשל, יש לאתר את התקלה, לתקן אותה ולנסות שוב.

אוטונומיה על בסיס קוד פועלת רק אם מערכי ההגנה הם אמיתיים. ארבעה מנגנונים שומרים על בטיחות הסוכנים:

  • בידוד עץ העבודה ב-Git: כל סוכן פועל בתוך עץ עבודה ייעודי, כך שסוכנים הפועלים במקביל לעולם אינם מפריעים זה לזה, וניקוי שנכשל נמחק בפשטות על ידי הסרת עץ העבודה.
  • פסק זמן קשיח של שעה לכל סוכן: כך מובטח שמפגש שנתקע לא יוכל להימשך ללא הגבלה.
  • אימות כיסוי התיקונים של JaCoCo: תכונה זו אוכפת כיסוי בדיקות של לפחות 95% על השורות שהסוכן שינה.
  • ניתוח סטטי של Detekt: כלי זה אוכף את כללי הסגנון ומאתר בעיות נפוצות.

כמו כן, אנו מריצים את Gradle עם האופציה –no-daemon כדי למנוע זיהום מצב בין עצי עבודה במהלך ריצות מקבילות. חשוב לציין כי אסור לסוכן לפתוח בקשת משיכה (PR) עד שהבדיקות והניתוח הסטטי יעברו בהצלחה באופן מקומי.

תוצאות

בניית מערכת היא דבר אחד, אך כאשר היא פועלת בקנה מידה של DoorDash, רק שאלה אחת חשובה: עד כמה היא פועלת היטב? במקרה זה, אכן היטב מאוד.  מתוך 50 הדגלים ה"מיושנים" האחרונים שהמערכת עיבדה, היא יצרה PR מוכן למיזוג עבור 45 מהם, בעלות ממוצעת של 4.79 דולר ו-13.8 דקות לכל ניקוי, במקום שעה עד שעתיים שהיו נדרשות לניקוי ידני. המערכת לא גרמה לשום באגים או רגרסיות בתהליך.

כיצד הערכנו את המוצר

בדקנו את המערכת על 50 ה-DV-ים ה"מיושנים" האחרונים שהיא עיבדה במספר מאגרי Kotlin. סיווגנו כל אחד מהם לפי רמת המורכבות: 

  • פשוט — בדיקה בוליאנית אחת בקובץ אחד או שניים; n=6
  • בינוני — שימושים מרובים בשלושה עד חמישה קבצים, עם כמה שינויים לצורך בדיקה; n=18
  • מורכב — תנאים מקוננים, תלות בין קבצים, סוגי נתונים שאינם בוליאניים או עדכונים משמעותיים בבדיקות; n=26 

לפי סוג, 41 היו מסוג בוליאני, 6 היו מסוג מחרוזת ו-3 היו מסוג מספר שלם/ארוך. כל בקשת משיכה (PR) נבחנה על פי שלושה קריטריונים: עמידה ב-CI — כולל רף כיסוי התיקונים של 95% — נכונות הקוד, ובדיקת מפתחים. 

תוצאות לפי רמת המורכבות

איור 2: תוצאות הניקוי לפי רמת המורכבות. משתנים תלויים פשוטים מתקבלים ב-100% בניסיון הראשון; משתנים תלויים בינוניים מגיעים לשיעור ניקוי של 94%; משתנים תלויים מורכבים מצריכים יותר תיקונים וכישלונות, אך עדיין מגיעים לשיעור של 85%.

כפי שמוצג באיור 2, 31 מתוך 50 תהליכי הניקוי אוחדו בניסיון הראשון, 14 הצריכו תיקון קל אחד, וחמישה הצריכו התערבות של מהנדס. פירוט המורכבות מתאר את גבול האמינות של המערכת:

  • קובצי DV פשוטים: 100% נוקו במעבר אחד.
  • ערכי DV בינוניים: 94% (17/18) – 14 הושלמו בניסיון אחד, שלושה לאחר תיקון אחד, ואחד שהצריך התערבות של מהנדס.
  • DV-ים מורכבים: 85% (22/26), אפילו עם הסרת פרמטרים בשרשרת דרך יותר מחמש שכבות שיטות, תנאים מקוננים ושינויים נרחבים בקוד הבדיקה.

14 התיקונים היו מינוריים וניתנים לתיקון עצמי; בששה מקרים כיסוי התיקון לא היה מספיק, ונדרשה איטרציה נוספת כדי להוסיף בדיקות, ובשמונה מקרים הסרת הקוד המת הייתה חלקית, עם משתנה או הפניה שנותרו בעומק שרשרת הקריאות. עם זאת, כולם תוקנו בהנחיה חוזרת אחת של ה-LLM.

הממצא החשוב ביותר נגע לסוג התקלה שהתרחשה. בכל 50 בקשות ה-PR שנוצרו, לא הבחנו בשום באגים או רגרסיות שנגרמו על ידי הקוד ששונה. כל אחד מחמשת המקרים שבהם נדרשה התערבות נבע מעומק שרשרת הקריאות עם העברת פרמטרים בין ממשקים; הסוכן הסיר כראוי את רוב הקוד המת, אך החמיץ קישור או שניים בשרשרת ארוכה המורכבת ממספר קבצים. במילים אחרות, גבול האמינות של המערכת הוא השלמות, ולא הנכונות, מה שמפחית את החשש שהמערכת עלולה ליצור בעיות חמורות יותר כאשר היא נכשלת.

עלות וזמן

העלות והזמן משתנים בהתאם לרמת המורכבות, אך נשארים בהחלט בתחום של "הפעלה בקנה מידה גדול", כפי שמוצג בטבלה 1 ובאיור 3. 

טבלה 1 מפרטת את מדדי הביצועים הממוצעים והחציוניים, ובפרט את הזמן והעלות, עבור 50 דגלי התכונות שנבדקו, המסווגים לפי רמת המורכבות שלהם. נתונים אלה מדגישים כי אף על פי שדגלים מורכבים יותר דורשים, מטבע הדברים, יותר זמן ותקציב, המערכת נותרת יעילה ביותר גם במשימות הניקוי הקשות ביותר.

מורכבותnזמן ממוצעזמן חציוניעלות ממוצעתעלות חציונית
פשוט67.5 דקות8.2 דקות$2.69$2.50
בינוני1810.4 דקות9.9 דקות$3.46$3.42
מורכב2617.7 דקות14.4 דקות$6.20$4.50

טבלה 1: מדדי ביצועים לפי רמת מורכבות ב-50 דגלי תכונות שנבדקו.

איור 3: עלות ה-API לעומת זמן השעון עבור כל DV, מסודרים לפי צבע בהתאם לרמת המורכבות. ה-DV-ים הפשוטים והבינוניים מתרכזים באזור בעל העלות הנמוכה והזמן הקצר. ה-DV-ים המורכבים פזורים, עם כמה ערכים חריגים המתקרבים ל-40 דקות ו-19 דולר. ה-DV-ים שנכשלו (×) נוטים לזמני ריצה ארוכים יותר.

כפי שמוצג באיור 3, ערכי DV פשוטים ובינוניים מתרכזים בצפיפות בפינה של "זול ומהיר". ערכי DV מורכבים מתפזרים, כאשר מספר קטן של ערכים חריגים מגיע לכ-40 דקות ולכ-19 דולר. אפילו בקצה העליון של טווח זה, הסוכן מייצג הפחתה דרמטית במאמץ ההנדסי ובעלויות, אפילו בהשוואה לאומדן שמרני של שעה אחת הנדרשת להסרת ערך DV בודד באופן ידני.

מה שלמדנו

  • התמחות במודלים לפי תפקיד משתלמת. אנו משתמשים ב-Claude Sonnet לצורך תזמור, כולל הקשר רחב, איסוף ותכנון מטא-נתונים קלים, וב-Claude Opus עבור סוכני ההסרה, כולל חשיבה מעמיקה על סמנטיקה של קוד, שרשראות קריאות ותלותי בדיקה. השמירת המודל היקר יותר לשלב העריכה, התובעני מבחינה קוגניטיבית, הובילה להפחתת העלות הכוללת של ה-API מבלי לפגוע באיכות הניקוי.
  • בידוד עץ העבודה הוא תנאי הכרחי עבור סוכנים הפועלים במקביל. הניסויים המוקדמים שלנו, שבהם לא נעשה שימוש בבידוד עץ העבודה, הובילו למצבי תחרות שבהם סוכנים הפועלים במקביל ערכו את אותם קבצים ויצרו דפים של הבדלים פגומים. עץ עבודה ייעודי לכל סוכן, בשילוב עם Gradle במצב –no-daemon, הפך את הניקוי המקביל לבטוח ואיפשר התמודדות קלה עם כשלים.
  • שילוב הניסויים בזמן אמת היה ההחלטה שהניבה את התועלת הגדולה ביותר. ללא מצב הפריסה הנוכחי, כל גישה אוטומטית — בין אם מבוססת כללים ובין אם מבוססת LLM — עלולה להוביל לקידוד קשיח של ערך שגוי ולשימור סמוי של ההתנהגות השגויה. קריאת הנתונים באמצעות MCP הוסיפה חביון זניח וחיסלה סוג שלם של שגיאות בערכי היעד.

כל צוות השוקל יישום אוטומציה דומה צריך לשים לב שתוצאותינו מצביעות על שלושה תנאים מוקדמים מעשיים: 

  • מקור אמין של מדינת הדגל שבה הוצב הספינה
  • בידוד עץ העבודה לצורך עריכות מקבילות, ו- 
  • תהליכי אימות דטרמיניסטיים מתבצעים עוד לפני פתיחת בקשת משיכה (PR).

מה הלאה

אנו מרחיבים את המערכת בשני מישורים:

  1. ציון אמינות של שלב 1 לאישור אוטומטי של ניקויים בעלי סיכון נמוך. לדוגמה, משתנה תלוי בוליאני (DV) שנמצא ב-100% פריסה, שקוד ברירת המחדל שלו כבר תואם לסביבת הייצור, מה שמאפשר לשמור את נקודת הבדיקה האנושית למקרים מעורפלים באמת.
  2. בדיקה של איכות הקוד לאחר הניקוי. בדיקה זו תאתר בעיות סמנטיות, כגון שמות משתנים שאינם משקפים עוד את ייעודם לאחר הסרת דגל מסוים.

ניקוי דגלי תכונות הוא סוג של עבודה שכל משימה בנפרד היא קטנה, אך במצטבר היא עצומה, במיוחד בקנה המידה של DoorDash, והיא נדחית ללא הרף. באמצעות שילוב של מתאם, סוכני הסרה מקבילים בעצי עבודה מבודדים, חיפושים בפלטפורמת ניסויים בזמן אמת ושערי אימות קפדניים, מערכת ניקוי דגלי התכונות שלנו הופכת צבר עבודה של אלפי שעות לתהליך רקע זול ואמין, המייצר בקשות למשיכה (PR) מוכנות למיזוג עבור 90% מהדגלים שהיא מטפלת בהם, בעלות של כ-4.79 דולר ו-14 דקות לכל אחד, ללא רגרסיות. האתגר שנותר הוא השלמת שרשראות הקריאות העמוקות ביותר, וזה בדיוק המקום שבו נתמקד בשלב הבא.

מעוניינים לבנות מערכות מסוג זה? מחלקת ההנדסה של DoorDash מחפשת עובדים – בואו לעזור לנו לבנות בקנה מידה גדול.

Flux היא פלטפורמת הסוכנים מבוססת הענן של DoorDash המיועדת למהנדסים. בחודש אחד בשנת 2026, השתמשנו ב-Flux כדי לבצע אוטומציה של 130,000 משימות הנדסיות. Flux, שהתרחבה במהירות לאחר השקתה ברבעון הראשון של 2026, כבר מפעילה תהליכי עבודה ברקע בהיקפים גדולים ברחבי DoorDash, כולל יותר מ-25,000 ביקורות קוד אוטומטיות בכל שבוע, וכן יותר מ-300 מדריכים ייחודיים ויותר מ-10,000 קריאות המשמשות מדי שבוע. תהליכי עבודה אלה יכולים לפעול ללא השגחה, במקביל, מסביב לשעון.

בפוסט זה בבלוג, נסקור את המגבלות שדחפו אותנו מעבר לעומסי עבודה מקומיים של סוכנים המבוססים על מחשבים ניידים, את הסיבות שבגללן בחרנו לפתח את Flux באופן פנימי במקום להסתמך אך ורק על סוכני קידוד מאוחסנים, וכן את מרכיבי היסוד של הפלטפורמה – כגון סביבות בדיקה לסוכנים, שער MCP, מדריכי פעולה ומשטחי הפעלה – שנועדו להפוך את האצלת הסוכנים לתהליך חוזר ובטוח.

דוגמאות לשימוש בתהליך העבודה של Flux Background

טבלה 1: תמונת מצב של השימוש ב-Flux ברחבי DoorDash במהלך חודש אחד, הכוללת ביקורות קוד אוטומטיות, הרצות של מדריכי פעולה והשלמת משימות ברקע

מאיפה התחלנו

במהלך השנה האחרונה, משתמשים שהריצו עומסי עבודה מבוססי סוכנים במחשבים הניידים שלהם נתקלו במהרה במגבלות:

  • משאבים וזמינות. למחשב נייד יש מספר קבוע של ליבות מעבד, זיכרון מוגבל וסוללה, שכולם משותפים לכל היישומים המותקנים עליו. לעתים קרובות, תהליכי העבודה של Agentic נדרשים להריץ במקביל משימות עתירות חישוב, כגון בניית גרסאות, בדיקות וחיפושים נרחבים, מה שגורם למחשבים הניידים להגיע במהירות לקצה יכולת העיבוד שלהם. תהליכי העבודה תלויים גם בכך שהמכשיר יהיה מופעל, מחובר וזמין; העבודה נעצרת כאשר מהנדס סוגר את המחשב הנייד, מאבד את החיבור או מתרחק מהמקום.
  • בקרות אבטחה. למחשבים ניידים יש בדרך כלל גישה נרחבת לפרטי זיהוי ולמערכות רגישות, כולל מפתחות SSH, הפעלות VPN וכלים הדורשים אימות. מתן אותה רמת גישה לסוכן אוטונומי יוצר סיכון מיותר וטווח פגיעה פוטנציאלי נרחב. סביבות מקומיות מקשות גם על הגדרת גבולות מדויקים לגבי מה שהסוכן יכול לגשת אליו ולמשך כמה זמן.
  • נראות ויכולת ביקורת. כאשר עומסי עבודה פועלים על מחשבים ניידים בודדים, הביצוע מפוצל וקשה לניטור. כך מתקשה להבין מה פועל, היכן הוא פועל, מטעם מי, ואילו מערכות או קבצים הוא השפיע עליהם.

הגישה שלנו לטיפול בסוגיות אלה היא פשוטה: 

להאציל משימות לסוכני תכנות אוטונומיים ובטוחים, כדי שהמהנדסים יוכלו להקדיש יותר אנרגיה לחדשנות, לחשיבה ביקורתית ולפתרון בעיות מורכבות.

מדוע פיתחנו את Flux באופן פנימי

סוכני קידוד מאוחסנים הם שימושיים, אך הם מאלצים לבצע פשרה קשה: או לשלוח קוד רגיש והקשר ביצוע לצד שלישי, או לפתוח נתיב מאותו צד שלישי חזרה אל המערכות הפנימיות. עבור DoorDash, הבעיה הקשה יותר לא הייתה רק לגרום לסוכן לכתוב קוד; בעיה זו נפתרה ברובה. הבעיה הייתה לספק לאותו סוכן את הסביבה, הכלים, ההרשאות, האינטגרציות והמגבלות הנכונים.

האסטרטגיה שלנו היא לשלוט במרכיבים הבסיסיים הסובבים את הסוכן, לרבות תזמור, סביבות בדיקה, זרימות עבודה, הרשאות, אינטגרציות, וכן סוכני ההקשר הספציפיים ל-DoorDash הנדרשים לעבודה יעילה. כמו כן, עיצבנו את המרכיבים הבסיסיים הללו כך שיהיו מודולריים, מה שמקנה לנו את הגמישות להשתמש בכלי הטוב ביותר של צד שלישי עבור כל משימה, או לפתח פתרון פנימי כאשר יש חשיבות רבה יותר לאבטחה, לאינטגרציה, לביצועים או לאחריות על חוויית המשתמש. 

אלמנטים בסיסיים אלה הופכים את יצירת זרימות העבודה לנגישה לכולם ומאפשרים למערכות להתאים את עצמן טוב יותר למקרי שימוש עתידיים. מכיוון שניתן לשלב אותם בדרכים שונות, צוותים יכולים לבנות זרימות עבודה חדשות לסוכנים מבלי לשנות את התשתית הבסיסית או לקבוע מראש כיצד כל מהנדס צריך לבנות את זרימת העבודה שלו. לדוגמה, אנו מריצים את כל הבדיקות (evals) של סקירת הקוד שלנו על תשתית Flux.

אלמנטים בסיסיים, לא תהליכי עבודה

כפי שמוצג באיור 1, Flux בנוי סביב ארבעה מרכיבים בסיסיים של הפלטפורמה: סביבות בדיקה (sandboxes), שער פרוטוקול הקשר המודל (MCP), מדריכי פעולה (playbooks) ומשטחי הפעלה (invocation surfaces). יחד, הם מאפשרים לבצע האצלת משימות לסוכנים באופן חוזר. מדריך הפעולה מגדיר את העבודה. סביבת בדיקה בענן מספקת לסוכן סביבה אמיתית לביצועה. שער הסוכן שולט באילו מערכות הסוכן יכול לגשת. ומשטחי ההפעלה מאפשרים למהנדסים להתחיל ולקבל משימות מהמקומות שבהם הם כבר משתמשים.

איור 1: ארבעת המרכיבים הבסיסיים של הפלטפורמה המרכיבים את Flux — סביבות בדיקה, שער ה-MCP, מדריכי פעולה ומשטחי הפעלה — והאופן שבו הם מתחברים כדי להפוך משימה לעבודה שסוכן יכול לבצע בבטחה

סביבות בדיקה מספקות את סביבת ההרצה

סוכנים מקומיים מתאימים היטב לפיתוח אינטראקטיבי, אך אינם מתאימים לתהליכי עבודה בלתי מפוקחים. הם תלויים במחשבים הניידים של מהנדסים בודדים, מתחרים על משאבים מקומיים, קשים לביקורת ואינם ניתנים להרחבה יעילה בין משימות מקבילות.

Flux מעבירה את הביצוע לסביבות בדיקה מבודדות בענן, הנתמכות על ידי מיקרו-מכונות וירטואליות (microVMs) של Firecracker, לצורך בידוד ברמת החומרה. כל סביבת בדיקה מצוידת במאגרי הקוד, בכלי הפיתוח, בסודות ובתלות הריצה הנדרשים למשימה, מה שמספק לסוכנים סביבת עבודה הנדסית מלאה, תוך מתן מודל עקבי של ביצוע, אבטחה וניטור ל-DoorDash.

השליטה בשכבה זו מאפשרת לנו לתמוך בתהליכי עבודה הנדסיים אמיתיים, כולל ביצוע שינויים במספר מאגרים ובמספר בקשות משיכה (pull requests) מתוך הפעלה אחת. ל-Flux יש יעד רמת שירות (SLA) של פחות מחמש שניות באחוזון ה-95 עבור ההתקנה המלאה מקצה לקצה — החל מהפעלת ה-microVM ועד לשכפול המאגרים הנדרשים, התקנת כלי הבנייה והגדרת מערכי הסוכנים הנתמכים לכתיבת קוד.

שער ה-MCP מספק גישה מבוקרת

לסוכנים נדרשת גישה למערכות שהמהנדסים משתמשים בהן מדי יום, לרבות אינטגרציה רציפה (CI), פלטפורמות ניטור, מערכות מעקב אחר תקלות, כלי פריסה, חיפוש קוד, תיעוד ומטא-נתונים של שירותים. עם זאת, מתן גישה רחבה ובלתי מוגבלת לא צריך להיות ברירת המחדל.

Flux מחבר את הסוכנים למערכות הפנימיות באמצעות שער MCP פנימי המכונה Agent Gateway. כל תסריט פעולה מציין את הכלים הנדרשים לו, ו-Flux מעניק רק את ההרשאות המוגבלות הנחוצות לביצוע משימה זו. כל פעולה נרשמת, וכך נוצר תיעוד ביקורת ברור.

ארכיטקטורת השער הזו מספקת לנו נקודת בקרה מרכזית לאימות, הרשאה, יכולת ניטור, מעקב אחר השימוש ואכיפת מדיניות — כל אלה הופכים את הגישה באמצעות הסוכנים לבטוחה יותר וקלה יותר לתפעול בקנה מידה גדול.

המדריכים מגדירים את העבודה

"פלייבוק" הוא יחידת עבודה סוכנתית הניתנת לשימוש חוזר — המקבילה למכולת Docker עבור מיומנויות ומשימות המונחות על ידי סוכנים בפלטפורמת Flux. הוא מוגדר בקובץ YAML יחיד, ומאגד בתוכו את המשימה, הקלטים, ההקשר, המיומנויות, הכלים, ההרשאות, האימות, התפוקות הצפויות וגבולות הבטיחות הנדרשים לביצוע העבודה באופן עקבי.

תסריטי פעולה יכולים לשלב בין שלבים סוכניים, המספקים גמישות ושיקול דעת, לבין שלבים דטרמיניסטיים, המציעים צפיות, עלות נמוכה יותר ואימות קל יותר. הדבר מאפשר לצוותים להעביר לוגיקה בין ביצוע מונחה-סוכן לקוד קונבנציונלי ככל שהדרישות מתפתחות, מבלי לעצב מחדש את זרימת העבודה.

משטחי Invocation מתאימים את עצמם לצרכים של המפתחים

ניתן להפעיל את אותו תסריט עבודה מ-Slack, GitHub, cron, ממשק השורה (CLI) או מיומנות שיחתית. משמעות הדבר היא שצוותים יכולים להגדיר זרימת עבודה פעם אחת ולהפעיל אותה מהממשק המתאים ביותר לאותו הרגע:

  • Slack לצורך חלוקת משימות בשיתוף פעולה
  • GitHub לאוטומציה של בקשות למשיכה (PR) ו-CI
  • Cron לצורך תחזוקה שוטפת
  • CLI לשליטה ישירה של המפתח, או הפעלה באמצעות סקיל

זה מה שהופך את Flux לקל לאימוץ.

לקחים שנלמדו

הקמת Flux לימדה אותנו לא פחות על אימוץ המוצר מאשר על התשתית, ובכלל זה:

  • התחילו בקנה מידה מצומצם כדי לזכות באמון. התחלנו בבדיקת קוד אוטומטית, במקום לנסות להפוך את כל מחזור החיים של פיתוח התוכנה לאוטומטי. בדיקת הקוד הייתה תכופה, ניתנת למדידה וקלה להערכה על ידי המהנדסים. היא סיפקה לנו תהליך עבודה בסביבת הייצור, שבו יכולנו לכוונן את האיכות, זמן התגובה, העלות והתנהגות המערכת, לפני שהתרחבנו לתחומים כמו מיון CI, משימות תורנות, מדריכי תחזוקה ופיתוח מונחה כרטיסים.
  • הפכו את העבודה לגלויה. האינטגרציה הראשונה שלנו עם Slack יצרה ערוצים פרטיים לכל ריצה של סוכן. זה הפך את Flux לשימושי עבור יחידים, אך לא יצר הרגלי עבודה צוותיים. העברת העבודה לשרשורים ציבוריים שינתה את דפוס האימוץ. מהנדסים יכלו לראות מה אחרים האצילו, לעקוב אחר ההתקדמות ב-Flux, לבחון את התוצאות ולבנות אמון יחד.
  • מדריכי פעולה זקוקים לתמיכה. תהליכי עבודה הניתנים לשימוש חוזר אינם נוצרים מעצמם רק בשל קיומה של הפלטפורמה. סדנאות והאקתונים סייעו לצוותים לתרגם משימות תפעוליות חוזרות ונשנות למדריכי פעולה. הרכיבים הבסיסיים אפשרו את האוטומציה; התמיכה סייעה לצוותים לזהות אילו תהליכי עבודה כדאי לתעד.

מה הלאה

בפוסטים הבאים נעמיק בנושא הרכיבים הבסיסיים של הפלטפורמה שמאפשרים את פעולת Flux, וכן בחוויית המפתחים בבניית זרימות עבודה חדשות. כמו כן, נדון ביישומים שבנינו על בסיס הפלטפורמה, כולל Flux Responder, הסוכן הפנימי שלנו ב-Slack.

תודות

תודה לאדם רוגל, אדם יארגר, אנדי פאנג, אשווין קצ'רה, פאן שיאה, איוון רודובול, ג'ייסון פרסד, ג'יאלו דנג, ג'סטין בלוק, ג'סטין דוקמפו, ג'סטין פאן, קית' ליאל, פרניט סינג, שון צ'ן, טיילר ברט ווולנדה ג'ו על תרומתם לפלטפורמה ולפוסט זה.

הישארו מעודכנים עם עדכונים שבועיים

הירשמו לבלוג ההנדסה שלנו כדי לקבל עדכונים שוטפים על כל הפרויקטים הכי מגניבים שהצוות שלנו עובד עליהם
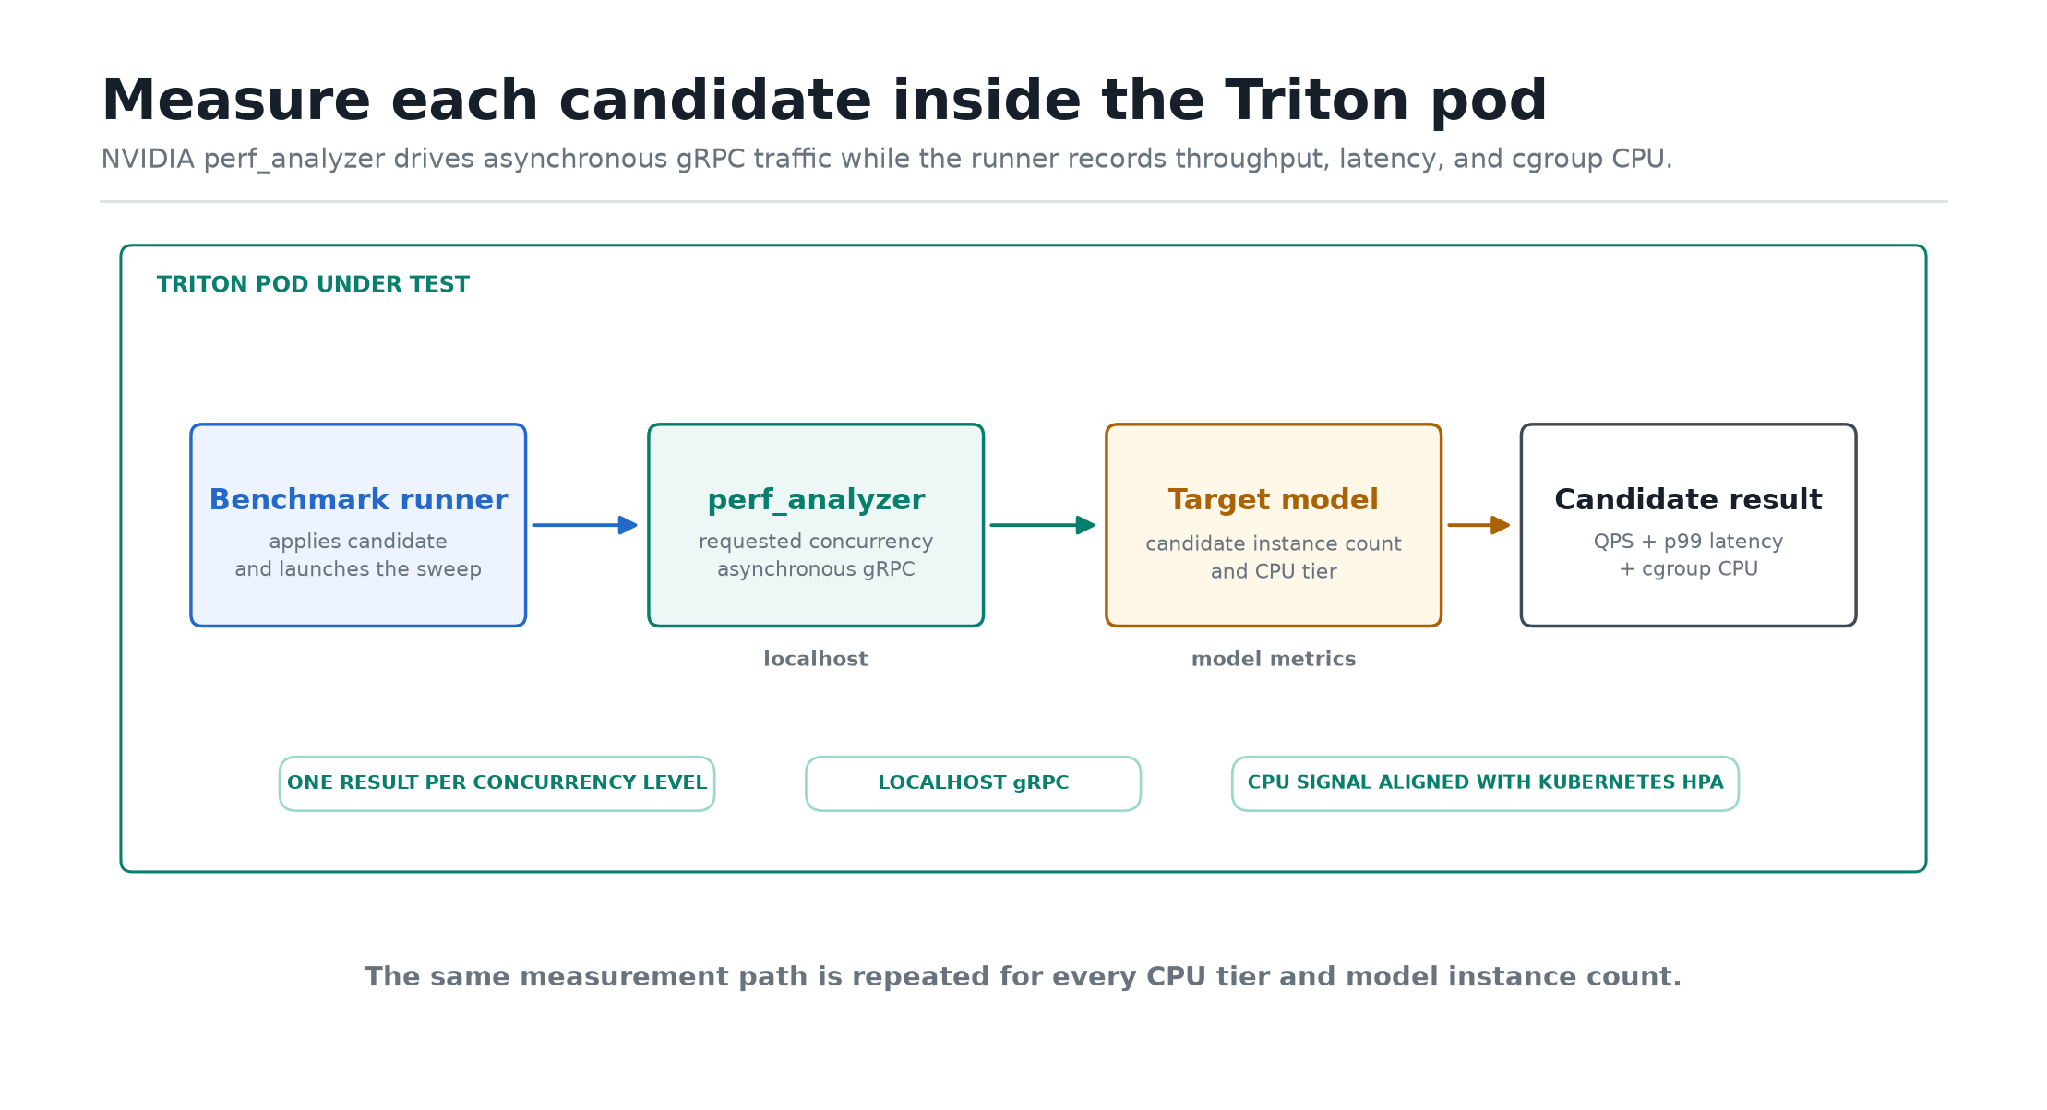
סוכני בינה מלאכותית הופכים לשימושיים כאשר הם יכולים לפעול במערכות אמיתיות. ב-DoorDash, משמעות הדבר היא גישה ל-API פנימיים, למערכות הנדסיות, לפלטפורמות ניטור, למערכות ניהול תקלות, למאגרי ידע ולמוצרי SaaS של צד שלישי. פרוטוקול הקשר המודל (MCP) הקל על חשיפת הכלים הללו בכך שהעניק לסוכנים ולשרתים דרך משותפת לתאר, לאתר ולהפעיל יכולות.

כשהסוכנים עברו מניסויים לתהליכי עבודה אמיתיים, נתקלנו בבעיה אחרת. אמנם ה-MCP קבע תקן לצורת קריאת הכלי, אך הוא לא סיפק מענה לשאלות מרכזיות הקשורות לייצור סביב אותה קריאה:

  • איזה סוכן רשאי להשתמש בכלי זה?
  • בשם איזה משתמש, צוות או שירות הוא פועל?
  • באיזה אישור יש להשתמש?
  • איזו תת-קבוצה של כלים צריך הסוכן לראות בכלל?
  • כיצד ניתן לבטל את הגישה?
  • איך אנחנו יודעים מה קרה אחרי השיחה?

השאלות הללו הולכות ומתרבות במהירות. סוכן תכנות עשוי להזדקק ל-GitHub, Jira, חיפוש קוד, אינטגרציה רציפה (CI), יכולת ניטור ותיעוד. שרת MCP של צד שלישי עשוי לחשוף מאות כלים, בעוד שתהליך העבודה זקוק לחמישה בלבד. סוכן הפונה למשתמשים עשוי להזדקק לאישור OAuth של המשתמש, בעוד שאוטומציה צוותית צריכה להשתמש בגוף שירות לא אישי. אם כל צוות פותר את הבעיות הללו באופן עצמאי, כל צמד של סוכן-כלי מסתיים עם קוד אימות, זרימת OAuth, טיפול בסודות, קטלוג כלים, מגבלות קצב ויומנים משלו.

לכן הקמנו את "Agent Gateway" כדי להפוך את הגישה לכלי הסוכנים ליכולת מובנית בפלטפורמה. זוהי נקודת כניסה יחידה ומפוקחת, שבה הסוכנים מאתרים ומפעילים כלים. השער מאמת את זהות המתקשר, בודק את ההרשאות, חושף רק את ממשק הכלים המאושר, מזין את פרטי ההזדהות הנכונים, מנתב את השיחה לשרת ה-MCP במורד הזרם, ומקליט אירוע שימוש מובנה עבור כל שיחה.

השער אינו רק פרוקסי. הוא מהווה את מישור הבקרה של מערכת הסוכנים. הוא קובע מי רשאי להפעיל כלים, בוחר אילו כלים יוכלו הסוכנים לראות, מאגד את הכלים לממשקים המותאמים למשימות, ומספק ל-DoorDash נקודת גישה אחת לניטור, להגבלת קצב השימוש, לביטול ולשיפור הגישה של הסוכנים לכלים.

הבעיה: הגישה לכלי מורכבת משלושה חלקים

בעוד ש-MCP מסייע לסוכנים להפעיל כלים, הבעיה המורכבת יותר בסביבת הייצור כוללת שלושה ממדים:

  1. הנושא הראשון הוא הגישה. הפלטפורמה צריכה לדעת מי מתקשר, האם הוא מורשה לכך, ואיזה מודל אימות חל: זהות פנימית, אסימון המוחזק בשער, OAuth לכל משתמש, או גישה באמצעות ישות שירות.
  2. השני הוא ניהול משטח הכלים. הסוכנים לא צריכים לקבל קובץ גולמי המכיל את כל הכלים שנחשפים על ידי שרתי MCP במורד הזרם. קטלוגים קטנים יותר, הרלוונטיים למשימה, משפרים את הבטיחות, מפחיתים את הבלבול במודל ומקלים על תפעול הסוכנים.
  3. הנושא השלישי הוא התפעול. קריאות לכלים דורשות הגבלות קצב, מעקב, מדדים, אירועי שימוש, ייחוס עלויות, מטא-נתונים על בעלות ושקיפות בסביבת הייצור.

שער הסוכנים שלנו קיים משום שהגישה, הארגון והתפעול צריכים להתבצע במסגרת פלטפורמה משותפת אחת, ולא להיות משוכפלים בכל סוכן ובכל שרת MCP.

ארכיטקטורת שער

לשער יש שני מרכיבים מרכזיים: פרוקסי ומרשם, כפי שמוצג באיור 1 להלן. הפרוקסי הוא מישור הנתונים; הוא מקבל כל בקשת MCP, מאמת את זהות המתקשר, מאשר את הפעולה, מפעיל מגבלות קצב, מזין אישורים, מעביר את הבקשה ומשדר נתוני ניטור. הרישום הוא מקור האמת של מישור הבקרה; הוא מאחסן סוכנים, שרתים MCP, בעלים, תצורות העברה, מצבי אימות, מדיניות, קטלוגים של כלים שזוהו ותצורות ממשק הכלים.

איור 1: ארכיטקטורה כללית של שער הסוכנים

חלוקה זו מעניקה לשער מספר תכונות שקשה להשיג באמצעות אינטגרציות מסוג "נקודה לנקודה":

  • הסוכנים משתמשים בתבנית קצה MCP אחידה אחת, במקום ללמוד את מודל האימות והניתוב של כל שרת במורד הזרם.
  • בעלי הכלים רושמים את היכולות פעם אחת, מקשרים אליהן בעלות ומדיניות, ומציגים את השימוש בסביבת הייצור.
  • צוותי האבטחה מקבלים פלטפורמה אחת שבה הם יכולים לאכוף הרשאות גישה, לבטל הרשאות ולבצע ביקורת על שיחות.
  • צוותי הפלטפורמה יכולים לשפר את הנתיב המשותף פעם אחת, וכל הסוכנים יירשו את השיפור.

כמו כן, אנו מפרידים בין גבולות האמון הפנימיים והחיצוניים. תהליכי העבודה הפנימיים של DoorDash ומקרי השימוש הסוכניים הפונים כלפי חוץ פועלים דרך מישורי פרוקסי נפרדים, עם ספריות משותפות ומושגי רישום משותפים. הדבר מגביל את טווח הפגיעה הפונה לאינטרנט ומאפשר לכל מודל אימות להתפתח באופן עצמאי.

זהות, הרשאות וסודות מרכזיים

כל בקשה בשער מתורגמת למתקשר: משתמש, שירות או סוכן הפועל בהקשר של משתמש שהוסמך. זהות זו מלווה את התהליך לאורך כל שלבי ההרשאה, הזנת האישורים, הניתוב והנראות, כך שניתן לייחס כל פעולה במורד הזרם.

שער הגישה בודק את ההרשאה באופן מרכזי. שאלות המדיניות אינן מסתכמות בשאלה האם המתקשר יכול לגשת לשרת זה. הן עשויות לכלול גם:

  • האם הסוכן הזה יכול לגשת לשרת הזה?
  • האם המשתמש הזה יכול להפעיל את הכלי הזה באמצעות הסוכן הזה?
  • האם ניתן לחשוף את הכלי הזה בסביבה זו?
  • האם המתקשר הזה יכול להשתמש בגרסה התומכת בכתיבה, או רק בגרסה לקריאה בלבד?
  • האם תהליך עבודה זה יכול להשתמש בגוף שירות צוותי, או שהוא מחייב שימוש ב-OAuth לכל משתמש בנפרד?

מכיוון שהמדיניות מוגדרת בשער הגישה, ל-DoorDash יש מקום אחד שבו ניתן לשנות את הגישה ולבטל אותה. בעלי הכלים נמנעים מהצורך להגדיר מחדש את ההרשאות עבור כל שרת, ומפתחי הסוכנים נמנעים מהצורך לקודד החלטות אבטחה בהנחיות או בקוד היישום.

הטיפול בתעודות עוקב אחר אותו דפוס, כפי שמוצג בטבלה 1:

מצב אימותמי מחזיק בתעודהמה תפקידו של השער
זהות שירות פנימיתהתשתית של DoorDashמעביר את הקשר של המתקשר המאומת לשירותים פנימיים
אסימון המוחזק על ידי Gatewayאחסון סודי של שער הגישהמזריק אסימון ספק או שירות מבלי לחשוף אותו לסוכן
OAuth לכל משתמשמאגר הרשאות מוצפן לכל משתמשמזריק ומרענן את האסימון של המשתמש עבור פעולות בהיקף המשתמש
גורם שירות ראשימנהל הקבוצה מטעם גייטווייגופים מנפיקים או מתווכים של אישורים לא אישיים בעלי תוקף קצר

סוכנים אינם אמורים להחזיק באישורים גולמיים, כגון מפתחות API של ספקים, אסימוני רענון OAuth או הרשאות אנושיות שהושאלו לצורך אוטומציה של הצוות. השער שומר על גבולות אלה באופן מפורש וניתן לבדיקה.

OAuth לכל משתמש מבלי לשבש את תור הסוכנים

כלים של צד שלישי הפועלים בהיקף המשתמש דורשים אישור מהמשתמש. קריאת המסמכים של המשתמש, פתיחת כרטיס תמיכה בשמו או עדכון נתוני SaaS מטעמו אינם יכולים להתבצע בבטחה באמצעות מפתח משותף. לפני שהטמענו את השער, כל צוות נטה לבנות זרימת OAuth משלו, אחסון אסימונים וחווית "התחבר תחילה".

השער מרכז את תהליך ה-OAuth. יחידת הגישה מוגבלת לסוכן, למשתמש ולשרת. בשיחה הראשונה הדורשת אישור, השער מפעיל את תהליך ה-OAuth של הספק, מאחסן את אסימוני הגישה והרענון המוצפנים שהתקבלו, ומשלב את האסימון של המשתמש בשיחות עתידיות. הסוכנים לעולם אינם רואים את האסימון הגולמי.

במקרה של לקוחות התומכים בתהליך אימות MCP, השער יכול להשהות את קריאת הכלי, לבקש מהלקוח להציג הודעת חיבור, ולחדש את הקריאה המקורית לאחר שהמשתמש יאשר אותה. עבור לקוחות שאינם תומכים בתהליך אימות זה, השער מחזיר תגובה מובנית המציינת כי נדרשת אישור, הכוללת כתובת URL לחיבור, כפי שמוצג באיור 2. פעולה זו הופכת את החיבור, שהיה אמור להיחשב ככישלון, לחלק שניתן לשחזר במסגרת קריאת הכלי.

איור 2: לחיצת יד לצורך איסוף מידע

משטחי כלים מאורגנים: חבילות וסינון

סוכנים אינם חושבים באופן טבעי במונחים של שרתים מסוג MCP. הם חושבים במונחים של משימות. סוכן תכנות אינו מעוניין ב-GitHub, ב-Jira, ביכולת ניטור ובתיעוד כשלבים נפרדים בתהליך ההתקנה; הוא מעוניין בממשק הכלים הדרוש לו כדי לחקור בעיה, לשנות קוד, לפתוח בקשת משיכה (pull request), לבדוק את ה-CI ולהבין את התנהגות המערכת בסביבת הייצור.

במקביל, מרבית שרתי ה-MCP במורד הזרם חושפים הרבה יותר כלים מכפי שסוכן בודד אמור להשתמש בהם. שרתים של צד שלישי עשויים לפרסם מאות פעולות, לרבות פעולות ניהול, פעולות הרסניות, ממשקי API לחיוב ותכונות ייחודיות לספקים ספציפיים. מרבית תהליכי העבודה של DoorDash זקוקים רק לתת-קבוצה קטנה ומאושרת מתוכן.

השער פותר את שתי הבעיות באמצעות ממשקי כלים שנבחרו בקפידה, כפי שמוצג באיור 3. החבילות משלבות כלים ממספר שרתים של MCP לנקודת קצה לוגית אחת של MCP. המסננים קובעים אילו כלים מכל שרת ייחשפו עבור חבילה, סוכן, קבוצת משתמשים, סביבה או קהל יעד נתונים.

לדוגמה, חבילת כלי מפתחים עשויה לכלול:

  • כלים נבחרים של GitHub לתהליכי עבודה של מאגרים ובקשות משיכה;
  • כלי Jira נבחרים לחיפוש בעיות ולעדכונים;
  • כלי ניטור נבחרים עבור יומנים, מדדים ועקבות;
  • כלי חיפוש קוד ותיעוד נבחרים; וכן
  • כלי פריסה או כלי סימון תכונות נבחרים.

איור 3: חוויית המשתמש עם חבילת MCP המצורפת

הסוכן מתחבר לכתובת URL אחת של השער, כגון נקודת קצה של כלי מפתחים. מאחורי כתובת ה-URL הזו, השער מפזר את tools/list בין השרתים בחבילה, מיישם סינון הרשאות וכלים, מגדיר מרחבי שמות או כינויים לשמות הכלים לפי הצורך, ומחזיר קטלוג אחיד אחד. כאשר הסוכן קורא ל-tools/call, השער אוכף את המדיניות שוב, מנתב את הקריאה לשרת הנכון במורד הזרם, ומיישם את מודל האישורים של אותו שרת.

כך זוכים הסוכנים לממשק באיכות מוצר, במקום הצגה גולמית של יכולות במורד הזרם, והוא כולל מרכיבים כגון כלים מאושרים, שמות יציבים, תיאורים ברורים יותר, מטא-נתונים על בעלות וחבילות המותאמות לקהל יעד ספציפי. מחלקות ההנדסה, ניתוח הנתונים, תפעול התמיכה והחבילות החיצוניות יכולות כולן להשתמש באותם רכיבי בסיס של השער, תוך חשיפת ממשקי כלים שונים.

היתרונות הם מעשיים:

  • הגדרת הסוכן פשוטה יותר: נקודת קצה אחת של השער במקום נקודות קצה רבות של השרת.
  • גילוי הכלים בטוח יותר: הסוכנים רואים רק את הכלים הנמצאים בתוך הגבול המאושר.
  • התנהלות הדגם משתפרת: קטלוגים מצומצמים יותר מצמצמים את האפשרויות הלא רלוונטיות ואת הבלבול בנוגע לכלים.
  • ההרשאה נשארת מרוכזת: הן הגילוי והן ההפעלה אוכפים את אותה המדיניות.

זה המקום שבו השער הופך ליותר מסתם פרוקסי גישה. הוא קובע מה הסוכנים יכולים לאתר, לאילו משאבים הם יכולים לפנות, וכמה הקשר לא רלוונטי הם נושאים עמם. ממשק כלים שנבחר בקפידה יכול להיות ההבדל בין סוכן שבוחר את הכלי הנכון, לבין סוכן שמסתובב בקטלוג API עצום ממדים.

נראות, ייחוס עלויות והגנה על שלבים הבאים בתהליך

מכיוון שכל שיחה עוברת דרך השער, כל בקשה יכולה לשדר אירוע מובנה הכולל:

  • השרת, הכלי, החבילה והצוות האחראי;
  • המשתמש, הסוכן, השירות והפלטפורמה המעורבים בשיחה;
  • תוצאת האישור, קוד הסטטוס, מקור השגיאה ופירוט זמני ההשהיה;
  • גודל הבקשה והתגובה; וכן
  • מטא-נתוני עלויות המדווחים במורד הזרם, ככל שקיימים.

השער גם מפיק מדדים בנוגע להיקף הבקשות, זמן ההשהיה לכל כלי, החלטות אימות, תוצאות רענון OAuth, החלטות בנוגע להגבלת קצב, חיבורי סטרימינג וכשלים במעלה הזרם. התפשטות העקבות מאפשרת לצוותים לעקוב אחר קריאה מהסוכן דרך השער ועד לשרת במורד הזרם.

לכך יש ערך תפעולי ישיר: צוות האבטחה יכול לבצע ביקורת על הגישה, צוותי הפלטפורמה יכולים לאתר סוכנים "רועשים", בעלי הכלים יכולים לעקוב אחר השימוש והשגיאות, וצוותי התשתית יכולים לייחס את העלויות.

אותו עיקרון מגן על מערכות במורד הזרם. ניתן להגדיר את היקף מגבלות הקצב לפי שרת, כלי, מתקשר, משתמש, חבילה או סוג מתקשר. מגבלות חדשות יכולות לפעול במצב "צל" לפני האכיפה, ולהציג מה היה נדחה מבלי לשבש את התעבורה בסביבת הייצור.

השער הופך את הניהול לנתונים, במקום להסתמך על כל צוות שימלא את השדות הנכונים ויאכוף את המגבלות הנכונות.

תהליך קליטה בשירות עצמי

שער גישה פועל רק אם הצוותים מעדיפים להשתמש בו במקום לעקוף אותו. הרישום, האיתור, הסינון וניהול החבילות – כולם חייבים להתבצע באופן עצמאי.

באמצעות ממשק המשתמש (UI) וממשק ה-API של מישור הבקרה, הצוותים יכולים לרשום שרתים וסוכנים של MCP, להגדיר אימות, לאתר כלים, להקצות בעלות, להגדיר מסננים, להוסיף כלים לחבילות ולבדוק את השימוש בסביבת הייצור.

תהליך ההטמעה של השער כולל את השלבים הבאים:

  1. רשום את שרת ה-MCP.
  2. גלו את קטלוג הכלים הגולמי שלו דרך tools/list.
  3. בחר ואשר את הכלים ש-DoorDash מעוניינת לחשוף.
  4. הגדר את מצב האימות, הבעלות והמדיניות.
  5. הוסף את הכלים שאושרו לחבילה אחת או יותר.
  6. עקבו אחר התעבורה, זמן ההשהיה, השגיאות, החלטות האישור והעלות.

ממשל הדורש כרטיסים אינו ניתן להרחבה. הדרך הסלולה חייבת להיות קלה יותר מאשר העתקת סוד לסוכן והתחברות ישירה לשרת.

מה השתנה

השער מעניק לכל קבוצה יתרון שונה:

  • מפתחי סוכנים מקבלים אינטגרציה אחת, קטלוג אחד שנבחר בקפידה, וללא אימות במורד הזרם, OAuth, טיפול בסודות או ניתוב לפי כלי.
  • בעלי הכלים זוכים למסלול הפצה מנוהל הכולל בקרת גישה, חשיפה מאושרת של הכלים ונתוני שימוש בסביבת הייצור.
  • צוותי האבטחה מקבלים גישה למדיניות מרכזית, לסודות, להרשאות OAuth, לביטול הרשאות ולרישומי ביקורת.
  • צוותי הפלטפורמה זוכים ליתרון; זהות, הגבלת קצב, יכולת ניטור, איכות הכלים, ייחוס עלויות וחווית המפתחים – כל אלה משתפרים במקום אחד.
  • הסוכנים זוכים לקטלוגים מצומצמים יותר, לשמות כלים ברורים יותר, לחבילות המותאמות למשימות, למספר מצומצם יותר של אפשרויות לא רלוונטיות ולתהליכי חיבור הניתנים לשחזור.

אימוץ

האימוץ הוא המבחן האמיתי של פלטפורמה: צוותים ישתמשו בה רק אם זה קל יותר מאשר פנייה ישירה. לפי מדד זה, Agent Gateway הפכה לנתיב ברירת המחדל לגישה בין הסוכנים לכלי העבודה בכל מחלקת ההנדסה של DoorDash:

  • מאחורי השער רשומים יותר מ-200 שרתים מסוג MCP, אשר יחד חושפים אלפי כלים שנבחרו בקפידה והוכנסו לתתי-קבוצות מאושרות המותאמות למשימות ספציפיות, במקום קטלוגים גולמיים.
  • יותר מ-30 סוכנים ושירותים, שבהם משתמשים אלפי עובדים, ניגשים לכלים אלה דרך השער, ואף אחד מהם אינו מטפל בנתוני הזדהות גולמיים. 
  • מיליוני קריאות לכלי עבודה בכל שבוע מועברות דרך שער הסוכנים (Agent Gateway), כאשר כל אחת מהן עוברת אימות, אישור והקלטה כאירוע שימוש מובנה.
  • תהליך ההטמעה הוא עצמאי ומהיר. רישום שרת MCP חדש והכלים הנלווים אליו אורך דקות ספורות, והצבת סוכן על כלי שכבר נרשם היא מהירה עוד יותר.

לקחים שנלמדו

הקמת השער והרחבתו שינו את האופן שבו אנו תופסים את הגישה של הסוכנים לכלים. ניתן להפיק מכך מספר תובנות בולטות, ולא רק ב-DoorDash:

  • MCP פותר את בעיית ההפעלה, אך לא את נושא הניהול. זהות, מדיניות, סודות, ניהול תוכן, יכולת ניטור וביטול הופכים לחלקים המורכבים.
  • קטלוג הכלים שהתגלה הוא ממשק, כלומר יש חשיבות לשמות, לתיאורים, לסינון, לקיבוץ ולקהל היעד.
  • חבילות הן היחידה המתאימה ביותר לתהליכי עבודה. הנציגים זקוקים לערכות כלים המותאמות למשימות, ולא לרשימות שרתים.
  • סינון הכלים משפר הן את האבטחה והן את איכות הסוכנים, בכך שהוא מציג מערך פעולות מצומצם וברור יותר.
  • אישורי הגישה צריכים להיות מאוחסנים בשער, שם ניתן לבצע את החלפתם, ביקורתם וביטולם באופן מרכזי.
  • היעדר אישורי OAuth הוא מצב רגיל, ולא חריגה, במסגרת הטיפול בחיבור בתוך הפרוטוקול.
  • המסלול המנוהל חייב להיות בשירות עצמי, אחרת הצוותים יעברו למסלול ישיר.

מה הלאה

ההשקעה המשמעותית הבאה תתמקד בחיזוק זהות הסוכנים ובהאצלת סמכויות למשתמשים. המודל המיועד מעניק לכל סוכן זהות קריפטוגרפית ומאפשר לשער ליצור אישורים מוענקים לתקופה קצרה, המותאמים למשתמש, לסוכן, למשימה ולכלי היעד. כך נוצרים במסלול הביקורת שני גורמים עיקריים: המשתמש והסוכן.

כמו כן, אנו משקיעים בפיתוח כלים למפתחים, לרבות דוחות איכות ואבטחה, בדיקות של תיאורי כלים מסוכנים, זיהוי סודות או מידע המאפשר זיהוי אישי בשגיאות, יצירת שרתים מדורגת, רישום אוטומטי, גילוי כלים דינמי, וזרמי אירועי קריאות כלים שעברו עריכה לצורך ניתוח נתונים ותאימות.

הגילוי הדינמי ממשיך באותו קו מחשבה. במקום לספק לסוכן את כל הכלים בחבילה אחת, השער יכול להשתמש בהקשר המשימה, במדיניות ובסימני השימוש כדי להציג רק את הכלים שעשויים להיות שימושיים למשימה הנוכחית.

מַסְקָנָה

שער הסוכנים (Agent Gateway) הופך את הגישה לכלי הסוכנים מעבודה חוזרת ונשנית של אינטגרציה ליכולת משותפת של הפלטפורמה. MCP הקל על תיאור הכלים והפעלתם; השער הופך את הגישה הזו למפוקחת, מאורגנת, ניתנת לניטור וניתנת להרחבה.

תודות

מבוא

פיתחנו את Ask DoorDash על גבי פלטפורמה משותפת המאפשרת לצוותי התחומים לבנות ולשכלל את הסוכנים שלהם מבלי לבנות מחדש את המערכות העומדות בבסיסם. הערכנו את הפלטפורמה על פי שני מדדים מעשיים: מהירות הוספת התכונות והתחומים על ידי הצוותים, ומהירות הערכתם ושחרורם של שיפורים בתחומי העלות, האיכות וזמן ההשהיה.

השקנו את "Ask DoorDash" עם תמיכה במסעדות ובמרכולים תוך כחודשיים, ומאז היא טיפלה ביותר משני מיליון שיחות. הוספת "Reservations", הסוכן התחומי השלישי שלנו, ארכה שבוע אחד – מהירות גבוהה פי 10 בערך בהשוואה לפיתוח הסוכנים התחומיים הראשונים.

מערכת ההערכה המשותפת שלנו ובקרות הפריסה מספקות לצוותים אינדיקציות ברורות לגבי איכות התוצאות, תוך כדי העברת השינויים לסביבת הייצור. תוך שבוע מרגע שחרורו של מודל LLM חדש, הערכנו אותו ופרשנו אותו, ובכך צמצמנו את זמן ההשהיה ב-p50 ב-35% ללא ירידה בציוני האיכות. שדרוג מודל שבוצע לאחר מכן צמצם את זמן ההשהיה ב-p50 בעוד 40%.

פוסט זה מסביר כיצד בחרנו אילו מרכיבים יכללו בפלטפורמה, כיצד המרכיבים הללו משתלבים זה בזה, ומהן הפשרות שעמדו בבסיס ההחלטות הללו. פוסט זה בא בהמשך לסקירה ההנדסית שלנו, לניתוח המעמיק בנושא הבינה המלאכותית ולניתוח המעמיק בנושא ההערכה. בהמשך יפורסם ניתוח מעמיק בנושא חוויית המשתמש.

כיצד בחרנו מה לתקנן

ריכזנו יכולת מסוימת רק כאשר מספר תחומים נזקקו לה, ויישומים נפרדים היו עלולים ליצור בעיות אמינות או תפעוליות. תיאום, זיכרון, גישה למודלים, מעקב, תשתית הערכה ובקרות פריסה עמדו בקריטריון זה. צוותי התחומים שמרו על האחריות על ההנחיות, המיומנויות, הכלים, קריטריוני ההערכה ובחירת המודלים המגדירים את הסוכנים שלהם.

במקרים שבהם היה קיים תקן תעשייתי מתאים, אימצנו אותו. Agent2Agent (A2A) הגדיר את אופן התקשורת בין הסוכנים, ואילו Google Agent Development Kit (ADK) סיפק את המסגרת לבנייתם ולהפעלתם. תקנים אלה הגבילו לעתים את אפשרויות העיצוב שלנו, אך הם סיפקו לצוותים חוזים משותפים וחסכו לנו את הצורך לפתח מקבילים קנייניים.

במקרה של בעיות חוזרות ונשנות שלא היה להן תקן מתאים, פיתחנו את היכולת בעצמנו. רגרסיה בקוד משותף עלולה הייתה להשפיע על מספר סוכנים, ולכן היה הכרחי להנהיג בקרות הערכה ופריסה. כל שינוי משותף היה חייב לעבור בדיקות איכות משותפות ואמצעי אבטחה לקראת השקה.

שאל את צוות הארכיטקטורה של DoorDash

ההחלטה האדריכלית המרכזית הייתה מה צריך להיות משותף לכל הסוכנים ומה צריך להיות בבעלות כל תחום. בנינו מסלול ביצוע משותף סביב סוכנים ייעודיים, הנמצאים בבעלות התחומים. סוכן יחיד לשימוש כללי היה הופך לקשה יותר להבנה ככל שהיה לוקח על עצמו יותר אחריות, בעוד שמערכי סוכנים עצמאיים לחלוטין היו יוצרים כפילויות בתשתית ומביאים לחוויות לא עקביות.

כפי שמוצג באיור 1, כל בקשה נכנסת דרך השער (Gateway). השער מאמת את זהות המשתמש, מרכיב את הקשר של נקודת הכניסה, ומבצע תרגום בין ממשקי ה-HTTP והסטרימינג של הלקוח לבין פרוטוקול ה-A2A של הפלטפורמה. לאחר מכן, הוא מעביר את הבקשה למנצח, אשר בוחר את הסוכן התחומי עבור כל תור, תוך שמירה על רציפות ככל שהשיחה עוברת בין תחומים. הסוכן הנבחר טוען את הכישורים המתאימים ומשתמש בכלים של פרוטוקול הקשר המודל (MCP) כדי לתקשר עם שירותי DoorDash הקיימים.

מתחת לנתיב הבקשה הזה, הפלטפורמה מספקת מצב הפעלה, זיכרון, ארטפקטים, גישה למודלים, מעקב, תשתית הערכה ובקרות פריסה. סוכני התחום משתמשים בשירותים משותפים אלה תוך שמירה על השליטה בהוראותיהם, במיומנויותיהם, בכלים שלהם ובקריטריוני ההערכה שלהם.

איור 1: Ask DoorDash מבדיל בין התנהגות הסוכנים הספציפית לתחום לבין יכולות הביצוע וההפקה המשותפות המשמשות בכל רחבי המערכת.

שער לחוויות מותאמות ומולטי-מודאליות

שערי הלקוח של DoorDash נבנו עבור ממשקי API שמחזירים תגובה מלאה במהירות. הנציגים פועלים באופן שונה. ייתכן שהטקסט הראשון יהיה מוכן עוד בזמן שהנציג עדיין קורא לכלים, והתגובה הסופית עשויה לשלב טקסט רציף עם כרטיסי חנות או פריטים אינטראקטיביים. היינו צריכים להזרים את העבודה הזו מבלי ללמד כל לקוח כיצד הנציגים מתקשרים.

ה-Gateway מטפל בתרגום זה. הוא מאמת את המשתמש, מוסיף הקשר לגבי המקום שבו החלה השיחה, וממיר בקשות HTTP של הלקוח לבקשות A2A. במסלול החזרה, הוא משתמש ב-Vercel AI SDK כדי לשלוח עדכוני טקסט ותכנים של ווידג'טים ללקוחות באמצעות Server-Sent Events (SSE). הלקוחות מציגים את העדכונים עם הגעתם, כך שהמשתמשים יכולים לראות את ההתקדמות בזמן שהסוכן משלים את תורו.

הקמת ה-Gateway ותפעולו דרשו מאמץ, אך הדבר איפשר לרכז את העבודה, שאחרת הייתה מתבצעת בכפילויות אצל כל אחד מלקוחות DoorDash. הסוכנים יכולים לבצע שינויים במסגרת חוזה לקוח יציב אחד, מבלי שיידרשו שחרורי גרסאות מתואמים מצד הלקוחות. סוכן דומיין חדש עושה שימוש חוזר במסלול האימות והסטרימינג הקיים, במקום לבצע אינטגרציה נפרדת עם כל אפליקציה.

עוזר אחד, סוכנים המתמחים בתחום מסוים

שיחה יכולה לעבור בין תחומים ללא התראה מוקדמת. משתמש עשוי להתחיל ב"אני רוצה שיביאו לי פאי עוף תוך פחות מ-30 דקות", ואז להחליט: "למעשה, אני רוצה להכין אותו בבית". הבקשה הראשונה שייכת לתחום המסעדות והשנייה לתחום המכולת, אך החוויה צריכה להרגיש כמו שיחה אחת.

ניסינו להשתמש בארכיטקטורת סוכן יחיד, אך התחומים "מסעדה", "מכולת" ו"הזמנות" מסתמכים על כלים, מדיניות וקריטריוני הערכה שונים. שילובם היה מקשה על בדיקת הסוכן ומאלץ כל תחום להיכנס לאותו מחזור שחרור. לפיכך, לכל תחום יש סוכן ייעודי משלו. ה-Orchestrator קורא את השיחה ומנתב כל תור לסוכן המתאים באמצעות A2A.

ניתוב זה מוסיף זמן השהיה ואסימוני קלט, גם כאשר השיחה נשארת באותו תחום. כדי לצמצם עלות זו, ה-Orchestrator מקבע את תורי התגובה לסוכן התחום הנבחר. קיבוע זה מאפשר לסוכן לטפל בבקשות הבאות באופן ישיר, ללא שלב ניתוב נוסף. אם השיחה משנה כיוון, סוכן התחום מזהה את ההודעה שאינה נכללת בתחום האחריות ומחזיר את השליטה ל-Orchestrator. ה-Orchestrator מנתב מחדש את הבקשה בתוך אותו תור, מבלי שהמשתמש יבחין בכך.

איור 2: "פינינג" מונע קריאה ל-Orchestrator בתורות הבאות, תוך שמירה על האפשרות שהשיחה תעבור בין תחומים.

המיומנויות מגבילות את ההקשר ואת העלות

סוכנים ייעודיים מנעו ממסעדות, מכולות והזמנות לחלוק חלון הקשר אחד ענק. עם זאת, ככל שכל סוכן צבר יכולות, אותה בעיה של הקשר הופיעה בתוך התחומים הבודדים. תכונות חדשות הוסיפו הוראות וכלים לכל תור, גם כאשר התור מעולם לא השתמש בהן. הדבר הגדיל את עלות אסימוני הקלט, והוראות חופפות או סותרות בלבלו את הסוכן.

הוספנו תמיכה במיומנויות למערכת שלנו כדי להפוך את ההוראות והכלים למודולריים. בכל תור, הסוכן טוען רק את מה שרלוונטי. משתמש עשוי להתחיל בבקשה: "מצא לי מסעדה תאילנדית בעלת דירוג גבוה שמבצעת משלוחים תוך פחות מ-30 דקות", ולאחר מכן לומר: "הראה לי את התפריט של המסעדה הראשונה והוסף 'פד סי או' לעגלת הקניות שלי". שתי הבקשות נשארות אצל הסוכן "מסעדה", אך הבקשה הראשונה טוענת את מיומנות החיפוש והגילוי. הבקשה השנייה טוענת את מיומנות ההזמנה לעגלת הקניות, המטפלת בדפדוף בתפריט ובפעולות הקשורות לעגלת הקניות.

טעינה דינמית יוצרת בעיה בבחירת היכולות. על הבוחר לזהות מתי יש צורך ביכולת מסוימת, מבלי לטעון הקשר שאינו רלוונטי לעתים קרובות מדי; לפיכך, אנו מעריכים את בחירת המיומנויות כחלק מהתנהגות הסוכן. המורכבות הנוספת הייתה כדאית, שכן הצוותים יכלו להוסיף יכולות מבלי להרחיב את ההקשר בכל תור.

כדי למדוד את ההשפעה, ספרו את האסימונים בהוראות הבסיס והטעונות של הסוכן. לא נכללו בהספירה היסטוריית השיחות, הודעות הצרכנים, סכמות הכלים ותוצאות הכלים. התור החציוני במסגרת המיומנות השתמש בפחות ממחצית מכמות אסימוני ההוראות בהשוואה לפרומפט של המערכת המונוליטית.

סוכןהוראות בסיסיות והוראות מיומנות עם כל המיומנויות הטעונותהמספר החציוני של הוראות המותאמות לרמת המיומנות בכל תורהפחתה
מסעדהכ-42,000 אסימונים

כ-20,000 אסימונים50% ומעלה
מכולתכ-25,000 אסימוניםכ-10,000 אסימונים60%

גישה בטוחה וניתנת לשימוש חוזר לשירות באמצעות MCP

האפליקציה "Ask DoorDash" זקוקה לגישה לשירותי DoorDash כדי לחפש חנויות ומוצרים, לקרוא תפריטים, לנהל עגלות קניות ולפעול בשם המשתמש. ממשקי ה-API העומדים בבסיס פעולות אלה מבוססים על קוד יישום דטרמיניסטי. מודל שפה גדול (LLM) הבוחר פעולות בזמן ריצה זקוק לממשק מצומצם יותר. חשיפת ממשקי ה-API באופן ישיר תאלץ את המודל לפרש ממשקים ברמה נמוכה. קידוד ההרשאות וכללי העסק רק בפרומפט יוסיף הקשר, אך לא יבטיח את אכיפתם.

בנינו שכבת Model Context Protocol (MCP) משותפת בין הסוכנים לממשקי ה-API של DoorDash. כל כלי MCP חושף פעולה ספציפית הכוללת את הקלטים והפלטים הדרושים למודל. המודל בוחר לאיזה כלי לפנות. קוד דטרמיניסטי מאמת כל בקשה ומאכף הרשאות וכללים עסקיים לפני שהבקשה מגיעה לשירות הבסיסי.

ההנחיות מסייעות למודל לבחור את הפעולה הנכונה, אך הנחיות אלה הן בגדר המלצה בלבד. תהליכי האימות והאכיפה מתבצעים בקוד הכלי בכל קריאה, ובכך יוצרים גבול בטיחות יציב גם כאשר ההנחיות והמודלים משתנים.

תכנון כלים דורש איזון. כלי רחב מדי עלול להציב בפני המודל אפשרויות רבות מדי, בעוד שכלי צר מדי עלול להפוך משימה לשרשרת ארוכה של קריאות. שרת ה-MCP המשותף שלנו מספק כעת יותר מ-60 כלים עבור זרימות עבודה של סוכנים, הן ציבוריות והן פנימיות. סוכן חדש בוחר את הכלים הדרושים לו מתוך הספרייה הזו, והשיפורים בתחומי האימות, הטלמטריה או שילוב השירותים מטיבים עם כל סוכן המשתמש בהם.

איור 3: ההנחיות משפיעות על מה שהמודל מבקש; קוד הכלי MCP קובע מה ניתן לבצע.

מוכנות לייצור כברירת מחדל

ADK סיפקה לנו את המרכיבים הבסיסיים לבניית סוכן, כולל הוראות, כלים, פונקציות החזרה, הפעלות וחיבור מודלים. סוכני DoorDash נזקקו גם למעקב מבוזר, גישה למודלים, מצב קבוע ובקרות פריסה. ללא שכבה משותפת, כל צוות תחום היה נאלץ לקבל את ההחלטות הללו ולהפעיל את התשתית שהתקבלה באופן עצמאי.

בנינו מודולים הניתנים לשימוש חוזר על גבי ADK, כדי לאפשר יכולות שצריכות לפעול באותו אופן בכל הסוכנים. צוותי התחומים עדיין בוחרים את ההוראות, הכלים ותצורת המודל שלהם. הפלטפורמה מקשרת בין בחירות אלה למערכות הנדרשות להפעלת הסוכנים באופן אמין בסביבת הייצור.

מעקב הוא דוגמה אחת לכך. צוות מאפשר זאת באמצעות תצורה, ו-SDK המשותף מעביר מזהה מעקב דרך שיחות A2A, כלי MCP ושירותי DoorDash במורד הזרם. מהנדסים יכולים לעקוב אחר בקשה אחת לאורך ה-Orchestrator, סוכני התחום ושיחות הכלים, במקום להרכיב יומנים ממערכות נפרדות. אותם נתוני מעקב תומכים באיתור באגים ובהערכה. מתן יכולת מעקב דרך הפלטפורמה חוסך כ-חודש של עבודת נראות עבור כל השקה של סוכן חדש.

הגישה למודלים פועלת על פי אותו עיקרון. צוותי התחומים בוחרים אילו מודלים ישתמשו הסוכנים שלהם, בעוד שהפלטפורמה אחידה את האופן שבו מודלים אלה מופעלים, מעוקבים ומוגנים באמצעות התנהגות גיבוי. הצוותים יכולים לבחון ולאמץ מודלים חדשים מבלי לשכתב אינטגרציות ספציפיות לספקים. נתיב משותף זה איפשר את שדרוגי המודלים המהירים ושיפורי זמן ההשהיה שתוארו קודם לכן.

מצב משותף לשיחות אמינות

ניסיונות קודמים לפתח מוצרי סוכנים ב-DoorDash בשנת 2025 הראו עד כמה מהר החוויה מתפרקת כאשר מצב המערכת אינו אמין. סוכן יכול היה להגיב היטב לבקשה אחת, ואז לשכוח או להשתמש באופן שגוי במידע מתור קודם. פתרון הבעיה הזו דרש יותר מאשר הוספת היסטוריית השיחה לפקודה.

Ask DoorDash משתמשת בשלושה סוגי מצבים. מצב ההפעלה עוקב אחר השיחה הפעילה והעבודה שכבר הושלמה במסגרתה. הזיכרון שומר מידע שעשוי להיות שימושי בשיחות עתידיות, כגון העדפות המשתמש. הארטיפקטים מכילים תוצרים מובנים שהנציגים יוצרים ומעדכנים, כולל רשימות קניות וכרטיסים אינטראקטיביים. לכל אחד מהם יש משך חיים ודפוס גישה שונים.

בפרויקטים קודמים של סוכני DoorDash יושמו יכולות אלה באופן עצמאי. הדבר גרם לכפילות בעבודת השמירה על נתונים והפך את האמינות לתלויה בבחירות של כל צוות. ריכזנו אותן בשירותי הסוכנים המנוהלים (Managed Agent Services), המספקים ממשקי API תואמי ADK עבור הפעלות, זיכרון וארטפקטים. סוכני התחום משתמשים באותם ממשקים מבלי להפעיל מערכות מצב משלהם.

ריכוזיות עדיין מחייבת כללים נפרדים לאחסון ולמחזור החיים של נתוני הפעלה, זיכרון לטווח ארוך ואובייקטים. שירותי הסוכן המנוהלים (Managed Agent Services) מאגדים את הגבולות הללו במקום אחד. כל תחום עדיין מחליט איזה מידע יש לשמור ולאחזר במסגרת החוויה שלו.

שירותי הסוכנים המנוהלים וארכיטקטורת הזיכרון מוסברים בפירוט רב יותר בחלק השני.

הישארו מעודכנים עם עדכונים שבועיים

הירשמו לבלוג ההנדסה שלנו כדי לקבל עדכונים שוטפים על כל הפרויקטים הכי מגניבים שהצוות שלנו עובד עליהם
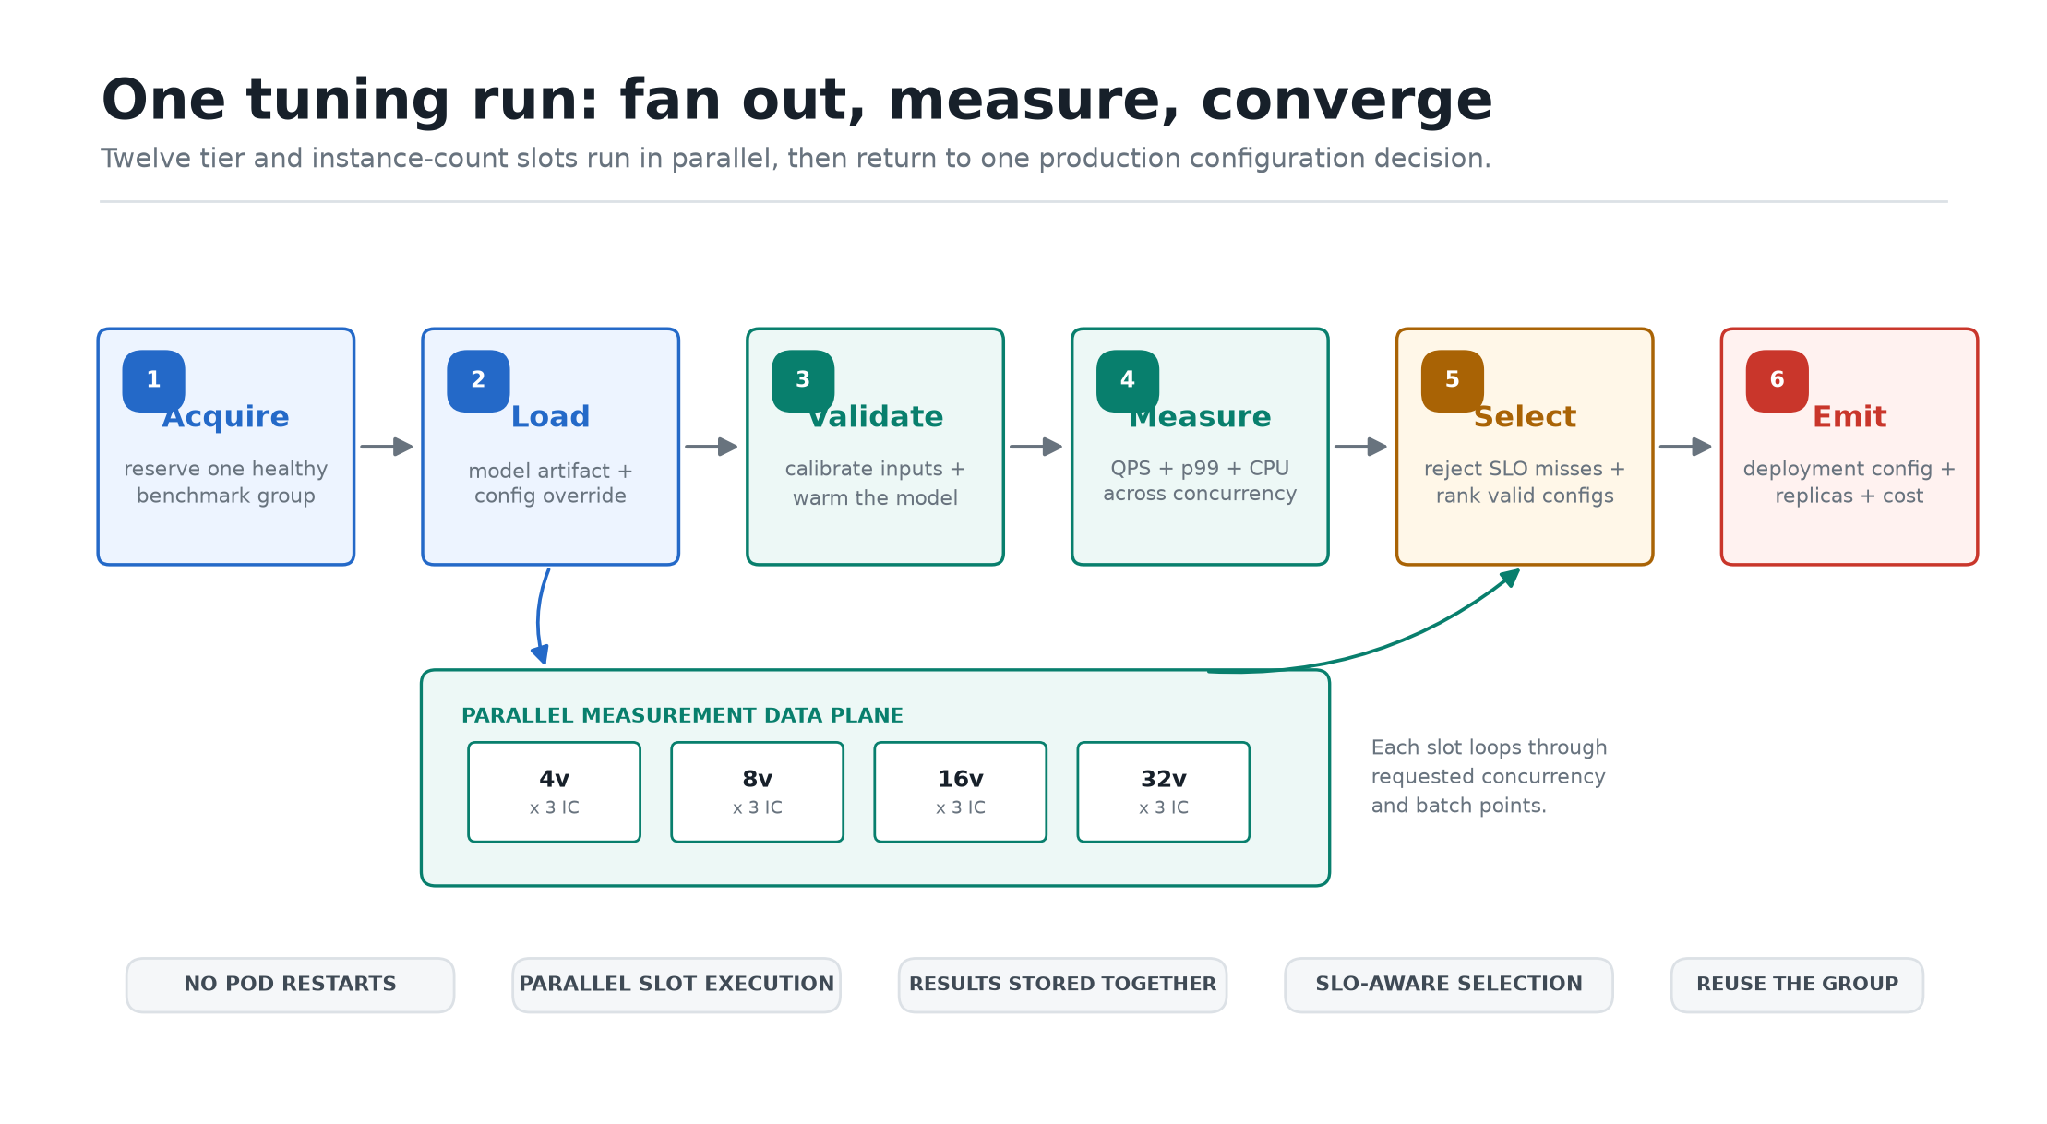
מה השתנה בפלטפורמה

"הזמנות" היו מבחן מעשי לפלטפורמה. הצוות עשה שימוש חוזר במסלול הייצור שכבר שימש את תחומי "מסעדות" ו"מכולת", והשיק את התמיכה ב"הזמנות" תוך שבוע אחד — מהירות גבוהה פי 10 בערך בהשוואה לפיתוח הסוכנים התחומיים הראשוניים.

צוותי התחומים שומרים על האחריות על התנהגות הסוכנים ועל קריטריוני האיכות. הפלטפורמה מספקת את מערך ההערכה, כלי ה-MCP, מעקב, גישה למודלים ובקרות פריסה, כך שהשיפורים ברכיבים אלה מגיעים לכל סוכן המשתמש בהם.

תשתית משותפת מגדילה את היקף ההשפעה של טעויות. פגם יכול להשפיע על מספר סוכנים, והפשטה מוקדמת מדי עלולה לכפות על מוצרים שונים להתאים לאותה תבנית. אנו מבצעים סטנדרטיזציה של יכולת רק לאחר שתחומים רבים זקוקים לה, ושהטמעה נפרדת עלולה ליצור בעיות אמינות או תפעוליות.

הצטרפו אלינו

אם פיתוח פלטפורמות לסוכנים ו-AI הפונה למשתמשים בקנה מידה גדול נשמע לכם מעניין, אתם מוזמנים לבדוק את משרות ההנדסה הפנויות שלנו באתר careersatdoordash.com.