Ir al contenido

En un mercado, los riesgos se centran inevitablemente en dos preguntas fundamentales: ¿Quién es esta persona? y ¿qué grado de confianza tenemos en que esta acción sea legítima? Algunos ejemplos de lo que queremos decir con esto: un agente de atención al cliente que evalúa una solicitud de reembolso necesita conocer estas respuestas. Un motor promocional que decide si ampliar una oferta no puede seguir adelante sin esta información. Un sistema de mitigación de bots que analiza un intento de inicio de sesión en busca de tráfico automatizado se ve paralizado sin estos datos. Los detalles varían —el canal, la señal, el umbral—, pero las preguntas fundamentales no cambian. 

Aunque estas cuestiones no son nuevas, la inteligencia artificial ha ido generando cada vez más presión desde ambos lados de la ecuación; los mismos avances que facilitan la generación a gran escala de comportamientos falsos y convincentes también permiten identificar a los actores con señales más precisas que nunca.

Sin embargo, la identidad nunca se ha tratado como una capacidad horizontal en sí misma. En cambio, la mayoría de los sistemas se han diseñado pensando primero en el producto: un motor de riesgo para los pedidos, un modelo para la segmentación promocional o una regla para la detección de apropiación de cuentas. Cada uno de ellos responde implícitamente a una variante de la pregunta «¿quién es este?» para sus propios fines, pero ninguno comparte esa respuesta. Esto da lugar a un conjunto de visiones parciales de la misma persona, cada una de ellas precisa para su propio propósito, pero aislada dentro de su propio sistema.

La inteligencia de identidad parte de una premisa diferente: si la pregunta es compartida, la señal que la responde también debería serlo. Se trata de un problema de plataforma —resuelto una sola vez, de forma centralizada— que es distinto de cómo decide actuar cada sistema concreto ante la respuesta, lo cual varía en función de dónde se aplique. Si se trata como una capacidad horizontal de primer orden —y no como un subproducto de un producto concreto—, la identidad se convierte en un hilo conductor que recorre casi todos los casos de uso relacionados con la integridad. Esa es nuestra tesis central: la identidad es una de las capacidades de mayor impacto, pero menos valoradas, en el ámbito de la integridad, precisamente porque nadie la desarrolla como algo independiente.

La identidad cobra todo su sentido

Si esa pregunta de «¿quién es este?» es tan universal, ¿por qué no se ha considerado la identidad como una infraestructura fundamental desde el principio?

En el pasado, cada superficie de integridad —ya fuera de riesgo de pedidos, de riesgo de cuentas o de riesgo promocional— resolvía primero su propio problema a su manera, con sus propias señales de dispositivos, su lógica de vinculación y su definición práctica de «la misma persona». Así es como suelen resolverse los problemas especializados: con una regla por aquí y un modelo por allá, cada uno diseñado específicamente para un fin concreto y listo para su implementación rápida. Una capa de identidad compartida supone un tipo de inversión diferente: no pertenece a ningún ámbito concreto, por lo que ningún ámbito está naturalmente en condiciones de crearla, aunque todos se beneficiarían de ella.

El resultado hasta la fecha ha sido una señal de identidad que no se puede reutilizar tal cual. Cada nuevo equipo que quería esa respuesta tenía que implementarla desde cero mediante una integración a medida y única, en lugar de conectarse a una interfaz estándar. Durante años, las señales de identidad han existido en todas partes, pero no eran propiedad de nadie; cada equipo pagaba por volver a obtener una respuesta parcial, mientras que nadie aprovechaba el valor acumulado de responder a la pregunta una sola vez y compartirla.

Creación de una plataforma de inteligencia de identidad

En DoorDash, decidimos subsanar esa carencia diseñando una nueva infraestructura. En lugar de que cada sistema creara su propia lógica de vinculación a partir de sus propias señales, queríamos que la identidad fuera algo que se creara una sola vez y se pudiera utilizar en todas partes.

En la práctica, eso supuso crear tres capas sobre un almacén de señales compartido:

  • En primer lugar, la resolución de identidades: un grafo de resolución de entidades con más de 1.000 millones de aristas, creado principalmente mediante técnicas de agrupamiento no supervisado y de predicción de enlaces, que analiza qué cuentas podrían corresponder a una misma persona. 
  • En segundo lugar, la inteligencia relacional: una cuestión relacionada con los gráficos, aunque distinta: ¿qué personas, cuentas, dispositivos y activos están asociados entre sí? Esta capa tiene en cuenta que dos cuentas pueden estar conectadas de forma significativa sin que correspondan a la misma persona. 
  • En tercer lugar, los modelos de toma de decisiones: suelen ser modelos de aprendizaje supervisado, como los clasificadores con refuerzo de gradientes, entrenados con resultados conocidos para un caso de uso específico. Esta capa utiliza los datos de las dos primeras capas para ofrecer una respuesta en tiempo real a la pregunta: ¿Es legítimo este evento concreto, para esta decisión concreta?
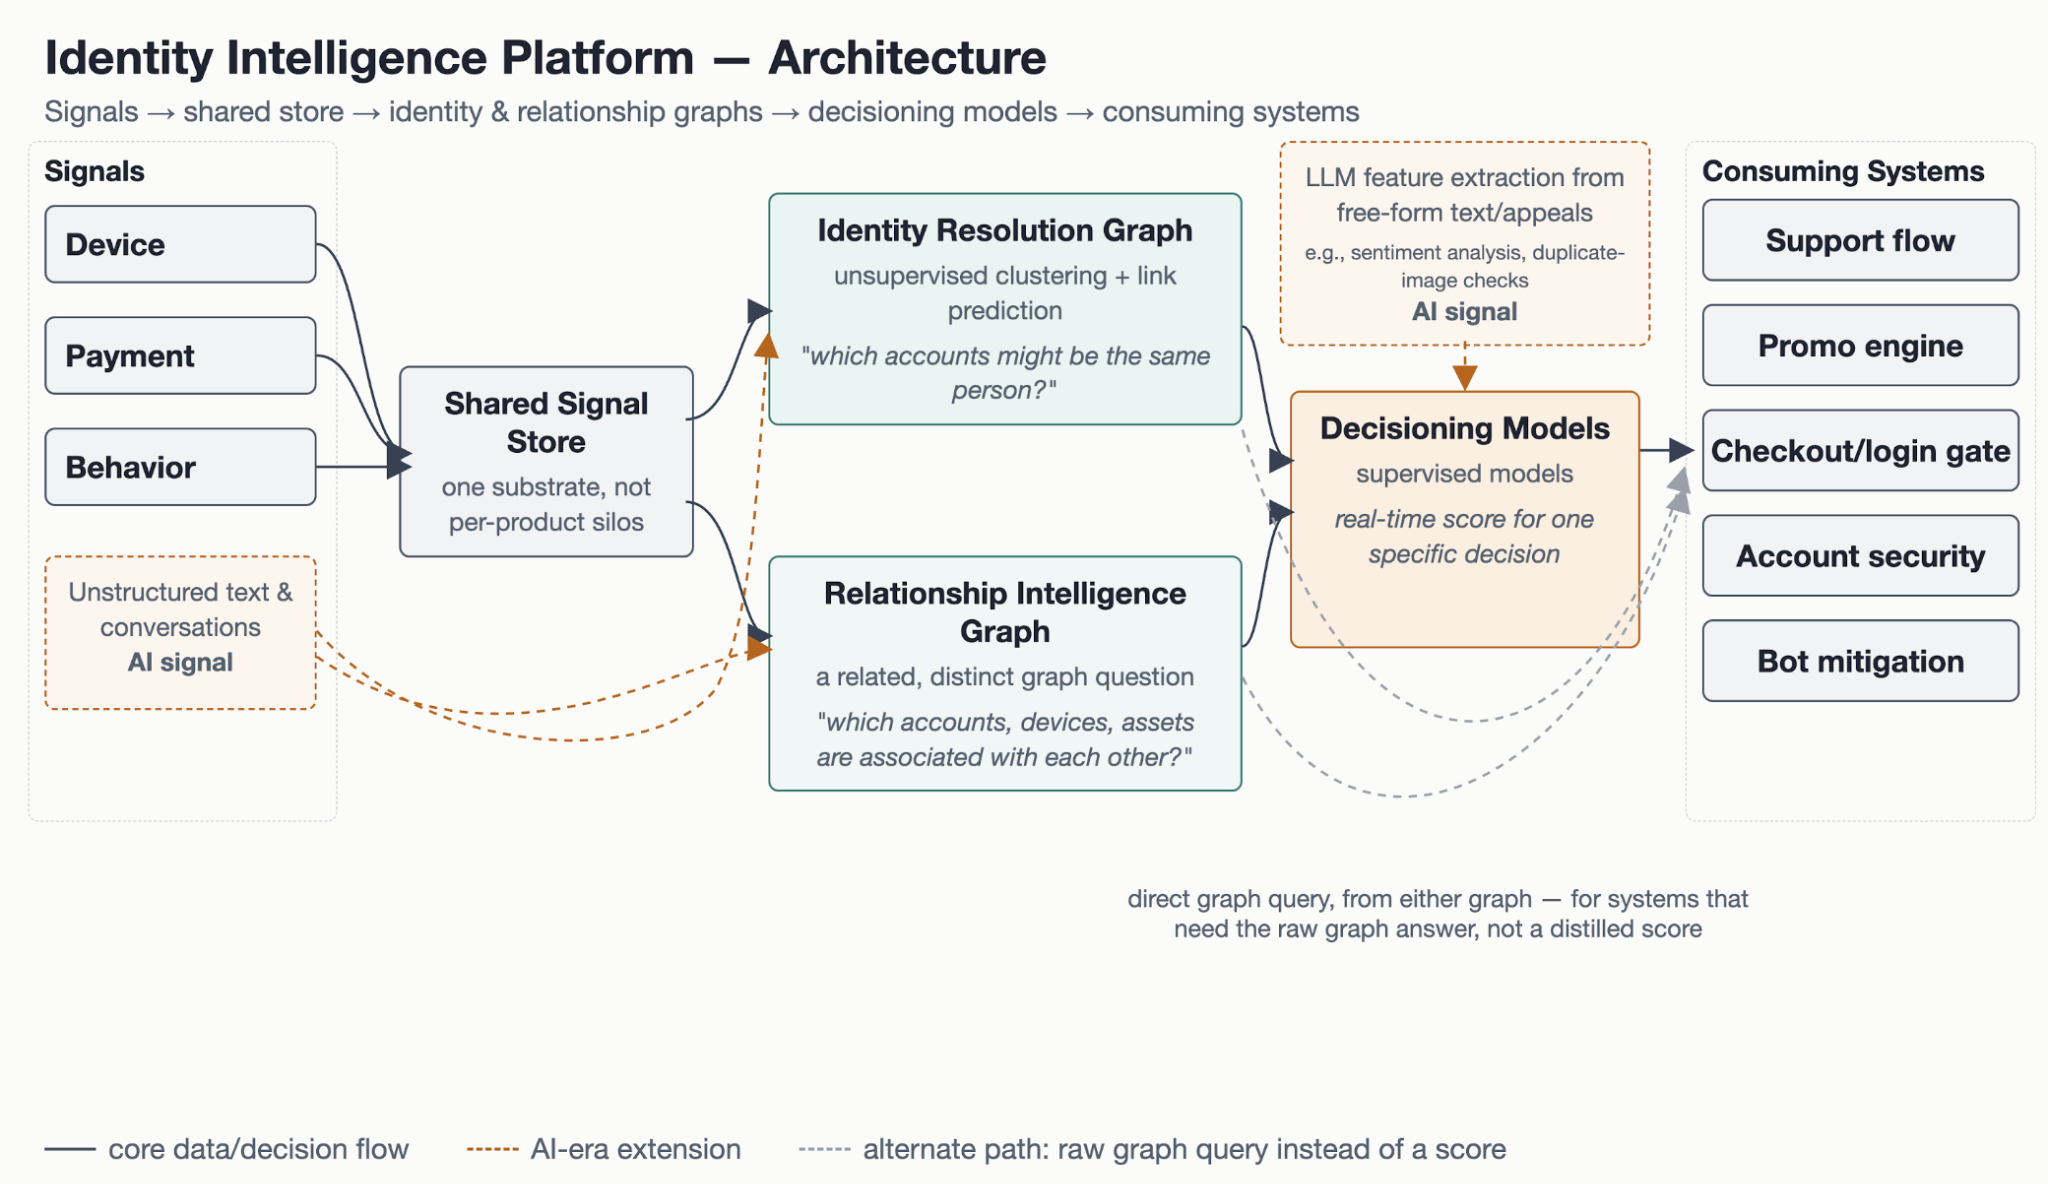
FIGURA 1: UN ALMACÉN DE SEÑALES COMPARTIDO ALIMENTA DOS GRÁFICOS —QUIÉN ES UNA PERSONA Y CON QUIÉN ESTÁ CONECTADA— CUJA SALIDA UNA CAPA DE PUNTUACIÓN TRADUCE EN UNA ÚNICA DECISIÓN.

Tomaremos como ejemplo uno de los casos más difíciles para la resolución de identidades: un cliente que acaba de registrarse, realiza su primer pedido y envía una solicitud de asistencia. No hay historial con el que comparar, ni es probable que haya una coincidencia clara con una cuenta existente; la resolución de identidades por sí sola no tiene muchos datos en los que basarse. Lo que sí tiene la cuenta, desde el momento en que se crea, es un conjunto de atributos de identidad, como un dispositivo, un número de teléfono, una dirección o una tarjeta registrada. La plataforma ya realiza un seguimiento de en qué cuentas ha aparecido cada uno de esos atributos, por lo que cualquier coincidencia en cualquiera de ellos se hace visible de inmediato, sin necesidad de esperar a que se produzca un solo pedido o una solicitud de asistencia. Una dirección compartida, por ejemplo, es un punto de partida, pero una simple indicación de si se comparte o no es demasiado imprecisa para actuar en consecuencia; no indica si esa dirección aparece en dos cuentas o en 200, si todas aparecieron el mismo día o a lo largo de varios años, ni siquiera si ese patrón es inusual. Esa es la función de la inteligencia de relaciones: no determinar quién es alguien, sino caracterizar su grado de conexión. Analiza minuciosamente más de 100 señales derivadas calculadas por cuenta, cada una de las cuales recoge cuántas otras cuentas comparten un atributo determinado, con qué frecuencia y en qué medida resulta anómalo en comparación con un cliente habitual.

Pero ni siquiera todo esto constituye una decisión. Un simple dato del gráfico —como, por ejemplo, que esta dirección tiene 40 cuentas asociadas, la mayoría creadas en la última semana— no constituye un veredicto sobre esta solicitud de asistencia concreta. Convertir uno en lo otro es la función del modelo de toma de decisiones. Este modelo se entrena con resultados para saber qué importancia debe tener ese patrón para este tipo específico de solicitud; su conclusión está disponible en tiempo real, de modo que está lista en el momento en que llega una solicitud.

Por eso la plataforma necesita las tres capas, no solo la primera. La resolución de identidades determina si dos cuentas pertenecen a la misma persona, mientras que la inteligencia de relaciones ofrece una respuesta útil incluso cuando la resolución no arroja ningún resultado; ninguna de las dos constituye una decisión hasta que un modelo creado para ese caso de uso específico la convierta en tal.

La plataforma separa el cálculo de la señal de la puntuación (Figura 2). Las características se agregan de forma asíncrona y están listas a los pocos minutos de que se produzca cualquier cambio. Un punto de control recupera lo que necesita en 10 a 15 milisegundos, en lugar de esperar a que finalice el trabajo que lo ha generado. La puntuación se sitúa entonces donde lo permita el presupuesto de latencia de la superficie; se ejecuta en línea cuando hay espacio disponible, o puede activarse tan pronto como llegan las características, de modo que la puntuación se almacena y se lee en el momento de la decisión.
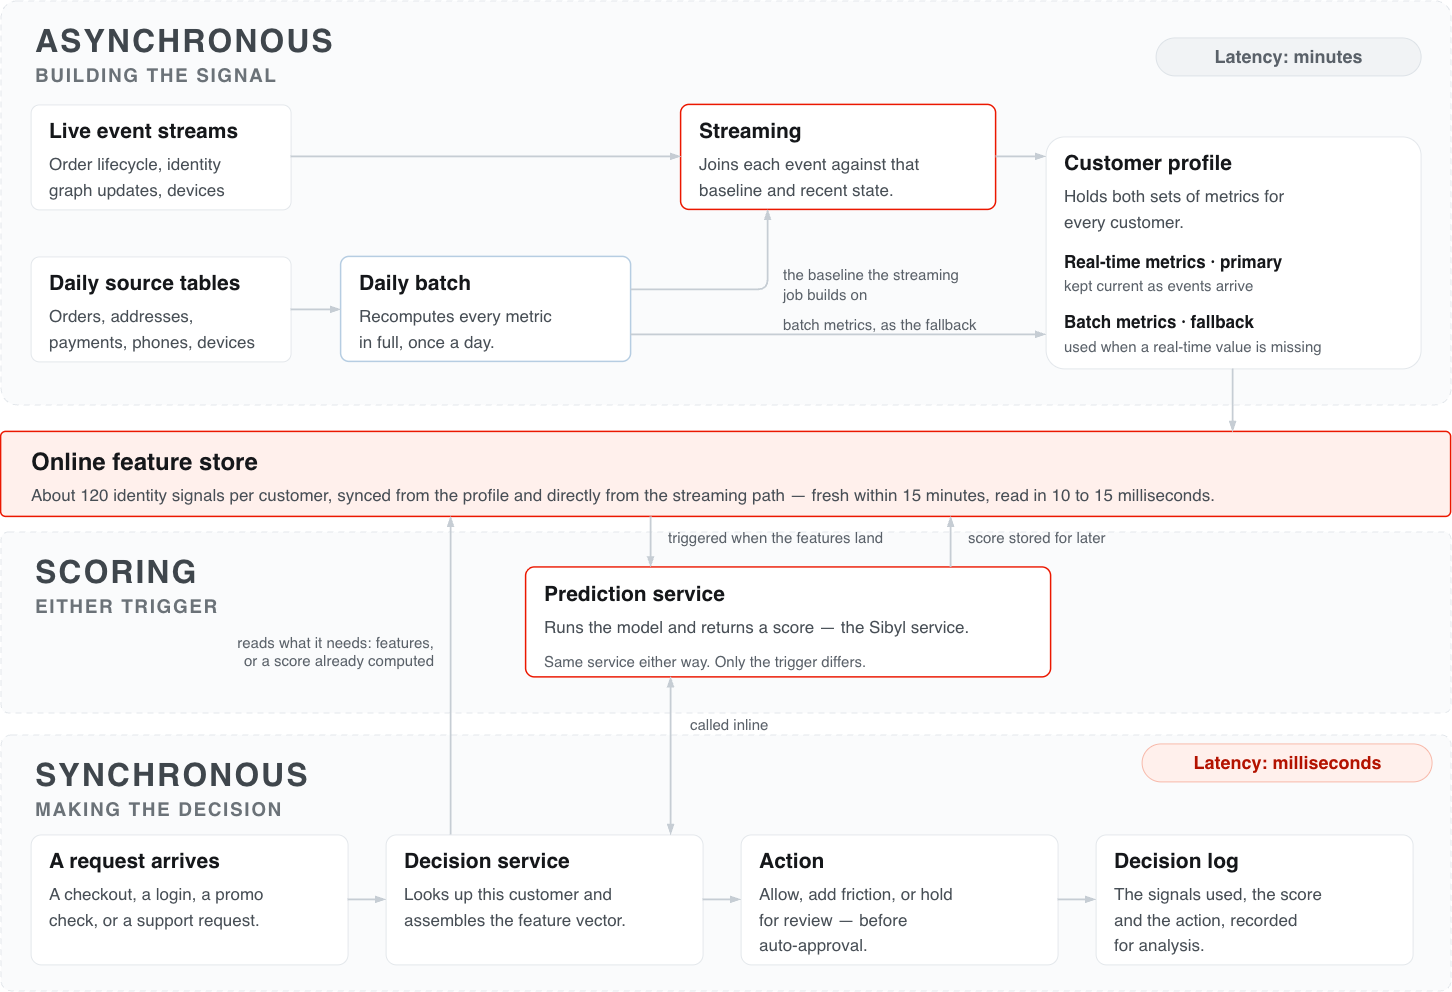
Figura 2: LAS SEÑALES DE IDENTIDAD SE GENERAN SEGÚN SU PROPIO RELOJ Y SE ALMACENAN UNA SOLA VEZ, POR LO QUE NINGUNA DECISIÓN DEPENDE DE LA AGREGACIÓN QUE HAY DETRÁS DE ELLAS.

Una base, múltiples aplicaciones

Los sistemas posteriores —por ejemplo, un flujo de asistencia, un motor de promociones o una pasarela de pago— no necesitan todos la misma capa. Algunos sistemas pueden obtener una respuesta directamente del grafo de identidades y relaciones; otros necesitan que esta se refine aún más, a través del modelo de toma de decisiones adecuado, hasta convertirse en una puntuación en tiempo real diseñada para esa decisión concreta. Estos sistemas nunca necesitan saber cómo es el grafo subyacente.

La agrupación de identidades de los consumidores es el ejemplo más claro de esa plataforma en acción. Esas cuentas parecen pertenecer a personas distintas, pero en realidad son la misma persona. Esto es, concretamente, la resolución de identidades: determinar si dos cuentas corresponden a una misma persona, no solo si están relacionadas de alguna manera. En el fondo, el clúster de identidades evalúa la fiabilidad de cada señal que conecta dos cuentas y la improbabilidad de que dos personas diferentes la compartan por casualidad. Cuanto más improbable es una señal compartida, mayor peso tiene por sí sola; las señales más comunes o más fáciles de compartir solo tienen peso en combinación, cuando se suman varias de ellas. Dado que se ejecuta de forma continua contra el grafo de identidades de DoorDash, en lugar de como una tarea por lotes periódica, se puede comprobar en el momento en que se recibe un inicio de sesión, una compra o una solicitud de reembolso.

Una vez que existe ese grupo, la misma señal subyacente de identidad y relación —reutilizada en lugar de reconstruida— aparece en el resto del ámbito de la integridad. En los flujos de trabajo de asistencia, esa misma agrupación ayuda a distinguir un fallo real del servicio de una persona que presenta reclamaciones de aspecto similar en varias cuentas. En las promociones, determina la elegibilidad al distinguir entre un nuevo cliente y una persona que ya se ha beneficiado de una oferta bajo una identidad diferente. En la seguridad de las cuentas, señala un inicio de sesión con la contraseña correcta que no se comporta como lo haría el titular de la cuenta. Ampliándolo de una persona a muchas, una capa relacionada pero distinta —la inteligencia de relaciones, no la resolución de identidades— es la que pone de manifiesto los abusos coordinados; esto puede adoptar la forma de una red de cuentas que parecen independientes individualmente, pero que se observa que actúan como una única operación una vez mapeadas sus conexiones. En la mitigación de bots, distingue a un ser humano que trabaja superando obstáculos de un script que opera a gran escala. 

Ninguna de ellas necesitaba un nuevo tipo de señal, sino la misma de siempre, dirigida cada vez hacia una decisión diferente. Eso es lo que permite una plataforma compartida: un único sustrato, múltiples decisiones. Y una vez que existe esa plataforma, no tiene por qué limitarse a los identificadores directos.

La identidad es más que un identificador

Los identificadores directos eran, por supuesto, el punto de partida más obvio: el identificador de un dispositivo, un número de teléfono, una dirección de correo electrónico o una tarjeta registrada. Se trata de indicios muy fiables que son difíciles de falsificar y que, a menudo, bastan por sí solos para responder con seguridad a la pregunta «¿quién es este?». Sin embargo, un delincuente lo suficientemente decidido puede eludirlos utilizando un nuevo dispositivo, un nuevo número, una nueva dirección de correo electrónico o una nueva tarjeta, lo que hace que el rastro directo se pierda.

El comportamiento ayuda a salvar esa brecha. La forma en que una persona se mueve por una tienda online —el ritmo de sus acciones, sus patrones de navegación, sus acciones al finalizar la compra o sus interacciones con el servicio de atención al cliente— también proporciona una forma de identidad, que tiende a persistir incluso cuando se sustituyen los identificadores que la rodean. No sustituye a las señales directas, sino que constituye una capa complementaria para aquellos casos en los que las señales directas por sí solas no son suficientes.

Este cambio de perspectiva es importante porque modifica la definición de «la misma persona». Dos cuentas con dispositivos y métodos de pago completamente diferentes pueden seguir considerándose de la misma persona si se tiene en cuenta el comportamiento. Dos cuentas que, a juzgar por todos los identificadores directos, parecen no tener relación alguna, pueden seguir mereciendo un análisis más detallado si su comportamiento coincide demasiado como para ser una coincidencia.

El futuro de la inteligencia artificial en el ámbito de la identidad

La forma más clara de evaluar una plataforma como esta no radica en un único logro, sino en los clientes que ni siquiera se dan cuenta de que ha pasado algo, pero que, sin embargo, se benefician de una experiencia más ágil. La inteligencia de identidad elimina las dificultades que los clientes de buena fe se han visto obligados a soportar; un sistema más seguro, capaz de llegar más rápidamente a una conclusión sobre con quién está tratando, les libera de esa carga. 

Esta misma idea puede aplicarse a datos de entrada más complejos. Hoy en día, nuestras señales de comportamiento siguen basándose en gran medida en resúmenes numéricos. Sin embargo, los modelos de lenguaje a gran escala (LLM) y los modelos de IA generativa nos permitirán en el futuro extraer información de textos no estructurados, imágenes y conversaciones espontáneas con unos costes de desarrollo mucho menores que antes. 

A diferencia de lo que ocurre en los modelos tradicionales de redes neuronales, en los que hay que crear desde cero los subcomponentes de texto e imagen, ahora podemos utilizar puntos finales de IA generativa ya disponibles o aprovechar la capa de salida de modelos grandes preentrenados para generar características relacionadas con el texto o las imágenes, como el análisis de sentimiento en la descripción de incidencias o la comprobación de imágenes duplicadas. Además, podemos explorar arquitecturas de modelos basadas en transformadores para seleccionar incrustaciones de identidad de usuario que podrían revolucionar la forma en que definimos los clústeres en el grafo de identidad. En la arquitectura anterior, estas se presentan como dos rutas separadas (Figura 1): un LLM que extrae características directamente de las reclamaciones de formato libre, e incrustaciones de texto que se convierten en un nuevo tipo de arista en el grafo de identidad. 

Dicho esto, los mismos avances en IA que facilitan la creación de una señal de identidad fiable también facilitan su falsificación mediante un comportamiento sintético más convincente, variaciones automatizadas entre cuentas o una respuesta adversaria más rápida a nuestras nuevas políticas. Tratar la identidad como una plataforma, en lugar de como un mosaico de comprobaciones puntuales, permite mantenerse al día ofreciendo un único lugar en el que integrar un nuevo tipo de señal, en lugar de depender de una docena de sistemas independientes que esperan su turno para ponerse al día.

En definitiva, nuestro objetivo es reducir el número de soluciones de identidad personalizadas y puntuales mediante el desarrollo de una base coherente de identidad y relaciones que dé respuesta a todos los puntos de decisión que lo requieran.

Manténgase informado con Actualizaciones

Suscríbase a nuestro blog de ingeniería para estar al día de todos los los proyectos más interesantes en los que trabaja nuestro equipo
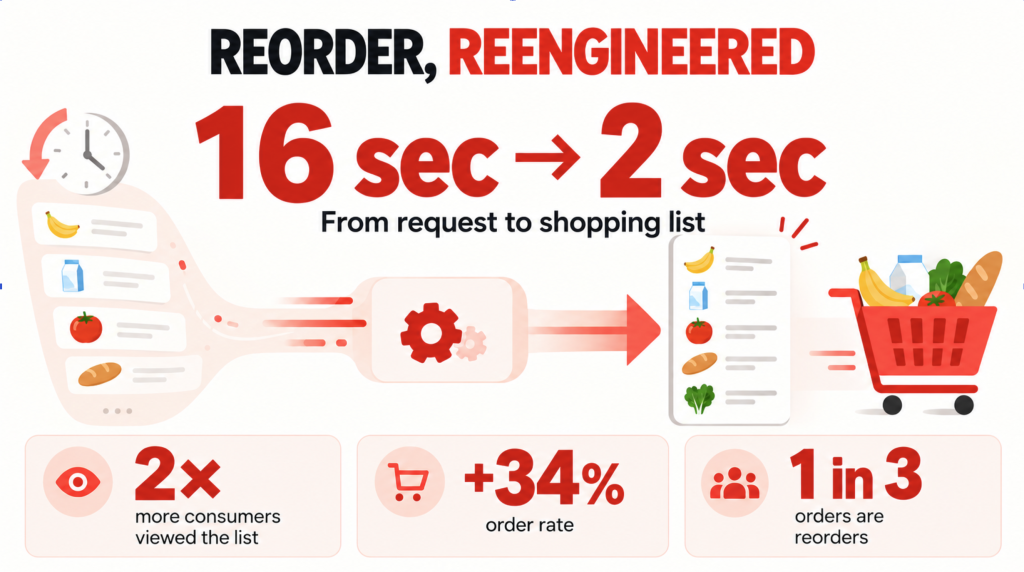
Cuando un consumidor le pide a Ask DoorDash que«vuelva a pedir lo de siempre», la solicitud parece sencilla. DoorDash ya dispone de su historial de pedidos; ¿por qué no recuperar los productos que compra con más frecuencia e incluirlos en una lista de la compra?

La repetición de pedidos es uno de nuestros casos de uso más populares, ya que representa aproximadamente uno de cada tres pedidos. Sin embargo, la ruta de ejecución original podía tardar decenas de segundos en generar una lista. Al adelantar el razonamiento histórico estable antes de la solicitud y utilizar una ejecución determinista en la que el producto ya conoce la intención del consumidor, redujimos la duración de una ruta de repetición de pedidos de unos 16 segundos a unos 2 segundos y duplicamos la tasa de visualización de la lista resultante por parte de los consumidores. 

Trasladar el razonamiento histórico fuera de línea también alivió la restricción de latencia en la generación, lo que nos permitió utilizar modelos más potentes para producir resultados de mayor calidad. Esa mejora se tradujo en un aumento de aproximadamente el 34 % en la tasa de pedidos del flujo.

El reto radica en que agilizar la repetición de pedidos no puede limitarse a reproducir el historial. El historial de pedidos recoge lo que alguien ha comprado, no lo que necesita a continuación.

La leche que se compra una vez a la semana es probablemente una necesidad recurrente. Sin embargo, puede que no lo sea un paquete grande de papel de cocina que se compra con más o menos la misma frecuencia. Comprar seis unidades en una sola entrega es algo distinto a comprar una unidad repartida en seis entregas. Un yogur que un consumidor compra repetidamente puede ser un producto básico; comprar tres sabores, uno de cada uno, puede ser una forma de probar cosas nuevas.

Por lo tanto, responder a«comprar lo de siempre»requiere evaluar el comportamiento anterior. Al mismo tiempo, la respuesta final debe basarse en un catálogo que cambia constantemente: los artículos se agotan, las fichas de producto cambian y es posible que el producto exacto que un consumidor compró anteriormente no esté disponible en la tienda en la que está comprando hoy.

En una solicitud típica de reposición de forma libre, el agente de Grocery carga la habilidad de reposición, recupera el contexto del consumidor y el historial de pedidos necesarios para la solicitud, decide qué compras anteriores deben incluirse en la próxima cesta, resuelve esas necesidades en función del catálogo actual y elabora la lista de la compra. Esta flexibilidad permite que el mismo flujo gestione una amplia variedad de solicitudes de reposición, al tiempo que integra varias partes diferentes del sistema Ask DoorDash para generar una lista de la compra aparentemente sencilla.

En entradas anteriores de esta serie se han tratado, una por una, la inteligencia, la evaluación, la plataforma y la experiencia del usuario. El reordenamiento es el proceso en el que los cuatro aspectos deben coincidir a la vez: la lista debe ser personalizada, verificable, rápida y permitir la compra. En esta entrada se sigue el recorrido de una única solicitud a través de cada uno de ellos.

«Reordenar» es más que «reproducir»

Ask DoorDash admite diversas solicitudes de repetición de pedidos. Un usuario puede escribir«¿Qué productos de alimentación suelo comprar?»,«Repetir mi pedido habitual»,«¿Qué leche compré la última vez?» o«Repetir mi pedido habitual, pero más barato».

Estas solicitudes parecen similares, pero en el fondo requieren decisiones diferentes. Buscar un producto del último pedido no es lo mismo que decidir qué compras constituyen los productos habituales de un consumidor; solicitar versiones más baratas añade otra serie de restricciones.

Según la arquitectura multiagente de DoorDash, descrita en nuestra descripción general de ingeniería, una solicitud de compra de comestibles se deriva en primer lugar al agente «Grocery». Cuando la solicitud implica una reposición, el agente puede activar la habilidad «Reorder».

La habilidad «Reordenar» proporciona al agente instrucciones específicas para gestionar estas solicitudes utilizando el contexto y las herramientas de que dispone. En lugar de definir un flujo de trabajo independiente para cada posible formulación, ofrece al agente un proceso general para determinar qué requiere la solicitud y convertir el resultado en una lista de la compra práctica.

Desde un punto de vista conceptual, ese proceso consta de cinco fases:

  1. Establecer el contexto. Determinar en qué tienda se va a comprar cuando aún no se sabe cuál es y obtener información relevante sobre el consumidor.
  2. Recuperar el historial. Leer el historial de pedidos de la tienda de alimentación necesario para la solicitud y adaptarlo a un formato que el modelo pueda procesar.
  3. Selecciona lo que importa. Decide qué partes de ese historial responden a la solicitud del consumidor. En el caso delos «clientes habituales», esto significa distinguir las necesidades recurrentes de las compras puntuales.
  4. Identificar productos. Realizar una búsqueda en el catálogo actual de DoorDash, conservando, siempre que sea posible, detalles como la marca, la talla y la variante.
  5. Elabora el resultado. Plantea al consumidor una pregunta aclaratoria cuando quede una opción realmente ambigua y, a continuación, crea el documento editable de la lista de la compra.

Otras habilidades pueden integrarse en ese proceso. Si un cliente pide lo de siempre «pero más barato», por ejemplo, la habilidad «Reorder» puede determinar lo que suele necesitar, mientras que el razonamiento sobre la asequibilidad tiene en cuenta los productos y precios disponibles en ese momento.

Esta flexibilidad es importante para el lenguaje de forma libre. Un usuario que escribe en Ask no ha seleccionado una operación de la API; ha expresado una intención, y el agente tiene que determinar qué acción requiere dicha intención.

Cada una de esas cinco etapas da por sentado algo que la herramienta no tiene en cuenta. En qué tienda comprar, qué marca preferir, si este consumidor siquiera quiere aceite de oliva esta semana… Nada de eso es un dato sobre la repetición de la compra. Es un dato sobre el consumidor.

Inteligencia: lo que el agente ya sabe sobre ti 

El historial de pedidos nos indica qué ha comprado un consumidor, pero no nos dice cómo interpretar cada compra. Tal y como se describe en «Creación de Ask DoorDash (Parte 2): Inteligencia», Ask DoorDash puede aportar contexto —como preferencias de tiendas, afinidades con marcas, preferencias alimentarias y el estado de la despensa— a partir de la memoria a largo plazo, la memoria conversacional y la memoria de sesión.

En el caso de los pedidos recurrentes, esas señales no constituyen otra fuente de productos. Ayudan a interpretar el historial de compras del consumidor. Si alguien compra siempre una misma marca de leche, por ejemplo, esa preferencia debería reflejarse en la lista resultante. Si recientemente ha indicado a Ask que tiene suficiente aceite de oliva, ese contexto puede hacer que el aceite de oliva no se incluya en su próximo pedido recurrente, aunque aparezca con frecuencia en su historial.

Esto es importante porque los consumidores ya saben cuáles son sus«productos habituales». Las pequeñas discrepancias en la tienda, la marca o el estado de la despensa se perciben de inmediato y pueden minar rápidamente la confianza en el resto de la lista.

Por lo tanto, la inteligencia ofrece a la habilidad «Reordenar» un mejor punto de partida, pero no responde a la pregunta fundamental: ¿qué compras del historial del consumidor se consideran realmente necesidades recurrentes? Esa decisión aún debe tomarse —y evaluarse de forma coherente—.

Evaluación: Comprobar si la lista es correcta

Necesitábamos una forma de evaluar la decisiónsobre los «productos habituales» antes de que llegara al consumidor. Tal y como se describe en «Creación de Ask DoorDash (Parte 3): Evaluación», la evaluación del agente tiene en cuenta tanto la ruta de ejecución como el resultado. En el caso de los pedidos recurrentes, esto significa comprobar si el agente ha recuperado el contexto y el historial correctos, si ha seguido el flujo previsto y si ha generado una lista de la compra útil, así como si los artículos de dicha lista reflejan realmente las necesidades recurrentes del consumidor.

Esos controles de selección son concretos. Si un consumidor pide repetidamente tres yogures, ¿la lista conserva ese patrón y esa cantidad? ¿Un producto que solo ha aparecido una vez queda excluido de sus«productos habituales»? Si el consumidor ha indicado que ya tiene algo en casa, ¿se refleja eso en el resultado?

Dado que el historial de pedidos en tiempo real cambia con el tiempo, utilizamos el simulador de conversaciones basado en plantillas para reproducir escenarios de repetición de pedidos a partir de un historial de compras fijo. A continuación, unas rúbricas tipo lista de comprobación nos permiten evaluar los artículos recurrentes, las compras puntuales, las cantidades y las preferencias conocidas, comparando los resultados con los mismos datos de referencia a medida que se producen cambios en la implementación.

Una lista correcta solo resulta útil si llega mientras el consumidor todavía está comprando. Nuestro proceso original tardaba unos 16 segundos.

Plataforma: No hace falta que tomes la decisión mientras esperas 

Esa latencia se debía, en parte, a la forma en que Ask DoorDash gestiona las solicitudes de los agentes. Tal y como se describe en «Building Ask DoorDash (Parte 4): Una plataforma para crear y desarrollar agentes», en un solo turno de un consumidor, el modelo puede tomar una decisión, invocar una herramienta, examinar el resultado y utilizar esa información para decidir qué hacer a continuación. En un flujo representativo de la sección de alimentación, esto puede requerir entre 6 y 8 llamadas a modelos de lenguaje grande (LLM), además de varias llamadas a herramientas.

Esa flexibilidad es importante cuando cada paso depende de la información obtenida durante la solicitud. Sin embargo, el reordenamiento nos reveló que varios de esos pasos se basaban en datos históricos que cambian lentamente.

Los consumidores suelen acudir siempre a un número relativamente reducido de tiendas de alimentación. En lugar de seleccionar una tienda, consultar su historial de pedidos y determinar las necesidades recurrentes del consumidor en cada solicitud, podemos realizar ese trabajo con antelación utilizando datos históricos.

El resto del proceso debe seguir activo. El stock y los precios varían, los productos pueden agotarse y los artículos del catálogo pueden cambiar entre una visita y otra.

Eso nos proporcionó un límite natural: calcular previamente las tiendas más probables para el consumidor y sus necesidades recurrentes; a continuación, utilizar la ruta de solicitud en tiempo real para satisfacer esas necesidades en función del catálogo actual y elaborar la lista de la compra.

Esa división se convirtió en la base de nuestro proceso de transición de lo offline a lo online.

Figura 1: Ask DoorDash asigna cada solicitud de repetición de pedido a una ruta de ejecución en función del ámbito de aplicación correspondiente. En el caso de «repetir mi último carrito», un ámbito de sesión tipado permite que un complemento de backend recupere el carrito anterior sin necesidad de utilizar el modelo para la selección de herramientas. Para las compras recurrentes, un proceso diario combina 90 días de historial de pedidos con señales del perfil relevantes para la tarea, selecciona a los consumidores con pruebas suficientes, ejecuta una inferencia LLM por lotes y valida el resultado en un paquete reutilizable de productos habituales. «Volver a pedir mis productos habituales» lee ese paquete directamente, mientras que «volver a pedir mis productos habituales, pero más baratos» lo complementa con precios actuales, promociones, tamaños de envase, stock y restricciones del consumidor. Las tres vías convergen en la resolución del catálogo en tiempo real, que prueba primero el ID del artículo de la tienda, luego el ID del producto del catálogo y, por último, un término de búsqueda antes de crear una lista de la compra editable. El agente de Grocery permanece disponible para aclarar opciones ambiguas, explicar sustituciones y solucionar resultados que faltan o que no se pueden utilizar.

Generar los habituales antes de que el consumidor las pida. 

Selección de cohortes y materialización de entradas

No todos los historiales de pedidos contienen datos suficientes para deducir necesidades recurrentes. Una sola entrega de la compra nos indica lo que un consumidor compró en una ocasión concreta, pero no si alguno de esos artículos es de primera necesidad. Por lo tanto, aplicar este proceso a todos los consumidores supondría un coste adicional y generaría resultados de poca fiabilidad.

Consideramos la selección de cohortes tanto como un filtro de calidad como un mecanismo de control de costes. Una tarea diaria de Spark identifica a los consumidores con suficiente actividad reciente en la compra de alimentación o en tiendas minoristas como para justificar la generación de datos.

Para cada consumidor seleccionado, preparamos dos datos de entrada: un perfil conciso que recoge las señales a largo plazo más relevantes para la repetición de pedidos, como los intereses por categorías de artículos y las afinidades con las marcas, y el historial de pedidos a nivel de artículo de los últimos 90 días.

Ambos tienen finalidades distintas. El perfil ofrece información sobre el consumidor; el historial de pedidos aporta los datos concretos necesarios para deducir necesidades recurrentes. La preferencia por una marca puede indicarnos qué yogur es probable que quiera un consumidor, por ejemplo, mientras que el historial de compras nos indica si el yogur forma parte de sus compras habituales.

Siguiendo el enfoque de recorte de contexto específico para cada tarea que desarrollamos en nuestro trabajo sobre modelos de lenguaje a gran escala (LLM) fuera de línea para la personalización en línea, enviamos únicamente las señales del perfil relevantes para esta tarea, en lugar del perfil completo del consumidor. Esto reduce el coste de la entrada y evita que el contexto no relevante compita con los datos de compra en los que se basa la decisión.

Cómo definir«tus productos habituales»

Elaborar una lista ordenada es sencillo una vez que se ha definido lo que se entiende por«habitual». Lo difícil fue definirlo.

La frecuencia es un punto de referencia razonable, pero indica lo que un consumidor ha comprado con más asiduidad, en lugar de lo que es probable que vuelva a necesitar. La leche y un paquete grande de papel de cocina pueden aparecer en el mismo número de pedidos, aunque tengan patrones de reposición muy diferentes. Seis botellas en una sola entrega también son una prueba menos sólida de un hábito recurrente que una botella comprada en seis entregas distintas. La recencia por sí sola tampoco resuelve la ambigüedad.

Utilizamos un modelo de lenguaje grande (LLM) porque estas señales interactúan de formas que resultan difíciles de plasmar en una única regla de clasificación. El modelo sigue un orden cualitativo explícito: la frecuencia en entregas distintas es la señal principal de una necesidad recurrente; la actualidad indica si esa necesidad sigue vigente; y las características de reposición ayudan a distinguir los productos de consumo rápido de los duraderos. La afinidad con la marca puede refinar la elección, pero no prevalece sobre la evidencia directa de compra.

El stock disponible añade otra variable. Un paquete múltiple de un producto duradero comprado recientemente puede bajar en la lista, mientras que un producto perecedero que aparecía habitualmente en el pasado pero que no se ha comprado últimamente puede subir.

Recopilar la decisión en un expediente

El modelo aplica ese razonamiento de forma independiente para cada tienda relevante y devuelve los artículos recurrentes que identifica. El número máximo de artículos es un límite máximo, no un objetivo: si los datos solo respaldan un puñado de artículos habituales, el modelo devuelve el conjunto más reducido en lugar de completar la lista con suposiciones menos fundadas. Si el historial no respalda un conjunto útil, puede abstenerse por completo.

El resultado se limita a la información procedente de los datos de entrada. Los identificadores de tienda y de artículo deben proceder del historial del consumidor; se dan prioridad a las compras recurrentes frente a las puntuales, y las variantes casi idénticas se agrupan en lugar de ocupar varias posiciones en el lote. Para cada artículo, conservamos datos como la frecuencia de compra, la recencia y la cantidad habitual, de modo que el resultado pueda ofrecerse sin necesidad de volver a realizar el razonamiento histórico en tiempo real.

Indica la necesidad, no el SKU

Un artículo bien posicionado sigue siendo inutilizable si el catálogo cambia antes de que el consumidor vuelva. Es posible que ese mismo artículo vuelva a aparecer bajo un nuevo identificador específico del comerciante o que desaparezca por completo. Conservar únicamente el identificador histórico del artículo en la tienda haría que el paquete fuera inestable; conservar únicamente un término genérico como «leche de avena» supondría perder la especificidad de lo que el consumidor compra realmente.

Por lo tanto, representamos cada necesidad en tres niveles: el identificador del artículo de la tienda para la coincidencia más precisa, un identificador de producto a nivel de catálogo para el mismo producto subyacente en todas las fichas de producto, y un término de búsqueda genérico como alternativa. En el momento de la solicitud, la ruta de servicio los prueba de más específico a más general y se detiene en el primer producto actual que cumple los requisitos.

Esa jerarquía refleja claramente la distinción entre el canal físico y el canal online. El modelo físico decide qué necesidad, según el historial del consumidor, merece la pena tener en cuenta; el sistema online decide qué producto puede satisfacer esa necesidad en ese mismo momento.

Antes de que se publique un paquete, la validación determinista se sitúa entre la generación del modelo y el contrato de servicio. Distingue una abstención explícita de una salida mal formada, elimina los identificadores inutilizables, normaliza las cantidades y filtra los resultados que no cumplen los requisitos para constituir un paquete útil. El modelo toma la decisión semántica; el código determinista decide si el resultado es seguro para su publicación.

Generación y suministro a gran escala

La generación de estos paquetes para un gran grupo de usuarios requiere un sistema por lotes capaz de tolerar fallos parciales. Utilizamos una infraestructura de Metaflow fragmentada para que los lotes puedan ejecutarse de forma independiente y los fragmentos que hayan fallado puedan volver a intentarse sin descartar el trabajo realizado con éxito.

Tras la validación, los paquetes resultantes se publican en un almacén de clave-valor de baja latencia. A continuación, la ruta de servicio puede recuperar el paquete de un consumidor para un almacén determinado sin repetir el razonamiento histórico, mientras que los paquetes que faltan o que no se pueden utilizar dan lugar a una respuesta vacía, en lugar de provocar un fallo en el turno de Grocery.

Dado que el paquete se genera independientemente de Ask, la misma señal también puede utilizarse para otras interfaces personalizadas sin necesidad de repetir la inferencia.

Nada de esto es visible para el consumidor. Lo que ve es una lista de la compra y, dependiendo de cómo haya accedido al proceso, puede verla en unos dos segundos.

Experiencia de usuario: una lista, varias formas de acceder a ella

Un consumidor no siempre llega a la opción de «volver a pedir» por el mismo camino. Puede que escriba«volver a pedir lo de siempre»directamente en Ask, o puede que acceda a través de una interfaz contextual en la que DoorDash ya tenga cierta información sobre lo que está intentando hacer.

Esa distinción es importante porque el contexto que aporta la experiencia puede eliminar trabajo de la conversación. Tal y como se describe en «Building Ask DoorDash (Parte 5): Una interfaz basada en el contexto para los agentes de compras», el cliente asocia un ámbito a una solicitud, que incluye información como el tema y la tienda desde la que ha accedido el consumidor. El sistema puede utilizar ese contexto en lugar de pedir al consumidor que repita información que el producto ya conoce.

En el caso de una solicitud de formato libre como«volver a pedir mis productos habituales», el agente de Grocery sigue interpretando la solicitud a través de la habilidad «Reorder». Sin embargo, cuando un consumidor accede a través de una acción específicadenominada «Volver a pedir mis productos habituales», el producto ya ha establecido la intención. Tal y como se muestra a continuación, adjuntamos un ámbito preestablecido que es invisible para el consumidor y dirigimos la solicitud a través de una ruta determinista.

Si se combina con el paquete precalculado de la sección «Plataforma», esto reduce el trabajo en tiempo real a la recuperación del paquete y la resolución de sus elementos en función del catálogo actual. La ruta ya no necesita que el modelo de lenguaje grande (LLM) interprete la solicitud ni reconstruya los productos habituales del consumidor a partir del historial, lo que reduce la latencia de unos 16 segundos a unos 2 segundos.

Tanto si el consumidor accede a través de un texto libre como de un punto de entrada contextual, el resultado es el mismo: una lista de la compra estructurada. A partir de ahí, puede modificar las cantidades, eliminar algo que ya tiene, cambiar un producto o añadir la lista completa a su carrito. Esas modificaciones estructuradas se realizan directamente en la lista, sin necesidad de realizar otra ronda de intercambio de datos con el modelo de lenguaje grande (LLM).

El agente sigue estando disponible cuando la solicitud requiere un mayor criterio. Un consumidor puede pedir, por ejemplo,«lo de siempre, pero más barato», y el agente puede partir de esas mismas necesidades recurrentes mientras evalúa los precios actuales y las alternativas.

Los distintos puntos de acceso pueden generar volúmenes de trabajo muy diferentes en segundo plano, aunque todos ellos converjan en una experiencia de reordenación continua.

Conclusión

«Volver a pedir lo de siempre»parece una petición sencilla, pero para que resulte útil hay que tomar las decisiones adecuadas en cada momento. El contexto del consumidor ayuda a interpretar el historial de compras; las necesidades recurrentes se pueden calcular con antelación; el stock, los precios y la resolución del catálogo se mantienen actualizados en tiempo real; y los puntos de entrada contextuales pueden eliminar el trabajo que el producto ya ha realizado.

La lección general es que mejorar un agente no siempre significa pedirle al modelo que haga más cosas. Significa decidir sobre qué se debe razonar en el momento de la solicitud, qué se puede saber de antemano y qué debe ser determinista.

Cuando esos límites están bien definidos, la complejidad desaparece para el consumidor. Le piden a DoorDash que les vuelva a pedir sus productos habituales y reciben una lista que les parece personalizada, actualizada y lista para comprar.

Manténgase informado con Actualizaciones

Suscríbase a nuestro blog de ingeniería para estar al día de todos los los proyectos más interesantes en los que trabaja nuestro equipo

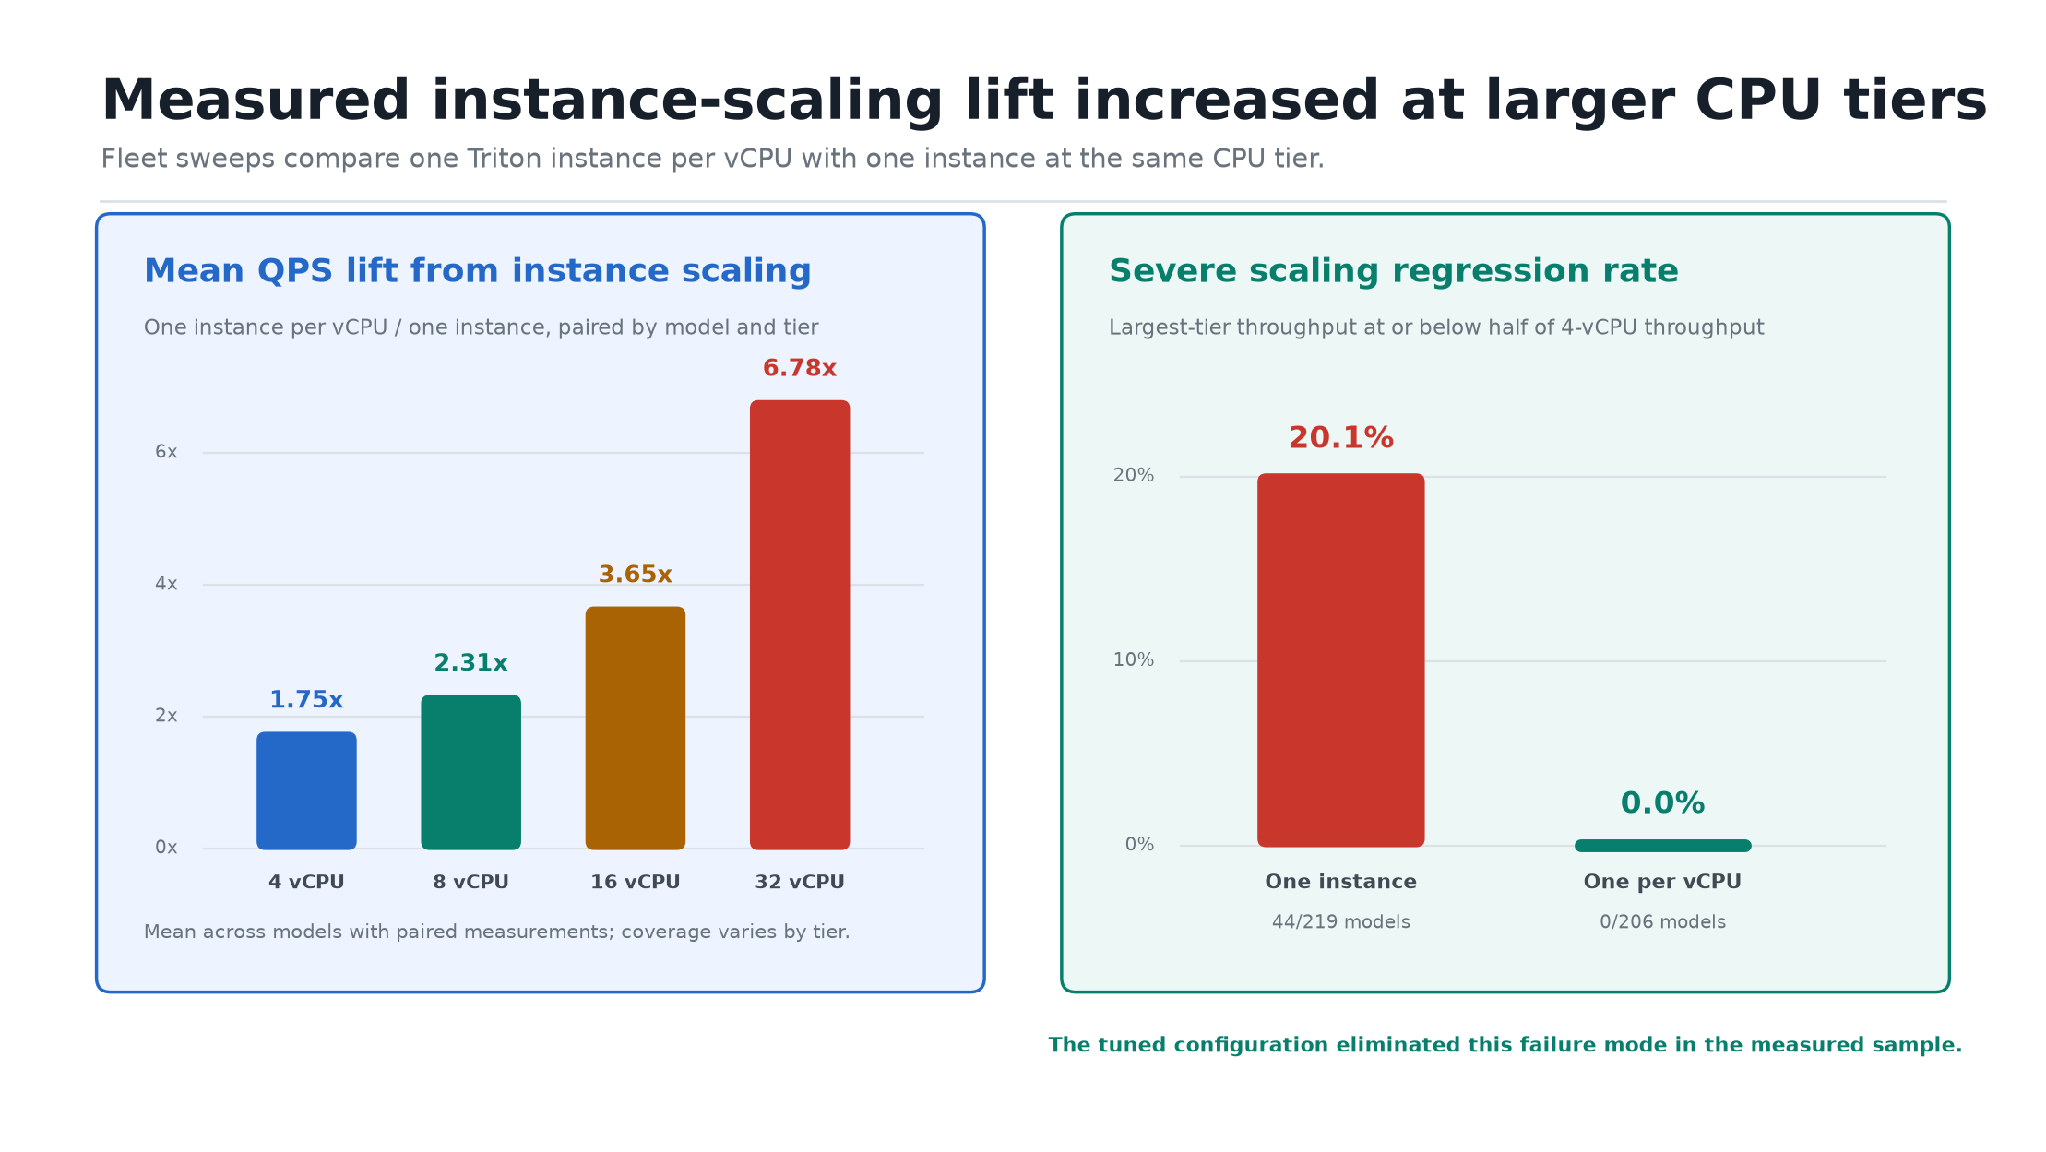
Cómo una flota de referencia reutilizable permitió cuantificar la configuración de Triton en cientos de modelos de producción y de simulación, con un aumento medio de QPS que pasó de 1,75 veces con 4 vCPU a 6,78 veces con 32 vCPU.

Primera parte de una serie de varias entregas. En esta entrega se tratan los modelos de Triton basados en CPU. En una próxima entrada explicaremos cómo estamos ampliando el sistema para incluir la inferencia mediante GPU.

En un modelo de producción, el mismo artefacto, ejecutado en el mismo pod de 32 vCPU, ofrecía 68 QPS u 863 QPS, dependiendo únicamente de su configuración de servicio. Tras el ajuste, la latencia p99 se redujo de 126 ms a 14 ms y la utilización de la CPU bajó del 67 % al 16 %.

1,75-6,78xAumento medio de QPS gracias al escalado de instancias, por nivel de CPUCientosmodelos de producción y de sombra compatibles20,1 % frente a 0 %tasa de regresión grave: un caso frente a uno por vCPU252ranuras reutilizables para cápsulas de referencia

Cuando una mayor potencia de la CPU ralentizaba los modelos

En DoorDash, los modelos de PyTorch se ejecutan en el servidor de inferencia NVIDIA Triton en distintos casos de uso, como la búsqueda, la clasificación, la asignación de pedidos, la detección de fraudes y la publicidad. Cada modelo cuenta con varias opciones de servicio: arquitectura de CPU, tamaño del pod, número de instancias de Triton, número de subprocesos OpenMP y concurrencia de solicitudes. Una configuración predeterminada adecuada para un modelo puede suponer un desperdicio de capacidad o incumplir los objetivos de latencia de otro. 

El análisis actualizado incluyó 264 modelos con datos de barrido válidos. Entre los modelos con resultados comparables en una sola instancia, 44 de los 219 vieron reducido su rendimiento a la mitad o menos de su rendimiento con 4 vCPU en el nivel de barrido más alto. Entre los 206 modelos con resultados comparables de una instancia por vCPU, ninguno experimentó esta reducción. 

El error fue considerar el tamaño del pod como el factor principal a la hora de determinar el rendimiento. En la práctica, el tamaño del pod influye en el número de instancias del modelo Triton y en el número de subprocesos que utiliza cada instancia. Un mayor número de núcleos puede generar más conflictos si esos parámetros no están coordinados. 

¿Qué configuración completa de servidores ofrece el rendimiento y la latencia necesarios con el menor coste de recursos?

Responder a esa pregunta para un solo modelo es un punto de referencia. Responderla de forma coherente para cientos de modelos requiere un sistema. 

Un sistema de afinación reutilizable

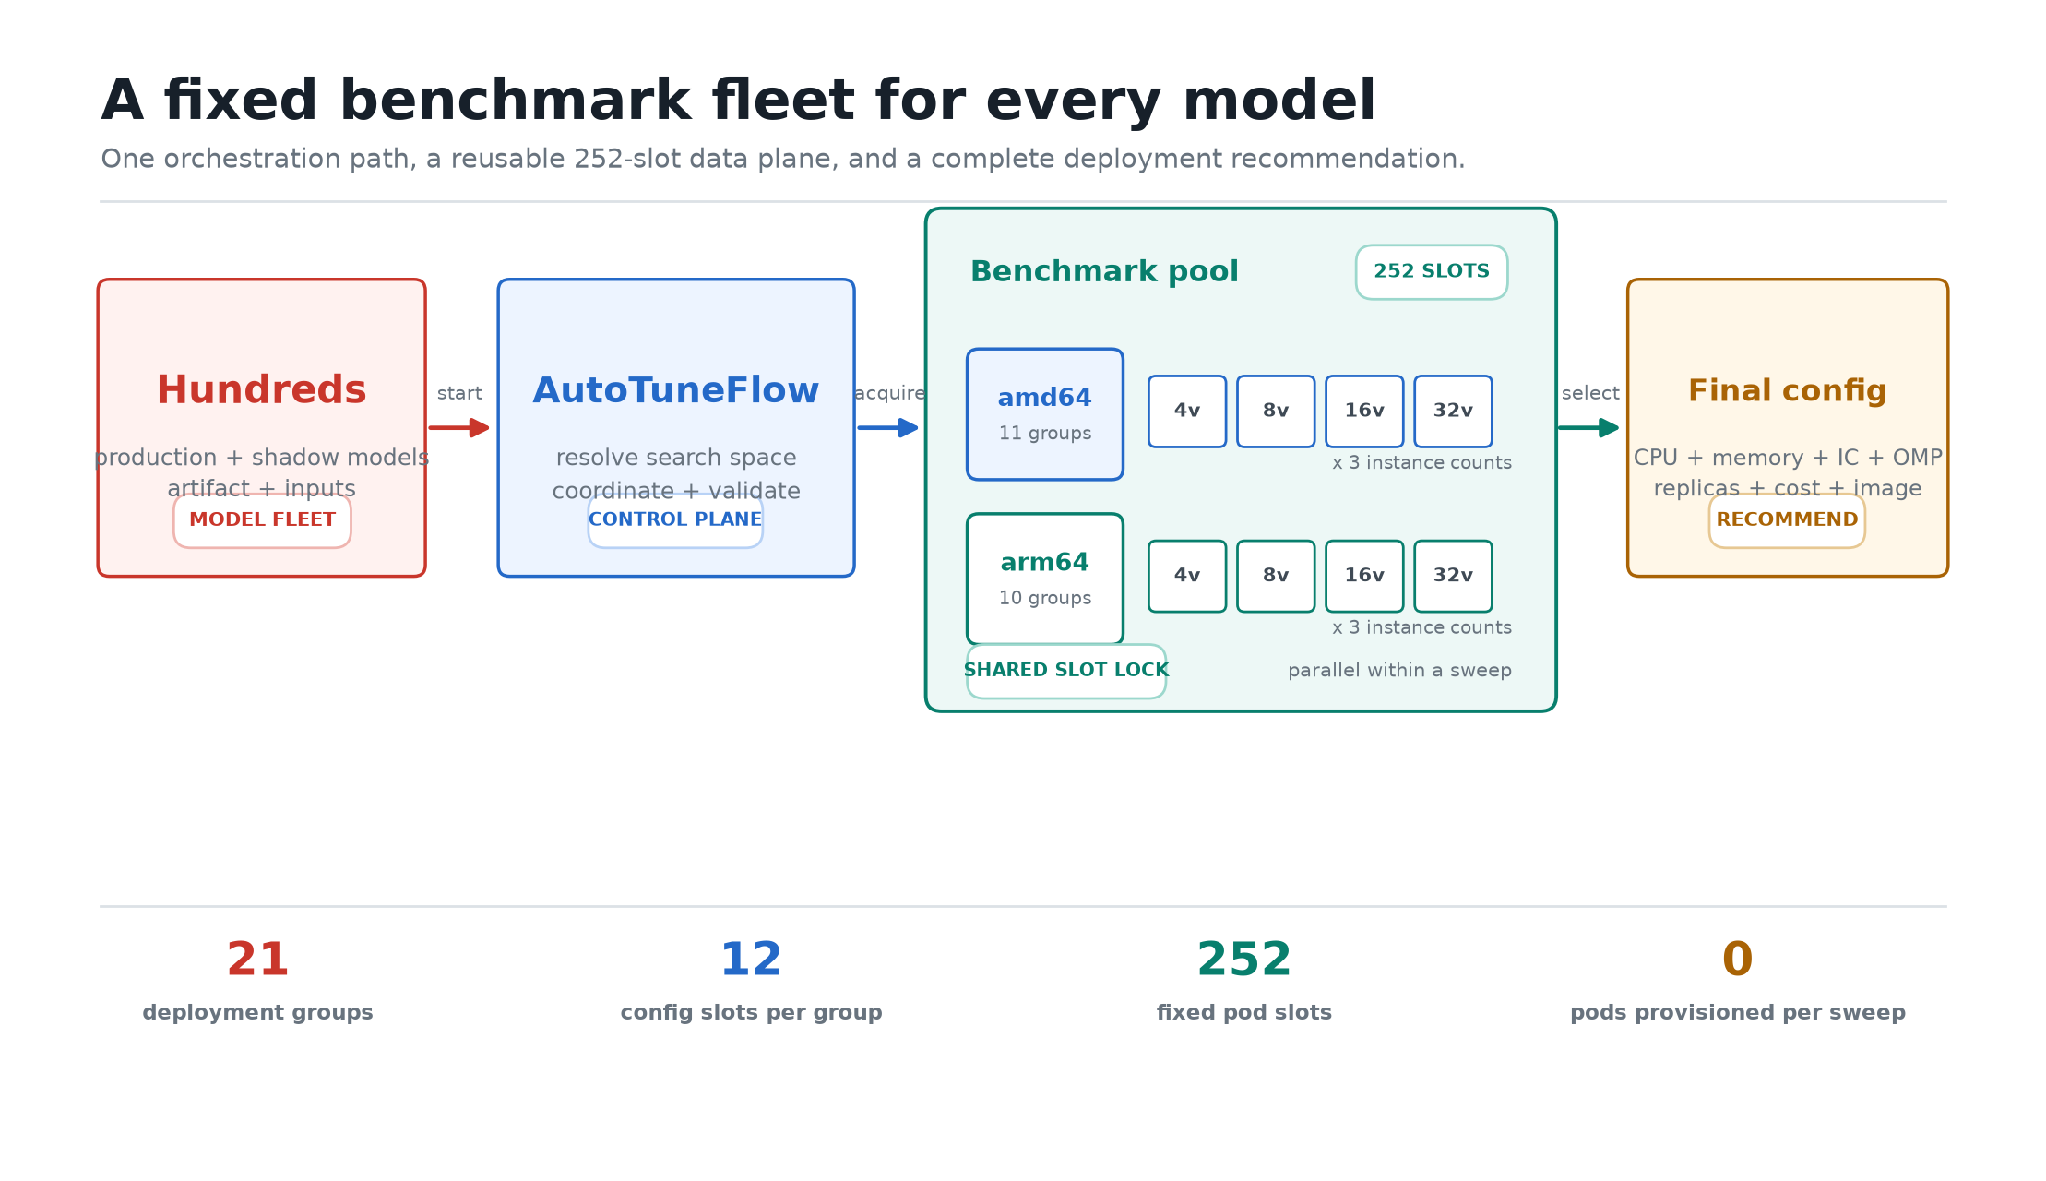
Hemos creado una plataforma de ajuste automático que compara los artefactos de los modelos de producción y las entradas representativas con una matriz de configuraciones controlada, y a continuación selecciona la configuración de menor coste que cumple los requisitos de latencia y capacidad del modelo. 

  1. Orquestación
    Un AutoTuneFlow determina el artefacto del modelo, las entradas representativas, el tráfico de producción, el objetivo de latencia y la matriz de configuraciones candidatas. 
  2. Medición
    Un conjunto de pruebas de referencia compartido ejecuta las candidatas en el mismo entorno de ejecución de Triton que se utiliza en producción y registra el rendimiento, la latencia y la utilización de la CPU en cgroups. 
  3. Selección
    El flujo descarta a los candidatos que no cumplen los límites de latencia o de CPU, combina las mediciones de capacidad restantes con el QPS de producción y emite modificaciones de implementación. 

Los equipos de modelos no necesitan comprender el funcionamiento del conjunto de referencias, y la capa de medición no necesita conocer el contexto empresarial que subyace al objetivo de latencia de un modelo. La capa de orquestación integra esos aspectos en una recomendación lista para su implementación en producción. 

El plano de datos de referencia contiene 252 ranuras de pod preasignadas repartidas en 21 grupos de implementación en amd64 y arm64.

Un conjunto fijo en lugar de una infraestructura por modelo

Cada grupo de implementación contiene 12 ranuras dedicadas que abarcan cuatro niveles de CPU (4, 8, 16 y 32 vCPU) y tres recuentos de instancias Triton para cada nivel. Una ejecución adjudica un grupo disponible y ejecuta las combinaciones de nivel y recuento de instancias en paralelo. Diferentes modelos pueden utilizar distintos grupos de implementación al mismo tiempo. 

Un bloqueo respaldado por S3 coordina el acceso. Si un grupo está ocupado o no funciona correctamente, el orquestador pasa a otro grupo disponible. Esto nos proporciona dos tipos de paralelismo: los candidatos se ejecutan simultáneamente dentro de una pasada, y se pueden ajustar varios modelos al mismo tiempo en toda la flota compartida. 

El conjunto fijo de 252 ranuras permite realizar ajustes en cientos de modelos de producción y de prueba. Al aumentar el número de modelos, se incrementa la utilización de la plataforma, pero no la infraestructura necesaria para cada ejecución individual. 

Prueba de rendimiento con perf_analyzer de NVIDIA

Cada pod de pruebas invoca el «perf_analyzer» de NVIDIA a través de un pequeño modelo de pruebas que se ejecuta junto con el modelo de destino. «perf_analyzer» envía solicitudes gRPC asíncronas a través de localhost en cada nivel de concurrencia solicitado, mientras que el ejecutor registra el rendimiento y la latencia y lee los contadores de CPU del cgroup del pod. Esto genera una medición coherente de QPS, la latencia p99 y la misma señal de CPU que detecta el HPA de Kubernetes. 

El ejecutor «in-pod» combina la generación de tráfico, las mediciones del modelo y la utilización de la CPU del cgroup en un único resultado para cada configuración candidata.

Reconfigurar Triton sin reiniciar los pods

Los pods de referencia ejecutan Triton en modo de control de modelo explícito. Para cada candidato, el optimizador carga el modelo de destino a través de la API de control de modelos de Triton y pasa la configuración ModelConfig del candidato como una sustitución. A continuación, puede descargar el modelo y reutilizar el pod para la siguiente pasada. 

Este ciclo de vida evita tener que editar el S3, el retraso en la consulta del repositorio o el reinicio del pod para cada candidato. Una sola medición sigue la misma secuencia: 

  1. Selecciona un grupo de referencia.
  2. Carga el ejecutor de pruebas de rendimiento y el modelo de destino.
  3. Valida los datos de entrada y calienta el modelo.
  4. Ejecuta perf_analyzer en distintos niveles de concurrencia.
  5. Registra las mediciones de QPS, latencia y CPU.
  6. Descarga el modelo y desactiva el grupo.
Cada nivel y cada ranura de número de instancias siguen este ciclo de vida en paralelo. Los resultados vuelven al mismo flujo para la configuración y la selección de costes.

El número exacto de mediciones depende de las arquitecturas de la CPU, los niveles de servicio, el número de instancias, el tamaño de los lotes y los niveles de concurrencia solicitados. Dado que las combinaciones más costosas de niveles de servicio y número de instancias se ejecutan en paralelo, ampliar la matriz de búsqueda no se traduce directamente en tiempo real. 

Por qué un cambio en la configuración afectó tanto al rendimiento

La inferencia en CPU de PyTorch presenta dos formas de paralelismo. Triton puede ejecutar varias copias de un modelo en paralelo, mientras que cada copia puede utilizar varios hilos de OpenMP dentro de una inferencia. Estos controles resultan útiles por separado, pero deben ajustarse de forma conjunta. 

El patrón predeterminado en un pod de N núcleos suele ser una instancia de Triton que utiliza N subprocesos. Para muchos de nuestros modelos, un patrón más adecuado era utilizar N instancias de un solo subproceso: 

instance_group.count = vCPU
OMP_NUM_THREADS = 1
OMP_DYNAMIC = FALSE
INTRA_OP_THREAD_COUNT = 1

De este modo, un único trabajador de inferencia con un gran número de subprocesos se convierte en varios trabajadores independientes. Además, se evita el peor de los casos, en el que varias instancias de Triton crean cada una un grupo de subprocesos completo y compiten por los mismos núcleos. 

Por lo tanto, el optimizador considera el número de instancias y el número de subprocesos como una única decisión de configuración. En general, mantiene: 

instance_group.count × OMP_NUM_THREADS ≈ vCPU

La elección entre más instancias y más subprocesos sigue dependiendo del modelo, por lo que la evaluamos en cada caso en lugar de establecer una respuesta única para toda la flota. 

ConfiguraciónQPSlatencia p99CPU
1 instancia, 32 subprocesos68126 ms67%
32 instancias, 1 hilo cada una86314 ms16%

A lo largo del análisis actualizado, al comparar una instancia de Triton por vCPU con una única instancia del mismo nivel, se obtuvieron aumentos medios de QPS sin procesar de 1,75 veces con 4 vCPU, 2,31 veces con 8 vCPU, 3,65 veces con 16 vCPU y 6,78 veces con 32 vCPU. El artefacto del modelo y el nivel de hardware se mantuvieron iguales; solo cambió la configuración de servicio. 

La mejora en la configuración observada aumentó a medida que aumentaba el tamaño del pod. Se produjeron fuertes caídas en el rendimiento en 44 de los 219 resultados comparables con una sola instancia, mientras que no se produjo ninguna en los 206 resultados con una instancia por vCPU.

La documentación de PyTorch sobre subprocesos en la CPU describe con más detalle la interacción entre el paralelismo interoperativo y el intraprocesal. 

Lo que hemos aprendido en toda la flota

Dejemos que el «Sweep» elija el nivel de CPU

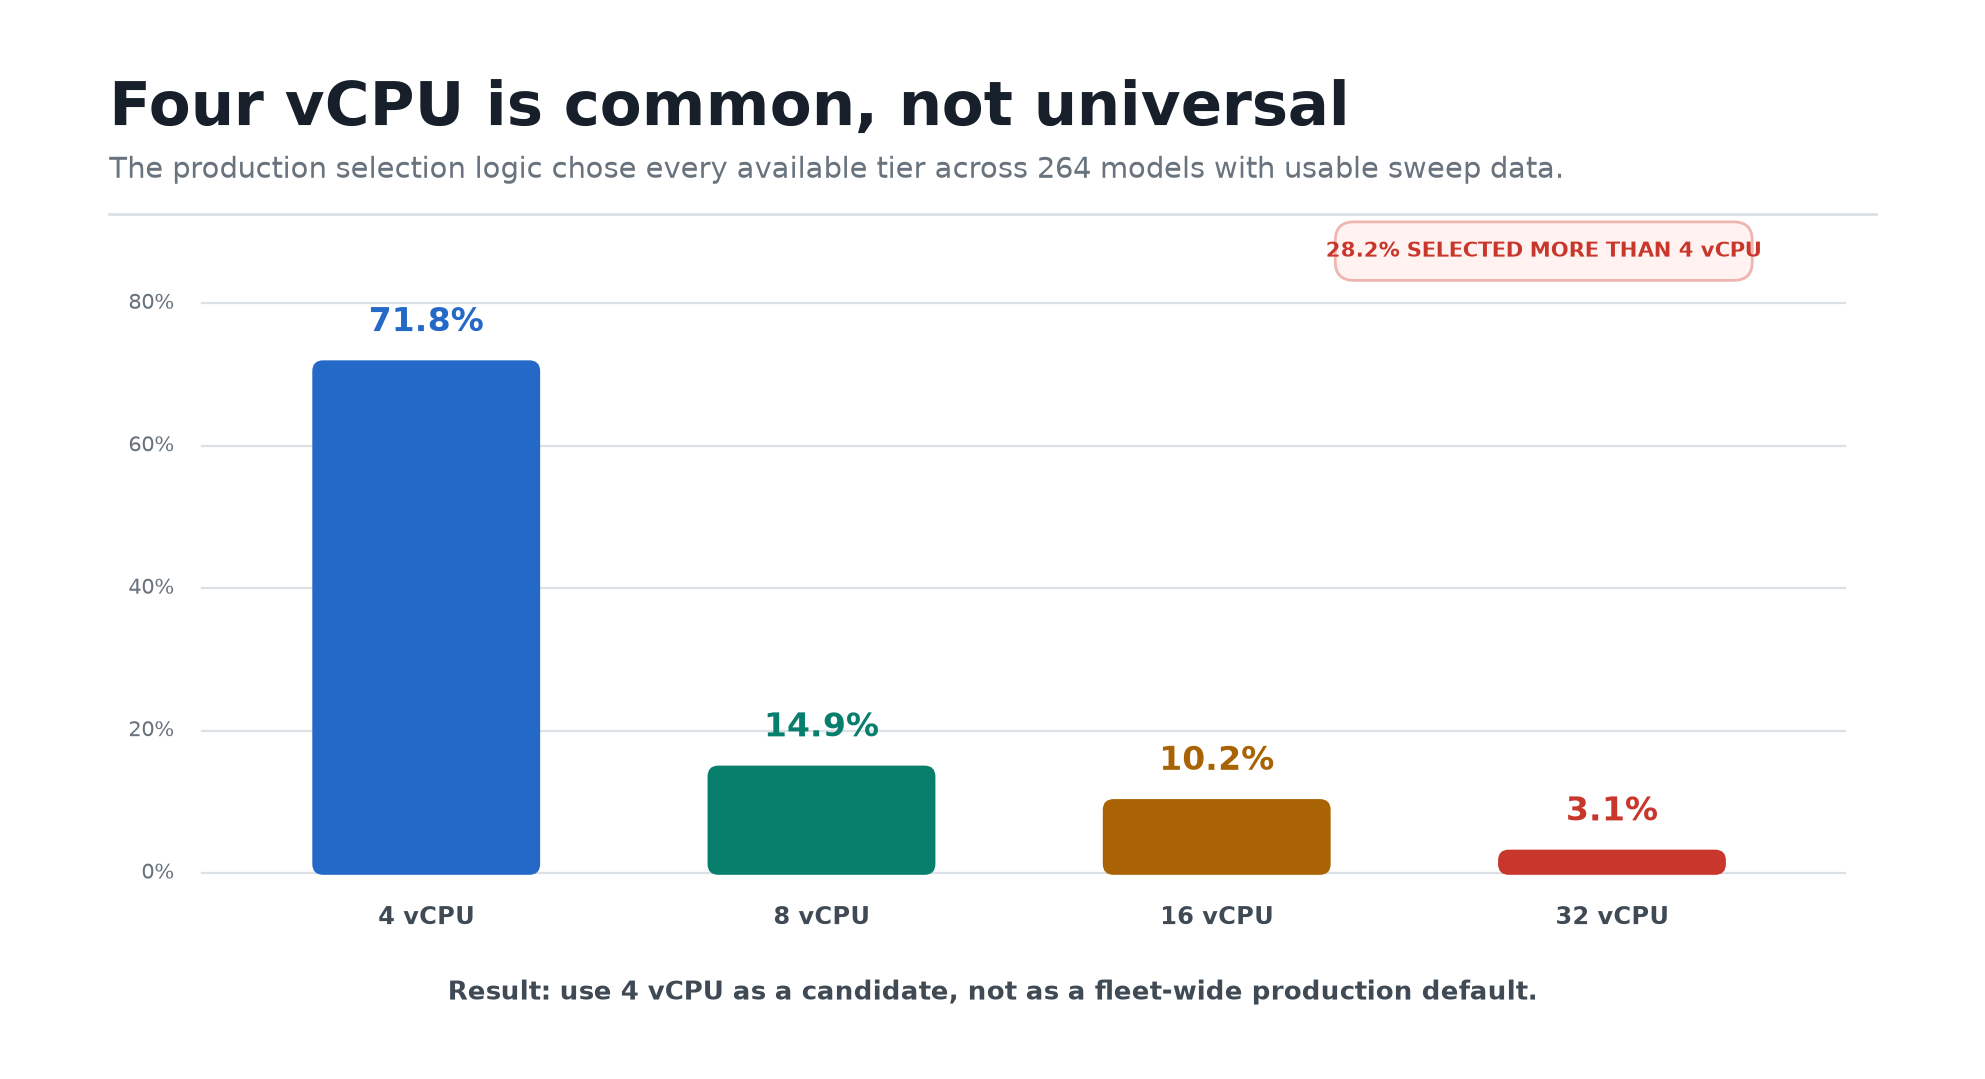
El análisis actualizado de los 264 modelos reveló que la configuración de 4 vCPU fue la más habitual, con un 71,8 %, seguida de la de 8 vCPU, con un 14,9 %; la de 16 vCPU, con un 10,2 %; y la de 32 vCPU, con un 3,1 %. Los niveles superiores se impusieron en el 28,2 % de los modelos. 

Todos los niveles de CPU disponibles resultaron óptimos para al menos algunos modelos.

Cuatro vCPU es una opción inicial útil, pero no un valor predeterminado para entornos de producción. El optimizador evalúa los niveles disponibles y selecciona aquel que ofrece la mejor capacidad ajustada al coste, al tiempo que cumple el objetivo de latencia del modelo. 

La CPU por sí sola no siempre refleja la saturación

El HPA de Kubernetes suele estimar la capacidad escalando el rendimiento observado en proporción a la utilización de la CPU: 

QPS previsto = QPS actual × (CPU objetivo / CPU medida)

Esto funciona cuando la CPU es el recurso limitante. Sin embargo, falla cuando el rendimiento alcanza primero un nivel estable. En una prueba con 8 vCPU, la CPU se estabilizó en el 26 %, por lo que un objetivo de HPA del 40 % implicaba una capacidad de 1.252 QPS. El modelo se saturó a 829 QPS, lo que supone una sobreestimación de 1,5 veces. 

Triton proporciona señales de cola como «nv_inference_pending_request_count» y la duración de la cola, que describen la saturación de forma más directa. Estamos avanzando hacia una señal de autoescalado que combine la CPU con la presión de la cola. 

De los resultados de las pruebas de rendimiento a la configuración de producción

El optimizador hace algo más que clasificar las filas de los resultados de las pruebas de rendimiento. Combina la capacidad medida por pod con el rango de QPS de producción del modelo, calcula los requisitos de réplicas y el coste previsto, valida el cambio propuesto y genera las modificaciones de implementación que utiliza el flujo de trabajo de entrega. 

  • Arquitectura de la CPU y nivel de vCPU
  • Asignación de memoria
  • Número de instancias de Triton
  • Configuración de subprocesos de OpenMP
  • QPS previsto y latencia p99
  • Número mínimo y máximo de réplicas
  • Imagen de servicio
  • Coste previsto

Esto reduce la brecha entre un punto de referencia y una configuración de producción operativa. Además, hace que la recomendación sea reproducible: las mediciones, la configuración seleccionada y los datos sobre costes se almacenan juntos, en lugar de quedar anotados en el cuaderno de un ingeniero. 

Apoyo a las migraciones de plataformas y a la formación continua

El sintonizador admite ahora dos flujos de trabajo recurrentes de la plataforma. Durante las migraciones de plataforma, asigna a cada modelo una configuración adaptada al entorno de servicio de destino, en lugar de mantener los supuestos de la plataforma anterior. Esta misma integración permite que los flujos de trabajo de entrenamiento continuo reevalúen los nuevos artefactos del modelo a medida que se generan, de modo que la configuración del servicio pueda evolucionar junto con el modelo. 

Ambos flujos de trabajo utilizan el conjunto compartido de pruebas de referencia y la misma lógica de selección. Esto proporciona a los procesos de migración y reentrenamiento una ruta coherente de validación del rendimiento, sin que los equipos de modelos tengan que crear una infraestructura de pruebas de referencia independiente. 

La lección más amplia

La configuración del servicio forma parte del rendimiento del modelo. El reentrenamiento y la optimización del código son importantes, pero ninguno de los dos es imprescindible para recuperar la capacidad perdida debido a los valores predeterminados en tiempo de ejecución. 

A escala de flota, lo importante no es una única regla, como «utilizar pods de 4 vCPU» o «configurar OpenMP en uno». Se trata de un sistema repetible capaz de comprobar esas hipótesis con cada modelo, en condiciones coherentes, y de convertir el resultado en una configuración lista para su implementación. 

En el caso de nuestra flota, ese sistema detectó aumentos medios de QPS que oscilaban entre 1,75x y 6,78x en los distintos niveles de CPU, demostró por qué el nivel de CPU debe medirse por modelo y sustituyó el dimensionamiento manual por una ruta de optimización compartida que se adapta a cientos de modelos. El conjunto de pruebas de rendimiento se mantuvo fijo a medida que aumentaba el número de modelos que lo utilizaban. 

¿Qué viene ahora?

Esta primera entrada se ha centrado en los modelos Triton basados en CPU. En la próxima entrega, abordaremos cómo estamos ampliando ese mismo flujo de trabajo de ajuste automático a los modelos basados en GPU, incluyendo el espacio de configuración de la GPU, las señales de capacidad específicas del acelerador y los cambios necesarios en la capa de medición. Las capas de orquestación y selección siguen siendo reutilizables, lo que proporciona a los modelos de GPU el mismo proceso repetible desde el artefacto del modelo hasta la configuración de producción validada. 

Agradecimientos

  • Plataforma de servicio de aprendizaje automático: Arvind Kalyan, Kyoungah Kim, Haifeng Geng, Emmanuel Khayat, Jeffery Ni, Songze Li, Teer Ying, Feijin Deng, Zhe Liu, Zhengyang Wang
  • Equipo de Ads ML: Utsaw Kumar, Kin Sum Liu, Benjamin Yang y Praveen Gondhi

Manténgase informado con Actualizaciones

Suscríbase a nuestro blog de ingeniería para estar al día de todos los los proyectos más interesantes en los que trabaja nuestro equipo
El equipo de datos de DoorDash se encarga de generar análisis precisos a partir de los datos y de dar respuesta a cuestiones clave para el negocio: 

  • ¿Por qué se redujo el volumen de pedidos en California la semana pasada? 
  • ¿Cómo ha ido la evolución de un nuevo producto desde su lanzamiento? 
  • ¿Qué comerciantes corren el riesgo de abandonar nuestros productos de marketing?
  • Muéstrame los pedidos cancelados por hora durante los últimos 90 días en Arby’s

Los modelos de agentes de Frontier, combinados con plataformas de agentes como Codex y Claude Code (CC), son herramientas muy potentes para interactuar con nuestros datos y responder a este tipo de preguntas. Sin embargo, a menudo su rendimiento no es óptimo cuando se enfrentan a los grandes volúmenes de datos semiestructurados que suelen caracterizar a las empresas de gran tamaño. Supone un reto garantizar que todas las funciones empresariales —incluidas las de operaciones, ingeniería, marketing y producto— tengan acceso a datos actualizados y correctos a partir de los cuales puedan extraer las conclusiones adecuadas.

«El problema es, en realidad, que nuestras fuentes de datos de origen están muy fragmentadas», señaló un responsable sénior de análisis al examinar nuestras herramientas anteriores. Esas herramientas o bien se centraban en profundidad en un solo ámbito, o bien abarcaban muchos ámbitos de forma superficial. 

Como resultado, creamos Vera, un agente interno de datos conversacional. Descubrimos que desarrollar y ajustar todas las partes del proceso —las preguntas de estimulación, la clasificación y la recuperación de datos, así como las habilidades específicas del ámbito— supuso una mejora significativa del rendimiento en comparación con los agentes estándar que cuentan con conectores de datos sencillos. «Ha funcionado bien con preguntas estratégicas de finanzas de distintos niveles de dificultad. Me ha impresionado mucho», afirmó un director financiero tras varias semanas de pruebas con Vera.

Por qué lo hemos desarrollado internamente

Los agentes actuales suelen ser capaces de responder a preguntas sobre datos en un entorno limpio. Sin embargo, contar con una sólida capa de datos semánticos es fundamental para garantizar que estos agentes obtengan respuestas veraces en las que la empresa pueda confiar. Eliminar la ambigüedad y resolver los conflictos de significado semántico en toda la organización no es una tarea trivial; se trata de un reto apremiante para ampliar esta capa de datos sin perder precisión. 

En nuestra opinión, la clave para ampliar Vera es permitir que los responsables de área —las personas más cercanas a los datos— contribuyan y verifiquen las evaluaciones. Un responsable de área es el experto en la materia encargado de determinar cómo se mide un área de negocio. Establecer ese ciclo cerrado resulta más fácil cuando tenemos un control firme sobre la pila tecnológica. 

En esta entrada, analizamos paso a paso el diseño general de Vera y sus mediciones de rendimiento, comentamos las decisiones arquitectónicas y ofrecemos estudios comparativos entre distintos tipos de modelos y enfoques de razonamiento.

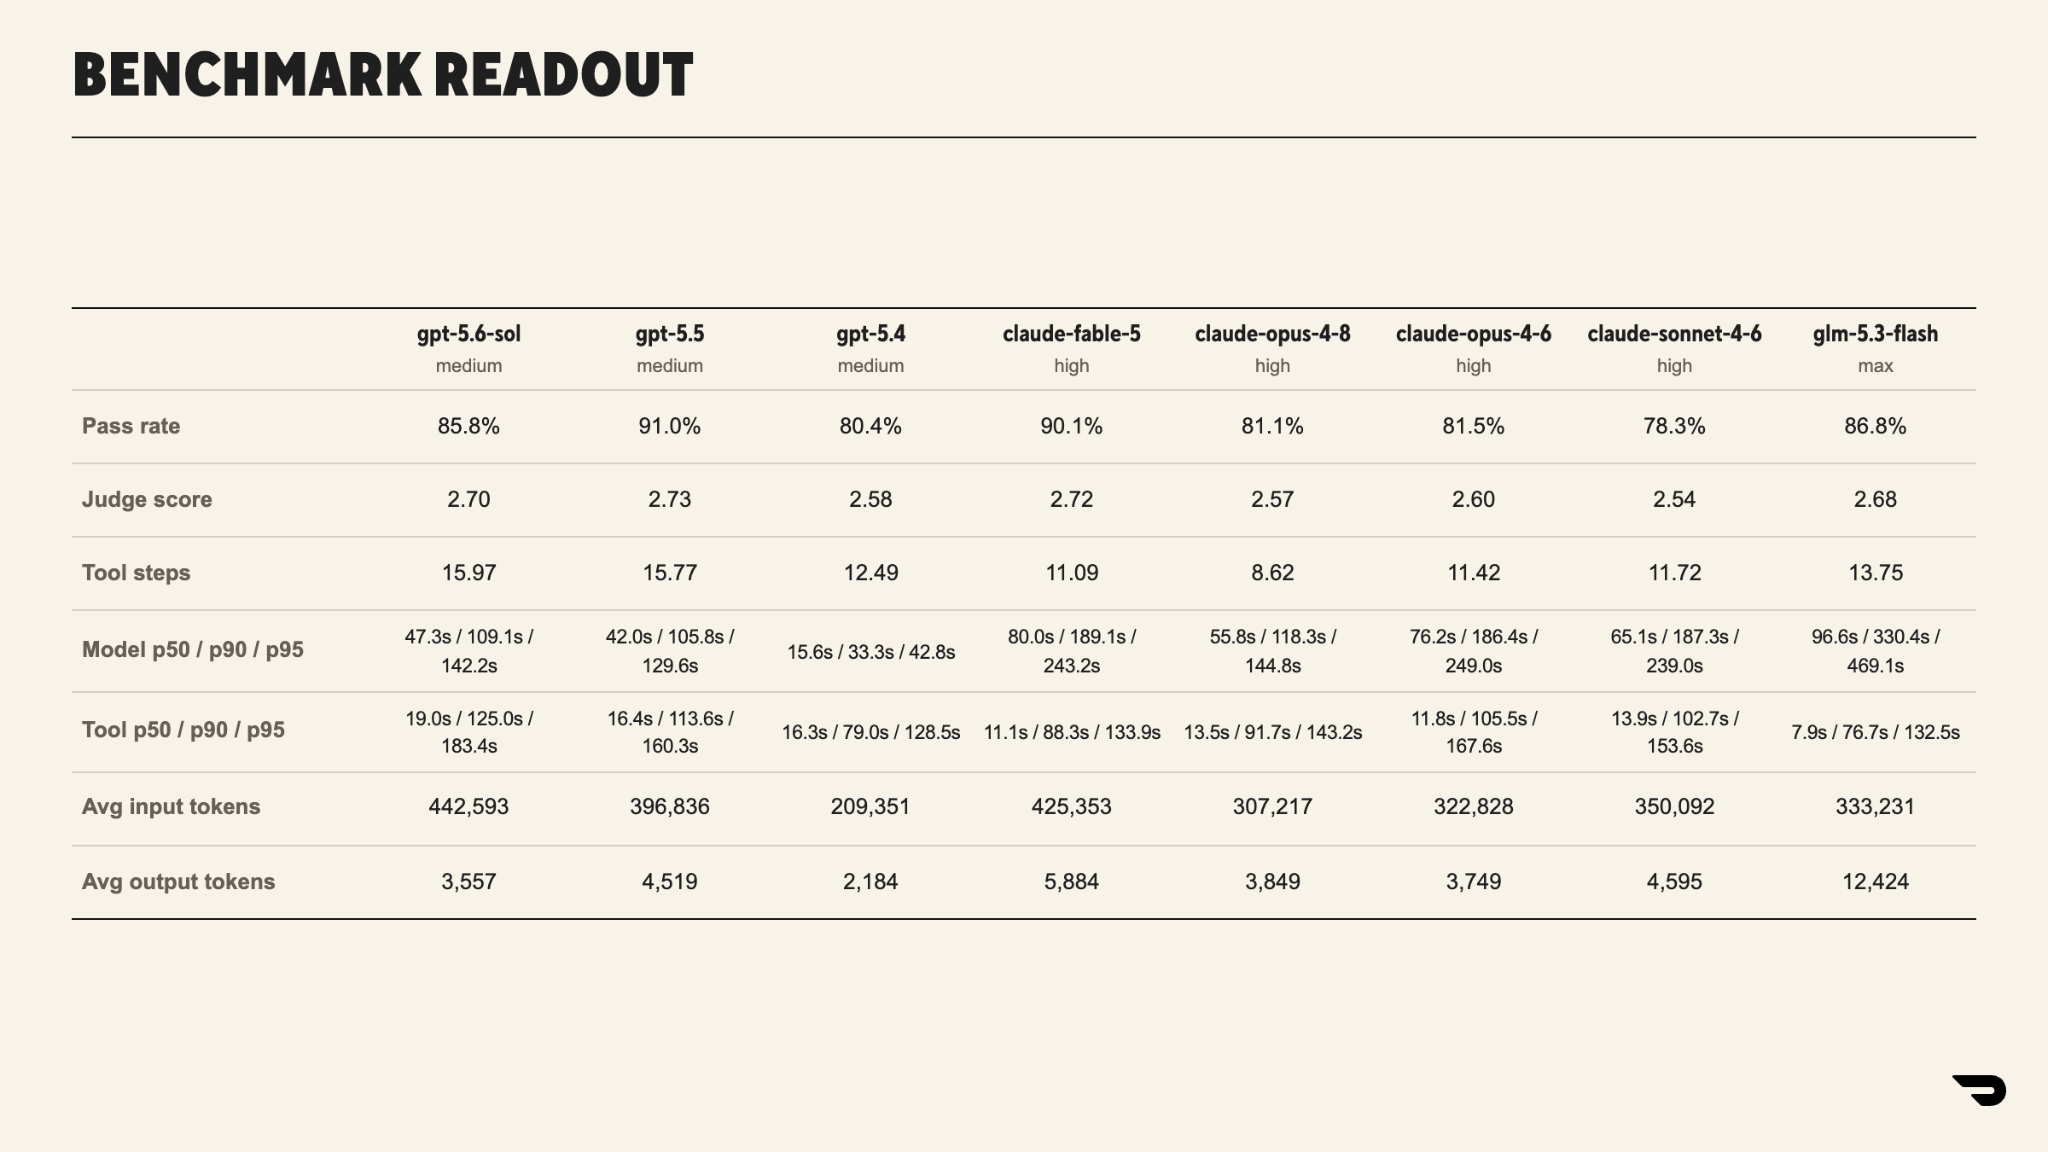
Tabla 1: Una ejecución completa de la prueba de rendimiento, con todos los modelos en el mismo conjunto de pruebas. Los modelos de la frontera se sitúan a pocos puntos de distancia entre sí en cuanto a puntuación, por lo que la latencia, los pasos y los tokens son los aspectos que los diferencian.

Nuestro conjunto de datos de evaluación abarca 19 ámbitos verticales en las áreas de ventas, finanzas, producto y operaciones de DoorDash, con más de 1.900 evaluaciones aportadas. Estas varían en complejidad, y algunas preguntas requieren numerosas llamadas a herramientas y un razonamiento más extenso. 

El modelo de producción actual —GPT 5.5— obtiene la puntuación global más alta en la prueba de rendimiento. Esto no es de extrañar, ya que hemos optimizado las indicaciones y las capacidades específicamente para este modelo, algo que pretendemos replicar pronto en el resto de familias de modelos.  

Las respuestas finales se puntúan mediante un juez LLM según tres criterios: uso de herramientas, selección de tablas y corrección general de la respuesta. Cuando las evaluaciones no cuentan con una consulta SQL inequívoca, los expertos en la materia proporcionan rúbricas de evaluación detalladas. La puntuación máxima en este diseño es de 3,0; tal y como muestra la Tabla 1, los modelos de vanguardia tanto de Anthropic como de OpenAI se sitúan a pocos puntos de distancia entre sí.

También informamos sobre las llamadas a herramientas y las tasas de finalización. Dado que los modelos generan su propio código SQL, una ejecución completa lanza numerosas consultas pesadas simultáneas. Algunas de ellas alcanzan el tiempo de espera de la base de datos, lo que se contabiliza como fallos en la tasa de superación, no como respuestas incorrectas.  

La variación entre ejecuciones del índice de referencia es de aproximadamente cuatro puntos porcentuales en la tasa de éxito, independientemente del modelo; las diferencias inferiores a ese valor se consideran ruido. Uno de los colaboradores se encarga de mantener actualizadas las propias evaluaciones. Una evaluación que especifique un intervalo de tiempo relativo —por ejemplo, «¿Cuál fue el volumen de pedidos de esta tienda la semana pasada?»— queda obsoleta rápidamente.

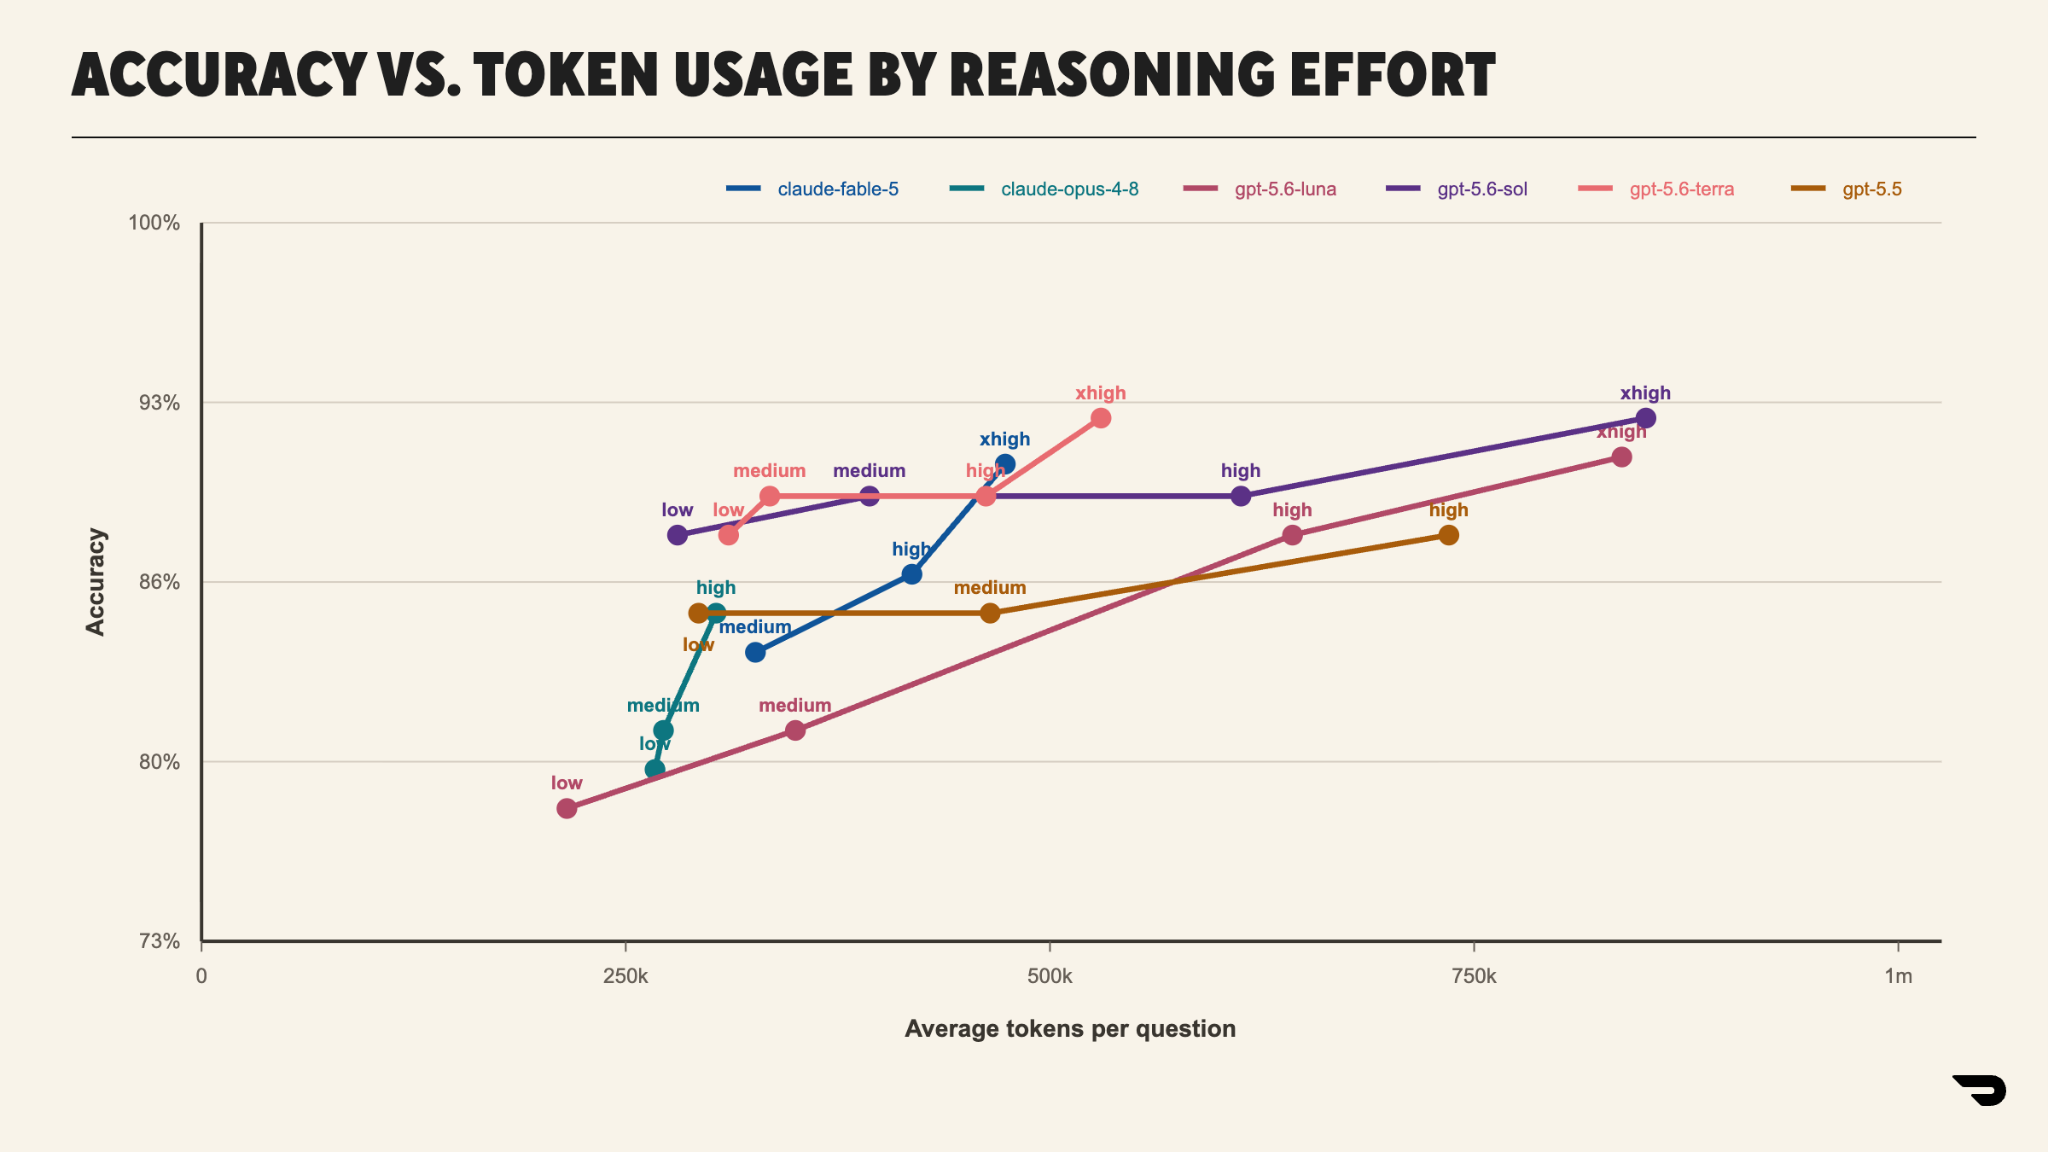
Aunque los modelos de vanguardia obtienen buenos resultados con nuestro conjunto de pruebas en este benchmark, existen diferentes consideraciones de equilibrio entre latencia, uso de herramientas y coste en función del modelo y del proveedor. Elegimos el modelo de producción de Vera basándonos en ese equilibrio, en lugar de solo en la puntuación principal, y volvemos a ejecutar el benchmark a medida que se lanzan nuevos modelos. Estas pruebas de ablación se realizan en un subconjunto de 100 preguntas, por lo que las diferencias de unos pocos puntos se encuentran dentro de nuestra definición de ruido. En todos los tipos de modelos, un mayor esfuerzo de razonamiento mejora la puntuación.

Figura 1: Precisión en función del número de tokens por pregunta en el subconjunto de 100 preguntas. Todas las líneas aumentan a medida que aumenta el esfuerzo y convergen hacia la parte superior, por lo que el esfuerzo es un factor importante, junto con la elección del modelo, y se mide en tokens.

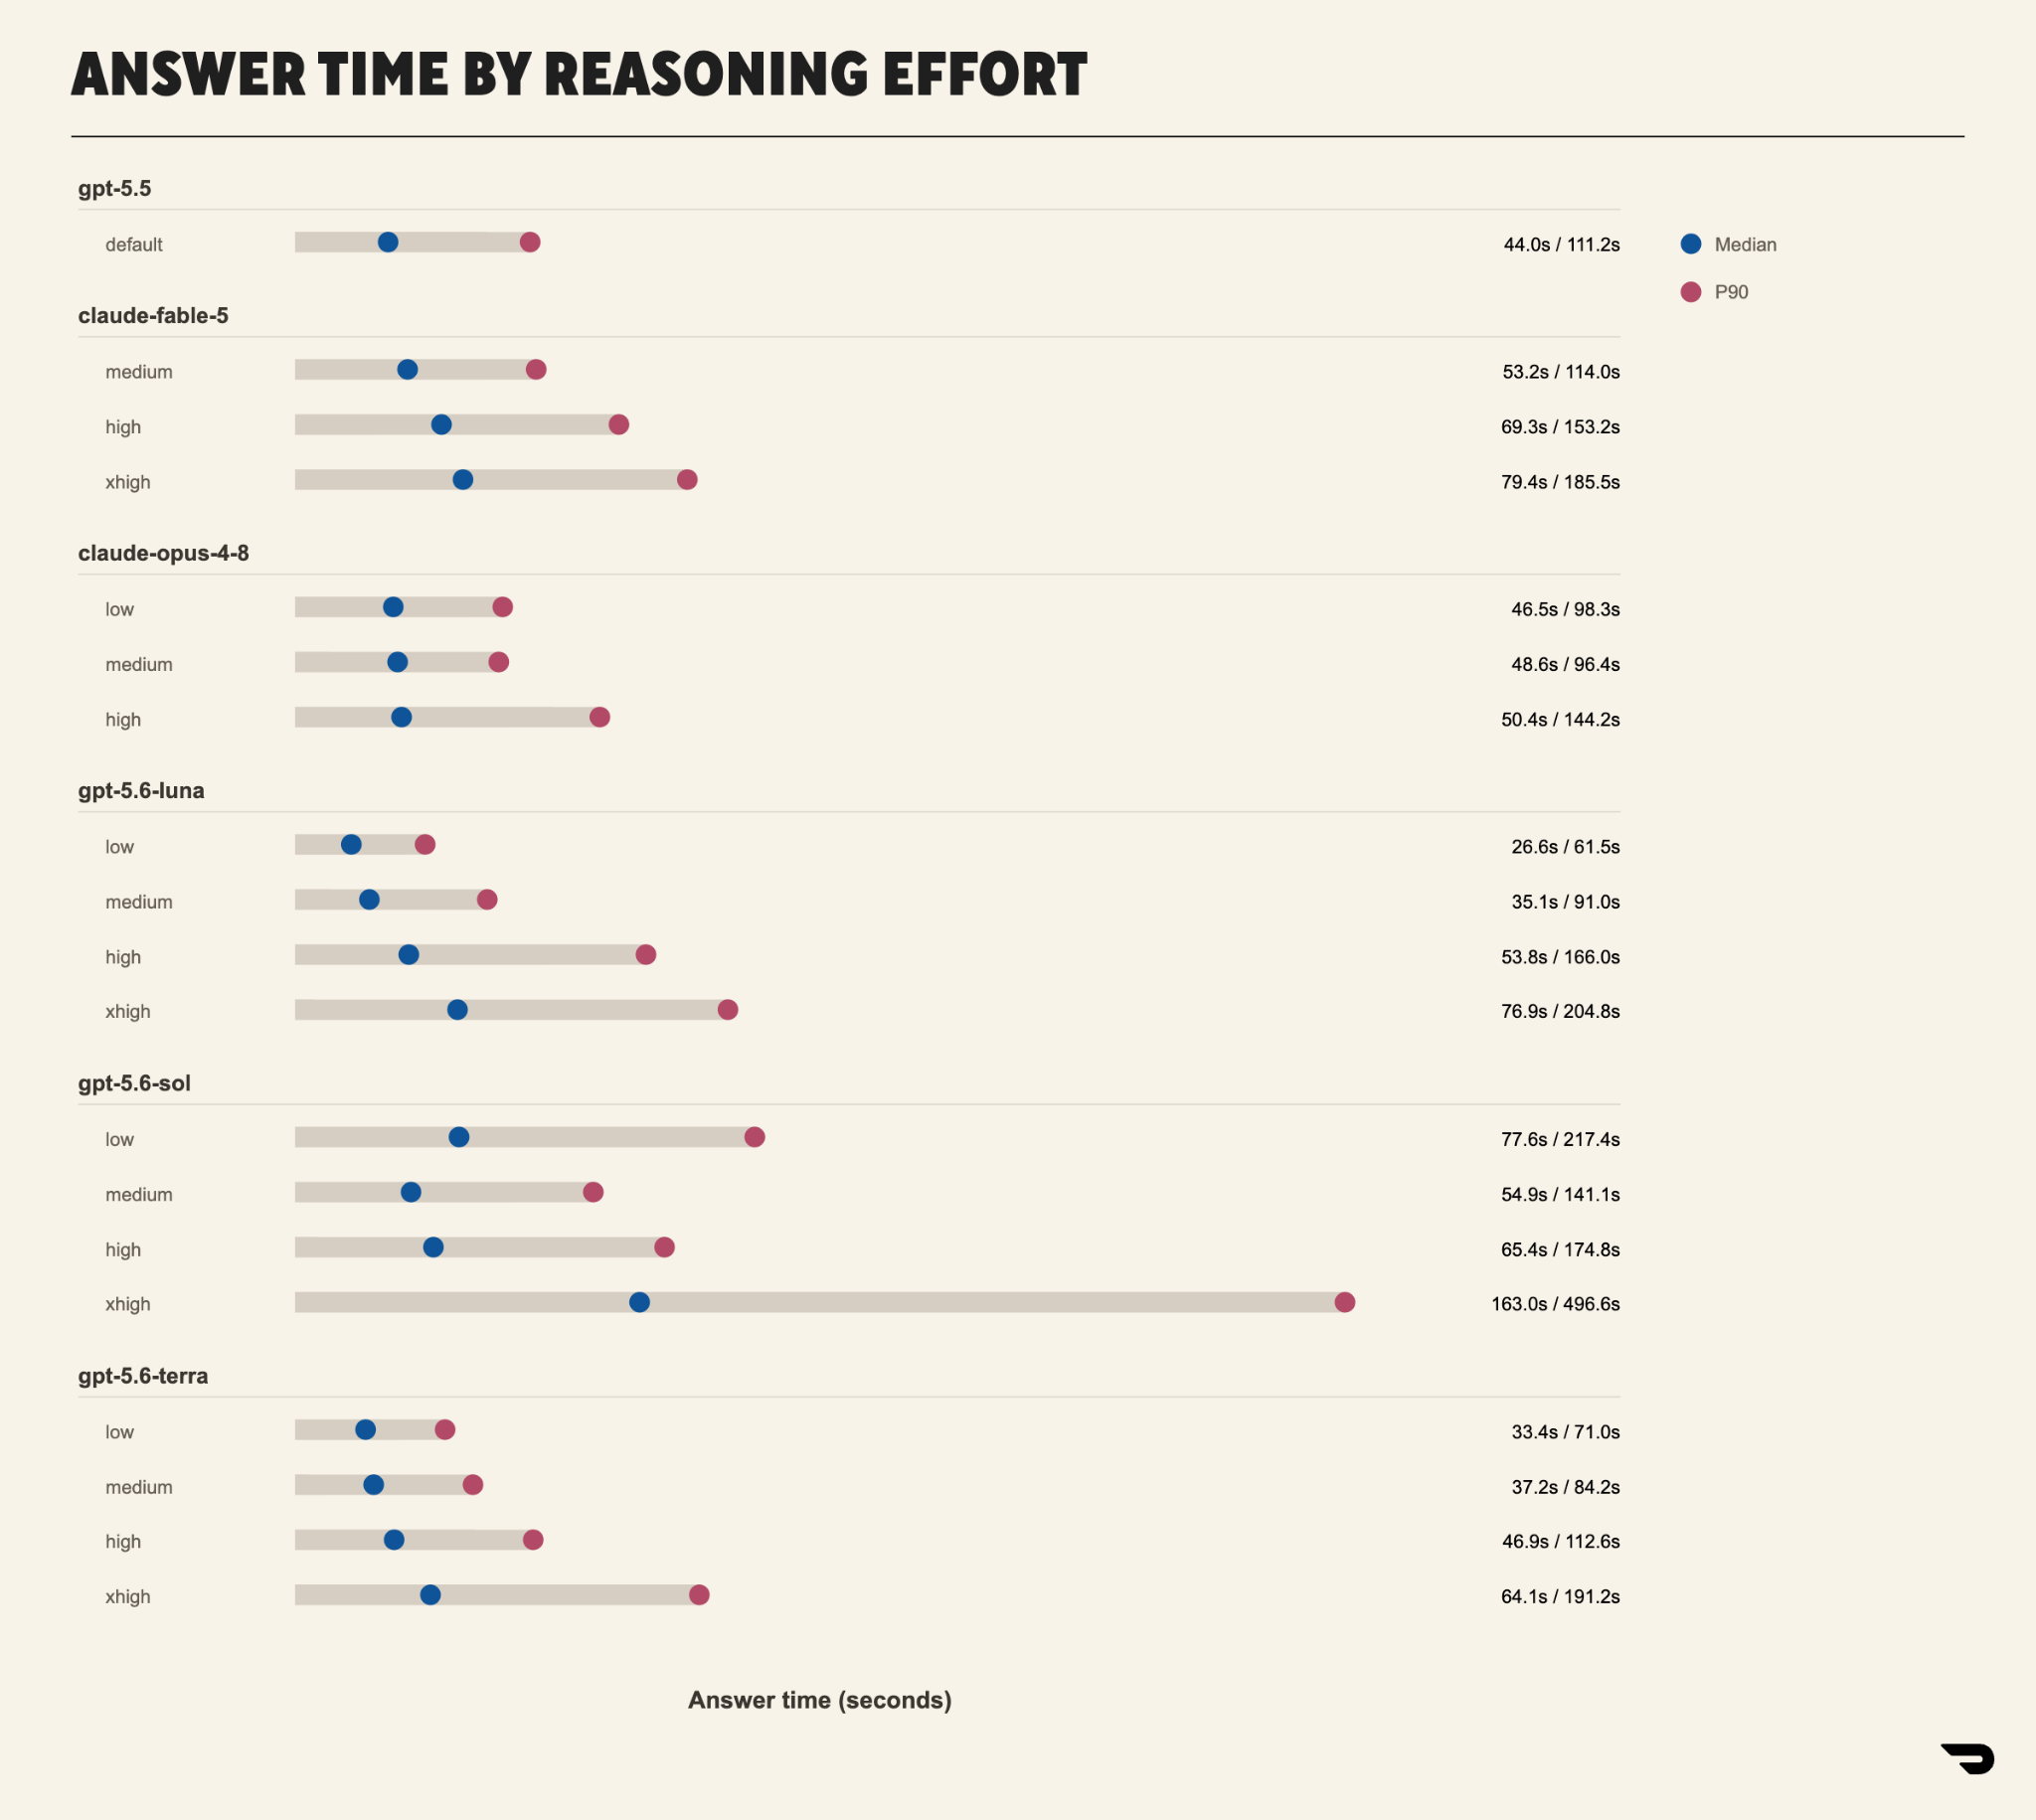
La diferencia de rendimiento en el límite es pequeña, ya que tanto los modelos de OpenAI como los de Anthropic alcanzan puntuaciones similares tras un esfuerzo prolongado. Como es lógico, aumentar el presupuesto de razonamiento conlleva un aumento de la latencia.

Figura 2: Tiempo medio y tiempo p90 de respuesta para los mismos modelos y niveles de esfuerzo. Un mayor esfuerzo se traduce en mayor precisión, pero a costa de más tiempo real.

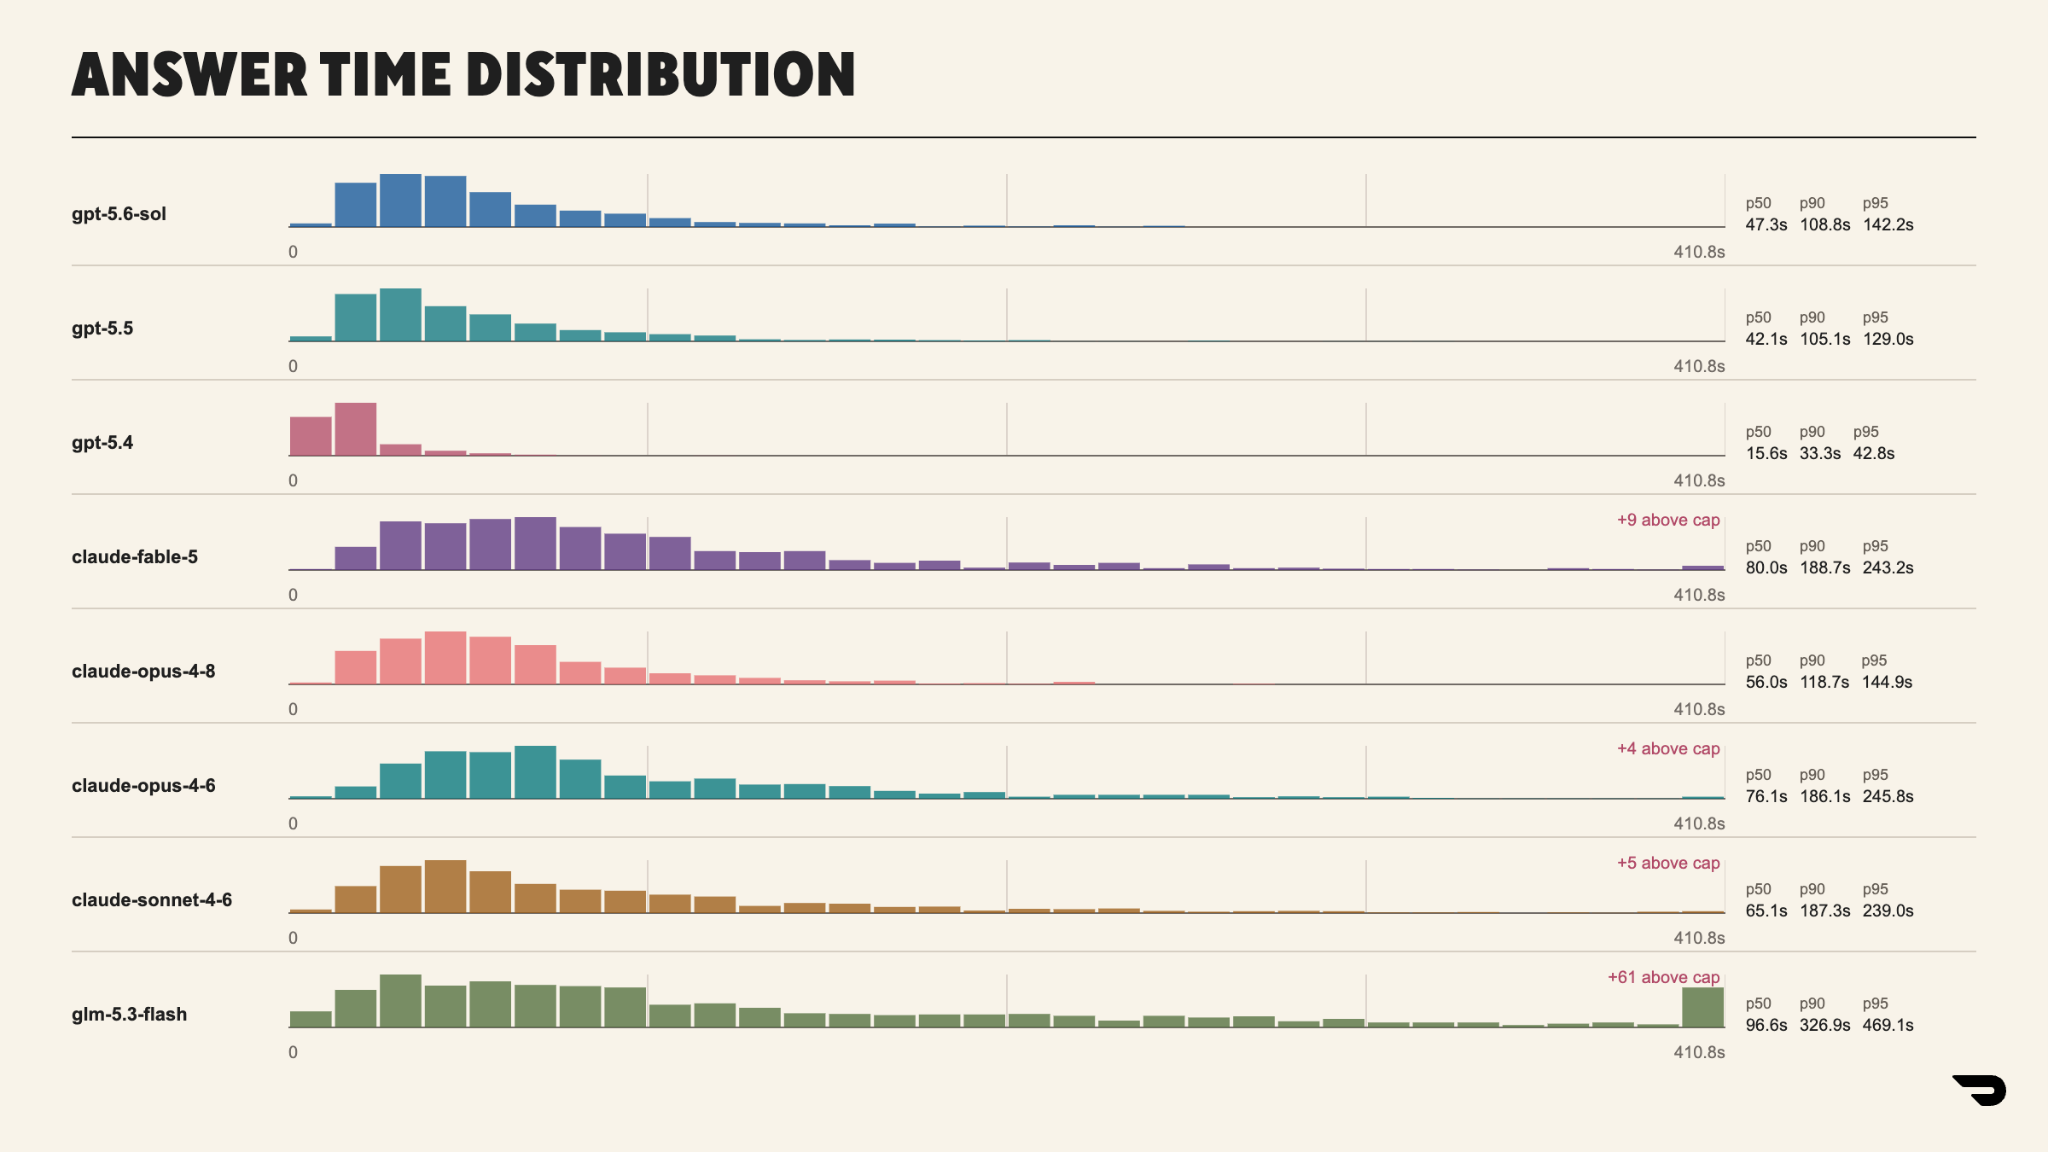
Aunque un mayor esfuerzo de razonamiento aumenta de forma monótona la puntuación en las pruebas de referencia, el efecto puede resultar perjudicial para el sistema en su conjunto, ya que se traducen en respuestas más largas para el usuario y en un mayor número de accesos de la herramienta al almacén de datos, lo que aumenta la probabilidad de que se produzcan tiempos de espera y resultados parciales. Hemos observado las siguientes distribuciones temporales en los distintos modelos, tal y como se muestra en la figura 3:

Figura 3: Distribución del tiempo de respuesta por modelo en la ejecución completa. Es la cola, y no la mediana, la que determina los tiempos de espera y los resultados parciales.

En nuestro entorno, la latencia de cola de los modelos de Anthropic fue mayor que la de sus homólogos de OpenAI. Alojamos una instancia interna de GLM 5.3 Flash a través de los puntos de conexión de Modal a modo de comparación aproximada, aunque al no estar optimizada, se produjeron importantes tiempos de espera bajo una carga elevada. 

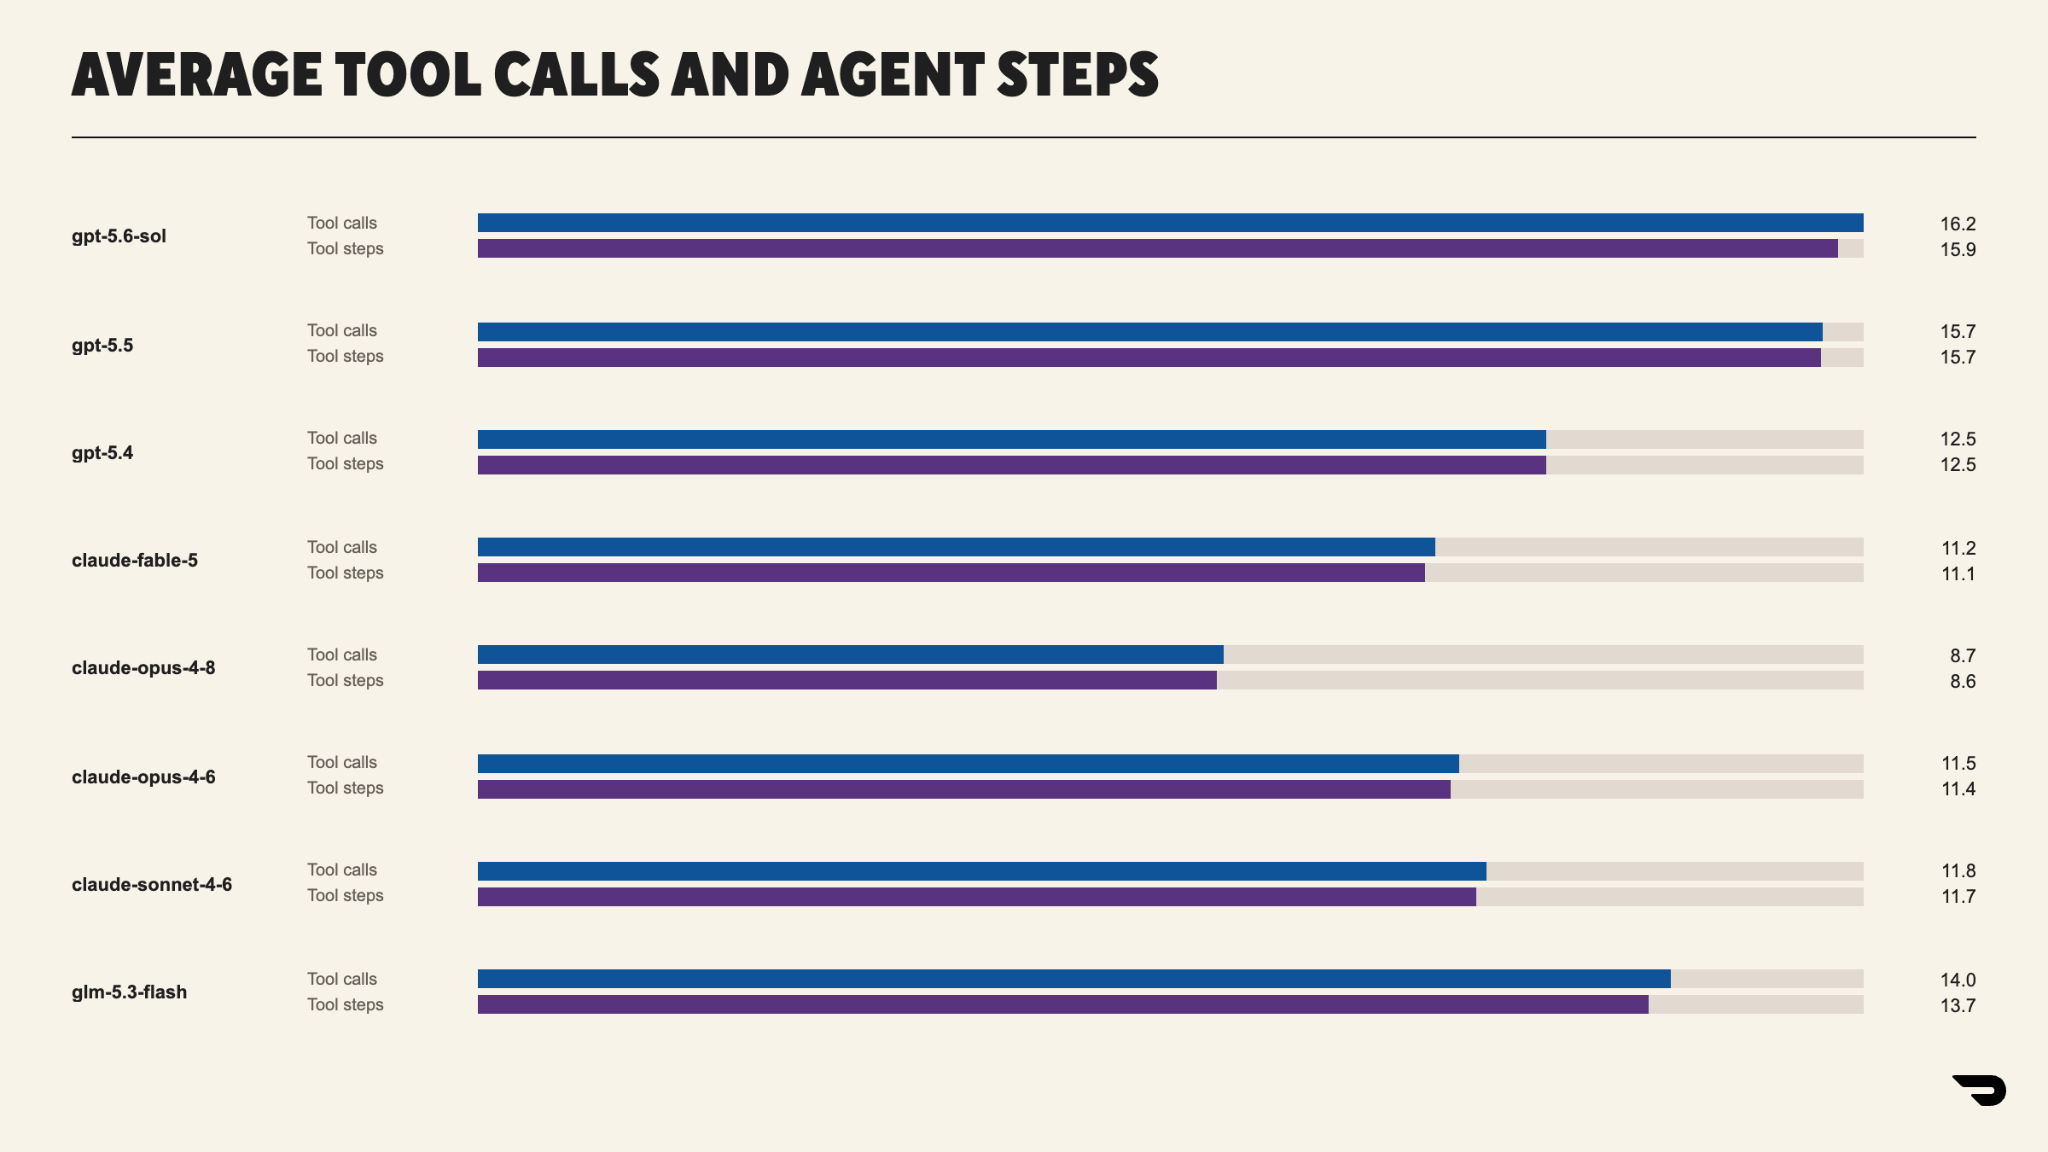
Claude Fable 5 necesitó menos pasos de herramienta que los modelos GPT, pero tardó más tiempo en cada paso y, aproximadamente, duplicó el tiempo de ejecución. Esto queda patente al comparar las trayectorias de las herramientas de los distintos modelos, tal y como se muestra en la figura 4:

Figura 4: Promedio de llamadas a herramientas y pasos del agente por pregunta. Un menor número de pasos no implica una respuesta más rápida, ya que los modelos que realizan menos pasos dedican más tiempo a cada uno de ellos, tal y como muestra la Figura 3.
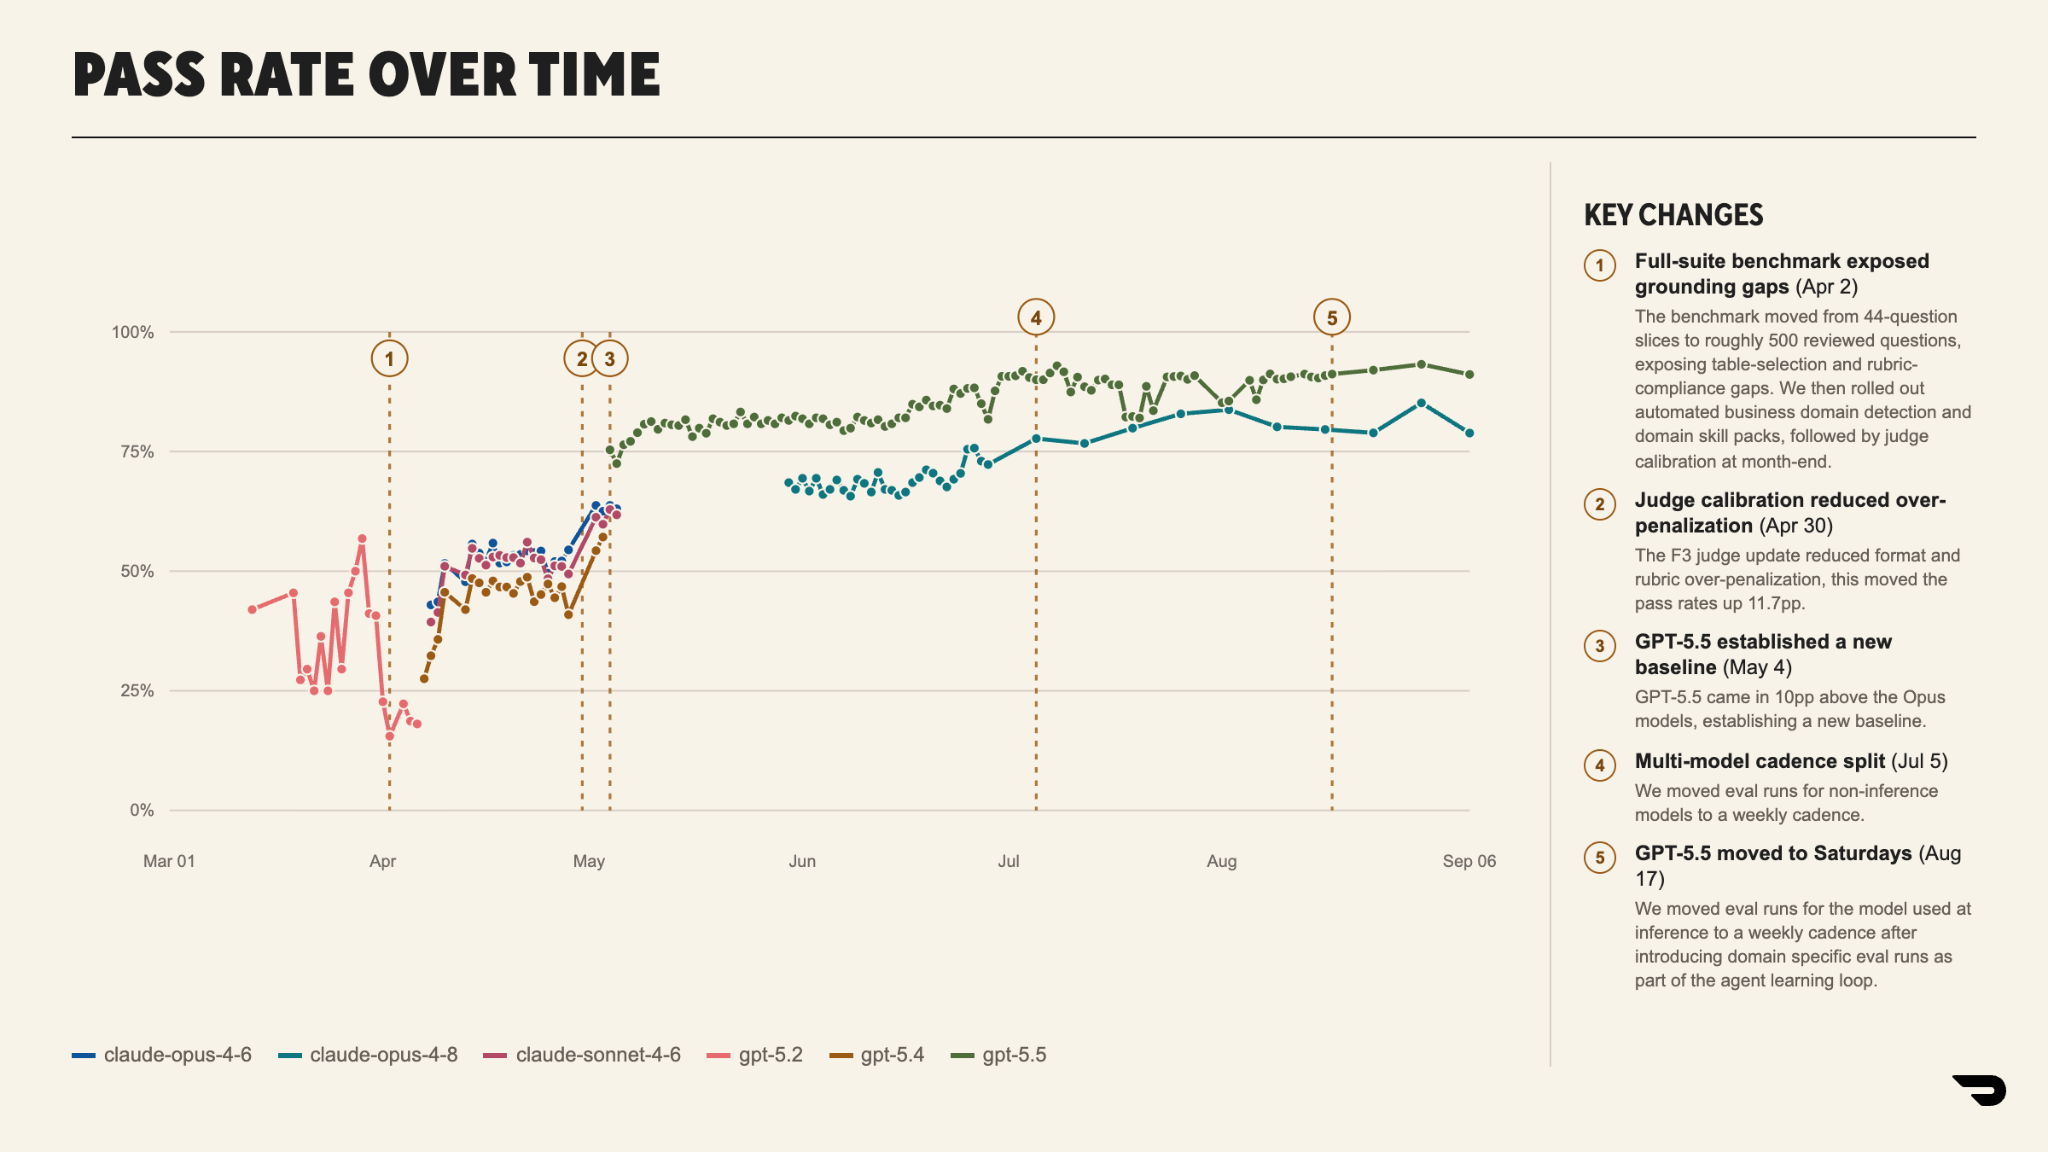
Aunque históricamente hemos observado mejoras progresivas en las puntuaciones de referencia para las nuevas variantes de los modelos, el impacto de las versiones se ha estabilizado progresivamente, tal y como se muestra en la Figura 5:
Figura 5: Índice de aprobados por modelo entre marzo y septiembre, con los cambios que lo han influido.

Esto es un claro indicio de que la inteligencia del modelo en sí ya no es el factor que más contribuye a las mejoras de Vera, y de que el conjunto de herramientas del modelo —que incluye el contexto empresarial, la recuperación de conocimientos, el modelado de datos, la validación de SQL y la ejecución— es el vector principal de mejora de cara al futuro. 

Para validar esta hipótesis, probamos tanto Claude Code como Vera con un modelo común, Opus 4.8. Dotamos a CC de nuestras herramientas de acceso SQL y de las mismas capacidades que utiliza Vera.

Analizamos 100 muestras representativas en cada sistema. Vera obtuvo una puntuación de 2,60/3,0, lo que supone una tasa de acierto del 73 %, mientras que CC obtuvo una puntuación de 2,16/3,0, con una tasa de acierto del 48 %. Esta diferencia se situaba muy por fuera del margen de variación estimado. Observamos que CC tenía dificultades para consultar eficazmente las tablas modeladas con el fin de extraer inferencias correctas, lo que puso de relieve la necesidad de contar con una capa de datos eficaz, que incluyera un catálogo de tablas modeladas, heurísticas de patrones de unión y elementos similares. Próximamente: cómo construimos y consultamos esa capa. 

Recuperación y clasificación

Más de 10 000 personas en DoorDash confían en un ecosistema de datos que ha crecido hasta incluir más de 200 000 conjuntos de datos, 350 petabytes de datos y 10 fuentes de conocimiento institucional, desde repositorios de código hasta wikis. Con tal cantidad de datos disponibles, el reto puede consistir en saber qué utilizar y cuándo. La fase de recuperación y clasificación proporciona esas fuentes de datos actuales, precisas y sin contradicciones. 

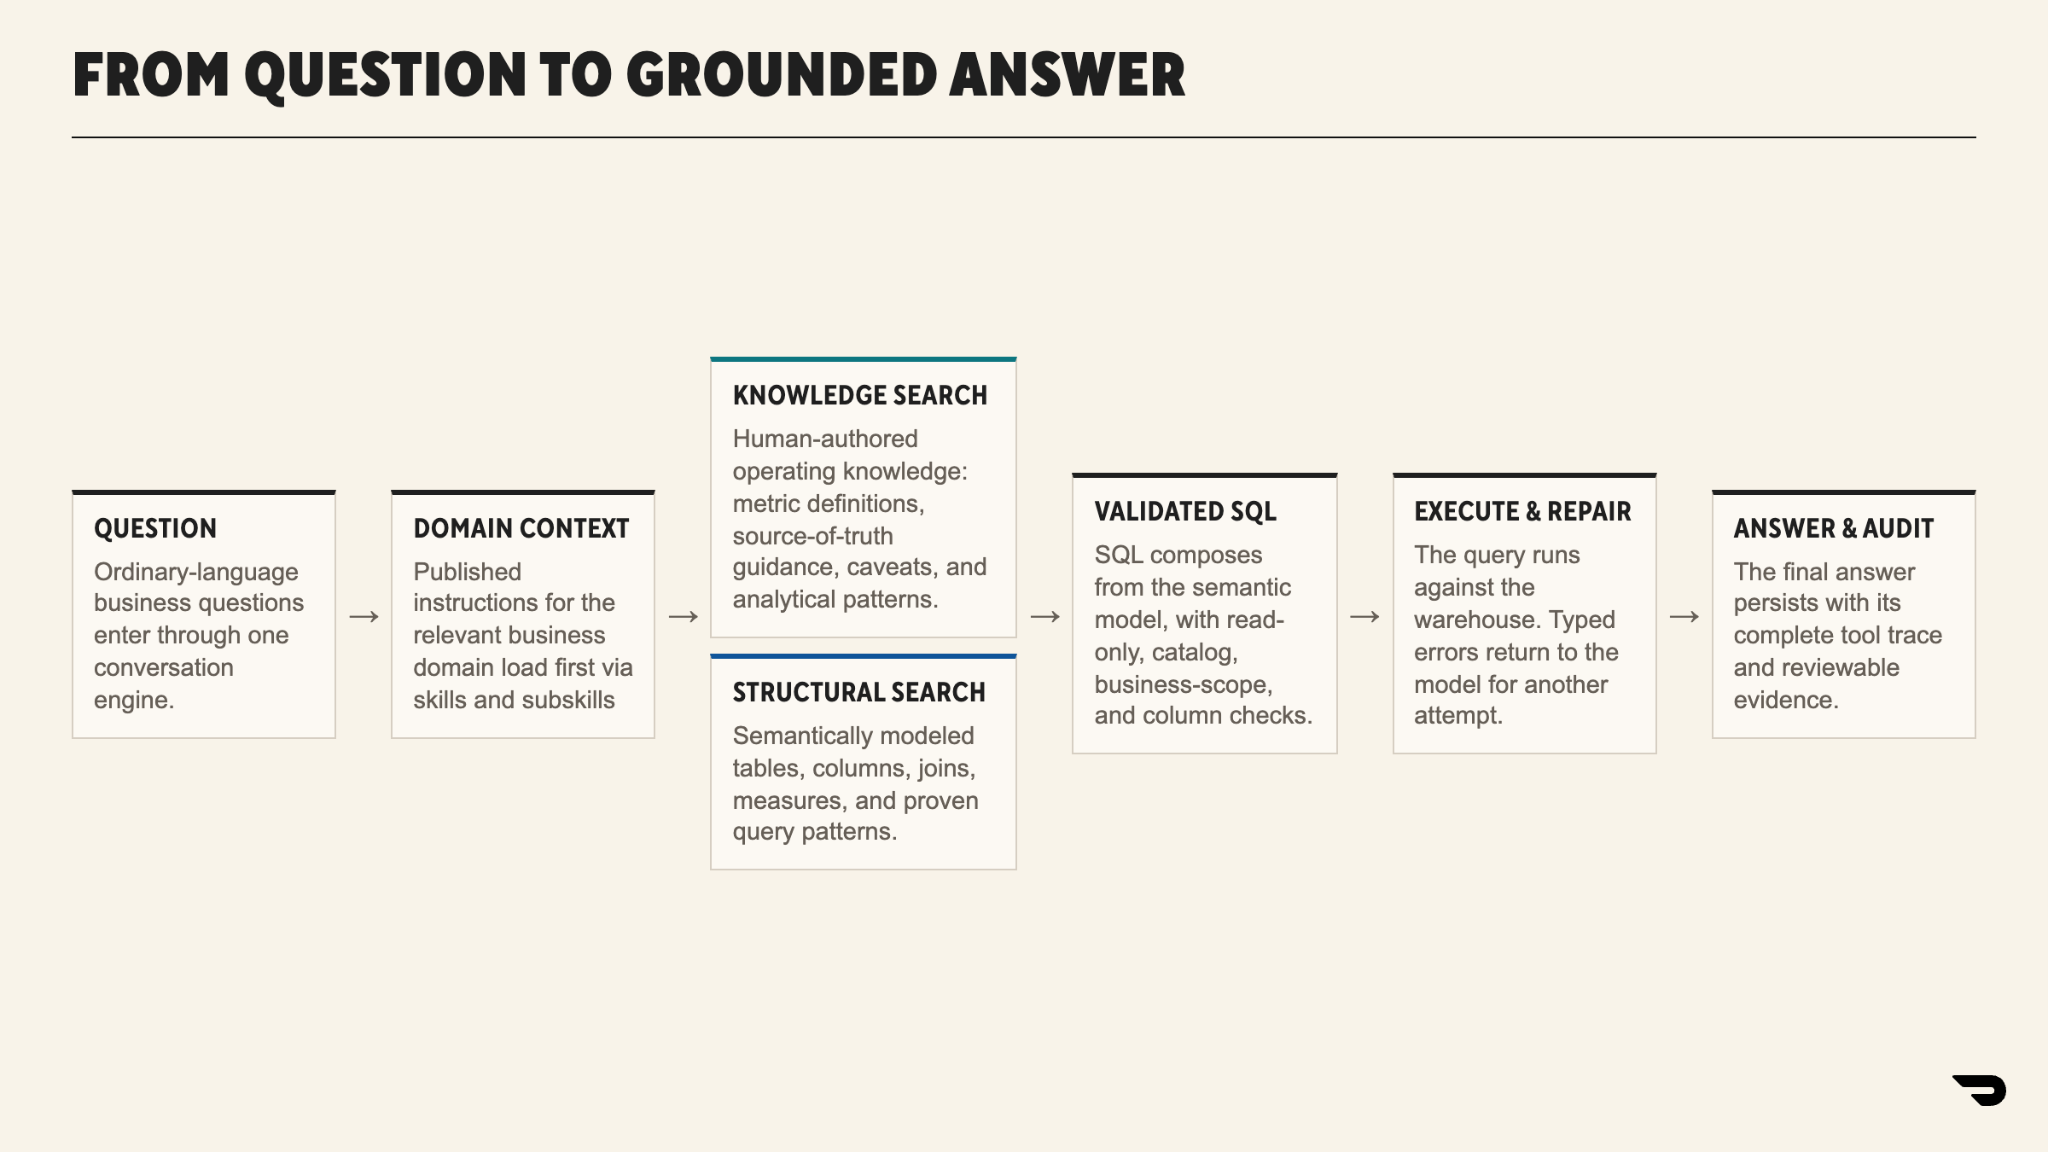
Figura 6: El proceso de Vera desde una pregunta hasta una respuesta fundamentada. La recuperación lleva a cabo dos búsquedas simultáneas: una en el conocimiento elaborado por personas y otra en las tablas modeladas, y todo lo que viene a continuación está condicionado por ese modelo.

Para simplificar, se utiliza un único modelo de incrustación para todos los repositorios de conocimiento. Las tablas de datos principales se indexan fuera de línea con una periodicidad regular, lo que nos permite descartar las consultas de baja relevancia y eliminar el contenido repetitivo. Aprendemos patrones de unión y otros aspectos semánticos a partir de los patrones de uso restantes, los metadatos de las tablas, las referencias de código y las páginas wiki para construir un modelo de datos completo. 

El modelo de datos limita el comportamiento en tiempo de ejecución; el acceso a fuentes no modeladas o no verificadas se bloquea a nivel del entorno de pruebas. Una desventaja es el retraso que se produce entre el momento en que los datos están disponibles y el momento en que Vera puede consultarlos. Las nuevas tablas se detectan e indexan tanto de forma automática en el momento de la inferencia como periódicamente en segundo plano. La compensación en cuanto a precisión merece la pena, ya que la gran mayoría de las tablas empresariales fundamentales tienen una larga vida útil y ya están indexadas. 

También debemos plantearnos cómo gestionar la incorporación de nueva información. ¿Cómo decidimos cuándo los nuevos patrones de unión o las incrustaciones de documentos aportan valor a las consultas de los usuarios? Por defecto, estas fuentes se marcan como inactivas y deben superar un umbral de evaluación antes de que el propietario del dominio las promueva. Los propietarios de dominio también pueden activar la promoción totalmente automatizada para su área. 

Además, cada fuente de conocimiento y cada habilidad incluye información sobre su procedencia hasta el material original; un proceso de detección de cambios comprueba periódicamente si hay diferencias con respecto al material original. Los cambios sustanciales dan lugar a una propuesta de cambio que pasa por una cola de aprobación y está sujeta a los mismos criterios de control que las evaluaciones.

Evaluaciones y calificaciones

Los propietarios de dominios y los usuarios habituales han aportado más de 1.900 evaluaciones; cada propietario de dominio revisa cada aportación de los usuarios antes de que se tenga en cuenta. Cada evaluación es calificada por un juez de LLM en función de tres preguntas: 

  1. ¿Utilizó el agente las herramientas adecuadas?
  2. ¿Se utilizaron las tablas correctas en este enfoque?
  3. ¿Era correcta la respuesta final?

Presentamos el agregado ponderado de estas respuestas como puntuación global. El modelo de evaluación se calibró de forma iterativa en varias fases clave. La desviación más notable fue una tendencia a penalizar en exceso las respuestas correctas cuando las tablas eran equivalentes, pero no exactas. Las recalibraciones garantizaron que el modelo fuera robusto ante imprecisiones numéricas, aceptara fuentes de datos equivalentes e ignorara diferencias menores de formato. 

La cuestión operativa fundamental es: ¿cómo podemos recabar evaluaciones en toda la empresa que no sean triviales, no se repitan y sean representativas del trabajo analítico real, sin suponer una carga para los responsables de cada área? 

Hemos incorporado en Vera una serie de herramientas que complementan las evaluaciones manuales mediante el análisis de los resultados del trabajo diario, como los hilos de Slack y los tickets de Jira. Un modelo de vanguardia lee cada resultado del trabajo y elabora un borrador de propuesta de evaluación completa, que incluye la pregunta, una consulta SQL o una rúbrica, y una calificación de complejidad. 

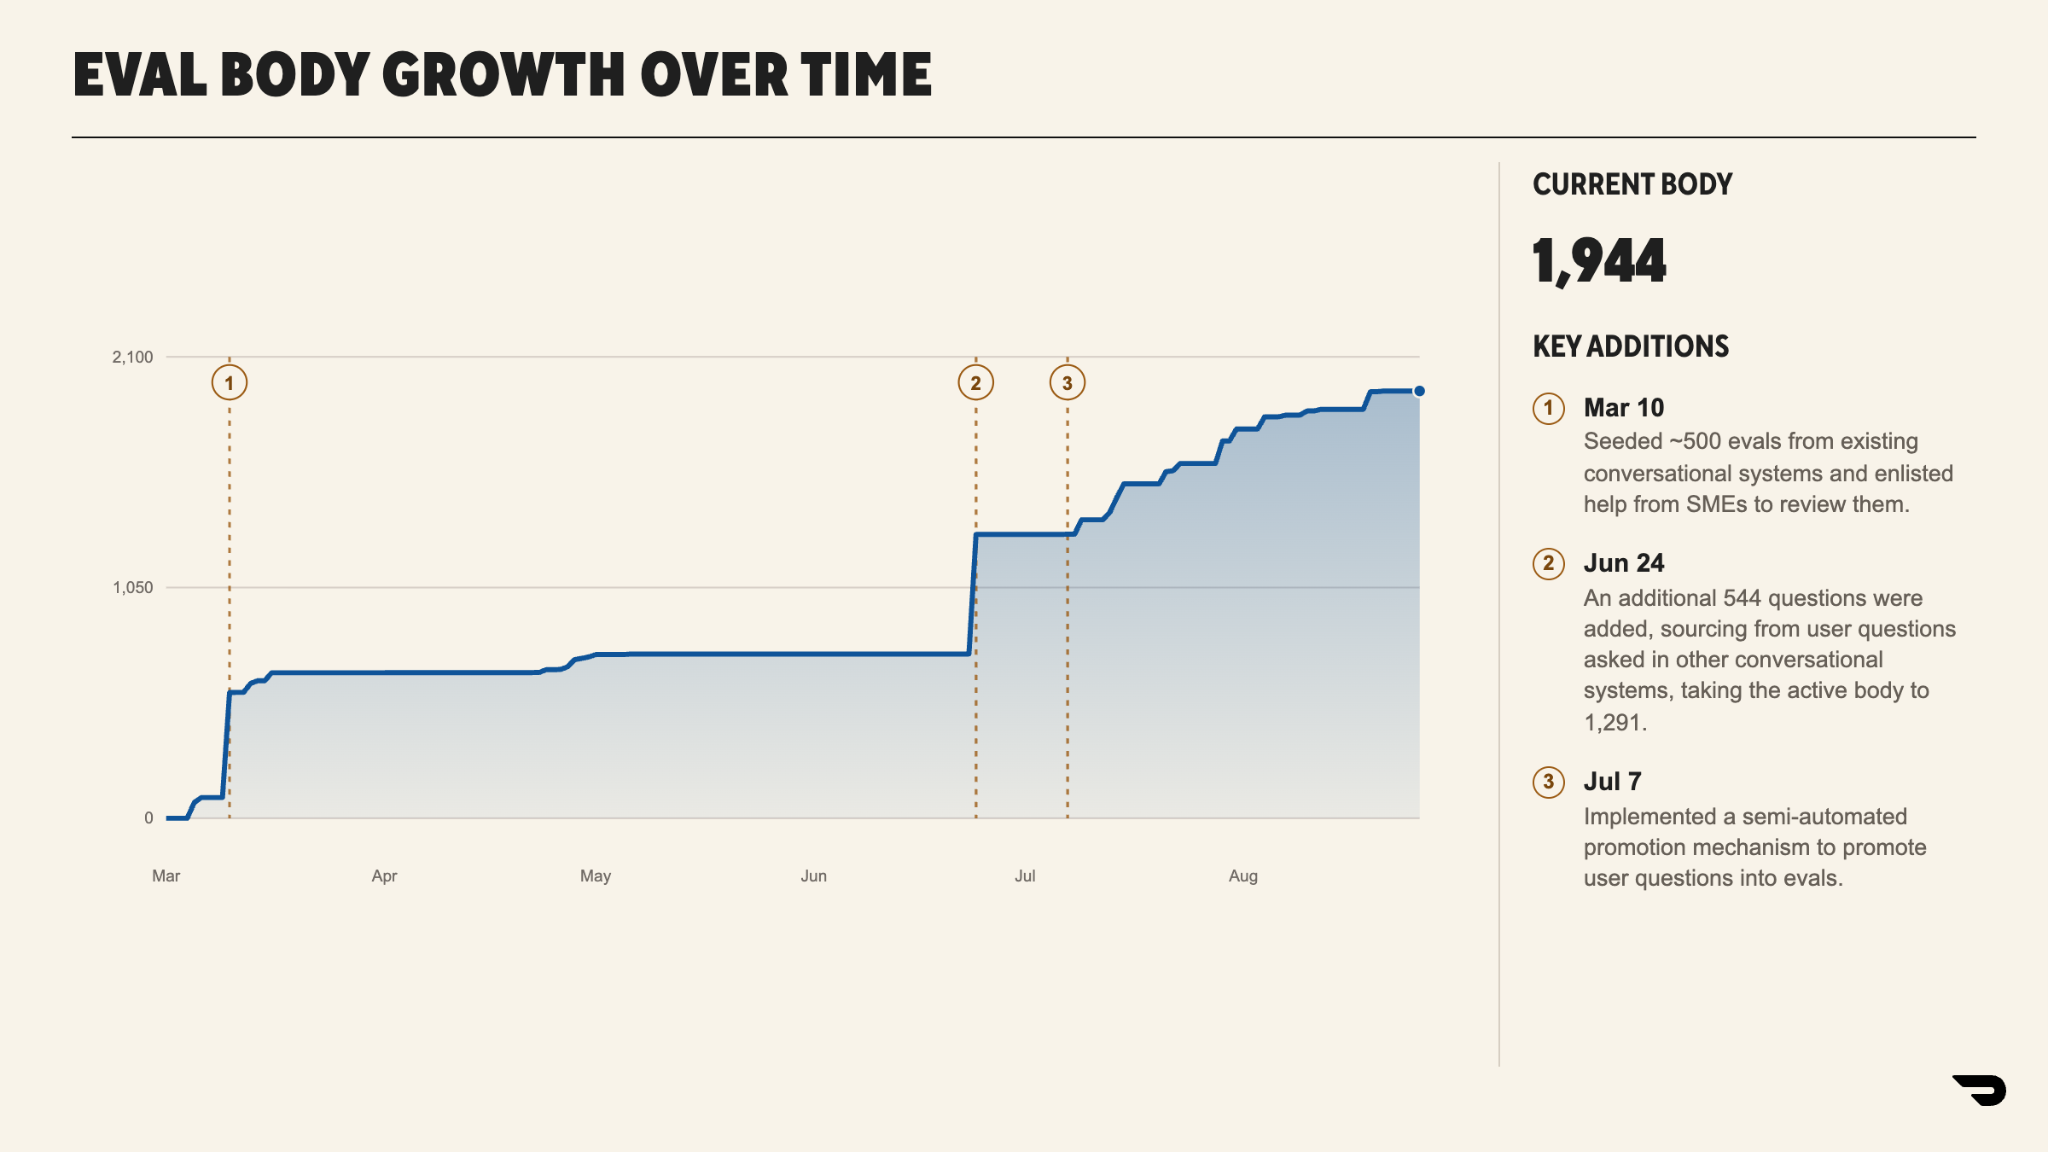
A continuación, los propietarios de los dominios revisan cada propuesta y deciden si la incluyen o la excluyen del conjunto de evaluaciones. Hemos comprobado que esto supone un mejor aprovechamiento del tiempo de los expertos que pedirles que redacten evaluaciones desde cero. Esto ha dado lugar a un número significativamente mayor de evaluaciones que ofrecen una cobertura más amplia, tal y como se muestra en la figura 7: 

Figura 7: Evolución del conjunto de evaluación, con las tres incorporaciones que lo han configurado. Los dos picos corresponden a importaciones masivas revisadas por los propietarios de los dominios, y el aumento constante a partir de julio se debe al proceso de extracción y promoción.

Garantizar la calidad a esta escala resulta cada vez más complicado. Eliminamos automáticamente las preguntas casi duplicadas mediante un indicador de similitud; los responsables de cada ámbito aceptan el 95 % de las preguntas restantes durante la revisión. 

Abordar la complejidad

Aunque Vera se centra en responder a preguntas de carácter coloquial, los conocimientos generales y los comportamientos adquiridos tras el entrenamiento de los modelos subyacentes les permiten abordar preguntas considerablemente más complejas. Utilizamos una taxonomía aproximada de la dificultad de los problemas:

  • Nivel 1: Preguntas descriptivas con definiciones conocidas y patrones seleccionados, incluyendo la extracción de métricas, tendencias, desgloses y comprobaciones de validez
  • Nivel 2: Análisis que podrían influir en las decisiones empresariales o de producto, incluyendo la priorización, la selección de objetivos, la evaluación del alcance de las oportunidades y la asignación de recursos
  • Nivel 3: Preguntas que requieren una interpretación más profunda y una mayor responsabilidad, incluyendo análisis causales, resultados de experimentos, previsiones comprometidas y apoyo a la toma de decisiones de gran importancia

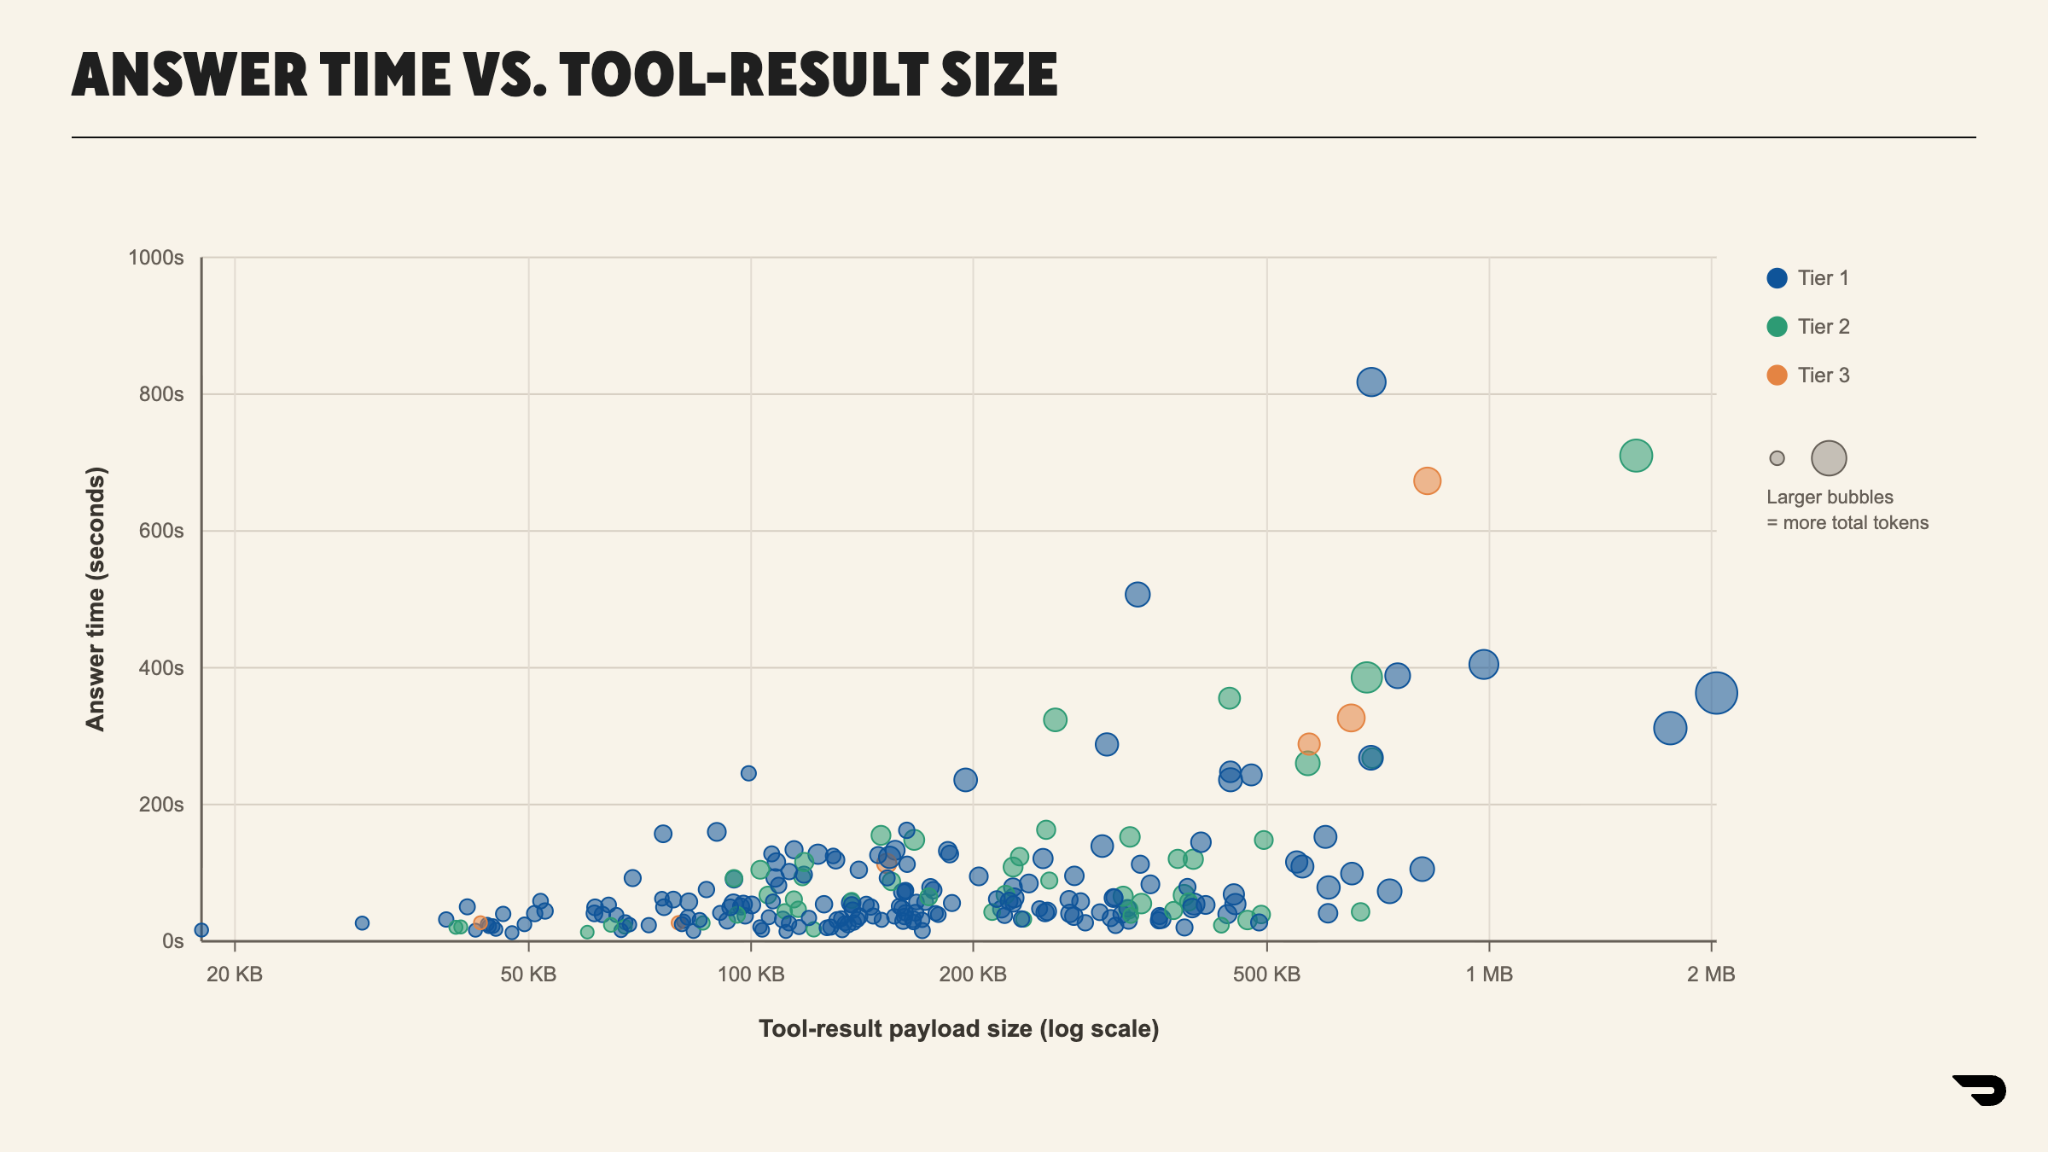
Dado que el solapamiento entre los niveles es elevado, puede resultar complicado clasificar las consultas en categorías bien diferenciadas; sin embargo, resulta ilustrativo a la hora de analizar el esfuerzo que requiere el modelo para las consultas más complejas, tal y como se muestra en la figura 8: 

Figura 8: Tiempo de respuesta en función de los datos recuperados por cada ejecución desde las herramientas. Las preguntas de los niveles 2 y 3 se concentran en cargas útiles más grandes y ejecuciones más largas, por lo que las preguntas más difíciles suponen un mayor coste en términos de datos y tiempo, y no solo de razonamiento.

En el caso de las consultas más complejas del Nivel 3, observamos que los modelos tendían a detenerse prematuramente y de forma optimista. Aunque existía información relevante para responder a la consulta, el modelo solía ofrecer respuestas superficiales —aunque plausibles— sin profundizar más. 

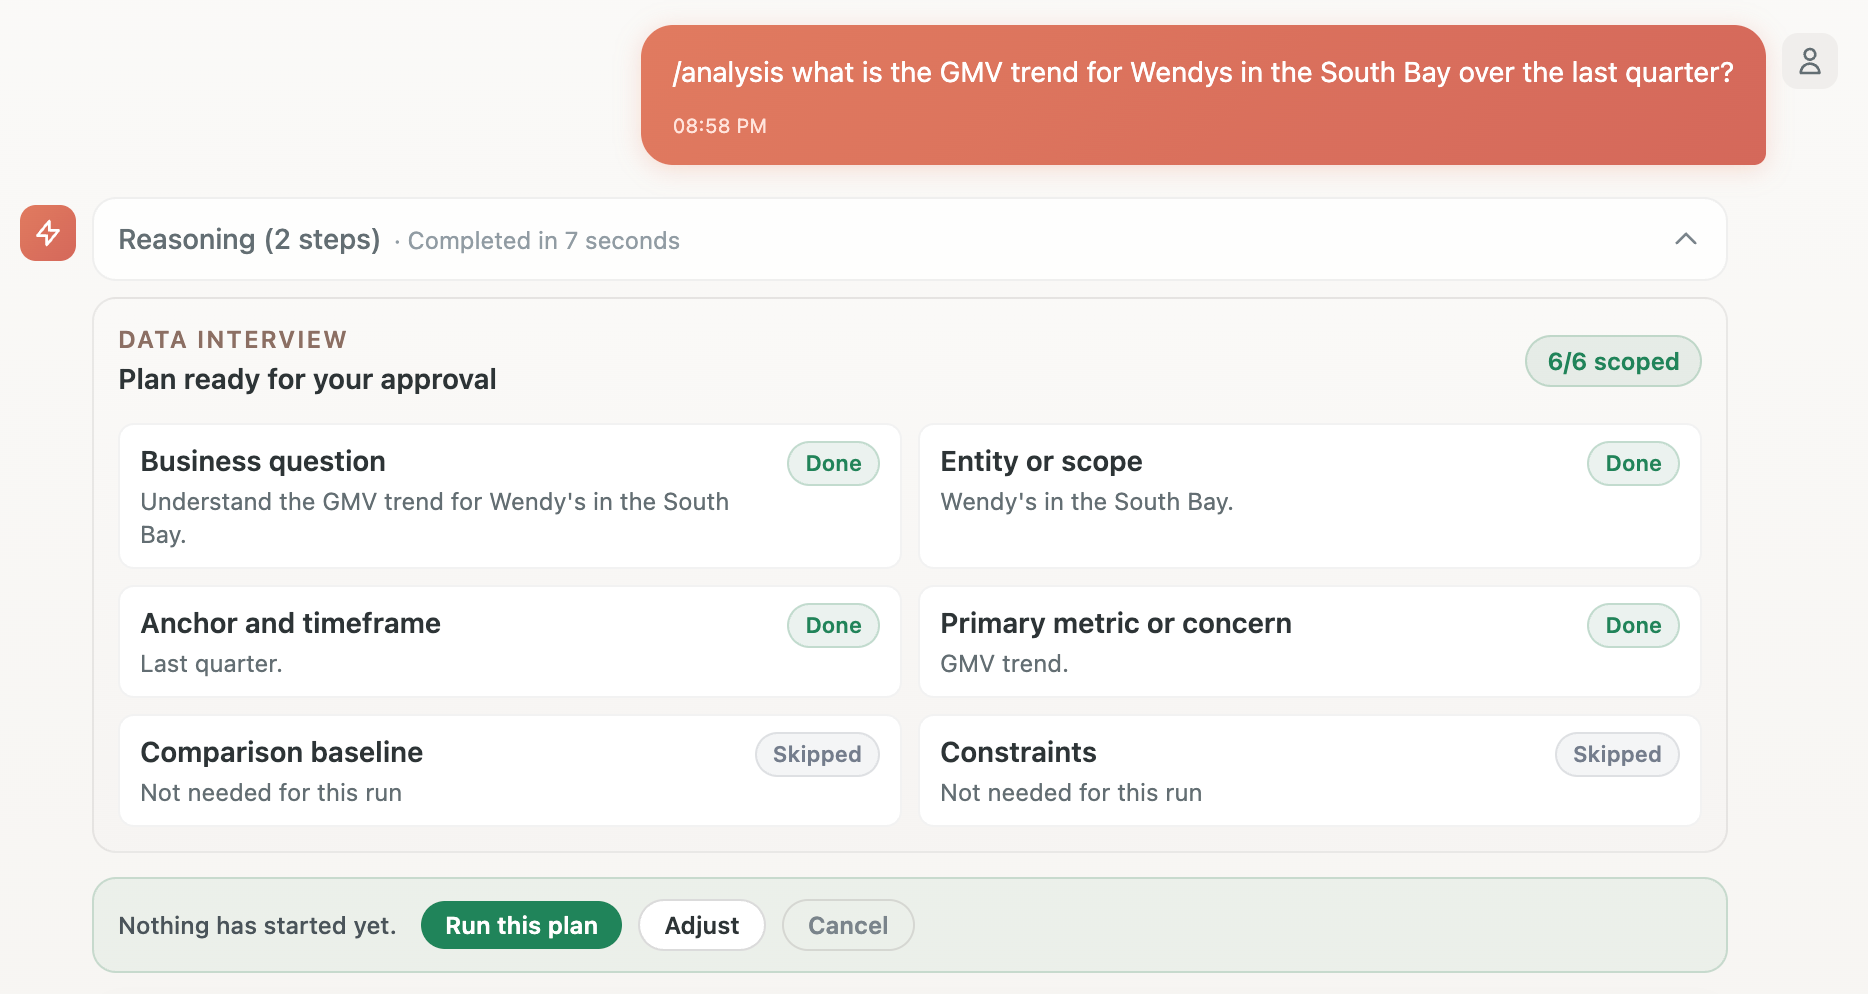
Para estas preguntas, creamos un flujo de análisis que hacía que el modelo realizara la detección de problemas y la planificación antes de la ejecución, tal y como se muestra en la figura 9: 

Figura 9: Flujo de análisis de Vera sobre una consulta relativa a las tendencias de un comerciante. El plan se muestra antes de que se ejecute ninguna consulta, y no se lleva a cabo ninguna acción hasta que el usuario lo apruebe o lo modifique.

Es aquí donde el agente define los plazos, los indicadores deseados, el alcance pertinente y cualquier restricción que el usuario quiera aplicar. Hemos constatado que una fase de planificación estructurada mejora el rendimiento de estas evaluaciones de nivel 3, aunque con una gran variabilidad —con una tasa de aprobados que oscila entre el 64 % y el 100 %— en una pequeña muestra de 14 casos, lo que pone de manifiesto la necesidad de contar con comentarios más amplios y profundos por parte de expertos en estas áreas. 

De ahora en adelante, abordaremos como prioridad estas cuestiones más complejas y subjetivas del Nivel 3. 

Conclusiones

A lo largo del proyecto, la tasa de superación pasó del 43 % al 90 %, mientras que el tamaño del conjunto de evaluación se duplicó dos veces. Las mejoras en la inteligencia de los modelos subyacentes contribuyeron a impulsar el rendimiento, pero fue la ingeniería de datos en torno al conjunto de pruebas lo que resultó tener un mayor impacto. 

Aún quedan muchas cuestiones por resolver:

  1. ¿Cómo podemos seguir manteniendo la calidad al tiempo que reducimos el coste por respuesta?
  2. ¿Cómo podemos diseñar evaluaciones en torno a cuestiones y informes de análisis de datos más complejos?
  3. ¿Cómo influyen unos análisis más rápidos y de mayor calidad en las métricas clave del negocio?

A medida que desarrollamos la inteligencia de análisis de datos en DoorDash, abordaremos estas cuestiones pendientes en próximas entradas de esta serie.

Colaboradores: Pavel Astakhov, Andy Fang, Jash Radia, Naveen Srinivasan, Helen Lin, Lokesh Sharma, Adnan Sheikh, Gun Johnson, Harsha Venkat Annapa Reddy

En DoorDash contamos con numerosos equipos de ingeniería que dan soporte a nuestras áreas de ingeniería. Este documento ofrece una visión general de nuestras áreas de ingeniería y de los equipos que les dan soporte:

  1. Dasher & Logística
  2. Fundamentos
  3. LaunchPad e investigación en IA
  4. Mercado
  5. Plataforma para comerciantes y consumidores
  6. Nuevas verticales
  7. Excelencia operativa
  8. Servicios de la plataforma
  9. DashOS
  10. Dinero
  11. Anuncios y promociones

Esperamos que estos perfiles te sirvan de referencia útil a la hora de responder a nuestra encuesta de selección de equipo. 

Dado que nuestros equipos están en constante evolución, este documento ofrece una visión general de nuestra organización de ingeniería actual. Ten en cuenta que es probable que sufra cambios de aquí a tu fecha de incorporación. Por lo tanto, a la hora de tomar decisiones sobre la asignación a un equipo, nos centraremos en el tipo de trabajo que te interesa. Además de tus preferencias y tu formación técnica, tendremos en cuenta la capacidad del equipo y otros factores organizativos.

Nota: A lo largo del documento se utilizan abreviaturas para designar nuestros principales segmentos de clientes —Comerciante (Mx), Consumidor (Cx) y Repartidor (Dx)—, además de Restaurantes (Rx).


Dasher & Logística

El equipo de Dasher & Logistics (DxLx) es el motor de la red de reparto de DoorDash: impulsa la ejecución de cada pedido con inteligencia, precisión y a gran escala. Desde el «cerebro» logístico que asigna rutas a los Dashers y equilibra la oferta y la demanda, hasta las plataformas y los productos que crean una experiencia cohesionada y gratificante para los Dashers, este equipo garantiza que cada entrega se realice de forma eficiente y fiable.

Nuestra visión es crear una red de logística de la máxima calidad y al menor coste, para que se convierta en la primera opción para los trabajadores autónomos y los comerciantes de todo el mundo. DxLx se sustenta en dos pilares fundamentales:

  • Logística: Crea una plataforma logística global de última milla de primer nivel que opera a la vanguardia de la ingeniería, la ciencia y las infraestructuras. El equipo amplía continuamente los límites de la velocidad, el coste, la eficiencia y la fiabilidad, lo que permite realizar millones de entregas cada día.
  • Dasher: Dedicado a ofrecer a los Dashers libertad de elección, estabilidad y oportunidades. Este equipo está creando la mejor plataforma de trabajos esporádicos del mundo, fomentando la fidelización, el crecimiento y la satisfacción a través de modelos de empleo innovadores, recompensas y programas de participación.

DxLx constituye el núcleo de la experiencia DoorDash: transforma la forma en que se transportan las mercancías por las ciudades y facilita la vida a millones de personas en todo el mundo.


Fundamentos

El equipo de Foundations se encarga de desarrollar la infraestructura básica, los datos y las plataformas para desarrolladores que sustentan todos los productos y servicios de DoorDash. Como columna vertebral de ingeniería de la empresa, combinan la infraestructura y los datos para crear una base fluida, segura y escalable sobre nuestro ecosistema en la nube de AWS. La organización se articula en torno a tres pilares fundamentales:

  • Plataforma para desarrolladores: Permite a los ingenieros avanzar con rapidez y desarrollar con confianza gracias a una experiencia de desarrollo de primer nivel basada en plataformas modernas, fiables y de alto rendimiento.
  • Infraestructura básica: Ofrece sistemas seguros, eficientes y resistentes que permiten a los ingenieros crear productos excelentes con rapidez y a gran escala.
  • Datos básicos: Aúna el trabajo de ingeniería de datos y de la plataforma de datos para garantizar que la empresa funcione con datos fiables y de alta calidad, y para acelerar la innovación de productos basada en datos en toda DoorDash.

En septiembre de 2025, los equipos de Foundations de DoorDash y Wolt se unieron para ampliar Pedregal y construir el futuro juntos, guiados por principios comunes como mantener el negocio en marcha, un liderazgo unificado, la responsabilidad geográfica, el respeto a las zonas horarias y la asignación del talento adecuado a los problemas adecuados.

«Foundations» es la plataforma sobre la que se sustenta todo el negocio, y aún hay mucho margen para definir cómo se ampliará a medida que DoorDash crezca, lo que potenciará la fiabilidad, el rendimiento y la rapidez en todo lo que hacemos.


LAUNCHPAD E INVESTIGACIÓN EN IA

La misión de LaunchPad es innovar, experimentar y desarrollar ideas audaces. El equipo está diseñado para actuar con rapidez, convirtiendo rápidamente ideas prometedoras en prototipos reales para que DoorDash pueda determinar en qué merece la pena seguir invirtiendo. Junto a LaunchPad, DoorDash AI Research es un equipo de investigación aplicada que explora cómo las últimas capacidades de inteligencia artificial pueden transformar el funcionamiento del negocio de DoorDash.

La organización abarca dos áreas principales:

  • Proyectos «de 0 a 1»: LaunchPad se encarga de ideas nuevas y con gran potencial en todo el ecosistema de productos de DoorDash, el tipo de proyectos que podrían convertirse en un nuevo negocio importante o aportar una nueva funcionalidad significativa a la plataforma. 
  • Investigación en IA: Explora cómo las últimas capacidades de la IA pueden mejorar DoorDash, desde aumentar la productividad de los ingenieros hasta crear agentes de IA capaces de actuar en nombre de los clientes, los comercios y los repartidores, pasando por ayudar a la empresa a comprender y utilizar mejor sus propios datos.

Dado que tanto LaunchPad como AI Research se dedican a probar las próximas novedades antes de que se conviertan en una parte consolidada del negocio, formar parte de esta organización significa trabajar en algunas de las ideas más incipientes y exploratorias de DoorDash.

LaunchPad está dirigida por Andy Fang, cofundador de DoorDash.


Mercado

Panorama general del mercado  

La organización Marketplace impulsa el intercambio de productos entre compradores y vendedores en múltiples sectores, ofreciendo confianza, calidad y experiencias fluidas a gran escala. Su misión es crear componentes básicos y ampliables que permitan a los equipos lanzar funciones innovadoras con confianza y rapidez. Marketplace se articula en torno a tres pilares fundamentales, cada uno de los cuales impulsa la experiencia del consumidor de formas únicas y significativas:

  • Core Consumer: Se encarga de gestionar todo el proceso de pedido de principio a fin, creando una experiencia de compra rápida, intuitiva y agradable para todos los clientes, en cualquier lugar.
  • Crecimiento de la base de usuarios: Acelera la expansión de DoorDash mediante análisis basados en datos, experimentación y optimización continua, desde el inicio de sesión hasta la finalización de la compra y más allá.
  • DashPass: Se encarga de gestionar nuestro negocio de suscripciones, centrándose en el crecimiento, la participación y la retención. El equipo de Participación impulsa la incorporación y la adopción temprana, ayudando a los clientes a disfrutar del valor de DashPass desde el primer día, mientras que el equipo de Retención se asegura de que los miembros sigan conectados y continúen apreciando el valor a lo largo de su experiencia.

El equipo de Marketplace sienta las bases de la experiencia DoorDash, conectando a millones de clientes con los comercios locales que les encantan, de forma más rápida y fiable que nunca.


PLATAFORMA PARA COMERCIANTES Y CONSUMIDORES

El equipo de la plataforma MxCx desarrolla plataformas de primer nivel que aceleran el desarrollo de productos y garantizan una fiabilidad, una observabilidad y una seguridad excepcionales. Su misión es empoderar a nuestros clientes al tiempo que impulsan el crecimiento de DoorDash en todas las experiencias.

El equipo se centra tanto en la experiencia de los comerciantes (Mx) como en la de los consumidores (Cx), y se encarga de todo, desde la incorporación de comerciantes hasta las aplicaciones para clientes de alto rendimiento. Las áreas clave incluyen:

Captación de comerciantes: identifica e incorpora a nuevos restaurantes asociados mediante datos inteligentes y herramientas de autoservicio de fácil manejo.

  • Mx Tablet: el hardware y la aplicación que facilitan la gestión de pedidos en tienda para los comerciantes.
  • Business Manager: una aplicación móvil que permite a los empresarios gestionar y hacer crecer sus negocios en cualquier momento y desde cualquier lugar.
  • Plataforma de pedidos: la base para gestionar el ciclo de vida de los pedidos de DoorDash, que permite a los ingenieros desarrollar nuevas funciones con rapidez y fiabilidad.
  • Plataforma MxCx Client: Permite a los ingenieros de aplicaciones de consumo crear de forma segura y eficiente aplicaciones de alto rendimiento y fiables para web, iOS y Android, lo que fomenta la calidad y la coherencia a gran escala.

El equipo de la plataforma MxCx está configurando la columna vertebral del ecosistema de DoorDash, creando las herramientas, los sistemas y las plataformas para clientes que impulsan el crecimiento de millones de usuarios y empresas cada día.


NUEVOS SECTORES

El equipo de New Verticals (NV) está ampliando DoorDash más allá de los restaurantes: está creando una plataforma para el comercio local y permitiendo a los clientes acceder a cualquier producto de su ciudad. Desde alimentos y artículos de primera necesidad hasta productos para mascotas, bebidas alcohólicas, artículos para el hogar y productos de belleza, NV está redefiniendo la forma en que la gente compra en su zona.

Nuestra misión es convertir a DoorDash en el socio de referencia para los productos de primera necesidad, ayudando a las familias y a las personas a conseguir lo que necesitan, cuando lo necesitan. El equipo aborda retos complejos propios de la logística minorista, ampliando los sistemas para gestionar inventarios enormes y dinámicos, mejorando la precisión de los datos y optimizando la experiencia de los repartidores en diversos modelos de entrega, como la compra de alimentación y la entrega por artículos.

Dentro de NV, hay cinco pilares principales (NV Categories, NV Consumer, NV Fulfillment, NV Merchant + Selection y NV Machine Learning) con numerosos equipos secundarios que impulsan la innovación. Además, el equipo de DashMart se encarga de la tienda virtual de alimentación y productos de conveniencia de Dash, de la que es propietaria al 100 %, que gestiona y cuya oferta selecciona para ofrecer la próxima generación de compras «todo bajo demanda».

¡A los ingenieros del equipo de NV nunca les faltarán retos y tendrán oportunidades increíbles para dejar huella en el comercio local!


EXCELENCIA OPERATIVA 

La misión del equipo de Excelencia Operativa (OpEx) es generar confianza e impulsar la eficiencia a través de la innovación y la automatización. Si los consumidores, los comerciantes o los repartidores no pueden confiar en que el mercado es justo y fiable, nuestro negocio no tiene sentido. OpEx se compone de cuatro áreas clave:

  • Experiencia de entrega: garantiza un seguimiento fluido y transparente del pedido, así como asistencia una vez realizado el pedido.
  • Fraude: vela por la equidad del mercado mediante la prevención y la detección de actividades fraudulentas.
  • Confianza y seguridad: fomenta la confianza entre los repartidores, los comerciantes y los consumidores mediante la verificación de la identidad y el cumplimiento normativo.
  • Plataforma de riesgo e identidad: amplía estos esfuerzos de forma eficiente mediante plataformas dedicadas al riesgo, los datos, las cuentas y las soluciones de aprendizaje automático e inteligencia artificial.

Como ingeniero del equipo de Ingeniería de OpEx, te encargarás de impulsar los sistemas que mantienen nuestra plataforma eficiente, justa y segura a gran escala. Ya sea luchando contra el fraude en tiempo real, garantizando pagos fluidos, mejorando las experiencias de entrega o reforzando la confianza y la seguridad, tu trabajo tendrá un impacto en millones de personas. Desarrollarás código relevante, colaborarás con otros departamentos y crecerás rápidamente en un entorno dinámico y con un alto grado de autonomía.


SERVICIOS DE LA PLATAFORMA

El equipo de Servicios de Plataforma está desarrollando el sistema operativo para todos los restaurantes, tiendas de alimentación y comercios minoristas, lo que permite a las empresas locales prosperar en la economía de la comodidad. Su misión es crear el software y el hardware que ayuden a los comerciantes a impulsar y ampliar sus propios negocios directos. Los ingenieros del equipo trabajan en cinco áreas de gran impacto:

Pedidos digitales: una solución de marca blanca que aprovecha la tecnología y el alcance de DoorDash para ayudar a los comercios a aumentar sus ventas directas por Internet.

  • Fidelización omnicanal: un programa de fidelización con la marca del comercio que permite a los clientes acumular y canjear recompensas de forma fluida: en línea, en tienda y en DoorDash.
  • Pedidos por voz: un servicio de voz de alta calidad que permite a los empleados de la tienda centrarse en los clientes mientras nosotros nos encargamos de las llamadas.
  • Drive: un servicio de logística como servicio que permite a los comerciantes utilizar la flota de Dasher para entregar los pedidos que se les realizan directamente a ellos.
  • DoorDash for Business (DDfB): Soluciones empresariales que permiten a las empresas ofrecer a sus empleados prestaciones gastronómicas como DashPass for Work, Expensed Meals, Group Orders y tarjetas regalo corporativas.
  • El equipo de Servicios de Plataforma está sentando las bases para la próxima generación del comercio local, ayudando a todos los comerciantes a conectar con sus clientes en cualquier momento y en cualquier lugar.

DashOS

DashOS es un equipo de ingeniería creado para conectar a los comerciantes con sus clientes de principio a fin. El equipo aúna en una sola unidad las capacidades que antes se distribuían entre distintos productos y regiones.

DashOS abarca tres áreas principales:

  • Operaciones en tienda: los sistemas que utilizan los comerciantes para gestionar su negocio en el día a día: puntos de venta, quioscos y sistemas de visualización en cocina.
  • Tienda online para comerciantes y programas de fidelización: las herramientas que permiten a los comerciantes crear su propia tienda online con su marca y gestionar sus propios programas de fidelización y recompensas.
  • Restaurantes y reservas: La vertiente del negocio dirigida al consumidor, que ayuda a las personas a descubrir, reservar y disfrutar de experiencias gastronómicas y de hostelería.

Dado que DashOS reúne a equipos que antes trabajaban por separado, formar parte de esta organización significa contribuir a la creación de plataformas compartidas a escala global, sin dejar de dar forma a la experiencia de producto que viven los comerciantes y los comensales en cada mercado local.


Dinero

La misión del equipo de Money es ofrecer productos de pagos y servicios financieros atractivos e innovadores para Cx, Dx y Mx, y actuar como catalizador del crecimiento empresarial tanto en términos de ingresos como de beneficios.

Actúan tanto como plataforma como equipo de producto, y su principal responsabilidad es gestionar todas las transacciones financieras de nuestra plataforma. Esto abarca desde el cobro a los clientes hasta el pago a Mx y Dx, todo ello garantizando que cada dólar se contabilice con precisión.

La organización se sustenta en tres pilares:

  • Pagos: la infraestructura básica que sustenta todas las transacciones en DoorDash: cómo pagan los clientes, cómo se les abona a los repartidores y a los comercios, y cómo se facturan las suscripciones como DashPass.
  • Productos financieros: Productos financieros destinados directamente a los Dasher, los consumidores y los comercios, como las tarjetas regalo, la tarjeta Crimson y otras ventajas para los Dasher, así como la financiación para comercios.
  • Cumplimiento normativo financiero: Garantiza que cada dólar que pasa por DoorDash se controle y concilie adecuadamente, y que cumpla con la normativa financiera vigente en todo el mundo.

El equipo de Money gestiona miles de millones de dólares al año, y sus innovaciones en materia de pagos —como las tarjetas regalo— han aportado millones de dólares al valor bruto de los pedidos anual incremental, lo que pone de relieve el importante impacto que tienen los sistemas y productos financieros del equipo de Money en el negocio de DoorDash.


Anuncios y promociones

El equipo de Publicidad y Promociones ayuda a los restaurantes, comercios y marcas a llegar a los clientes y hacer crecer sus negocios en DoorDash. La organización se estructura en torno a dos áreas: publicidad y promociones.

  • Anuncios: Al combinar datos potentes con una ubicación inteligente, el equipo de Anuncios conecta a los anunciantes con las audiencias adecuadas, lo que impulsa la visibilidad, la conversión y el crecimiento. Se basa en tres pilares: la oferta (la experiencia del cliente), la demanda (la experiencia del anunciante) y la entrega (el motor basado en aprendizaje automático que conecta ambos en tiempo real). El equipo gestiona dos líneas de negocio: «Restaurant Ads», que ayuda a los restaurantes a destacar ante los clientes hambrientos, y «CPG Ads», que pone de relieve las marcas de consumo diario, con el respaldo de los equipos de «Ads Foundation» y «Ads Data» entre bastidores.
  • Promociones: gestiona los descuentos y las ofertas que ven los clientes en toda la aplicación —desde la página de inicio hasta el proceso de pago—, lo que ayuda a los comerciantes a generar más pedidos y a los clientes a ahorrar dinero.

De cara al futuro, el equipo está trabajando para integrar mejor los anuncios y las promociones en una única experiencia más automatizada para los comerciantes. Ambos negocios están creciendo rápidamente y esto no ha hecho más que empezar: únete a nosotros para construir el próximo motor de crecimiento de DoorDash.


Esta entrada aborda los límites del cliente y de la plataforma que subyacen a la experiencia de usuario y a las interacciones con Ask DoorDash: cómo pasamos de los carruseles de hackatones a ese modelo, cómo un mismo artefacto da servicio a tres lectores y cómo el contexto y el estado se mantienen coherentes a medida que los usuarios navegan por DoorDash. A continuación, «Creación del asistente de DoorDash: una visión general desde el punto de vista de la ingeniería» y nuestros análisis en profundidad «Creación de Ask DoorDash (Parte 2): Inteligencia», «Creación de Ask DoorDash (Parte 3): Evaluación», y Creación de Ask DoorDash (Parte 4): una plataforma para crear y desarrollar agentes.


Ask DoorDash convierte peticiones como «prepárame una cena de 60 dólares para 10 personas», «ayúdame a hacer tacos de pollo» y «aperitivos para toda la semana» en listas de la compra editables. Genera una lista con productos que se pueden comprar, precios, fotos, controles de cantidad y botones sencillos para cambiar cualquier artículo y finalizar la compra. En el caso de las peticiones relacionadas con restaurantes, se muestran establecimientos y platos que se integran en el flujo de compra nativo. Ambas funcionalidades se ejecutan en el mismo cliente y en la misma infraestructura de la plataforma. Este artículo se centra en el caso de uso de la compra de alimentación, ya que es el que plantea mayores dificultades a la hora de crear una interfaz intuitiva para las compras gestionadas por un agente. Las listas de la compra suelen contener entre diez y veinte artículos, pasan por varias rondas de revisión y deben adaptarse fácilmente a las limitaciones de los consumidores, como el presupuesto y las restricciones dietéticas.

Las sesiones de usuarios de julio de 2026 mostraron que, en las sesiones relacionadas con la compra de alimentación en las que se mostraba una lista de la compra, los consumidores realizaban una media de casi dos interacciones con la interfaz de usuario cada uno. Aproximadamente un tercio de esas sesiones continuaron con la aplicación de la lista al carrito. El asistente recoge la intención general de los consumidores y la sintetiza. El resultado son componentes nativos, que permiten a los consumidores realizar ajustes detallados. Las modificaciones sencillas actualizan inmediatamente un elemento de referencia, mientras que los cambios que requieren razonamiento dan inicio a un nuevo turno del agente.

Para crear una experiencia de compra colaborativa eficaz entre el consumidor y el agente, los agentes de compra deben integrarse en una interfaz interactiva basada en datos de comercio en tiempo real y en el contexto actual de la aplicación del consumidor. Cuando un consumidor está comprando en una aplicación, espera ver de un vistazo artículos reales que pueda adquirir. El texto puede describir ese entorno, pero los componentes interactivos basados en imágenes permiten a los consumidores recorrerlo realmente. El contexto también es importante. Los consumidores que abren DoorDash llegan con expectativas diferentes a las que tienen al utilizar una aplicación de chat de uso general. Compran navegando, pasando de una tienda a otra y de una página a otra, en lugar de describir lo que quieren. Salirles al encuentro allí donde se encuentran es una pieza esencial del rompecabezas.

Las grandes cosas tienen un pequeño comienzo

El asistente de compra de DoorDash comenzó como un proyecto de hackatón. Sabíamos desde el principio que la integración de los componentes existentes de DoorDash sería una pieza clave de cualquier cosa que construyéramos. Las primeras versiones se basaban en gran medida en carruseles: primero, una lista de tiendas cercanas; después, un carrusel con los resultados de búsqueda para cada artículo que buscaba el agente. Se mostraban en línea, cada uno con su término de búsqueda adjunto. El resultado era, básicamente, una transcripción de chat con resultados comerciales pegados en ella.

Desde el punto de vista funcional, se parecía mucho a lo que ofrecemos hoy en día. En cuanto a la experiencia de usuario, era más rudimentaria, y merece la pena repasar los detalles.

Una vez encontradas varias tiendas, el asistente preguntaba cuál quería explorar y esperaba a que se escribiera la respuesta. Cada carrusel representaba un único artículo que el consumidor necesitaba, y al elegir una opción de él, ese artículo se añadía al carrito. Cada uno aparecía con sus opciones desplegadas a todo lo ancho y la elección aún abierta. Así pues, preparar la compra para una semana significaba ir bajando por la lista, selección a selección, sin posibilidad de seleccionar varios artículos a la vez.

Detrás de todo ello se escondía un fallo que afectaba en ambos sentidos: la interfaz se había diseñado principalmente para presentar el trabajo del asistente. Cada carrusel iba precedido de la consulta que lo había generado y los resultados aparecían en el orden en que se habían recuperado. Los términos de búsqueda y los conjuntos de resultados sin procesar son el material de trabajo de un agente. Presentar los resultados directamente es el equivalente, en una interfaz, a imprimir un seguimiento de la pila. El asistente se sometía con la misma facilidad a la interfaz, trabajando con un elemento cada vez, porque lo único que la pantalla podía mostrar era una pila de carruseles por elemento. Cada uno se había diseñado en función de las limitaciones del otro, en lugar de hacerlo en función del usuario.

La lección no era que reutilizar componentes existentes estuviera mal; la familiaridad que aportan es precisamente la razón por la que el asistente se parece a DoorDash. Simplemente habíamos creado el contenedor equivocado para ellos. El contenedor es lo que determina el orden en el que aparecen, junto a qué se sitúan y qué puede hacer el usuario con ellos. Por encima de todo, el usuario necesita una interfaz de compra, más que una interfaz conversacional. Habíamos creado una interfaz conversacional que, casualmente, contenía componentes de compra. La reutilización de componentes nos proporcionó el vocabulario. Lo más difícil fue organizarlo todo en una interfaz de compra.

Lo que sí sobrevivió al hackatón fue la base: la experiencia se ejecuta hoy en día sobre la misma infraestructura de streaming que se estableció entonces. Por su parte, la capa de decodificación que convertía los resultados de las herramientas en una interfaz de usuario no perduró. El asistente ya no muestra en absoluto los resultados de las herramientas. En su lugar, dedicamos tiempo a desarrollar una arquitectura de artefactos que separa los requisitos de los usuarios finales de los requisitos de almacenamiento y de los agentes. En otras palabras: dejamos de decodificar el material de trabajo del agente para su visualización y empezamos a diseñar en función de las necesidades de los diferentes componentes y usuarios del sistema.

Figura 1: La misma solicitud de la compra, con un año de diferencia. La versión creada en el hackatón mostraba un carrusel por artículo, cada uno encabezado por la consulta que lo había generado; la selección se dejaba en manos del consumidor. Hoy en día, el asistente muestra cada lista como una tarjeta en la conversación, con los artículos más solicitados ya seleccionados.

Un objeto, tres lentes

Una lista de la compra tiene tres lectores: el servicio que la almacena, el agente que la revisa y la persona que hace la compra. Cada uno necesita ver algo diferente. Mantenerlos separados es lo que permite que los cambios del consumidor aparezcan de inmediato y sigan siendo válidos sin que ello suponga una nueva iteración del modelo.

El formato almacenado es el sistema de registro: un blob JSON que se guarda como un artefacto en Managed Agent Services, tal y como se describe en la publicación sobre la plataforma. Debe estar completo y es la única copia oficial.

El agente no lee ese bloque de datos directamente. Una lista de la compra interactiva contiene muchos más detalles de los que un modelo necesita para la mayoría de las respuestas. Repetir el nombre de cada producto, el precio, la cantidad, las sustituciones y cada dato de metadatos de visualización en cada turno entraría en conflicto con lo que el consumidor realmente ha solicitado. Por eso, cuando un agente emite un «widget», lo que permanece en el contexto de la conversación es un resumen conciso: la tienda y el contenido de la lista. Cuando un turno requiere el estado exacto, el agente lee el artefacto y obtiene una vista reducida en la que se han eliminado los metadatos de visualización. Esa vista es inequívoca y lo suficientemente pequeña como para procesarla de forma eficiente. Una lista media ocupa entre 40 y 60 KB de JSON. Lo que permanece en el contexto de la conversación es una sola línea de unos 240 caracteres, aproximadamente 250 veces más pequeña.

Lo que ve el consumidor es otra cosa, y adopta más de una forma. En la conversación, la lista se muestra como un widget compacto: la tienda, el nombre de la lista, la hora estimada de llegada, algunas fotos de los artículos y un botón «Añadir al carrito» que indica el total estimado. Eso basta para evaluar la lista de un vistazo sin salir del chat. El botón «Ver lista» abre la vista a página completa, que muestra la lista completa y todo lo necesario para revisarla en detalle. Ambas vistas están diseñadas para que se comprendan al instante y se pueda actuar directamente sobre ellas.

Hay un detalle que pone de manifiesto hasta qué punto divergen estas perspectivas. Cuando el agente elige un producto para un artículo de la lista, conserva los demás productos que coincidían con la misma búsqueda, y el consumidor puede alternar entre ellos con un simple toque. Se mantienen diez opciones por artículo, y el 99,7 % de los artículos tienen suficientes coincidencias para completar esa lista, por lo que casi cada línea en la vista del consumidor tiene una selección y nueve alternativas detrás. La vista del consumidor muestra todas y cada una de esas alternativas. La vista del agente no muestra ninguna de ellas, ya que elegir entre ellas es tarea del consumidor (a menos que se le pida explícitamente al asistente que lo haga).

Figura 2: Una lista, tres perspectivas. El consumidor ve los precios, las fotos y una opción alternativa detrás de cada línea. El agente solo ve la tienda y el contenido de la lista. El artefacto lo recoge todo, incluidas nueve alternativas solo para las láminas de lasaña.

Mantener los pies en la tierra

Si, con un carrito que contiene yogur de frambuesa, pulsas «Recomendaciones para el carrito», aparecen dos sugerencias: muesli, «porque combina bien con tu yogur», y arándanos, «para añadir fruta a tu yogur» (véase la figura 3). El caso de contraste ya existe en nuestro propio producto, en la misma pantalla: la página del carrito incluye un carrusel de artículos complementarios que ofrece productos que el consumidor podría querer añadir, sin indicar ningún motivo. Nuestro agente del carrito podría haber devuelto exactamente eso: una lista de artículos plausibles. Es muy posible que los artículos fueran los mismos en ambos casos. El razonamiento es lo que indica al consumidor que la sugerencia está fundamentada y no es meramente plausible, y dado que cada elemento de la interfaz es también un lugar para actuar, esa distinción tiene una función real.

Eso es lo que aporta el enfoque práctico: la diferencia entre una experiencia de compra atractiva y una simple novedad. Si el resultado del asistente no es tangible, los consumidores tienen pocos motivos para dejar de lado la completa experiencia que ya ofrece la aplicación de DoorDash. El texto sigue cumpliendo su función, pero en un papel secundario. Hemos colocado deliberadamente la lógica del asistente dentro de los widgets y a su alrededor, en lugar de mostrar las celdas de los artículos exactamente como aparecen en el resto de la aplicación.

La integración también debe mantenerse a nivel de los datos, y ahí el trabajo se divide. Un agente elige un tipo de contenido compatible y proporciona los datos comerciales correspondientes; el cliente de iOS se encarga de la presentación y la interacción, adaptando ese contenido a los componentes nativos del sistema de diseño de DoorDash. Una solicitud de compra de comestibles genera una lista de la compra editable con cantidades, sustituciones y un subtotal. Una solicitud de restaurante puede generar fichas de tienda, fichas de productos o sugerencias para el carrito.

Esa división es lo que da validez a los propios datos. Los valores comerciales de un widget no proceden del modelo. Los precios, el inventario, el horario de la tienda y el contenido del carrito se obtienen de los mismos sistemas de registro que utiliza el resto de la aplicación, por lo que un precio que aparece en Ask coincide con el precio de la página de la tienda en ese momento. El contenido tipado también proporciona al backend y al cliente un contrato estable. La implementación de un nuevo widget requiere algo más que un simple cambio. El agente tiene que saber cuándo utilizarlo y qué incluir en él, y el cliente necesita un esquema con nombre, además del código para descodificarlo y representarlo. Más allá de eso, un nuevo widget llega al consumidor a través del mismo mecanismo de conversación y transmisión que cualquier otro.

Figura 3: Dos tipos de sugerencias sobre el mismo carrito. Solo una de ellas explica el motivo.

Los widgets como canales de E/S

Cada nuevo widget que hemos integrado ha hecho que el asistente resulte más funcional. La razón tiene tanto que ver con la entrada como con la salida. Hay un límite que rige todos ellos: una edición determinista permanece en el cliente y se aplica directamente al artefacto, mientras que un cambio que requiera un juicio inicia un turno del agente. Los ejemplos que figuran a continuación se organizan en función de dónde se sitúa esa línea divisoria.

La versión del hackatón preguntaba al usuario qué tienda quería y luego esperaba a que la escribiera. No tenía forma de elegir por sí misma; hoy en día, esa elección es automática. Todavía hay muchas otras preguntas que requieren la intervención del usuario, y el texto directo puede ser una forma poco adecuada de recabar las respuestas. La introducción de texto es una limitación de un solo hilo: el usuario puede saber todas las respuestas, pero solo puede proporcionarlas a la velocidad a la que escribe o habla.

Aquí es donde los widgets cobran sentido. Un consumidor puede tener que realizar diez operaciones en una lista de la compra, todas ellas sencillas. Por separado, son trivialidades; pero, cuando se describen con palabras, se convierten en una tarea compleja. Es la diferencia entre mirar por encima del hombro de alguien y decirle qué botones debe pulsar, y pulsar los botones uno mismo.

Las preguntas aclaratorias estructuradas son el ejemplo más claro, y el patrón se ha tomado prestado de los agentes de programación: la herramienta AskUserQuestion de Claude Code realiza la misma función para los desarrolladores. Ofrecemos un widget que interrumpe al consumidor con un pequeño conjunto de preguntas (de opción múltiple y selección múltiple), lo que le permite dirigir la conversación en momentos verdaderamente abiertos. Se ha convertido en un pilar fundamental del modelo de interacción del agente de supermercados y ahora se está incorporando al agente de restaurantes para simplificar este mismo tipo de interacción. Lo integramos con nuestra plataforma de memoria del consumidor, lo que reduce considerablemente las opciones, pero siguen existiendo lagunas de conocimiento que requieren la aportación del consumidor. Hacer preguntas es inevitable. Pero podemos preguntar de una forma que resulte fácil y eficiente para el consumidor a la hora de responder.

La vista de lista a página completa es donde la colaboración entre entrada y salida se hace tangible. Un consumidor puede modificar la cantidad de un artículo, eliminar un artículo, cambiarlo por una de las alternativas que el asistente ha encontrado junto a él y añadir la lista finalizada a su carrito. Cada una de esas acciones manipula el objeto directamente. Ninguna requiere que el asistente actúe en nombre del consumidor, y ninguna supone una ida y vuelta al modelo de lenguaje grande (LLM). El caso del cambio aprovecha mejor los conjuntos de candidatos de la versión del hackatón. Las alternativas entre las que elige el consumidor son los demás candidatos que el asistente recuperó al seleccionar el artículo. La lista de todas las opciones disponibles para el consumidor ocupaba anteriormente un carrusel. Ahora se encuentran a un solo toque de distancia de la decisión, en lugar de estar dispersas ante el consumidor como una pregunta abierta.

Cambiar de tienda es la excepción, y la excepción es lo interesante. No se trata de una modificación de la lista existente. Se convierte en una solicitud al asistente que reconstruye la lista en la tienda alternativa. Esta interacción también es poco frecuente: fue la primera acción en el 0,1 % de las sesiones activas, lo que se ajusta más o menos a lo que cabría esperar si el límite se establece más o menos en el lugar adecuado. Si se sitúa esa línea en el lugar equivocado, el consumidor o bien espera a que el asistente haga algo que podría haber hecho con un solo toque, o bien tiene que ir tocando para realizar una acción en la que habría sido útil el criterio del asistente.

El artefacto garantiza la seguridad de la división, y las dos partes escriben en él de forma diferente. Un cambio de cantidad, una eliminación o un intercambio siguen la ruta corta: el cliente actualiza la lista in situ y la modificación aparece de inmediato. En cambio, un cambio de almacenamiento inicia un turno del agente, ya que es necesario volver a hacer coincidir toda la lista con un catálogo diferente. Una revisión del agente no sobrescribe lo que había; genera una nueva lista derivada de la anterior.

El resultado es que una modificación directa tiene carácter vinculante. Antes de que un turno modifique la lista, el agente consulta la lista actual en lugar de basarse en la transcripción; por lo tanto, si el consumidor elimina la leche de avena, el siguiente turno comienza con una lista en la que ya no figura la leche de avena.

El comportamiento observado durante ese mismo periodo muestra dónde se sitúa esa línea divisoria. Inmediatamente después de la primera solicitud, casi tres cuartas partes de las primeras acciones siguientes se realizaron a través de un componente. A partir del segundo mensaje, la tendencia se invierte, y las acciones de seguimiento escritas constituyen la mayoría en todos los niveles de profundidad que hemos medido. Los controles se encargan de los ajustes inmediatos y estructurados; el lenguaje toma el relevo cuando el cambio es mayor o más difícil de expresar con un simple toque.

Figura 4: La lista al cruzar el límite de un turno. El consumidor retira las manzanas directamente en la vista de lista, sin necesidad de un intercambio de datos con el modelo. Cuando el cambio de tienda marca el inicio de un nuevo turno, el agente lee el artefacto en lugar de la transcripción, por lo que la lista que reconstruye en la nueva tienda sigue sin incluirlas.

Todas las revisiones de los asistentes permanecen activas

Cuando el asistente revisa una lista de la compra, la versión que sustituye permanece en pantalla y sigue estando disponible.

Esa no fue nuestra primera implementación. La primera versión ocultaba las listas sustituidas: una vez que llegaba una revisión, la lista anterior ya no se podía ver ni editar. Una sola lista actual, sin desorden. Parecía un comportamiento más ordenado. Sin embargo, lo que conseguía era que solicitar una revisión resultara costoso. Si pedir un cambio puede borrar una lista con la que estás satisfecho, lo más seguro es dejar de pedirlo, y eso socava el sentido mismo de un flujo colaborativo.

Así, cada revisión realizada por un asistente genera ahora un nuevo elemento derivado del anterior, y cada uno permanece en el lugar de la conversación donde se creó. Si te desplazas hacia atrás, las versiones anteriores siguen ahí, siguen activas: un usuario puede abrir una lista anterior, editarla o añadirla a su carrito en lugar de la más reciente. Solicitar un cambio no cuesta nada, porque lo que tenía hace un momento está a solo un desplazamiento de distancia.

No todas las listas que elabora el asistente se convierten en una versión que ve el consumidor. Cuando el asistente elabora una lista de opciones y llega a la conclusión de que la tienda no dispone de lo solicitado, esa lista nunca se muestra. Se informa al consumidor mediante un texto de que la tienda no tenía los artículos y de que se le está preparando una nueva lista. Es uno de los pocos casos en los que el texto cumple su función de forma directa, y es la razón que subyace a todo lo demás en esta entrada: la interacción se utiliza para simplificar, y el texto se utiliza para justificar.

Cuando una lista se convierte en un carrito

Un asistente que edite directamente el carrito puede eliminar un artículo que el cliente quería o añadir uno que nunca haya confirmado, sin que se le pregunte. Un solo error de este tipo basta para perder la confianza del cliente, ya que el fallo pasa desapercibido y afecta precisamente a lo que está a punto de pagar.

Por eso, en su lugar, presentamos una lista de la compra como propuesta. Puede contener docenas de artículos y pasar por varias rondas de revisión, ya sea para eliminar un producto de despensa que el consumidor ya tiene, cambiar una cantidad, sustituir un producto o modificar parte de una receta, y nada de ello afecta al carrito. Para confirmar la selección es necesario hacer clic explícitamente en «Añadir al carrito», que es la estructura más sencilla que hemos encontrado y que ofrece al consumidor un control real sin obligarle a supervisar cada paso.

Aún hay que conciliar ambos elementos, y lo interesante es decidir quién lo hace. El asistente lee el contenido del carrito mientras elabora la lista, pero no la ajusta automáticamente para que coincida: si una receta requiere dos plátanos, la lista solicita dos, independientemente de si ya hay cuatro en el carrito. Elaborar la lista con exactamente lo que se ha solicitado y conciliarla con el contenido del carrito en un paso aparte permite que cada decisión se tome en su contexto.

Ese paso se pone de manifiesto en el momento de confirmar la compra. Cuando la lista y el carrito coinciden, se muestran al consumidor los productos duplicados y este decide si desea sustituir esas cantidades o añadir otras. Es un pequeño momento, pero son precisamente los pequeños momentos como este los que determinan si se gana o se pierde la confianza.

Mantener el contexto en DoorDash

No basta con que el asistente se encuentre en un único lugar; debe poder accederse a él desde cualquier parte de la aplicación. Abrir el asistente ya es una señal clara de intención, pero ambigua. En ese momento, un consumidor puede estar haciendo un pedido en su restaurante favorito, comprando la compra para la semana, buscando unos auriculares nuevos o solicitando ayuda con un pedido anterior. Un consumidor que ha accedido a la página web de una tienda de alimentación concreta está enviando una señal mucho más clara: es probable que tenga la intención de crear una cesta de la compra en esa tienda. Facilitar ese contexto al asistente es lo que le permite centrarse en la intención probable en lugar de tener que preguntar.

El sistema de ámbito que hemos diseñado para esto abarca tanto el cliente como la pasarela. El cliente adjunta a cada solicitud datos clave sobre el contexto de la entrada: el tema bajo el que se ha registrado el usuario (supermercado, restaurante), la tienda que está consultando y algunos identificadores relacionados. La pasarela utiliza el tema para decidir a qué agente se deriva la solicitud, y el resto de datos para proporcionar a las herramientas los identificadores que necesitan.

Scope es, deliberadamente, un conjunto plano de pares clave-valor en lugar de un esquema tipado, y es el cliente quien decide qué se incluye en él. Las claves no reconocidas se transmiten tal cual, en lugar de rechazarse, por lo que una nueva superficie puede empezar a enviar contexto sin tener que esperar a que se produzca un cambio en la pasarela. La excepción es el propio tema: añadir uno nuevo implica indicar a la pasarela a qué agente debe dirigirlo. Así pues, aunque crear una nueva superficie es sencillo, crear un nuevo dominio no lo es.

El tema es también la parte que se aplica únicamente al primer mensaje de un contexto. Eso proporciona al asistente una base sólida sobre la que trabajar sin ser excesivamente prescriptivo, y es lo que permite a los usuarios salir de un ámbito cuando así lo eligen explícitamente. Un usuario que utilice el asistente dentro de un restaurante puede salir por completo del ámbito del restaurante pidiéndole: «Búscame una receta para este plato y prepárame una lista de la compra para que pueda prepararlo en casa». Esa solicitud no es gratuita, pero el coste supone un pequeño desvío en el proceso en lugar de un callejón sin salida: el agente del restaurante tiene que reconocer que la solicitud queda fuera de su ámbito y devolverla antes de que otro agente se haga cargo de ella.

En ciertos casos, los ámbitos también nos permiten prescindir por completo del modelo. Tomemos como ejemplo el punto de entrada «Volver a pedir mi último carrito». Podríamos limitarnos a enviar esa frase al asistente como un mensaje y, aunque eso funcionaría, añadir un ámbito nos permite ser más precisos. El caso de «volver a pedir» es, en la práctica, determinista, por lo que podemos saltarnos el modelo de lenguaje grande (LLM) y devolver una lista de la compra casi de inmediato. Lo que se devuelve es un widget de lista de la compra normal y corriente: el consumidor puede cambiar las cantidades, intercambiar productos o pedirle al asistente que la revise en el chat, exactamente igual que lo haría con cualquier otra. Ten en cuenta que esta omisión solo es válida si la tienda sigue teniendo todos los artículos del carrito anterior; si un artículo no está disponible, la solicitud se envía al agente de alimentación, que vuelve a generar la lista del mismo modo que lo haría a partir de una solicitud escrita.

El ámbito es también lo que hace posible mantener una única conversación continua a lo largo de una sesión de la aplicación, pero solo funciona porque el ámbito, la asignación de agentes y el estado de la sesión se mantienen separados. Tratamos el ámbito como un contexto por turno. La asignación, descrita anteriormente en la serie de entradas del blog, mantiene los turnos de seguimiento con el agente que resolvió el turno anterior. Tanto la asignación como la transcripción (la conversación propiamente dicha) se asocian al chat en lugar de al ámbito, por lo que un consumidor que se desplaza de una tienda a otra reasigna la asignación a un agente de un nuevo ámbito sin descartar lo que se había dicho. Varios agentes se especializan en segundo plano, y el conjunto sigue comportándose como un único asistente.

Figura 5: Un chat, al que se accede desde dos lugares. El ámbito de aplicación varía en función de cada solicitud, por lo que si se realiza una solicitud dentro de Safeway, la lista se crea en Safeway.

Conclusión

La integración de los agentes en los productos de consumo aún se encuentra en una fase temprana. Sin embargo, las bases se están perfilando con claridad. Los widgets son el lugar donde los consumidores realizan el trabajo, y la conversación entre el consumidor y el agente es lo que los guía. Actualmente hay tres lectores de nuestro artefacto de lista de la compra, y cada uno necesita una visión diferente del mismo. Utilizamos la parte orientada al usuario para que el consumidor se sitúe en el contexto de los productos reales y para que las modificaciones habituales se puedan realizar con un solo toque. A medida que los agentes asuman una mayor parte del trabajo, esperamos que lo que el consumidor necesita ver y lo que el agente necesita analizar sigan cambiando, y que la línea divisoria entre la interfaz de una aplicación y la de un chat sea cada vez más difícil de trazar.

La plataforma de experimentación de DoorDash gestiona más de 60 000 indicadores de funciones repartidos en unos 623 repositorios. Hemos identificado más de mil indicadores de características obsoletos; en otras palabras, la característica a la que en su día daban acceso ya se ha implementado por completo, pero el indicador y su lógica de ramificación siguen ocupando espacio en el código como lastre. Limpiar uno solo de ellos manualmente le lleva a un ingeniero entre una y dos horas. Con unos 2.300 nuevos indicadores creados cada mes, la lista de tareas pendientes no hace más que crecer.

Así pues, hemos creado un sistema LLM multiagente que elimina las marcas de «caducado» de principio a fin, desde un ticket de Jira hasta una solicitud de incorporación de cambios (PR) lista para la fusión, sin intervención humana alguna, salvo la de un ingeniero que confirma el valor objetivo y la incorporación de la PR. De las 50 marcas de obsoleto más recientes que procesó, el sistema generó PR utilizables para 45 de ellas, con un coste medio de 4,79 dólares y 13,8 minutos por marca, lo que supuso un ahorro de innumerables horas de trabajo de los ingenieros. El sistema que creamos no solo tenía que ser eficaz, sino que su límite de fiabilidad debía ser la exhaustividad, no la corrección; si el agente fallaba, debía hacerlo de forma segura, sin realizar cambios en el código que pudieran provocar errores.

En esta entrada se explica por qué las herramientas estándar no podían llevar a cabo esta tarea en nuestro código fuente, cómo diseñamos el sistema y qué aprendimos durante su implementación. Nota: Este trabajo fue revisado por pares y aceptado para la sección dedicada a la industria de ICSME 2026.

Por qué merece la pena automatizar la eliminación de los «feature flags» obsoletos

Los «feature flags» son una pieza fundamental de la entrega moderna de software. Nos permiten implementar funciones de forma gradual, realizar experimentos A/B y activar mecanismos de desactivación inmediata cuando algo sale mal. Sin embargo, cada «feature flag» tiene un ciclo de vida y, una vez que una función se ha implementado por completo, su «feature flag» queda obsoleto. Los «feature flags» obsoletos suelen convertirse en deuda técnica, ya que el tiempo de un ingeniero tiene más valor si se dedica a crear nuevas funciones en lugar de a eliminarlas. 

Su lógica condicional ya no tiene ninguna utilidad, pero no se queda ahí sin causar ningún daño:

  • Los «feature flags» obsoletos pueden permanecer en el código durante años. Estudios previos han revelado que, aproximadamente, el 25 % de los «feature flags» persisten durante más de ocho años en los proyectos de código abierto; los profesionales del sector señalan constantemente que su eliminación resulta laboriosa y que se pospone una y otra vez.
  • Una señal obsoleta es deuda técnica. Cada señal obsoleta añade una rama, un caso extremo y un poco más de texto que leer y analizar, lo que puede resultar especialmente complicado durante un incidente.
  • Los indicadores obsoletos pueden suponer un riesgo operativo. Un indicador obsoleto mantiene activa una ruta de código inactiva que puede reactivarse por accidente. En un caso bien documentado, una empresa de negociación reutilizó un indicador obsoleto durante una implementación, lo que provocó operaciones no deseadas por valor de 460 millones de dólares en tan solo 45 minutos.

Si multiplicamos decenas de miles de banderas por una tasa de creación mensual de cuatro cifras, queda claro que la limpieza manual simplemente no puede seguir el ritmo. Eliminar manualmente nuestro atraso acumulado supondría miles de horas de ingeniería que sería mejor dedicar al desarrollo.

Valores dinámicos

En DoorDash, los «feature flags» se denominan «valores dinámicos» (DV). Funcionan gracias a nuestra plataforma de experimentación. A lo largo de esta entrada, el término «DV» es sinónimo de «feature flag».

El ciclo de vida de un DV sigue el patrón: creación → experimentación → implantación → obsoleto → eliminación. Clasificamos un DV como obsoleto cuando cumple todos los criterios siguientes:

  1. No se ha modificado en 90 días.
  2. Todavía aparece mencionado en el código.
  3. Aún no se encuentra en estado de fin de vida útil (archivado o retirado).
  4. No figura en ninguna lista de exclusión.

Una tarea programada diaria crea un ticket de Jira con la etiqueta «STALEDV» para cada DV obsoleto identificado y lo asigna a la persona que lo creó. Esto marca el inicio de la cola a partir de la cual funciona nuestro sistema de limpieza.

Flujo de trabajo basado en agentes frente a herramientas de limpieza basadas en AST

El enfoque automatizado más conocido para la limpieza de indicadores es Piranha y su sucesor poliglota, que simplifican las condiciones controladas por indicadores mediante la coincidencia de patrones en el árbol de sintaxis abstracta (AST). Funciona bien cuando un indicador se lee a través de una llamada directa a la API con la que una regla de reescritura puede establecer una coincidencia de patrones.

Pero en DoorDash no es así como se accede a los DV. Nuestros servicios utilizan un patrón de envoltura de tres capas con inyección de dependencias:

// Layer 1: RuntimeKeys.kt – the DV name as a string constant
object RuntimeKeys {
  const val ENABLE_X = “enable_feature_x”
}

// Layer 2: FeatureFlags.kt – a DI wrapper that calls the DV client
@Singleton
class FeatureFlags @Inject constructor(
    private val dvClient: DynamicValuesClient
) {
  fun shouldEnableX(userId: String): Boolean =
    dvClient.getBoolean(ENABLE_X, withContext(“user_id” to userId), false)
}

// Layer 3: business logic – uses the flag via dependency injection
class MyService @Inject constructor(
    private val featureFlags: FeatureFlags
) {
  fun process(userId: String) {
    if (featureFlags.shouldEnableX(userId)) handleNewPath()
    else handleOldPath()
  }
}

Se trata de una clara separación de responsabilidades, pero implica que el nombre del DV, la llamada a la API y la lógica condicional se encuentran cada uno en un archivo diferente, conectados únicamente a través de llamadas a métodos y la inyección de dependencias. Se trata de relaciones semánticas, no sintácticas; los comparadores de patrones del AST no pueden seguirlas. 

Determinación del valor objetivo

Existe un problema adicional que una herramienta basada únicamente en el código fuente no puede resolver: la determinación del valor de destino y la consulta del estado de implementación en tiempo real. Una herramienta que solo lee el código fuente podría codificar de forma definitiva un valor erróneo y modificar el comportamiento sin avisar. Para garantizar que la herramienta realice la limpieza correcta del código, es necesario conocer el estado de implementación en tiempo real del indicador, que se encuentra en la plataforma de experimentación, no en el repositorio. Por ejemplo, la plataforma de experimentación de DoorDash admite el uso de indicadores de función de tipo entero, cadena y JSON. Una lectura en tiempo real del valor objetivo garantiza que la herramienta modifique el código con el valor correcto del indicador de función, que representa el estado actual del sistema. Del mismo modo, la información sobre la implementación también es una parte importante de la ecuación. Es posible que un experimento se haya implementado en un 60 % y luego se haya abandonado. La herramienta debería tener la capacidad de determinar que se trata de una implementación parcial y solicitar la confirmación del usuario antes de realizar cualquier limpieza. Esto puede llevar al usuario a completar la implementación o la reversión antes de utilizar la herramienta para realizar la limpieza, o bien indicarle que omita la limpieza por el momento.

Alcance y complejidad

Por último, incluso una simple variable de datos booleana puede afectar a entre cinco y veinte archivos tras tener en cuenta la constante, el contenedor, cada punto de llamada y la actualización o eliminación de las pruebas pertinentes. Se trata de una tarea que requiere comprender el código, no solo hacer coincidir la sintaxis. Precisamente por eso optamos por utilizar agentes LLM. Pero la tarea no era tan sencilla como escribir una instrucción y pedirle al agente que realizara la limpieza; eso no permitiría lograr una limpieza eficiente en términos de coste y tiempo, con medidas de seguridad a gran escala.

Un proceso en dos fases con intervención humana

El sistema se basa en el Kit de Desarrollo de Agentes (ADK) de Google y se ejecuta en dos fases, con un único punto de control humano entre ellas, tal y como se muestra en la figura 1.

Figura 1: Arquitectura del sistema. Un agente de orquestación ejecuta el análisis de la Fase 1, extrae los DV obsoletos de Jira, consulta el estado de implementación a la plataforma de experimentación a través del protocolo de contexto de modelo (MCP) y realiza búsquedas en el código fuente; un ingeniero verifica el informe. A continuación, la Fase 2 genera agentes de limpieza en paralelo en árboles de trabajo de Git aislados que editan, prueban, comprueban la cobertura y realizan análisis de lint antes de abrir una solicitud de incorporación de cambios (PR).

Fase 1: Análisis e informe

Un agente de coordinación, en este caso Claude Sonnet, procesa las solicitudes de DV caducadas. Para cada DV, realiza lo siguiente:

  1. Recupera los tickets de DV en Jira caducados mediante la herramienta de línea de comandos de Atlassian.
  2. Consulta la plataforma de experimentación de DoorDash a través del protocolo de contexto de modelos (MCP) para obtener los metadatos de la variable dependiente (DV): su UUID, el porcentaje de implementación y el valor objetivo.
  3. Detecta el repositorio local y busca todas las referencias de código al DV.
  4. Genera un informe estructurado en el que se propone un valor objetivo y se enumeran los archivos afectados para cada DV.

Esa integración con MCP es el héroe silencioso del diseño. Al leer el estado de implementación en producción en tiempo real, el agente determina el valor objetivo correcto en lugar de tener que adivinarlo a partir del código. Por ejemplo, un DV que se introdujo para una función que acabó abandonándose muestra un 0 % de implementación en la plataforma, por lo que el agente sabe que debe eliminarlo utilizando el valor de referencia, en lugar de dar por hecho que la función está activada.

Punto de control humano

Antes de realizar cualquier cambio en el código, un ingeniero revisa el informe y confirma el valor objetivo de cada DV. Se trata de una medida de seguridad deliberada para casos ambiguos, como implementaciones parciales o experimentos abandonados, en los que la respuesta correcta requiere el criterio humano. Por ejemplo, puede darse el caso de que un experimento se haya implementado en un 60 % y luego se haya abandonado. El control humano permite al usuario intervenir para decidir, por ejemplo, si se completa la implementación o se revierte el experimento antes de que continúe la limpieza.

Fase 2: Limpieza en paralelo

Por cada DV confirmado, el coordinador genera un agente de eliminación específico —Claude Opus— que se ejecuta en su propio árbol de trabajo de Git aislado. Se pueden ejecutar hasta cuatro agentes simultáneamente por repositorio, aunque este número es configurable. Cada uno de ellos lleva a cabo una limpieza completa y abre una solicitud de incorporación de cambios asignada al propietario del DV.

El interior de una empresa de mudanzas

Cada agente de eliminación ejecuta un flujo de trabajo iterativo tal y como se indica a continuación:

  1. Busca todas las referencias al DV, incluyendo la constante, la función envolvente y cada punto de llamada.
  2. Decide una estrategia de limpieza en función del tipo de variable DV —booleana, entera o de cadena— y de su uso.
  3. Aplica los cambios; sustituye las llamadas a la función «wrapper» por el valor de destino y simplifica las condiciones que ahora son constantes.
  4. Elimina la función envolvente, la definición y la constante.
  5. Actualiza o elimina las pruebas afectadas, por ejemplo, eliminando las ramas de pruebas «marcadas como desactivadas».
  6. Comprueba que la compilación se haya realizado correctamente.
  7. Comprueba que las pruebas se superen.
  8. Comprueba que la cobertura de los parches sea, como mínimo, del 95 % en las líneas modificadas.
  9. Ejecuta el linter de Detekt.
  10. Si falla alguna validación, diagnostica el problema, corrígelo y vuelve a intentarlo.

La autonomía sobre un código fuente solo funciona si las medidas de seguridad son reales. Hay cuatro mecanismos que garantizan la seguridad de los agentes:

  • Aislamiento del árbol de trabajo de Git: cada agente trabaja en un árbol de trabajo específico, por lo que los agentes que se ejecutan simultáneamente nunca interfieren entre sí, y si falla una limpieza, esta se descarta simplemente eliminando el árbol de trabajo.
  • Un tiempo de espera fijo de una hora por agente: esto garantiza que una sesión bloqueada no se prolongue indefinidamente.
  • Validación de la cobertura de parches de JaCoCo: esto garantiza una cobertura de pruebas de al menos el 95 % en las líneas que ha modificado el agente.
  • Análisis estático de Detekt: garantiza el cumplimiento de las normas de estilo y detecta problemas habituales.

Además, ejecutamos Gradle con la opción –no-daemon para evitar la contaminación del estado entre árboles de trabajo durante las ejecuciones paralelas. Es fundamental destacar que no se permite a ningún agente abrir una solicitud de pull hasta que las pruebas y el análisis estático se hayan superado localmente.

Resultados

Crear un sistema es una cosa, pero cuando funciona a la escala de DoorDash solo importa una pregunta: ¿qué tal funciona? En este caso, la verdad es que muy bien.  De las 50 señales de código obsoleto más recientes que procesó el sistema, generó una solicitud de incorporación de cambios (PR) lista para fusionarse en 45 de ellas, con un coste medio de 4,79 dólares y 13,8 minutos por limpieza, en lugar de las una o dos horas que habría llevado una limpieza manual. El sistema no introdujo ningún error ni regresión durante el proceso.

Cómo lo hemos evaluado

Evaluamos el sistema con los 50 DV obsoletos más recientes que procesó en varios repositorios de Kotlin. Clasificamos cada uno de ellos según su complejidad: 

  • Sencillo: una sola comprobación booleana en uno o dos archivos; n = 6
  • Medio: múltiples usos en entre tres y cinco archivos con algunos cambios de prueba; n = 18
  • Complejo: condiciones anidadas, dependencias entre archivos, tipos no booleanos o actualizaciones importantes de las pruebas; n = 26 

Por tipo, 41 eran booleanos, seis eran cadenas y tres eran enteros/long. Cada PR se evaluó según tres criterios: superación de las pruebas de CI —incluido el requisito de cobertura del 95 % de los parches—, corrección del código y revisión por parte de los desarrolladores. 

Resultados según el grado de complejidad

Figura 2: Resultados de la limpieza según la complejidad. Las variables dependientes simples se aceptan al 100 % a la primera; las de complejidad media alcanzan una tasa de limpieza del 94 %; las complejas presentan más revisiones y fallos, pero aún así alcanzan el 85 %.

Como se muestra en la figura 2, 31 de las 50 limpiezas se completaron a la primera, 14 necesitaron una pequeña revisión y cinco requirieron la intervención de un ingeniero. El desglose por complejidad refleja el límite de fiabilidad del sistema:

  • DV simples: depuradas al 100 % en una sola pasada.
  • Valores de datos medios: 94 % (17/18). 14 se completaron en una sola pasada, tres tras una revisión y uno requirió la intervención de un ingeniero.
  • Variables de datos complejas: 85 % (22/26), incluso con la eliminación en cascada de parámetros a lo largo de más de cinco capas de métodos, condiciones anidadas y una profunda refactorización de las pruebas.

Las 14 revisiones fueron de carácter menor y se corrigieron por sí solas; seis presentaban una cobertura insuficiente del parche, lo que requirió una iteración más para añadir pruebas, y ocho consistían en una eliminación incompleta de código muerto, con alguna variable o referencia residual en lo más profundo de una cadena de llamadas. No obstante, todas se corrigieron con una sola nueva solicitud al modelo de lenguaje grande (LLM).

El hallazgo más importante tuvo que ver con el tipo de problema que se produjo. En las 50 solicitudes de incorporación de cambios generadas, no observamos ningún error ni regresión provocados por el código modificado. Cada uno de los cinco casos de intervención se redujo a la profundidad de la cadena de llamadas con encadenamiento de parámetros entre interfaces; el agente eliminó correctamente la mayor parte del código muerto, pero se le escaparon uno o dos eslabones en una larga cadena que abarcaba varios archivos. En otras palabras, el límite de fiabilidad del sistema es la exhaustividad, no la corrección, lo que disipa la preocupación de que el sistema pudiera generar problemas mayores cuando no lograba su objetivo.

Coste y tiempo

El coste y el plazo varían en función de la complejidad, pero se mantienen claramente dentro del ámbito de la «ejecución a gran escala», tal y como se muestra en la Tabla 1 y en la Figura 3. 

La tabla 1 desglosa los indicadores de rendimiento medios y medianos —concretamente, el tiempo y el coste— de los 50 «feature flags» analizados, clasificados según su complejidad. Estos datos ponen de manifiesto que, si bien los «feature flags» más complejos requieren, como es lógico, más tiempo y presupuesto, el sistema sigue siendo muy eficiente incluso en las tareas de limpieza más difíciles.

ComplejidadnTiempo medioTiempo medianoCoste medioCoste medio
Sencillo67,5 min8,2 min$2.69$2.50
Medio1810,4 min9,9 min$3.46$3.42
Complejo2617,7 min14,4 min$6.20$4.50

Tabla 1: Indicadores de rendimiento por nivel de complejidad en las 50 opciones de configuración evaluadas.

Figura 3: Coste de la API frente al tiempo real para cada DV, clasificados por colores según su complejidad. Los DV simples y de complejidad media se agrupan en la zona de bajo coste y tiempo reducido. Los DV complejos se distribuyen de forma dispersa, con algunos valores atípicos que se acercan a los 40 minutos y los 19 dólares. Los DV fallidos (×) tienden a presentar tiempos de ejecución más largos.

Como se muestra en la figura 3, los DV simples y medios se agrupan estrechamente en el rincón de «barato y rápido». Los DV complejos se dispersan, con unos pocos valores atípicos que alcanzan aproximadamente los 40 minutos y unos 19 dólares. Incluso en el extremo superior de ese rango, el agente supone una reducción drástica del esfuerzo de ingeniería y de los costes, incluso en comparación con una estimación conservadora de una hora de lo que se necesitaría para eliminar manualmente un solo DV.

Lo que aprendimos

  • Especializar los modelos según su función da sus frutos. Utilizamos Claude Sonnet para la orquestación, lo que incluye el contexto general, la recopilación de metadatos ligeros y la planificación, y Claude Opus para los agentes de eliminación, lo que incluye el razonamiento profundo sobre la semántica del código, las cadenas de llamadas y las dependencias de las pruebas. Reservar el modelo más costoso para la fase de edición, que exige un mayor esfuerzo cognitivo, nos ha permitido reducir el coste global de la API sin perjudicar la calidad de la limpieza.
  • El aislamiento del árbol de trabajo es imprescindible para los agentes paralelos. Nuestros primeros experimentos sin aislamiento del árbol de trabajo dieron lugar a condiciones de carrera en las que agentes concurrentes editaban los mismos archivos y generaban diferencias corruptas. Un árbol de trabajo específico para cada agente, junto con Gradle en modo –no-daemon, hizo que la limpieza paralela fuera segura y que los fallos se pudieran descartar.
  • La integración de la experimentación en tiempo real fue la decisión más decisiva. Sin el estado actual de implementación, cualquier enfoque automatizado —ya sea basado en reglas o en modelos de lenguaje grande (LLM)— corre el riesgo de codificar de forma rígida un valor erróneo y de mantener de forma encubierta un comportamiento incorrecto. Su aplicación a través de MCP añadió una latencia insignificante y eliminó toda una clase de errores de valores objetivo.

Cualquier equipo que esté considerando una automatización similar debe tener en cuenta que nuestros resultados apuntan a tres requisitos previos prácticos: 

  • Una fuente fiable de información sobre el Estado de la bandera en que navega el buque
  • Aislamiento del árbol de trabajo para ediciones en paralelo, y 
  • Las comprobaciones de validación determinísticas se realizan antes incluso de que se abra una solicitud de incorporación de cambios (PR).

Próximos pasos

Vamos a ampliar el sistema en dos direcciones:

  1. Una puntuación de confianza de fase 1 para aprobar automáticamente las correcciones de bajo riesgo. Por ejemplo, una variable dependiente booleana con un 100 % de implementación cuyo código por defecto ya coincide con el de producción, lo que reserva la revisión humana para los casos realmente ambiguos.
  2. Una revisión de la calidad del código tras la limpieza. Esto permitiría detectar problemas semánticos, como nombres de variables que ya no reflejan su finalidad una vez que se ha eliminado un indicador.

La limpieza de los «feature flags» es el tipo de trabajo que, individualmente, resulta insignificante, pero que, en conjunto, supone una tarea ingente —especialmente a la escala de DoorDash— y que se pospone constantemente. Al combinar un orquestador, agentes de eliminación en paralelo en árboles de trabajo aislados, consultas en la plataforma de experimentación en tiempo real y controles de validación estrictos, nuestro sistema de limpieza de indicadores de funcionalidades transforma un trabajo atrasado de miles de horas en un proceso en segundo plano económico y fiable que genera solicitudes de incorporación de cambios (PR) listas para fusionarse para el 90 % de los indicadores que procesa, con un coste de unos 4,79 dólares y 14 minutos por cada uno, sin regresiones. El único obstáculo que queda es la exhaustividad en las cadenas de llamadas más profundas, y ahí es precisamente donde centraremos nuestros esfuerzos a continuación.

¿Te interesa desarrollar sistemas como este? El departamento de ingeniería de DoorDash está contratando: únete a nosotros para ayudarnos a desarrollar a gran escala.

Flux es la plataforma de agentes basada en la nube de DoorDash para ingenieros. En un solo mes de 2026, utilizamos Flux para automatizar 130 000 tareas de ingeniería. Tras su lanzamiento en el primer trimestre de 2026, Flux ha experimentado una rápida expansión y ya gestiona flujos de trabajo en segundo plano de gran volumen en toda DoorDash, incluyendo más de 25 000 revisiones de código automatizadas cada semana, así como más de 300 guías de procedimientos únicas y más de 10 000 ejecuciones semanales. Estos flujos de trabajo pueden ejecutarse de forma autónoma, en paralelo y las 24 horas del día.

En esta entrada del blog, analizaremos las limitaciones que nos llevaron a ir más allá de las cargas de trabajo de los agentes locales ejecutados en portátiles, por qué decidimos desarrollar Flux internamente en lugar de depender exclusivamente de agentes de programación alojados, y los elementos básicos de la plataforma —como los entornos aislados de los agentes, la pasarela MCP, los guiones y las superficies de invocación— que permiten que la delegación de agentes sea repetible y segura.

Casos de uso del flujo de trabajo de fondo de Flux

Tabla 1: Resumen del uso de Flux en DoorDash durante un mes, que abarca revisiones automáticas de código, ejecuciones de guiones y finalización de tareas en segundo plano

De dónde partimos

A lo largo del último año, los usuarios que ejecutan cargas de trabajo de tipo «agente» en sus portátiles se han topado rápidamente con una serie de limitaciones:

  • Recursos y disponibilidad. Un portátil tiene un número fijo de núcleos de CPU, memoria limitada y una batería, todos ellos compartidos con todas las aplicaciones instaladas. Los flujos de trabajo de Agentic a menudo necesitan ejecutar en paralelo tareas que requieren un gran esfuerzo computacional, como compilaciones, pruebas y búsquedas de gran envergadura, lo que hace que los portátiles se queden sin capacidad rápidamente. Además, los flujos de trabajo dependen de que el dispositivo esté encendido, conectado y disponible; el trabajo se detiene cuando un ingeniero cierra el portátil, pierde la conexión o se aleja.
  • Controles de seguridad. Los ordenadores portátiles suelen tener un amplio acceso a credenciales y sistemas sensibles, como claves SSH, sesiones VPN y herramientas autenticadas. Otorgar a un agente autónomo ese mismo nivel de acceso genera un riesgo innecesario y un alcance potencialmente amplio. Los entornos locales también dificultan definir con precisión a qué puede acceder un agente y durante cuánto tiempo.
  • Visibilidad y auditabilidad. Cuando las cargas de trabajo se ejecutan en ordenadores portátiles individuales, la ejecución resulta fragmentada y difícil de supervisar. Resulta más complicado saber qué se está ejecutando, dónde se está ejecutando, en nombre de quién y a qué sistemas o archivos ha afectado.

Nuestra propuesta para abordar estas cuestiones es sencilla: 

Delegar tareas en agentes de programación seguros y autónomos para que los ingenieros puedan dedicar más energía a la innovación, al pensamiento crítico y a la resolución de problemas complejos.

Por qué desarrollamos Flux internamente

Los agentes de programación alojados son útiles, pero obligan a elegir entre dos opciones: o bien enviar código sensible y el contexto de ejecución a un tercero, o bien abrir una vía desde ese tercero de vuelta a los sistemas internos. Para DoorDash, el mayor reto no era simplemente conseguir que un agente escribiera código; eso ya está prácticamente resuelto. Se trataba de proporcionar a ese agente el entorno, las herramientas, los permisos, las integraciones y las restricciones adecuados.

Nuestra estrategia consiste en controlar los elementos básicos que rodean al agente, entre los que se incluyen la orquestación, los entornos aislados, los flujos de trabajo, los permisos, las integraciones y los agentes de contexto específicos de DoorDash necesarios para trabajar con eficacia. Además, hemos diseñado esos elementos básicos para que sean modulares, lo que nos da la flexibilidad de utilizar la mejor herramienta de terceros para cada tarea o de desarrollarla internamente cuando sea importante contar con un mayor nivel de seguridad, integración, rendimiento o control sobre la experiencia de usuario. 

Estas primitivas democratizan la creación de flujos de trabajo y hacen que los sistemas sean más adaptables a futuros casos de uso. Dado que se pueden combinar de diferentes maneras, los equipos pueden crear nuevos flujos de trabajo para los agentes sin tener que modificar la infraestructura subyacente ni imponer a cada ingeniero cómo debe estructurar su flujo de trabajo. Por ejemplo, ejecutamos las evaluaciones de nuestra revisión de código en la infraestructura de Flux.

Elementos primitivos, no flujos de trabajo

Como se muestra en la figura 1, Flux se basa en cuatro elementos fundamentales de la plataforma: entornos aislados, la pasarela del protocolo de contexto de modelos (MCP), los guiones de trabajo y las superficies de invocación. En conjunto, hacen que la delegación de tareas a los agentes sea repetible. Un guión de trabajo define la tarea. Un entorno aislado en la nube proporciona al agente un espacio real para llevarla a cabo. Una pasarela de agente controla a qué sistemas puede acceder el agente. Y las superficies de invocación permiten a los ingenieros iniciar y recibir tareas desde los entornos que ya utilizan.

Figura 1: Las cuatro primitivas de la plataforma que conforman Flux —entornos aislados, la pasarela MCP, los guiones y las superficies de invocación— y cómo se conectan entre sí para convertir una tarea en un trabajo que un agente pueda llevar a cabo de forma segura

Los entornos aislados proporcionan el entorno de ejecución

Los agentes locales funcionan bien para el desarrollo interactivo, pero no son adecuados para flujos de trabajo sin supervisión. Dependen de los ordenadores portátiles de cada ingeniero, compiten por los recursos locales, son difíciles de auditar y no se adaptan de forma eficiente a tareas paralelas.

Flux traslada la ejecución a entornos aislados en la nube, respaldados por microvirtuales (microVM) de Firecracker, que garantizan el aislamiento a nivel de hardware. Cada entorno cuenta con los repositorios, las herramientas de desarrollo, los secretos y las dependencias de tiempo de ejecución que requiere la tarea, lo que proporciona a los agentes un espacio de trabajo de ingeniería completo, al tiempo que ofrece a DoorDash un modelo coherente de ejecución, seguridad y observabilidad.

El control de esta capa nos permite dar soporte a flujos de trabajo de ingeniería reales, incluyendo cambios en varios repositorios y múltiples solicitudes de incorporación de cambios desde una única sesión. Flux tiene un objetivo de nivel de servicio en el percentil 95 de menos de cinco segundos para la configuración completa de principio a fin: desde el inicio de la microVM hasta la clonación de los repositorios necesarios, la instalación de las herramientas de compilación y la configuración de los entornos de prueba compatibles con el agente de codificación.

La pasarela MCP proporciona un acceso controlado

Los agentes necesitan tener acceso a los sistemas que utilizan los ingenieros a diario, entre los que se incluyen la integración continua (CI), las plataformas de observabilidad, los sistemas de seguimiento de incidencias, las herramientas de implementación, la búsqueda de código, la documentación y los metadatos de los servicios. Sin embargo, conceder un acceso amplio y sin restricciones no debería ser la opción por defecto.

Flux conecta a los agentes con los sistemas internos a través de una pasarela MCP propia denominada «Agent Gateway». Cada guion de acciones especifica las herramientas que necesita, y Flux solo concede los permisos específicos necesarios para esa tarea. Se registra cada acción, lo que genera un registro de auditoría claro.

Esta arquitectura de puerta de enlace nos proporciona un punto de control centralizado para la autenticación, la autorización, la observabilidad, el seguimiento del uso y la aplicación de políticas, lo que hace que el acceso de los agentes sea más seguro y más fácil de gestionar a gran escala.

Los manuales de estrategias definen el trabajo

Un «playbook» es una unidad reutilizable de trabajo autónomo, el equivalente a un contenedor Docker para habilidades y tareas gestionadas por agentes en la plataforma Flux. Definido en un único archivo YAML de marcado, agrupa la tarea, los datos de entrada, el contexto, las habilidades, las herramientas, los permisos, la validación, los resultados esperados y los límites de seguridad necesarios para ejecutar el trabajo de forma coherente.

Los «playbooks» pueden combinar pasos basados en agentes —que aportan flexibilidad y capacidad de juicio— con pasos deterministas —que ofrecen previsibilidad, un menor coste y una validación más sencilla—. Esto permite a los equipos trasladar la lógica entre la ejecución basada en agentes y el código convencional a medida que evolucionan los requisitos, sin necesidad de rediseñar el flujo de trabajo.

Las interfaces de invocación se adaptan a las necesidades de los desarrolladores

El mismo guion de acciones se puede activar desde Slack, GitHub, cron, la interfaz de línea de comandos (CLI) o una habilidad conversacional. Esto significa que los equipos pueden definir un flujo de trabajo una sola vez e invocarlo desde la interfaz que mejor se adapte a cada momento:

  • Slack para la delegación colaborativa
  • GitHub para la automatización de las solicitudes de incorporación de cambios (PR) y la integración continua (CI)
  • Cron para tareas de mantenimiento periódicas
  • Interfaz de línea de comandos (CLI) para que el desarrollador tenga control directo, o que se pueda invocar a través de una skill

Esto es lo que hace que Flux sea fácil de adoptar.

Lecciones aprendidas

La creación de Flux nos enseñó tanto sobre la adopción de productos como sobre la infraestructura, entre otras cosas:

  • Empieza por algo concreto para ganarte la confianza. Comenzamos con la revisión automatizada del código, en lugar de intentar automatizar todo el ciclo de vida del desarrollo de software. La revisión del código era frecuente, cuantificable y fácil de evaluar para los ingenieros. Esto nos proporcionó un flujo de trabajo en producción que nos permitía ajustar la calidad, la latencia, el coste y el comportamiento antes de ampliarlo al triaje de CI, las tareas de guardia, los manuales de mantenimiento y el desarrollo basado en tickets.
  • Haz que el trabajo sea visible. Nuestra primera integración con Slack creaba canales privados para cada tarea asignada a un agente. Eso hacía que Flux resultara útil a nivel individual, pero no fomentaba los hábitos de trabajo en equipo. Trasladar el trabajo a hilos públicos cambió el patrón de adopción. Los ingenieros podían ver lo que otros delegaban, seguir el progreso en Flux, revisar los resultados y generar confianza entre todos.
  • Los manuales operativos necesitan apoyo. Los flujos de trabajo reutilizables no surgen por el mero hecho de que exista la plataforma. Los talleres y los hackatones ayudaron a los equipos a plasmar en manuales operativos las tareas operativas recurrentes. Los elementos básicos hicieron posible la automatización; el apoyo ayudó a los equipos a identificar qué flujos de trabajo merecía la pena codificar.

Próximos pasos

En próximas entradas, profundizaremos en los componentes básicos de la plataforma que hacen posible el funcionamiento de Flux, así como en la experiencia de los desarrolladores a la hora de crear nuevos flujos de trabajo. También hablaremos de las aplicaciones que hemos desarrollado a partir de ella, entre ellas Flux Responder, nuestro agente interno de Slack.

Agradecimientos

Agradecemos a Adam Rogal, Adam Yarger, Andy Fang, Ashwin Kachhara, Fan Xia, Ivan Rudovol, Jason Prasad, Jialu Deng, Justin Block, Justin Deocampo, Justin Fan, Keith Lyall, Praneet Singh, Sean Chen, Tyler Berrett y Volanda Zhu sus aportaciones a la plataforma y a esta publicación.

Manténgase informado con Actualizaciones

Suscríbase a nuestro blog de ingeniería para estar al día de todos los los proyectos más interesantes en los que trabaja nuestro equipo
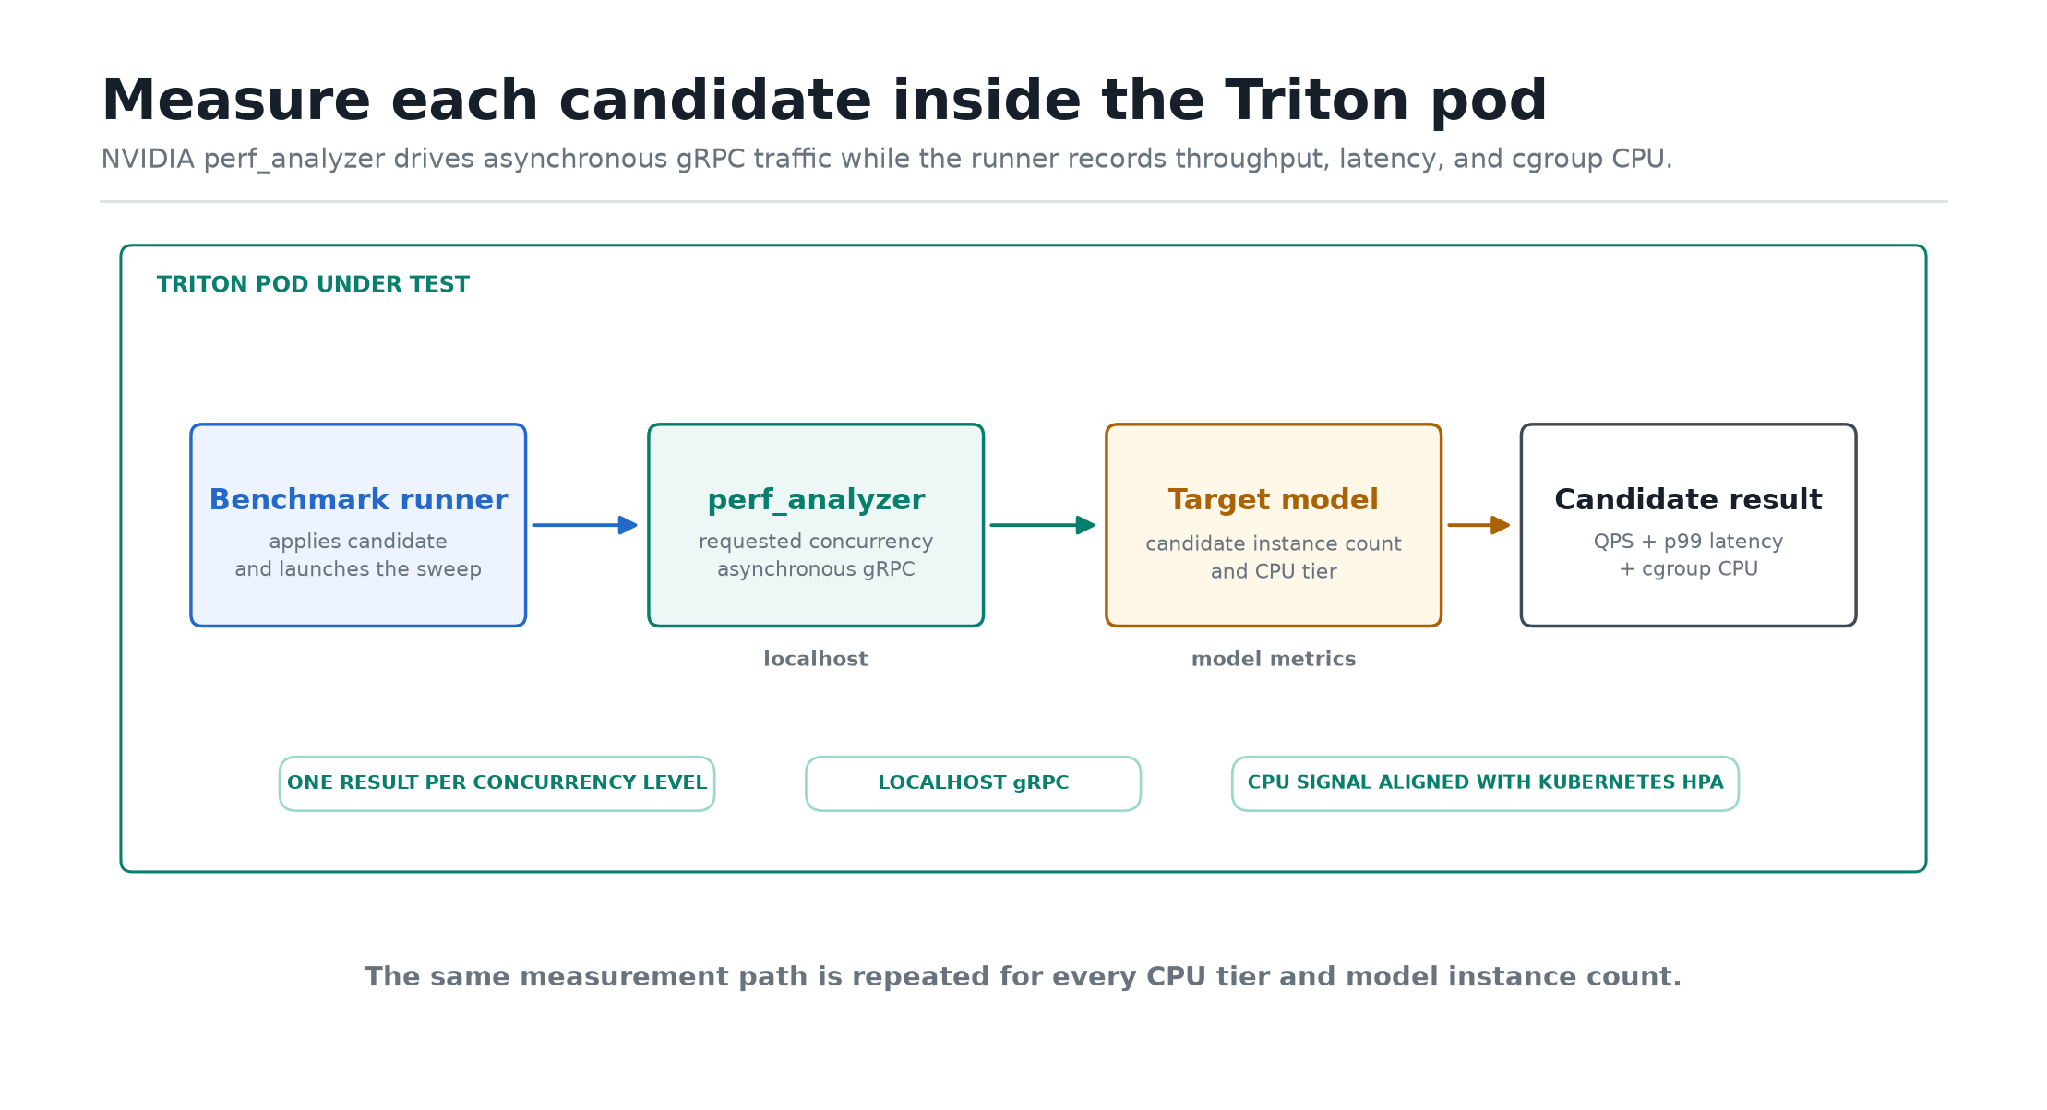
Los agentes de IA resultan útiles cuando pueden actuar en sistemas reales. En DoorDash, eso significa acceder a API internas, sistemas de ingeniería, plataformas de observabilidad, sistemas de gestión de incidencias, bases de conocimiento y productos SaaS de terceros. El protocolo de contexto del modelo (MCP) facilitó la exposición de esas herramientas al proporcionar a los agentes y servidores una forma común de describir, descubrir e invocar capacidades.

A medida que los agentes pasaban de los experimentos a los flujos de trabajo reales, nos topamos con un problema diferente. Aunque MCP estandarizaba el formato de una llamada a una herramienta, no respondía a preguntas clave relacionadas con la producción en torno a dicha llamada:

  • ¿Qué agente tiene permiso para utilizar esta herramienta?
  • ¿En nombre de qué usuario, equipo o servicio actúa?
  • ¿Qué credencial se debe utilizar?
  • ¿Qué subconjunto de herramientas debería ver el agente?
  • ¿Cómo se revoca el acceso?
  • ¿Cómo sabemos qué pasó después de la llamada?

Estas necesidades crecen rápidamente. Un agente de programación podría necesitar GitHub, Jira, búsqueda de código, integración continua (CI), observabilidad y documentación. Un servidor MCP de terceros podría ofrecer cientos de herramientas cuando un flujo de trabajo solo necesita cinco. Un agente de atención al usuario podría necesitar una autorización OAuth del usuario, mientras que la automatización del equipo debería utilizar una entidad de servicio no personal. Si cada equipo resuelve estos problemas de forma independiente, cada combinación de agente y herramienta acaba teniendo su propio código de autenticación, flujo OAuth, gestión de secretos, catálogo de herramientas, límites de frecuencia y registros.

Por eso hemos creado una «Agent Gateway» para que el acceso a las herramientas de los agentes sea una funcionalidad de la plataforma. Se trata de un único punto de entrada regulado desde el que los agentes pueden detectar e invocar herramientas. La pasarela autentica al usuario que realiza la llamada, comprueba la autorización, muestra únicamente las herramientas aprobadas, introduce las credenciales adecuadas, redirige la llamada al servidor MCP correspondiente y registra un evento de uso estructurado para cada llamada.

La pasarela no es solo un proxy. Es el plano de control del ecosistema de agentes. Se encarga de determinar quién puede acceder a las herramientas, selecciona las herramientas a las que pueden acceder los agentes, agrupa las herramientas en interfaces orientadas a tareas y proporciona a DoorDash un único punto desde el que supervisar, limitar el número de solicitudes, revocar y mejorar el acceso de los agentes a las herramientas.

Problema: El acceso a las herramientas consta de tres partes

Aunque MCP ayuda a los agentes a utilizar herramientas, el problema más complejo en el entorno de producción tiene tres dimensiones:

  1. El primero es el acceso. La plataforma debe saber quién está llamando, si tiene permiso para hacerlo y qué modelo de credenciales se aplica: identidad interna, token gestionado por la pasarela, OAuth por usuario o acceso mediante entidad de servicio.
  2. El segundo aspecto es la selección de herramientas y superficies. Los agentes no deben recibir un volcado sin procesar de todas las herramientas expuestas por los servidores MCP posteriores. Los catálogos más reducidos y relevantes para la tarea mejoran la seguridad, reducen la confusión de los modelos y facilitan el manejo de los agentes.
  3. El tercero es el ámbito operativo. Las llamadas a las herramientas deben contar con límites de frecuencia, seguimientos, métricas, eventos de uso, atribución de costes, metadatos de propiedad y visibilidad en producción.

Nuestra Agent Gateway existe porque el acceso, la gestión de contenidos y las operaciones deben integrarse en una única plataforma compartida, en lugar de duplicarse en cada agente y en cada servidor MCP.

Arquitectura de pasarela

La pasarela consta de dos componentes principales: un proxy y un registro, tal y como se muestra en la figura 1 a continuación. El proxy es el plano de datos; recibe cada solicitud de MCP, autentica al solicitante, autoriza la acción, aplica límites de tasa, inyecta credenciales, reenvía la solicitud y emite datos de observabilidad. El registro es la fuente de información de referencia del plano de control; almacena agentes, servidores MCP, propietarios, configuraciones de transporte, modos de autenticación, políticas, catálogos de herramientas detectadas y configuraciones de la superficie de herramientas.

Figura 1: Arquitectura de alto nivel de la pasarela de agentes

Esta división dota a la pasarela de algunas características que resultan difíciles de conseguir con las integraciones punto a punto:

  • Los agentes utilizan un patrón de punto final MCP único y coherente, en lugar de tener que aprender el modelo de autenticación y enrutamiento de cada servidor posterior.
  • Los propietarios de las herramientas registran las capacidades una sola vez, asocian la titularidad y la política, y consultan el uso en producción.
  • Los equipos de seguridad disponen de un único punto desde el que pueden gestionar los accesos, revocar autorizaciones y auditar las llamadas.
  • Los equipos de la plataforma pueden mejorar la ruta compartida una sola vez y hacer que todos los agentes se beneficien de esa mejora.

Además, mantenemos separados los límites de confianza internos y externos. Los flujos de trabajo internos de DoorDash y los casos de uso de agentes orientados al exterior se ejecutan a través de planos de proxy independientes con bibliotecas compartidas y conceptos de registro. Esto limita el alcance de los posibles incidentes frente a Internet y permite que cada modelo de autenticación evolucione de forma independiente.

Identidad, autorización y claves de acceso centralizadas

Cada solicitud de la pasarela se asocia a un solicitante: un usuario, un servicio o un agente que actúa con un contexto de usuario delegado. Esa identidad se mantiene a lo largo de los procesos de autorización, inyección de credenciales, enrutamiento y observabilidad, de modo que se pueda atribuir cada acción posterior.

La pasarela comprueba la autorización de forma centralizada. Las cuestiones relacionadas con la política no se limitan a determinar si este solicitante puede acceder a este servidor. También pueden ser:

  • ¿Puede este agente acceder a este servidor?
  • ¿Puede este usuario acceder a esta herramienta a través de este agente?
  • ¿Se puede exponer esta herramienta en este entorno?
  • ¿Puede este usuario utilizar una variante con capacidad de escritura o solo una de solo lectura?
  • ¿Este flujo de trabajo puede utilizar una entidad de servicio de equipo o requiere OAuth por usuario?

Dado que la política se gestiona en la puerta de enlace, DoorDash dispone de un único lugar desde el que modificar y revocar el acceso. Los responsables de las herramientas evitan tener que volver a configurar la autorización para cada servidor, y los desarrolladores de agentes evitan tener que codificar las decisiones de seguridad en las solicitudes o en el código de la aplicación.

La gestión de credenciales sigue el mismo patrón, tal y como se muestra en la Tabla 1:

Modo de autenticación¿Quién es el titular de la credencial?Qué hace la pasarela
Identidad de servicio internaInfraestructura de DoorDashReenvía el contexto de la llamada verificada a los servicios internos
Token gestionado por GatewayAlmacenamiento seguro de claves de puerta de enlaceInyecta un token de proveedor o de servicio sin exponerlo al agente
OAuth por usuarioAlmacén de autorizaciones cifrado por usuarioInserta y actualiza el token del usuario para las acciones con ámbito de usuario
Servicio principalDirector del equipo gestionado por GatewayLos emisores o intermediarios emiten credenciales no personales de corta duración

Los agentes no deben disponer de credenciales sin procesar, como claves API de proveedores, tokens de actualización de OAuth o autorizaciones de usuarios prestadas para las automatizaciones del equipo. La pasarela garantiza que esos límites sean explícitos y auditables.

OAuth por usuario sin interrumpir el turno del agente

Las herramientas de terceros con ámbito de usuario requieren la autorización del usuario. Para consultar la documentación de un usuario, crear un ticket en su nombre o actualizar datos de SaaS en su nombre, no es seguro utilizar una clave compartida. Antes de implementar la pasarela, cada equipo solía crear su propio flujo de OAuth, su propio almacenamiento de tokens y su propia experiencia de «conectarse primero».

La pasarela centraliza la concesión de OAuth. La unidad de acceso se limita al agente, al usuario y al servidor. En la primera llamada que requiere autorización, la pasarela inicia el flujo OAuth del proveedor, almacena los tokens cifrados de acceso y de actualización resultantes, e inserta el token del usuario en las llamadas posteriores. Los agentes nunca ven el token sin procesar.

En el caso de los clientes que admiten la solicitud de autorización MCP, la pasarela puede pausar la llamada a la herramienta, solicitar al cliente que muestre un mensaje de conexión y reanudar la llamada original una vez que el usuario la haya autorizado. Para los clientes que no admiten la solicitud de autorización, devuelve una respuesta estructurada que indica que se requiere autorización, junto con una URL de conexión, tal y como se muestra en la figura 2. De este modo, la conexión pasa de ser un paso fallido a convertirse en una parte recuperable de la llamada a la herramienta.

Figura 2: Protocolo de intercambio de información

Superficies de herramientas seleccionadas: paquetes y filtrado

Los agentes no piensan de forma natural en servidores MCP, sino en tareas. Un agente de programación no quiere que GitHub, Jira, la observabilidad y la documentación sean pasos de configuración independientes; lo que quiere es disponer de las herramientas necesarias para investigar un problema, modificar el código, abrir una solicitud de incorporación de cambios, inspeccionar la integración continua y comprender el comportamiento en producción.

Al mismo tiempo, la mayoría de los servidores MCP de nivel inferior exponen muchas más herramientas de las que debería utilizar un solo agente. Los servidores de terceros pueden publicar cientos de operaciones, entre las que se incluyen acciones administrativas, acciones destructivas, API de facturación y funciones específicas de proveedores especializados. La mayoría de los flujos de trabajo de DoorDash solo necesitan un pequeño subconjunto autorizado de ellas.

La pasarela resuelve ambos problemas mediante interfaces de herramientas seleccionadas, tal y como se muestra en la figura 3. Los paquetes combinan herramientas de varios servidores MCP en un único punto final lógico de MCP. Los filtros determinan qué herramientas de cada servidor se muestran para un paquete, agente, grupo de usuarios, entorno o público determinado.

Por ejemplo, un paquete de herramientas para desarrolladores puede incluir:

  • herramientas seleccionadas de GitHub para los flujos de trabajo de repositorios y solicitudes de incorporación de cambios;
  • herramientas seleccionadas de Jira para la búsqueda y actualización de incidencias;
  • herramientas de observabilidad seleccionadas para registros, métricas y trazas;
  • determinadas herramientas de búsqueda de código y documentación; y
  • herramientas seleccionadas de implementación o de control de funciones.

Figura 3: Experiencia del usuario con el paquete MCP incluido

El agente se conecta a una URL de la pasarela, como un punto final de herramientas para desarrolladores. Detrás de esa URL, la pasarela distribuye «tools/list» entre los servidores del paquete, aplica filtros de autorización y de herramientas, asigna espacios de nombres o alias a los nombres de las herramientas cuando es necesario, y devuelve un catálogo coherente. Cuando el agente invoca «tools/call», la pasarela vuelve a aplicar la política, enruta la llamada al servidor de destino correcto y aplica el modelo de credenciales de dicho servidor.

Esto proporciona a los agentes una interfaz de calidad, en lugar de un simple conjunto de capacidades de nivel inferior, e incluye elementos como herramientas aprobadas, nombres estables, descripciones más claras, metadatos de propiedad y paquetes específicos para cada público. Los departamentos de ingeniería, análisis de datos y operaciones de soporte, así como los paquetes externos, pueden utilizar las mismas primitivas de la pasarela al tiempo que exponen diferentes interfaces de herramientas.

Las ventajas son prácticas:

  • La configuración del agente es más sencilla: un único punto de acceso de puerta de enlace en lugar de múltiples puntos de acceso de servidor.
  • La detección de herramientas es más segura: los agentes solo ven las herramientas que se encuentran dentro del límite autorizado.
  • Mejora el comportamiento de los modelos: los catálogos más reducidos disminuyen las opciones irrelevantes y la confusión a la hora de elegir herramientas.
  • La autorización sigue estando centralizada: tanto el descubrimiento como la invocación aplican la misma política.

Aquí es donde la pasarela deja de ser un simple proxy de acceso. Determina qué pueden encontrar los agentes, a qué pueden acceder y cuánto contexto irrelevante transportan. Una selección de herramientas bien organizada puede marcar la diferencia entre un agente que elige la herramienta adecuada y otro que se pierde en un catálogo de API desmesuradamente amplio.

Observabilidad, atribución de costes y protección en las fases posteriores

Dado que todas las llamadas pasan por la pasarela, cada solicitud puede generar un evento estructurado que incluya:

  • el servidor, la herramienta, el paquete y el equipo responsable;
  • el usuario, el agente, el servicio y la plataforma implicados en la llamada;
  • resultado de la autorización, código de estado, origen del error y desglose de la latencia;
  • el tamaño de la solicitud y de la respuesta; y
  • metadatos sobre los costes comunicados por los eslabones posteriores de la cadena de suministro, cuando estén disponibles.

La pasarela también genera métricas sobre el volumen de solicitudes, la latencia por herramienta, las decisiones de autorización, los resultados de la actualización de OAuth, las decisiones de limitación de tasa, las conexiones de streaming y los fallos en el lado de origen. La propagación de trazas permite a los equipos seguir el recorrido de una llamada desde el agente, pasando por la pasarela, hasta el servidor de destino.

Esto tiene un valor operativo directo: el equipo de seguridad puede auditar los accesos, los equipos de la plataforma pueden detectar agentes que generan ruido, los responsables de las herramientas pueden ver los niveles de adopción y los errores, y los equipos de infraestructura pueden atribuir los costes.

Este mismo mecanismo protege los sistemas posteriores. Los límites de tasa pueden aplicarse por servidor, herramienta, entidad solicitante, usuario, paquete o tipo de entidad solicitante. Los nuevos límites pueden ejecutarse en modo simulado antes de su aplicación efectiva, mostrando lo que se habría rechazado sin interrumpir el tráfico de producción.

La pasarela transforma la gestión en datos, en lugar de depender de que cada equipo registre los campos adecuados y aplique los límites correctos.

Incorporación de autoservicio

Una pasarela solo funciona si los equipos prefieren utilizarla en lugar de eludirla. El registro, la detección, el filtrado y la gestión de paquetes deben poder realizarse de forma autónoma.

A través de la interfaz de usuario y la API del plano de control, los equipos pueden registrar servidores y agentes MCP, configurar la autenticación, detectar herramientas, asignarles un propietario, definir filtros, añadir herramientas a paquetes e inspeccionar el uso en producción.

El proceso de incorporación de la pasarela sigue estos pasos:

  1. Registra el servidor MCP.
  2. Descubre su catálogo de herramientas sin procesar en tools/list.
  3. Selecciona y aprueba las herramientas que DoorDash quiere poner a disposición.
  4. Especifica el modo de autenticación, la titularidad y la política.
  5. Añade las herramientas aprobadas a uno o varios paquetes.
  6. Supervisa el tráfico, la latencia, los errores, las decisiones de autorización y los costes.

Una gestión que requiera tickets no es escalable. El camino allanado tiene que ser más sencillo que copiar una clave secreta en un agente y conectarse directamente a un servidor.

¿Qué ha cambiado?

La pasarela ofrece a cada grupo una ventaja diferente:

  • Los desarrolladores de agentes disponen de una única integración, un catálogo seleccionado y no tienen que ocuparse de la autenticación posterior, OAuth, la gestión de claves secretas ni el enrutamiento por herramienta.
  • Los propietarios de las herramientas disponen de una vía de distribución gestionada con control de acceso, exposición autorizada de las herramientas y datos sobre su uso en producción.
  • Los equipos de seguridad disponen de políticas centralizadas, datos confidenciales, autorizaciones OAuth, revocaciones y registros de auditoría.
  • Los equipos de la plataforma obtienen ventajas; la identidad, la limitación de tasas, la observabilidad, la calidad de las herramientas, la atribución de costes y la experiencia de los desarrolladores mejoran, todo ello desde un único lugar.
  • Los agentes disponen de catálogos más reducidos, nombres de herramientas más claros, paquetes orientados a tareas, menos opciones irrelevantes y flujos de conexión recuperables.

Adopción

La adopción es la verdadera prueba de fuego de una plataforma: los equipos solo la utilizan si resulta más fácil que acceder directamente. Según este criterio, Agent Gateway se ha convertido en la vía predeterminada para el acceso de los agentes a las herramientas en todo el departamento de ingeniería de DoorDash:

  • Hay más de 200 servidores MCP registrados detrás de la pasarela, que en conjunto ponen a disposición miles de herramientas organizadas en subconjuntos aprobados y orientados a tareas concretas, en lugar de catálogos sin filtrar.
  • Más de 30 agentes y servicios, utilizados por miles de empleados, acceden a esas herramientas a través de la pasarela y ninguno de ellos gestiona credenciales sin procesar. 
  • Cada semana se canalizan millones de llamadas a herramientas a través de Agent Gateway, y cada una de ellas se autentica, se autoriza y se registra como un evento de uso estructurado.
  • La incorporación es rápida y se realiza de forma autónoma. Registrar un nuevo servidor MCP y sus herramientas es cuestión de minutos, y asignar un agente a una herramienta ya registrada es aún más rápido.

Lecciones aprendidas

La creación y la ampliación de la pasarela han cambiado nuestra forma de concebir el acceso de los agentes a las herramientas. Hay algunas lecciones que destacan, y no solo en DoorDash:

  • MCP resuelve la invocación, no la gobernanza. La identidad, las políticas, los secretos, la gestión, la observabilidad y la revocación se convierten en las partes más complejas.
  • El catálogo de herramientas descubierto es una interfaz, lo que significa que los nombres, las descripciones, los filtros, las agrupaciones y el público objetivo son importantes.
  • Los paquetes son la unidad adecuada para los flujos de trabajo. Los agentes necesitan conjuntos de herramientas orientados a tareas, no listas de servidores.
  • El filtrado de herramientas mejora tanto la seguridad como la calidad de los agentes, al ofrecer un conjunto de acciones más reducido y claro.
  • Las credenciales deben almacenarse en la pasarela, donde se pueden renovar, auditar y revocar de forma centralizada.
  • La ausencia de autorizaciones OAuth es un estado normal, no una excepción, en la gestión de la conexión dentro del protocolo.
  • La vía regulada debe ser de autoservicio; de lo contrario, los equipos recurrirán directamente a otras vías.

Próximos pasos

La próxima inversión importante se centrará en reforzar la identidad de los agentes y la delegación de usuarios. El modelo objetivo otorga a cada agente una identidad criptográfica y permite que la pasarela genere credenciales delegadas de corta duración, limitadas al usuario, al agente, a la tarea y a la herramienta de destino. De este modo, el registro de auditoría cuenta con dos sujetos reales: el usuario y el agente.

También estamos invirtiendo en herramientas de compilación, lo que incluye fichas de evaluación de calidad y seguridad, comprobaciones de descripciones de herramientas que puedan suponer un riesgo, detección de secretos o información de carácter personal en los errores, creación escalonada de servidores, registro automático, detección dinámica de herramientas y flujos de eventos de llamadas a herramientas censurados para fines de análisis y cumplimiento normativo.

El descubrimiento dinámico sigue la misma línea. En lugar de proporcionar a un agente todas las herramientas de un paquete, la pasarela puede utilizar el contexto de la tarea, la política y las señales de uso para mostrar únicamente aquellas herramientas que puedan resultar útiles para el trabajo en curso.

Conclusión

Agent Gateway transforma el acceso a las herramientas de los agentes, que antes suponía un trabajo de integración repetitivo, en una funcionalidad compartida de la plataforma. MCP facilitó la descripción y la ejecución de herramientas; la pasarela hace que ese acceso esté regulado, supervisado, sea observable y escalable.

Agradecimientos

Introducción

Hemos desarrollado Ask DoorDash sobre una plataforma común que permite a los equipos de cada área desarrollar y mejorar sus agentes sin tener que reconstruir los sistemas subyacentes. Hemos evaluado la plataforma en función de dos resultados prácticos: la rapidez con la que los equipos podían añadir funciones y áreas, y la rapidez con la que podían evaluar e implementar mejoras en materia de costes, calidad y latencia.

Lanzamos «Ask DoorDash» con soporte para restaurantes y tiendas de alimentación en unos dos meses, y desde entonces ha gestionado más de dos millones de conversaciones. La incorporación de «Reservations», nuestro tercer agente temático, nos llevó una semana, lo que supone aproximadamente 10 veces más rápido que la creación de los agentes temáticos iniciales.

Nuestro sistema compartido de evaluación y nuestros controles de implementación proporcionan a los equipos indicadores claros de calidad a medida que incorporan los cambios al entorno de producción. En el plazo de una semana desde el lanzamiento de un nuevo modelo de lenguaje grande (LLM), lo evaluamos y lo implementamos, reduciendo la latencia p50 en un 35 % sin que se produjera ninguna disminución en las puntuaciones de calidad. Una actualización posterior del modelo redujo la latencia p50 en otro 40 %.

En esta entrada se explica cómo elegimos qué elementos debían formar parte de la plataforma, cómo encajan sus componentes entre sí y las concesiones que hay detrás de esas decisiones. Es la continuación de nuestra descripción general de ingeniería, nuestro análisis en profundidad sobre la inteligencia y nuestro análisis en profundidad sobre la evaluación. Próximamente publicaremos un análisis en profundidad sobre la experiencia de usuario.

Cómo elegimos qué normalizar

Solo centralizábamos una funcionalidad cuando varios ámbitos la necesitaban y unas implementaciones independientes podrían generar problemas de fiabilidad u operativos. La orquestación, la memoria, el acceso a los modelos, el seguimiento, la infraestructura de evaluación y los controles de implementación cumplían ese requisito. Los equipos de cada ámbito conservaban la responsabilidad sobre las instrucciones, las competencias, las herramientas, los criterios de evaluación y la elección de modelos que definen a sus agentes.

Cuando existía un estándar del sector adecuado, lo adoptábamos. Agent2Agent (A2A) definía cómo se comunicaban los agentes, mientras que el Kit de Desarrollo de Agentes de Google (ADK) proporcionaba el marco para crearlos y ejecutarlos. Estos estándares limitaban en ocasiones nuestras opciones de diseño, pero proporcionaban a los equipos contratos comunes y nos ahorraban tener que desarrollar equivalentes propios.

En el caso de los problemas recurrentes para los que no existía una norma adecuada, desarrollamos nosotros mismos la capacidad necesaria. Una regresión en el código compartido podía afectar a varios agentes, por lo que era imprescindible contar con controles de evaluación y de implementación. Cada cambio compartido debía superar controles de calidad comunes y medidas de seguridad para el lanzamiento.

Consulta a los arquitectos de DoorDash

La decisión arquitectónica fundamental consistió en determinar qué elementos debían compartir todos los agentes y cuáles debían ser propios de cada dominio. Creamos una ruta de ejecución compartida en torno a agentes especializados, propios de cada dominio. Un único agente de uso general resultaría cada vez más difícil de analizar a medida que asumiera más responsabilidades, mientras que unas pilas de agentes totalmente independientes duplicarían la infraestructura y darían lugar a experiencias incoherentes.

Como muestra la figura 1, cada solicitud entra a través de la pasarela. La pasarela autentica al usuario, recopila el contexto del punto de entrada y realiza la traducción entre las interfaces HTTP y de streaming del cliente y el protocolo A2A de la plataforma. A continuación, envía la solicitud al orquestador, que elige el agente de dominio para cada turno, preservando la continuidad a medida que la conversación se desplaza entre dominios. El agente seleccionado carga las habilidades adecuadas y utiliza herramientas del Protocolo de Contexto de Modelo (MCP) para interactuar con los servicios existentes de DoorDash.

Por debajo de esa ruta de solicitud, la plataforma proporciona estado de sesión, memoria, artefactos, acceso a modelos, seguimiento, infraestructura de evaluación y controles de implementación. Los agentes de dominio utilizan estos servicios comunes sin dejar de mantener el control sobre sus instrucciones, competencias, herramientas y criterios de evaluación.

Figura 1: Ask DoorDash separa el comportamiento específico de los agentes de cada dominio de las capacidades compartidas de ejecución y producción que se utilizan en todo el sistema.

Una plataforma para experiencias adaptativas y multimodales

Las pasarelas de clientes de DoorDash se diseñaron para API que devuelven una respuesta completa rápidamente. Los agentes funcionan de forma diferente. El primer mensaje de texto puede estar listo mientras el agente aún está accediendo a las herramientas, y la respuesta final puede combinar texto con fichas interactivas de tiendas o productos. Necesitábamos gestionar ese flujo de trabajo sin tener que explicar a cada cliente cómo se comunican los agentes.

Gateway se encarga de esta traducción. Autentifica al usuario, añade contexto sobre dónde se inició la conversación y convierte las solicitudes HTTP de los clientes en solicitudes A2A. En la ruta de retorno, utiliza el SDK de IA de Vercel para enviar actualizaciones de texto y datos de los widgets a los clientes a través de Server-Sent Events (SSE). Los clientes muestran las actualizaciones a medida que llegan, de modo que los usuarios pueden ver el progreso mientras el agente completa su turno.

La creación y el funcionamiento del Gateway supusieron un esfuerzo, pero permitieron concentrar el trabajo que, de otro modo, se habría duplicado en cada cliente de DoorDash. Los agentes pueden realizar cambios en el marco de un único contrato de cliente estable, sin necesidad de coordinar las versiones de los clientes. Un nuevo agente de dominio reutiliza la ruta de autenticación y transmisión existente, en lugar de integrarse por separado con cada aplicación.

Un asistente, agentes especializados en el sector

Una conversación puede pasar de un ámbito a otro sin previo aviso. Un usuario podría empezar diciendo: «Quiero que me traigan un pastel de pollo en menos de 30 minutos», y luego decidir: «En realidad, prefiero prepararlo en casa». La primera solicitud pertenece al ámbito de los restaurantes y la segunda, al de la alimentación, pero la experiencia debe dar la sensación de ser una sola conversación.

Probamos una arquitectura con un único agente, pero los ámbitos «Restaurante», «Supermercado» y «Reservas» se basan en herramientas, políticas y criterios de evaluación diferentes. Combinarlos dificultaría las pruebas del agente y obligaría a todos los ámbitos a seguir el mismo ciclo de lanzamiento. Por lo tanto, cada ámbito cuenta con su propio agente especializado. El «Orchestrator» lee la conversación y redirige cada turno al agente adecuado a través de A2A.

Ese enrutamiento añade latencia y tokens de entrada, incluso cuando la conversación permanece en el mismo dominio. Para reducir este coste, el Orchestrator asigna los turnos siguientes al agente de dominio seleccionado. Esta asignación permite que dicho agente gestione las solicitudes posteriores directamente, sin necesidad de otro paso de enrutamiento. Si la conversación cambia de dirección, el agente de dominio reconoce el mensaje fuera de su ámbito y devuelve el control al Orchestrator. El Orchestrator redirige la solicitud dentro del mismo turno, de forma invisible para el usuario.

Figura 2: El «pinning» evita que se realice una llamada al Orchestrator en los turnos siguientes, al tiempo que permite que la conversación se desplace entre dominios.

Las habilidades mantienen el contexto y los costes dentro de unos límites

Los agentes especializados evitaban que «Restaurante», «Tienda de alimentación» y «Reservas» compartieran una única ventana de contexto enorme. Sin embargo, a medida que cada agente adquiría nuevas capacidades, el mismo problema de contexto aparecía dentro de cada dominio. Las nuevas funciones añadían instrucciones y herramientas a cada turno, incluso cuando ese turno nunca las utilizaba. Esto aumentaba el coste de los tokens de entrada, y las instrucciones superpuestas o contradictorias confundían al agente.

Hemos añadido compatibilidad con habilidades a nuestro sistema para modular las instrucciones y las herramientas. En cada turno, el agente carga solo lo que es relevante. Un usuario podría empezar diciendo: «Búscame un restaurante tailandés bien valorado que haga entregas en menos de 30 minutos», y luego decir: «Muéstrame el menú del primero y añade pad see ew a mi carrito». Ambas solicitudes se gestionan a través del agente «Restaurante», pero la primera activa la habilidad de búsqueda y descubrimiento, mientras que la segunda activa la habilidad de pedido y carrito, que se encarga de la navegación por el menú y las acciones relacionadas con el carrito.

La carga dinámica plantea un problema de selección. El selector debe reconocer cuándo se necesita una capacidad sin cargar contexto ajeno con demasiada frecuencia, por lo que evaluamos la selección de habilidades como parte del comportamiento del agente. La complejidad añadida mereció la pena, ya que los equipos pudieron añadir capacidades sin ampliar el contexto de cada turno.

Para medir el efecto, contamos los tokens de las instrucciones de la base del agente y de las habilidades cargadas. Excluimos el historial de conversaciones, los mensajes de los usuarios, los esquemas de herramientas y los resultados de las herramientas. La mediana de los turnos correspondientes a las habilidades utilizó menos de la mitad de tokens de instrucciones que la solicitud del sistema monolítico.

AgenteInstrucciones básicas y de habilidades con todas las habilidades cargadasMediana de instrucciones con especificación de habilidades por turnoReducción
Restaurante~42 000 fichas

~20 000 fichas50 %+
Tienda de comestibles~25 000 fichas~10 000 fichas60%

Acceso seguro y reutilizable a los servicios a través de MCP

Ask DoorDash necesita acceso a los servicios de DoorDash para buscar establecimientos y artículos, consultar menús, gestionar carritos y actuar en nombre del usuario. Las API que sustentan estas operaciones parten de la base de que el código de la aplicación es determinista. Un modelo de lenguaje grande (LLM) que elija las operaciones en tiempo de ejecución necesita una interfaz más específica. Exponer las API directamente obligaría al modelo a interpretar interfaces de bajo nivel. Codificar los permisos y las reglas de negocio únicamente en la indicación añadiría contexto sin garantizar su cumplimiento.

Hemos creado una capa compartida del Protocolo de Contexto del Modelo (MCP) entre los agentes y las API de DoorDash. Cada herramienta MCP expone una operación específica con las entradas y salidas que necesita el modelo. El modelo decide qué herramienta llamar. Un código determinista valida cada solicitud y garantiza el cumplimiento de los permisos y las reglas de negocio antes de que la llamada llegue al servicio subyacente.

Las indicaciones ayudan al modelo a elegir la operación adecuada, pero esa orientación es meramente consultiva. La validación y la aplicación se ejecutan en el código de la herramienta en cada llamada, lo que crea un límite de seguridad estable a medida que cambian las indicaciones y los modelos.

El diseño de herramientas requiere equilibrio. Una herramienta demasiado amplia puede ofrecer al modelo demasiadas opciones, mientras que una demasiado limitada puede convertir una tarea en una larga cadena de llamadas. Nuestro servidor MCP compartido ofrece ahora más de 60 herramientas para los flujos de trabajo de los agentes, tanto públicos como internos. Un agente nuevo selecciona las herramientas que necesita de esa biblioteca, y las mejoras en la validación, la telemetría o la integración de servicios benefician a todos los agentes que las utilizan.

Figura 3: Las indicaciones influyen en lo que solicita el modelo; el código de la herramienta MCP determina lo que se puede ejecutar.

Listo para producción de forma predeterminada

ADK nos proporcionó los elementos básicos para crear un agente, incluyendo instrucciones, herramientas, callbacks, sesiones y la integración de modelos. Los agentes de DoorDash también necesitaban rastreo distribuido, acceso a modelos, estado duradero y controles de implementación. Sin una capa compartida, cada equipo de dominio tendría que tomar esas decisiones y gestionar la infraestructura resultante de forma independiente.

Hemos creado módulos reutilizables basados en ADK para que las funcionalidades funcionen de la misma manera en todos los agentes. Los equipos de cada área siguen eligiendo sus instrucciones, herramientas y configuración de modelos. La plataforma conecta esas elecciones con los sistemas necesarios para ejecutar los agentes de forma fiable en producción.

El rastreo es un ejemplo. Un equipo lo habilita mediante la configuración, y el SDK compartido propaga un identificador de rastreo a través de las llamadas A2A, las herramientas MCP y los servicios posteriores de DoorDash. Los ingenieros pueden seguir una solicitud a lo largo del Orchestrator, los agentes de dominio y las llamadas a herramientas, en lugar de tener que recopilar registros de sistemas independientes. Esos mismos datos de rastreo sirven para la depuración y la evaluación. Ofrecer rastreo a través de la plataforma ahorra aproximadamente un mes de trabajo de observabilidad por cada lanzamiento de un nuevo agente.

El acceso a los modelos sigue el mismo principio. Los equipos de dominio eligen qué modelos utilizan sus agentes, mientras que la plataforma estandariza la forma en que se invocan, se rastrean y se protegen dichos modelos mediante un comportamiento de respaldo. Los equipos pueden evaluar y adoptar nuevos modelos sin necesidad de reescribir las integraciones específicas de cada proveedor. Esa vía común permitió las rápidas actualizaciones de los modelos y las mejoras en la latencia descritas anteriormente.

Estado compartido para conversaciones fiables

Los primeros intentos de crear productos con agentes de DoorDash en 2025 demostraron lo rápido que se deteriora la experiencia cuando el estado no es fiable. Un agente podía responder bien a una solicitud y, a continuación, olvidar o utilizar incorrectamente la información de un turno anterior. Resolver ese problema requirió algo más que añadir el historial de la conversación a la indicación.

Ask DoorDash utiliza tres tipos de estado. El estado de sesión realiza un seguimiento de la conversación activa y del trabajo ya realizado en ella. La memoria conserva información que puede resultar útil en conversaciones posteriores, como las preferencias del usuario. Los artefactos contienen resultados estructurados que los agentes crean y actualizan, como listas de la compra y tarjetas interactivas. Cada uno de ellos tiene una vida útil y un patrón de acceso diferentes.

En proyectos anteriores de agentes de DoorDash, estas capacidades se implementaban de forma independiente. Esto suponía una duplicación del trabajo de persistencia y hacía que la fiabilidad dependiera de las decisiones de cada equipo. Las hemos centralizado en Managed Agent Services, que proporciona API compatibles con ADK para sesiones, memoria y artefactos. Los agentes de dominio utilizan las mismas interfaces sin necesidad de gestionar sus propios sistemas con estado.

Aunque la centralización sigue requiriendo normas de almacenamiento y ciclo de vida independientes para los datos de sesión, la memoria a largo plazo y los artefactos, Managed Agent Services agrupa esos límites en un único lugar. Cada dominio sigue decidiendo qué información debe guardar y recuperar su experiencia.

Los servicios de agentes gestionados y la arquitectura de memoria se tratan con más detalle en la segunda parte.

Manténgase informado con Actualizaciones

Suscríbase a nuestro blog de ingeniería para estar al día de todos los los proyectos más interesantes en los que trabaja nuestro equipo
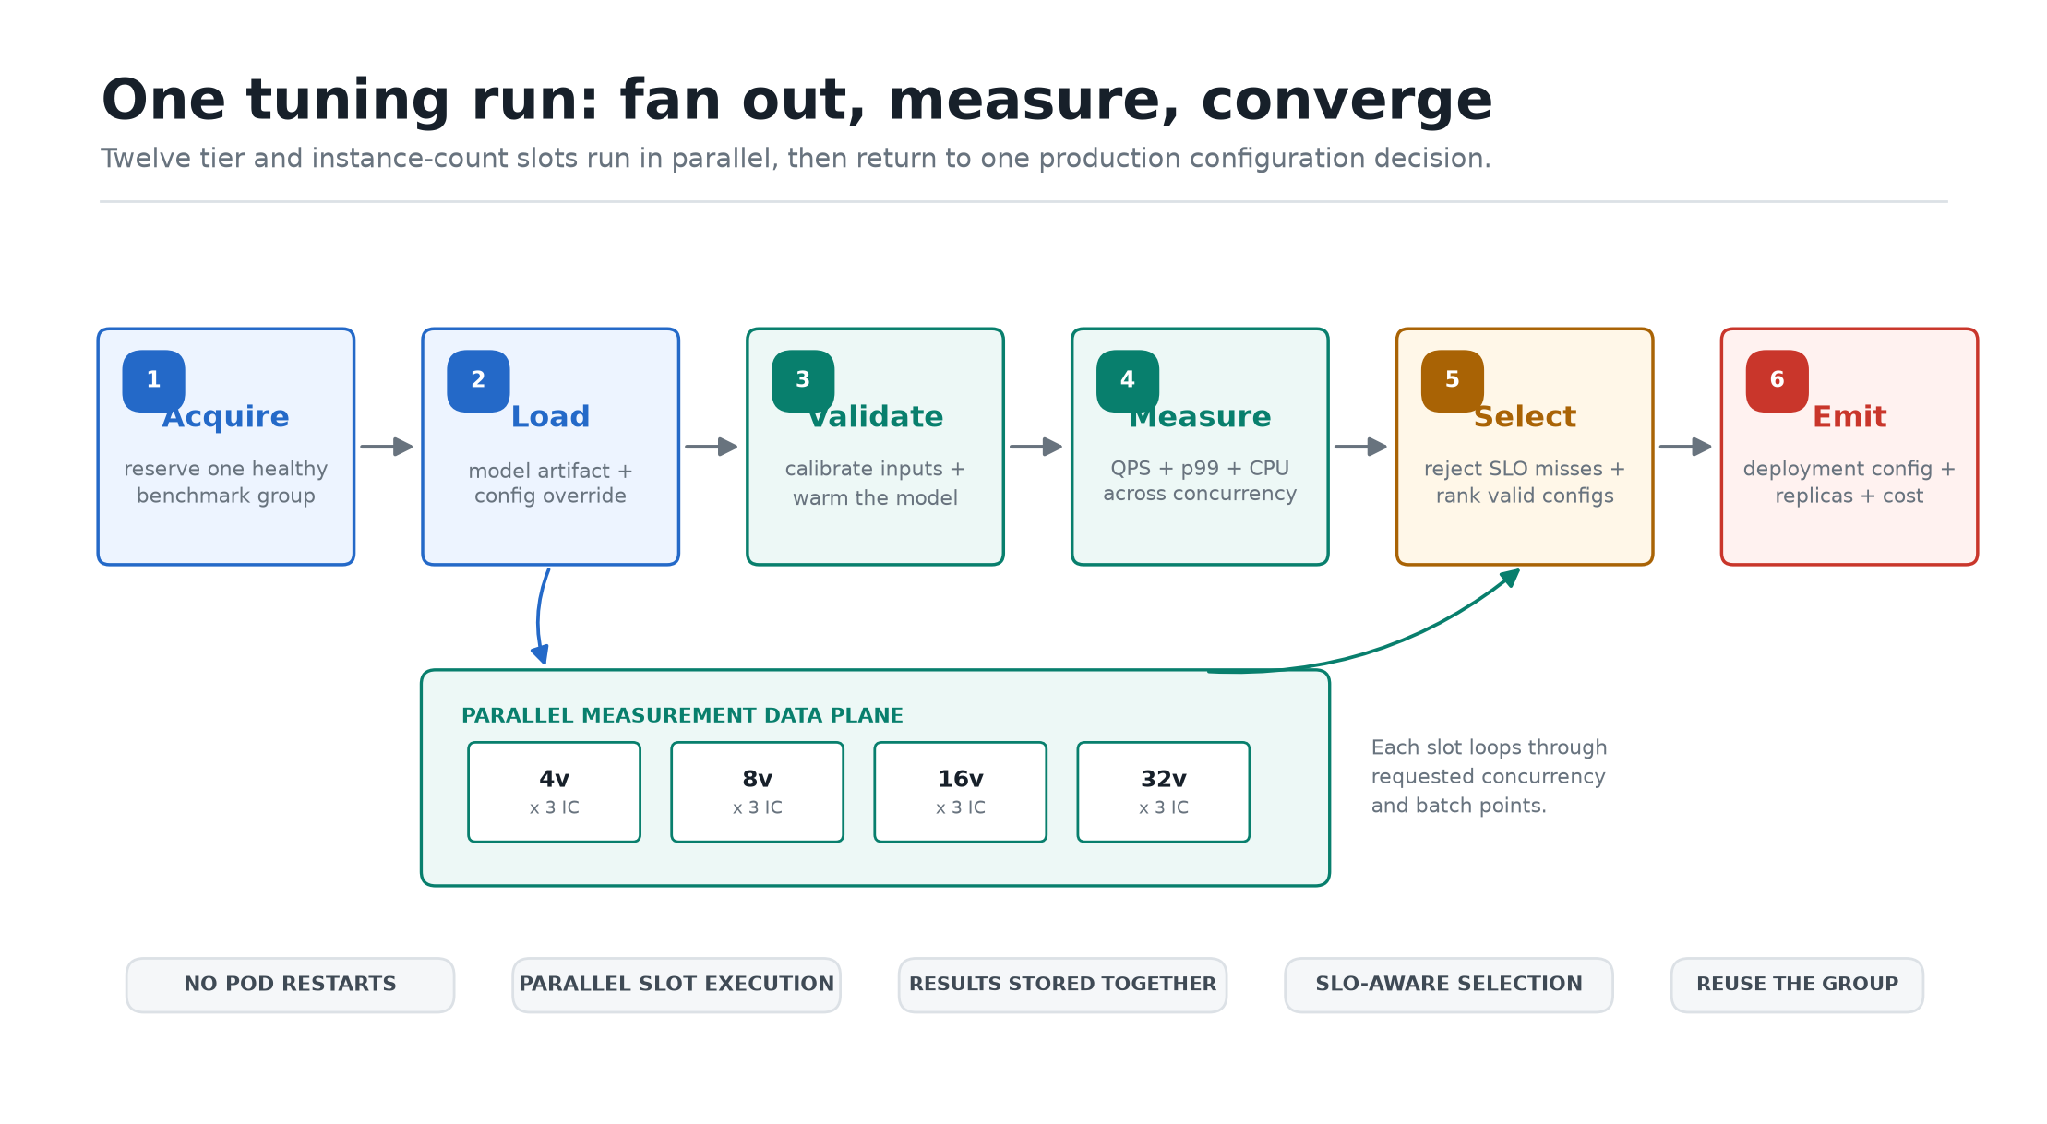
Qué cambió con la plataforma

«Reservas» supuso una prueba concreta de la plataforma. El equipo reutilizó la ruta de producción que ya daba servicio a «Restaurante» y «Tienda de comestibles» y puso en marcha la compatibilidad con «Reservas» en una semana, lo que supuso una velocidad aproximadamente 10 veces mayor que la necesaria para crear los agentes de dominio iniciales.
Los equipos de cada ámbito son los responsables del comportamiento de los agentes y de los criterios de calidad. La plataforma proporciona el marco de evaluación, las herramientas MCP, el seguimiento, el acceso a los modelos y los controles de implementación, de modo que las mejoras introducidas en dichos componentes se aplican a todos los agentes que los utilizan.

La infraestructura compartida amplía el alcance de los errores. Un defecto puede afectar a varios agentes, y una abstracción prematura puede obligar a productos diferentes a adoptar el mismo formato. Solo estandarizamos una funcionalidad cuando varios ámbitos la necesitan y las implementaciones independientes podrían generar problemas de fiabilidad u operativos.

Únete a nosotros

Si te interesa desarrollar plataformas de agentes y IA orientada al usuario a gran escala, consulta nuestras ofertas de empleo en ingeniería en careersatdoordash.com.