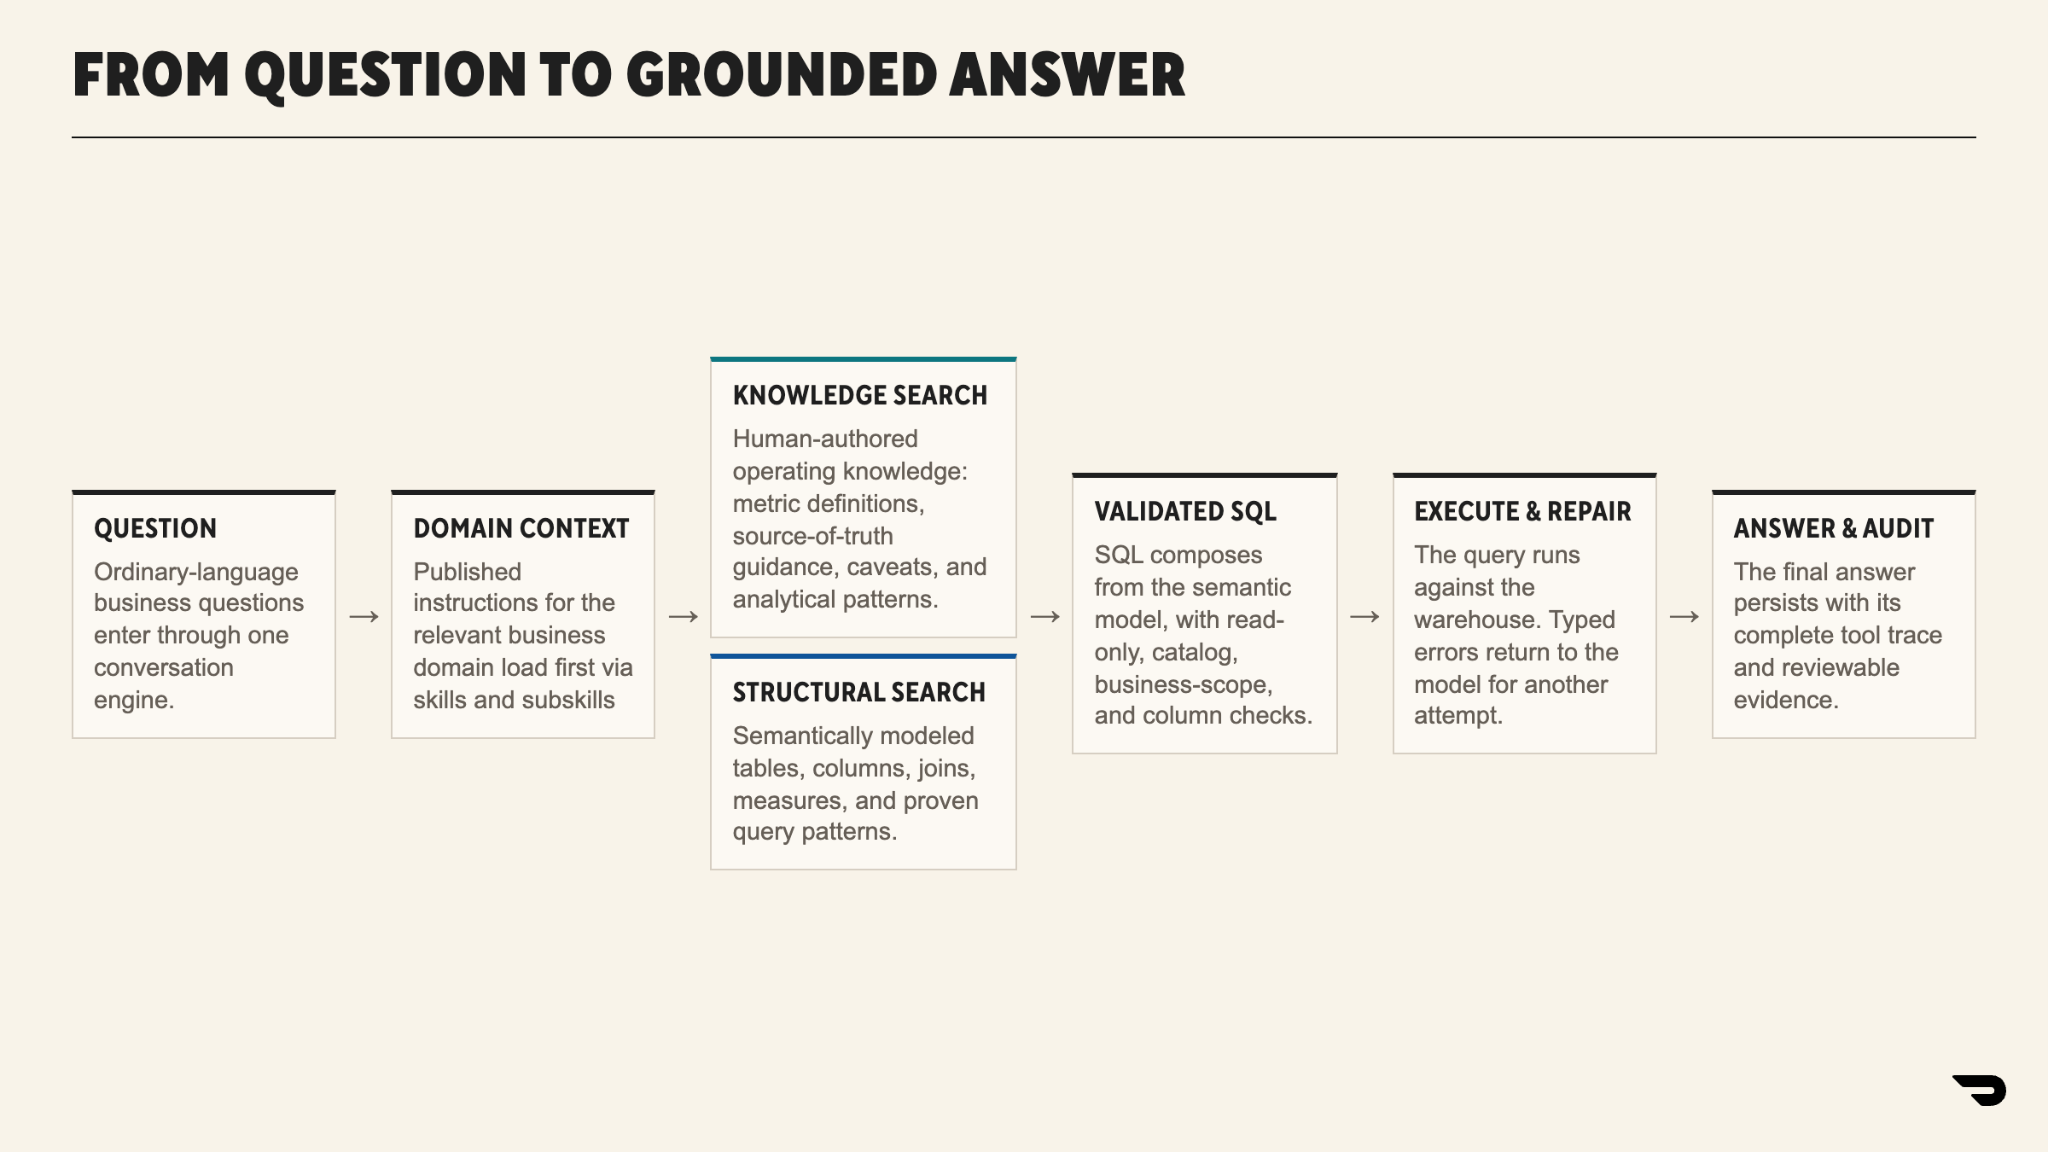
Num mercado, os riscos convergem inevitavelmente para duas questões fundamentais: quem é esta pessoa e qual é o nosso grau de confiança de que esta ação é legítima? Eis alguns exemplos do que queremos dizer com isto: um agente de apoio que avalia um pedido de reembolso precisa de saber estas respostas. Um mecanismo promocional que decide se deve prolongar uma oferta não pode avançar sem esta informação. Um sistema de mitigação de bots que analisa uma tentativa de início de sessão para detetar tráfego automatizado fica de mãos atadas sem estes dados. Os pormenores diferem — o canal, o sinal, o limiar — mas as questões centrais não mudam.
Embora estas questões não sejam novas, a IA tem vindo a exercer uma pressão cada vez maior de ambos os lados da equação; os mesmos avanços que facilitam a geração de comportamentos falsos convincentes em grande escala também tornam possível identificar os intervenientes com sinais mais ricos do que nunca.
No entanto, a identidade nunca foi tratada como uma capacidade horizontal própria. Em vez disso, a maioria dos sistemas foi construída com uma abordagem centrada no produto — um motor de risco para encomendas, um modelo para a segmentação de promoções ou uma regra para a deteção de apropriação de contas. Cada um responde implicitamente a uma versão da pergunta «quem é esta pessoa?» para os seus próprios fins, mas nenhum deles partilha essa resposta. Isto resulta num conjunto de visões parciais da mesma pessoa, cada uma precisa para o seu próprio fim, mas isolada dentro do seu próprio sistema.
A inteligência de identidade parte de uma premissa diferente: se a questão é partilhada, o sinal que a responde também deve sê-lo. Trata-se de um problema de plataforma — resolvido uma vez, de forma centralizada — que é distinto da forma como um determinado sistema opta por agir com base na resposta, o que varia consoante o contexto em que é aplicado. Tratada como uma capacidade horizontal de primeira classe — e não como um subproduto de um determinado produto —, a identidade torna-se um fio condutor presente em quase todos os casos de utilização relacionados com a integridade. Essa é a nossa tese central: a identidade é uma das capacidades com maior impacto, mas menos valorizadas no âmbito da integridade, precisamente porque ninguém a desenvolve como algo autónomo.
A identidade ganha o seu verdadeiro significado
Se essa questão de «quem é este?» é tão universal, por que razão a identidade não foi tratada como uma infraestrutura fundamental desde o início?
No passado, cada superfície de integridade — risco de encomendas, risco de contas ou risco promocional — resolvia primeiro o seu próprio problema e à sua maneira, com os seus próprios sinais de dispositivos, lógica de ligação e definição prática de «a mesma pessoa». É assim que os problemas especializados tendem a ser resolvidos: com uma regra aqui e um modelo ali, cada um concebido para um fim específico e de rápida implementação. Uma camada de identidade partilhada é um tipo diferente de investimento: não pertence a nenhuma área específica, pelo que nenhuma delas está naturalmente posicionada para a construir, apesar de todas elas beneficiarem com isso.
O resultado até à data tem sido um sinal de identidade que não é reutilizável tal como está. Cada nova equipa que pretendesse essa resposta tinha de a implementar do zero, através de uma integração personalizada e única, em vez de se ligar a uma interface padrão. Durante anos, os sinais de identidade existiram em todo o lado, mas não pertenciam a ninguém; cada equipa pagava para voltar a obter uma resposta parcial, enquanto ninguém captava o valor acumulado de responder à pergunta uma única vez e partilhá-la.
Criação de uma plataforma de inteligência de identidade
Na DoorDash, decidimos colmatar essa lacuna através da conceção de uma nova infraestrutura. Em vez de cada sistema criar a sua própria lógica de ligação com base nos seus próprios sinais, queríamos que a identidade se tornasse algo criado uma única vez e utilizado em todo o lado.
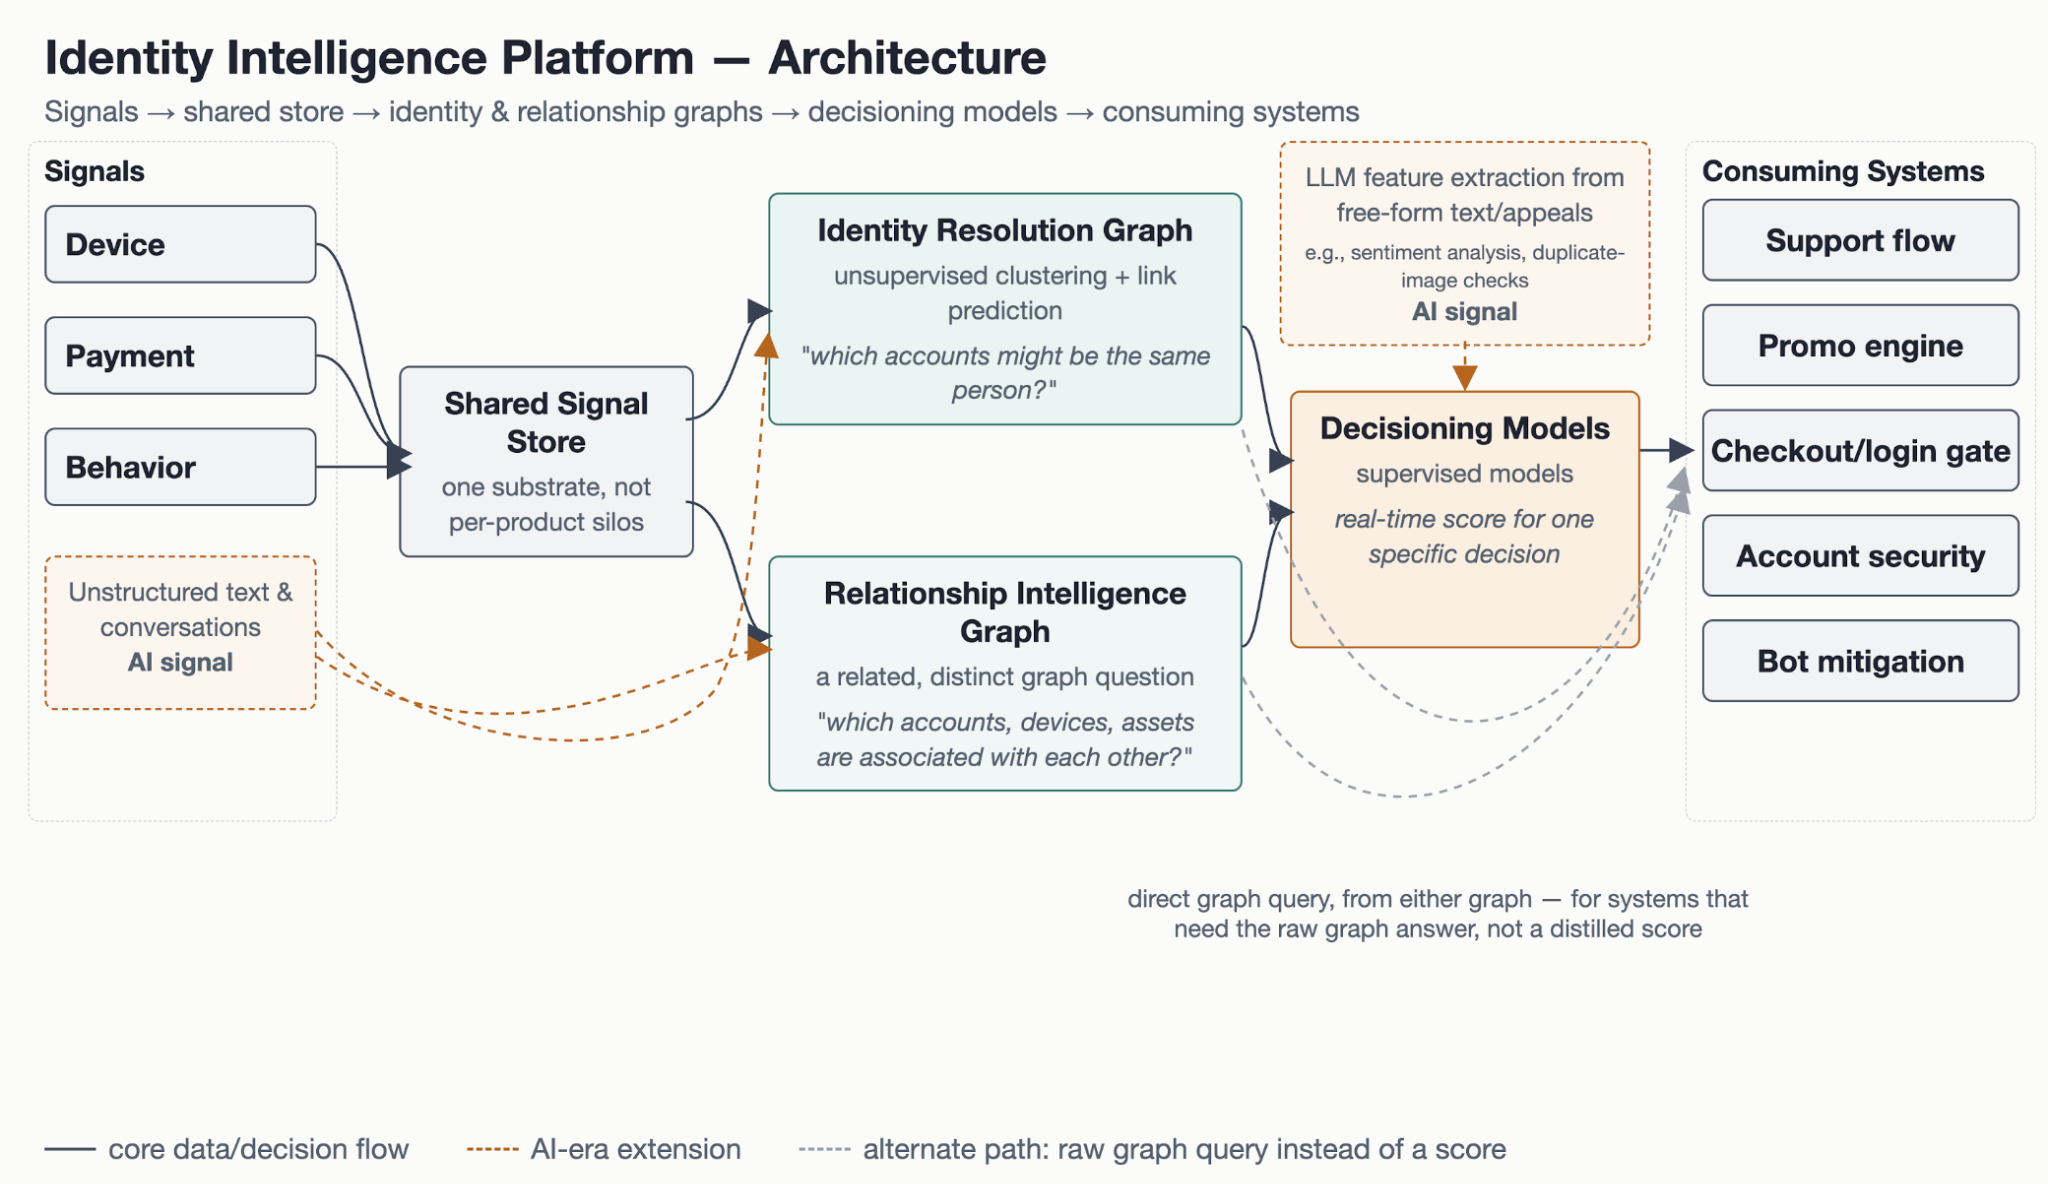
Na prática, isso significava criar três camadas sobre uma base de dados de sinais partilhada:
- Em primeiro lugar, a resolução de identidades: um gráfico de resolução de entidades com mais de mil milhões de arestas, construído principalmente com técnicas de agrupamento não supervisionado e de previsão de ligações, que investiga quais as contas que poderão corresponder à mesma pessoa.
- Em segundo lugar, inteligência relacional: uma questão relacionada com os gráficos, mas diferente: que pessoas, contas, dispositivos e ativos estão associados entre si? Esta camada reconhece que duas contas podem estar ligadas de forma significativa sem corresponderem à mesma pessoa.
- Em terceiro lugar, os modelos de tomada de decisão: normalmente modelos de aprendizagem supervisionada, tais como classificadores com reforço de gradiente, treinados com base em resultados conhecidos para um caso de utilização específico. Esta camada utiliza as duas primeiras camadas para fornecer uma resposta em tempo real à pergunta: este evento específico, para esta decisão específica, é legítimo?
Vamos usar um dos casos mais complexos de resolução de identidade como exemplo — um cliente que acabou de se registar, faz a sua primeira encomenda e apresenta um pedido de apoio. Não há histórico com o qual comparar, nem é provável que haja uma correspondência forte com uma conta existente; a resolução de identidade, por si só, não tem muitos elementos em que se basear. O que a conta possui, desde o momento em que é criada, é um conjunto de atributos de identidade, tais como um dispositivo, um número de telefone, uma morada ou um cartão registado. A plataforma já regista em que contas cada um desses atributos apareceu, pelo que uma sobreposição em qualquer um deles é visível imediatamente, sem ter de esperar por uma única encomenda ou pedido de assistência. Um endereço partilhado, por exemplo, é um ponto de partida, mas um simples indicador de «partilhado ou não» é demasiado vago para se agir com base nele; não indica se esse endereço está associado a duas contas ou a 200, se todas surgiram no mesmo dia ou ao longo de anos, ou se esse padrão é sequer invulgar. É essa a função da inteligência de relações: não identificar quem é uma pessoa, mas caracterizar o grau de interligação entre elas. Ela analisa minuciosamente mais de 100 sinais derivados calculados por conta, cada um captando quantas outras contas partilham um determinado atributo, há quanto tempo e quão anómalo isso parece quando comparado com um cliente comum.
Mas mesmo tudo isto não constitui uma decisão. Um simples facto sobre o gráfico — como, por exemplo, o facto de este endereço ter 40 contas associadas, a maioria criada na última semana — não constitui um veredicto sobre este pedido de apoio específico. Transformar um facto num veredicto é a função do modelo de tomada de decisão. Este é treinado com base em resultados para saber até que ponto esse padrão deve ser relevante para este tipo específico de pedido; a sua conclusão é disponibilizada em tempo real, para que esteja pronta no momento em que o pedido for recebido.
É por isso que a plataforma precisa das três camadas, e não apenas da primeira. A resolução de identidade determina se duas contas pertencem à mesma pessoa, enquanto a inteligência de relações fornece uma resposta útil mesmo quando a resolução não produz resultados; nenhuma delas constitui uma decisão até que um modelo criado para esse caso de utilização específico a transforme numa decisão.
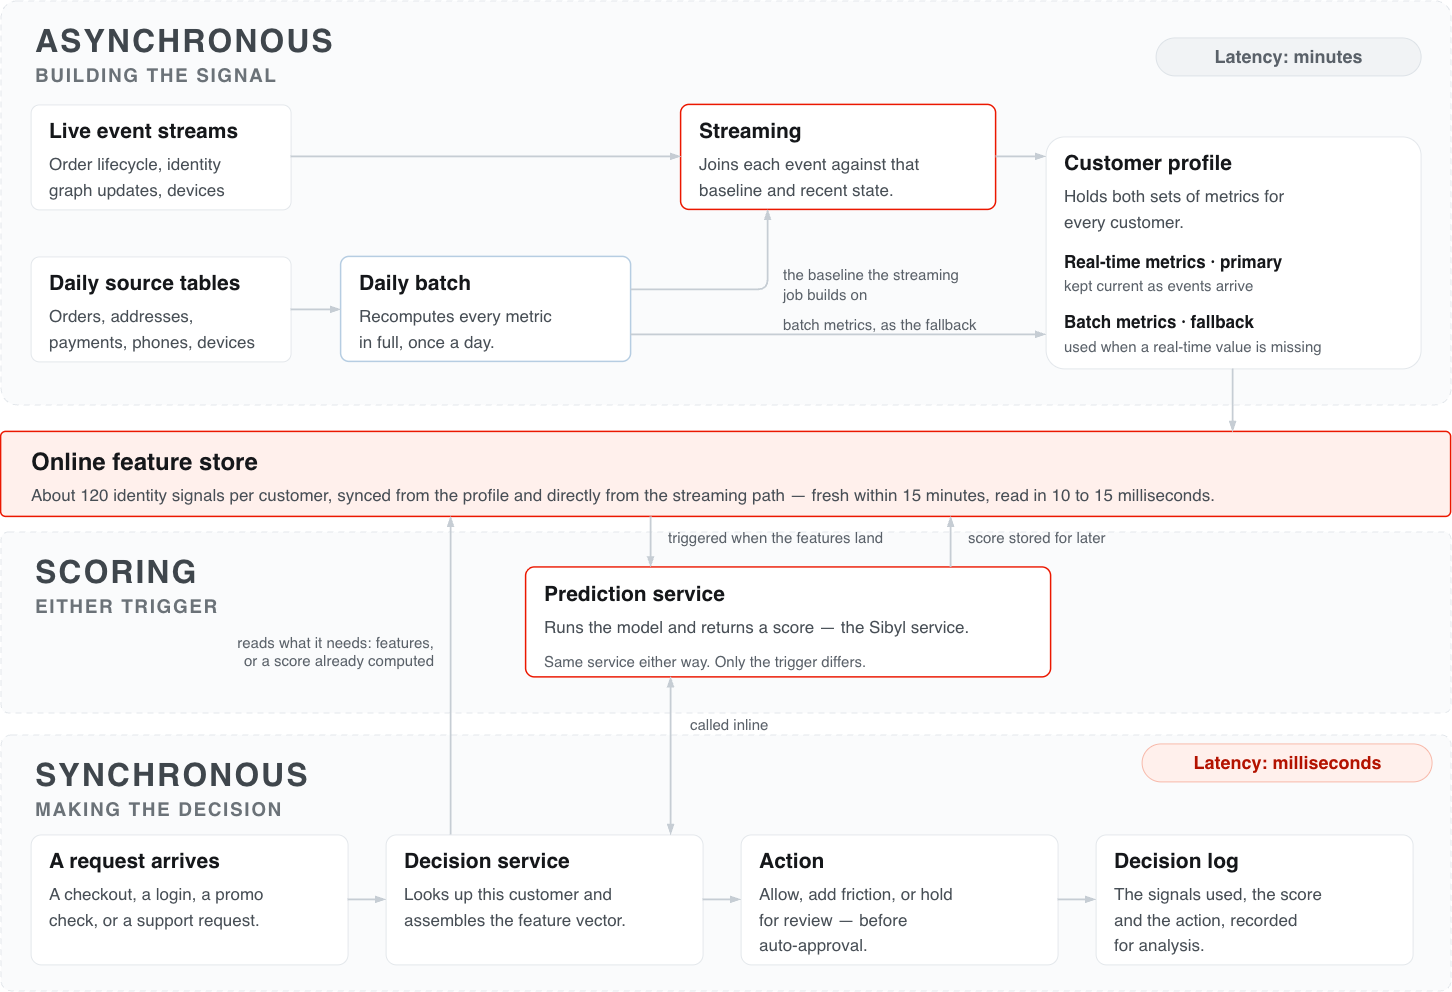
A plataforma separa o cálculo do sinal da atribuição de pontuação (Figura 2). As características são agregadas de forma assíncrona e ficam prontas poucos minutos após qualquer alteração. Um ponto de verificação recupera o que precisa em 10 a 15 milissegundos, em vez de esperar por qualquer tarefa que o tenha produzido. A pontuação ocorre então onde a margem de latência da superfície o permitir; é executada em linha quando há espaço disponível, ou pode ser acionada assim que as características forem disponibilizadas, para que a pontuação seja armazenada e lida no momento da decisão.
Uma base, vários casos de utilização
Os sistemas a jusante — por exemplo, um fluxo de apoio, um motor promocional ou um portal de finalização de compra — nem todos necessitam da mesma camada. Alguns sistemas podem obter uma resposta diretamente do gráfico de identidades e relações; outros precisam que essa resposta seja refinada através do modelo de decisão adequado, transformando-se numa pontuação em tempo real concebida para essa decisão específica. Estes sistemas nunca precisam de saber como é o gráfico subjacente.
O agrupamento de identidades de consumidores é o exemplo mais claro dessa plataforma em ação. Essas contas parecem pertencer a pessoas diferentes, mas, na realidade, são da mesma pessoa. Trata-se, especificamente, de resolução de identidade: determinar se duas contas correspondem a uma única pessoa, e não apenas se estão, de alguma forma, ligadas. Nos bastidores, o agrupamento de identidades avalia a fiabilidade de cada sinal que liga duas contas e a improbabilidade de duas pessoas diferentes partilharem esse sinal por coincidência. Quanto mais improvável for um sinal partilhado, maior será o peso que este tem por si só; sinais mais comuns ou mais fáceis de partilhar só têm peso em combinação, quando vários deles se somam. Como funciona continuamente em relação ao gráfico de identidade da DoorDash, em vez de ser uma tarefa em lote periódica, pode ser verificado no momento em que é recebido um pedido de início de sessão, finalização de compra ou reembolso.
Assim que esse agrupamento existe, o mesmo sinal subjacente de identidade e relação — reutilizado em vez de reconstruído — surge em toda a restante área de cobertura da integridade. Nos fluxos de trabalho de apoio, esse mesmo agrupamento ajuda a distinguir uma falha de serviço genuína de uma situação em que uma pessoa apresenta reclamações aparentemente semelhantes em várias contas. Nas promoções, determina a elegibilidade ao distinguir um novo cliente de uma pessoa que já tenha usufruído de uma oferta sob uma identidade diferente. Na segurança das contas, sinaliza um início de sessão com a palavra-passe correta que não se comporta como o titular da conta. Ampliada de uma pessoa para muitas, uma camada relacionada, mas distinta — a inteligência de relações, e não a resolução de identidade — é o que revela abusos coordenados; isto pode assumir a forma de uma rede de contas que parecem independentes individualmente, mas que se revelam agir como uma única operação depois de as suas ligações serem mapeadas. Na mitigação de bots, distingue um ser humano a lidar com atritos de um script a funcionar em grande escala.
Nenhuma destas situações exigia um novo tipo de sinal, mas sim o mesmo, encaminhado para uma decisão diferente em cada ocasião. É isso que uma plataforma partilhada torna possível: um único substrato, múltiplas decisões. E, uma vez que essa plataforma existe, não tem de se limitar a identificadores diretos.
A identidade é mais do que um identificador
Os identificadores diretos eram, naturalmente, o ponto de partida óbvio — um ID de dispositivo, um número de telefone, um e-mail ou um cartão registado no sistema. Trata-se de sinais poderosos, difíceis de falsificar e que, muitas vezes, por si só, são suficientes para responder com segurança à pergunta «quem é este?». No entanto, um malfeitor suficientemente determinado ainda consegue contorná-los com um novo dispositivo, um novo número, um novo e-mail ou um novo cartão — fazendo com que o rasto direto se perca.
O comportamento ajuda a colmatar essa lacuna. A forma como uma pessoa se move num mercado — o ritmo das suas ações, os seus padrões de navegação, as ações de finalização de compra ou as interações com o apoio ao cliente — também constitui uma forma de identidade, que tende a persistir mesmo quando os identificadores que a rodeiam são substituídos. Não substitui os sinais diretos; é uma camada complementar para os casos em que os sinais diretos, por si só, não são suficientes.
Esta nova perspetiva é importante porque altera a definição de «a mesma pessoa». Duas contas com dispositivos e métodos de pagamento completamente diferentes podem, ainda assim, ser reconhecidas como pertencendo à mesma pessoa, se o comportamento for tido em conta. Duas contas que pareçam não ter qualquer relação, com base em todos os identificadores diretos, podem, ainda assim, justificar uma análise mais aprofundada, se o seu comportamento for demasiado semelhante para ser uma coincidência.
O futuro da IA na área da identidade
A forma mais clara de avaliar uma plataforma como esta não reside numa única conquista, mas sim nos clientes que nem sequer se apercebem de que algo aconteceu, mas que, ainda assim, beneficiam de uma experiência mais simplificada. A inteligência de identidade elimina os obstáculos que os clientes honestos têm sido obrigados a suportar; um sistema mais seguro, capaz de chegar mais rapidamente a uma conclusão sobre com quem está a lidar, alivia-os desse fardo.
Esta mesma ideia pode ser aplicada a dados de entrada mais ricos. Atualmente, os nossos sinais comportamentais ainda dependem em grande medida de resumos numéricos. No entanto, os modelos LLM e de IA generativa poderão permitir-nos, no futuro, extrair informações a partir de texto não estruturado, imagens e conversas informais, com custos de desenvolvimento muito mais baixos do que anteriormente.
Ao contrário do que acontece nos modelos tradicionais de redes neurais, em que os subcomponentes de texto e imagem têm de ser criados do zero, agora podemos utilizar endpoints de IA gerativa já disponíveis ou aproveitar a camada de saída de modelos de grande dimensão pré-treinados para gerar características relacionadas com texto/imagem, tais como a descrição de problemas, a análise de sentimentos ou a verificação de imagens duplicadas. Além disso, podemos explorar arquiteturas de modelos baseadas em transformadores para selecionar embeddings de identidade do utilizador que possam potencialmente revolucionar a forma como definimos clusters no gráfico de identidade. Na arquitetura acima, estes apresentam-se como dois caminhos separados (Figura 1): um LLM a extrair características diretamente de recursos de forma livre e embeddings de texto a tornarem-se um novo tipo de aresta no gráfico de identidade.
Dito isto, os mesmos avanços na IA que facilitam a criação de um sinal de identidade fiável também facilitam a sua falsificação, com comportamentos sintéticos mais convincentes, variações automatizadas entre contas ou respostas adversárias mais rápidas às nossas novas políticas. Tratar a identidade como uma plataforma, em vez de um conjunto heterogéneo de verificações pontuais, permite acompanhar o ritmo, oferecendo um único local para integrar um novo tipo de sinal, em vez de depender de uma dúzia de sistemas separados, cada um à espera da sua vez para se atualizar.
Em última análise, o nosso objetivo é reduzir a necessidade de respostas personalizadas e pontuais em matéria de identidade, desenvolvendo uma base consistente de identidade e relações que sirva todos os pontos de decisão que dela necessitem.
Mantenha-se informado com as actualizações semanais
Subscreva o nosso blogue de Engenharia para receber actualizações regulares sobre todos os projectos mais interessantes em que a nossa equipa está a trabalhar