Skip to content

Sur une place de marché, les risques se résument inévitablement à deux questions fondamentales : « Qui est cette personne ? » et « Dans quelle mesure sommes-nous sûrs que cette action est légitime ? ». Voici quelques exemples illustrant ce que nous entendons par là : un agent du service client chargé d’évaluer une demande de remboursement doit connaître les réponses à ces questions. Un moteur promotionnel chargé de décider s’il convient de proposer une offre ne peut pas aller de l’avant sans ces informations. Un système de lutte contre les bots chargé de filtrer une tentative de connexion à la recherche de trafic automatisé est paralysé sans ces données. Les détails varient — le canal, le signal, le seuil — mais les questions fondamentales restent les mêmes. 

Même si ces questions ne sont pas nouvelles, l’IA exerce une pression croissante des deux côtés de l’équation ; les mêmes avancées qui facilitent la génération à grande échelle de comportements factices convaincants permettent également d’identifier les acteurs grâce à des signaux plus riches que jamais.

Pourtant, l’identité n’a jamais été considérée comme une capacité horizontale à part entière. Au contraire, la plupart des systèmes ont été conçus en privilégiant d’abord le produit : un moteur de risque pour les commandes, un modèle de ciblage promotionnel ou une règle de détection de piratage de compte. Chacun répond implicitement à une variante de la question « qui est cette personne ? » à ses propres fins, mais aucun d’entre eux ne partage cette réponse. Il en résulte un ensemble de vues partielles d’une même personne, chacune exacte pour son usage spécifique, mais cloisonnée au sein de son propre système.

L’« intelligence identitaire » part d’un postulat différent : si la question est partagée, le signal qui y répond doit l’être également. Il s’agit là d’un problème de plateforme — résolu une fois pour toutes, de manière centralisée — qui se distingue de la manière dont un système donné choisit d’agir sur la réponse, laquelle varie en fonction du contexte d’application. Considérée comme une capacité horizontale de premier ordre — et non comme un sous-produit d’un produit particulier —, l’identité devient un fil conducteur qui traverse presque tous les cas d’utilisation liés à l’intégrité. Telle est notre thèse centrale : l’identité est l’une des capacités les plus efficaces, mais aussi les moins appréciées, dans le domaine de l’intégrité, précisément parce que personne ne la développe en tant que capacité à part entière.

L'identité prend tout son sens

Si cette question « qui est-ce ? » est si universelle, pourquoi l'identité n'a-t-elle pas été considérée dès le départ comme une infrastructure fondamentale ?

Par le passé, chaque interface d’intégrité — risque lié aux commandes, risque lié aux comptes ou risque lié aux promotions — a d’abord résolu son propre problème à sa manière, avec ses propres signaux de dispositif, sa logique de mise en relation et sa définition opérationnelle de « la même personne ». C’est ainsi que les problèmes spécialisés sont généralement résolus : avec une règle par-ci, un modèle par-là, chacun conçu sur mesure et rapidement déployable. Une couche d’identité partagée représente un investissement d’un autre ordre : elle n’appartient à aucun domaine en particulier, de sorte qu’aucun d’entre eux n’est naturellement placé pour la mettre en place, même si chacun d’entre eux en tirerait profit.

Le résultat obtenu à ce jour est un indicateur d’identité qui n’est pas réutilisable tel quel. Chaque nouvelle équipe souhaitant obtenir cette réponse devait la mettre en place à partir de zéro, via une intégration sur mesure et unique, au lieu de se connecter à une interface standard. Pendant des années, les indicateurs d’identité ont existé partout sans appartenir à personne ; chaque équipe payait pour redéfinir une réponse partielle, tandis que personne ne tirait parti de la valeur ajoutée que représenterait le fait de répondre une seule fois à la question et de partager cette réponse.

Mise en place d'une plateforme d'intelligence identitaire

Chez DoorDash, nous avons décidé de combler cette lacune en concevant une nouvelle infrastructure. Plutôt que de laisser chaque système développer sa propre logique de mise en relation à partir de ses propres signaux, nous voulions que l'identité soit un élément créé une seule fois et réutilisable partout.

Concrètement, cela impliquait de créer trois couches s'appuyant sur un espace de stockage de signaux commun :

  • Tout d'abord, la résolution d'identité : un graphe de résolution d'entités comptant plus d'un milliard d'arêtes, construit principalement à l'aide de techniques de regroupement non supervisé et de prédiction de liens, qui permet de déterminer quels comptes pourraient correspondre à une même personne. 
  • Deuxièmement, l'intelligence relationnelle : une question liée aux graphes, mais différente : quelles personnes, quels comptes, quels appareils et quels actifs sont associés les uns aux autres ? Cette couche tient compte du fait que deux comptes peuvent être liés de manière significative sans pour autant correspondre à la même personne. 
  • Troisièmement, les modèles décisionnels : il s'agit généralement de modèles d'apprentissage supervisé, tels que les classificateurs à gradient boosté, entraînés à partir de résultats connus pour un cas d'utilisation spécifique. Cette couche exploite les deux premières couches pour fournir une réponse en temps réel à la question suivante : cet événement particulier, dans le cadre de cette décision spécifique, est-il légitime ?
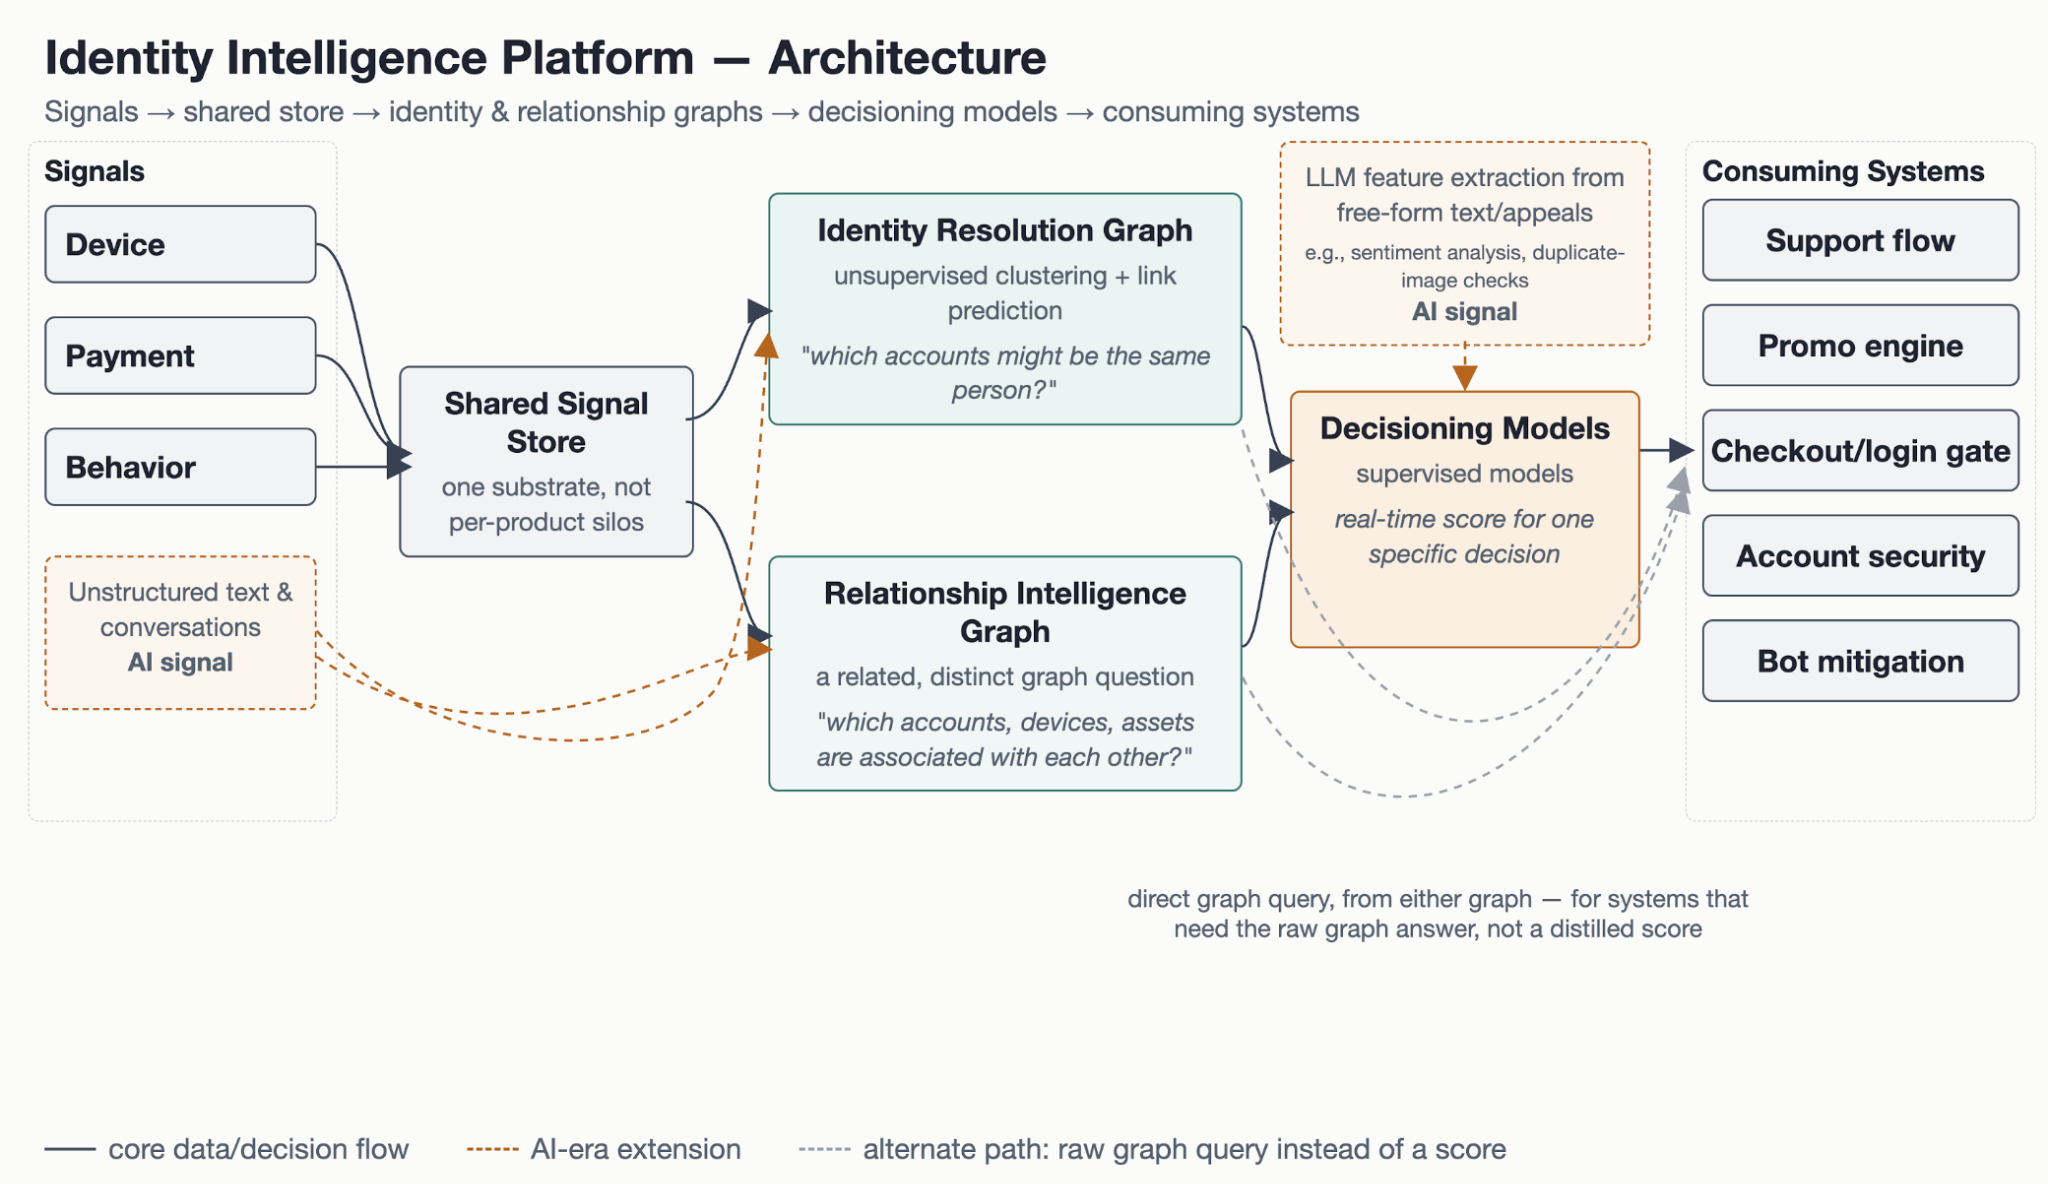
FIGURE 1 : UNE MÉMOIRE DE SIGNAL PARTAGÉE ALIMENTE DEUX GRAPHES — L'IDENTITÉ D'UNE PERSONNE ET SES RELATIONS — DONT LA SORTIE EST TRADUITE PAR UNE SEULE COUCHE D'ÉVALUATION EN UNE SEULE DÉCISION.

Prenons comme exemple l’un des cas les plus complexes en matière de résolution d’identité : un client qui vient de s’inscrire, passe une première commande et soumet une demande d’assistance. Il n’y a pas d’historique auquel se référer, et il est peu probable qu’il y ait une correspondance forte avec un compte existant ; la résolution d’identité à elle seule ne dispose donc pas de beaucoup d’éléments pour s’appuyer. Ce dont dispose le compte, dès sa création, c’est d’une poignée d’attributs d’identité, tels qu’un appareil, un numéro de téléphone, une adresse ou une carte enregistrée. La plateforme suit déjà les comptes sur lesquels chacun de ces attributs est apparu ; ainsi, tout recoupement entre eux est immédiatement visible, sans qu’il soit nécessaire d’attendre une commande ou une demande d’assistance. Une adresse partagée, par exemple, est un point de départ, mais le simple fait de savoir si elle est partagée ou non est trop vague pour permettre d’agir ; cela ne précise pas si cette adresse est associée à deux comptes ou à 200, si ils sont tous apparus le même jour ou au fil des années, ni même si ce schéma est inhabituel. C’est là le rôle de l’intelligence relationnelle : non pas d’identifier qui est une personne, mais de caractériser le degré de ses connexions. Elle passe au crible plus de 100 signaux dérivés calculés pour chaque compte, chacun d’entre eux indiquant combien d’autres comptes partagent un attribut donné, depuis combien de temps, et dans quelle mesure cela semble anormal par rapport à un client ordinaire.

Mais tout cela ne constitue pas pour autant une décision. Un simple fait concernant le graphe — par exemple, cette adresse est associée à 40 comptes, dont la plupart ont été créés la semaine dernière — ne constitue pas un verdict sur cette demande d’assistance particulière. C’est au modèle décisionnel de faire le lien entre les deux. Il est entraîné à partir de résultats pour déterminer dans quelle mesure ce schéma doit être pris en compte pour ce type spécifique de demande ; sa conclusion est disponible en temps réel, de sorte qu’elle est prête dès qu’une demande est reçue.

C’est pourquoi la plateforme a besoin de ces trois couches, et pas seulement de la première. La résolution d’identité permet de déterminer si deux comptes correspondent à une même personne, tandis que l’intelligence relationnelle fournit une réponse utile même lorsque la résolution d’identité ne donne aucun résultat ; aucune de ces deux informations ne constitue une décision tant qu’un modèle conçu pour ce cas d’utilisation spécifique ne l’a pas transformée en décision.

La plateforme sépare le calcul des signaux de la notation (figure 2). Les caractéristiques sont agrégées de manière asynchrone et disponibles en quelques minutes après tout changement. Un point de contrôle récupère les données dont il a besoin en 10 à 15 millisecondes, sans attendre la fin du traitement qui les a générées. L’évaluation s’effectue ensuite là où le budget de latence de l’interface le permet ; elle est appelée « en ligne » lorsqu’il y a de la place, ou peut être déclenchée dès que les caractéristiques sont disponibles, de sorte que le score soit stocké et lu au moment de la prise de décision.
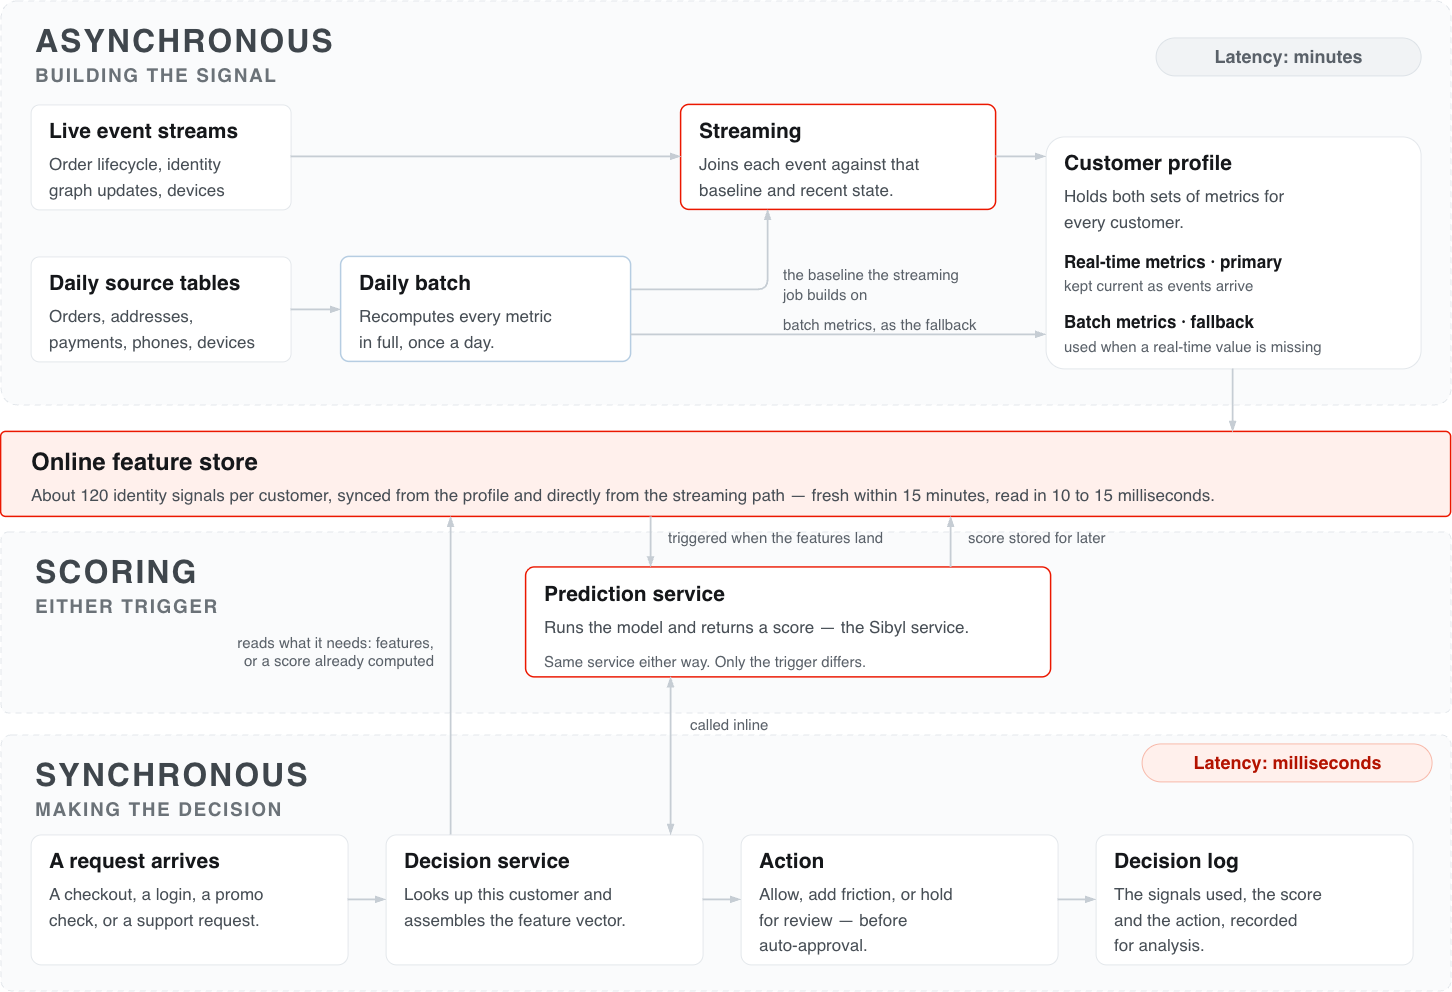
Figure 2 : LES SIGNAL D'IDENTITÉ SONT GÉNÉRÉS SELON LEUR PROPRE HORLOGE ET ENREGISTRÉS UNE SEULE FOIS ; AUCUNE DÉCISION NE DÉPEND DONC DE L'AGRÉGATION QUI LES SOUS-TEND.

Une base commune, de nombreux cas d'utilisation

Les systèmes en aval — par exemple, un flux d'assistance, un moteur promotionnel ou une passerelle de paiement — n'ont pas tous besoin de la même couche. Certains systèmes peuvent obtenir une réponse directement à partir du graphe d'identité et de relations ; d'autres ont besoin que cette réponse soit affinée via le modèle décisionnel approprié pour aboutir à un score en temps réel conçu pour cette décision spécifique. Ces systèmes n'ont jamais besoin de savoir à quoi ressemble le graphe sous-jacent.

Le regroupement d’identités des consommateurs est l’exemple le plus parlant de cette plateforme en action. Ces comptes semblent appartenir à des personnes distinctes, mais correspondent en réalité à une seule et même personne. Il s’agit précisément de « résolution d’identité », c’est-à-dire déterminer si deux comptes correspondent à un seul et même individu, et pas seulement s’ils sont liés d’une manière ou d’une autre. En coulisses, le système de regroupement d’identités évalue la fiabilité de chaque signal reliant deux comptes et la probabilité que deux personnes différentes le partagent par hasard. Plus un signal partagé est improbable, plus il a de poids en soi ; les signaux plus courants ou plus faciles à partager n’ont de poids qu’en combinaison, lorsque plusieurs d’entre eux s’additionnent. Comme ce processus s’exécute en continu par rapport au graphe d’identité de DoorDash plutôt que sous la forme d’une tâche par lots périodique, il peut être vérifié dès qu’une connexion, un paiement ou une demande de remboursement est enregistrée.

Une fois ce regroupement établi, le même signal sous-jacent d’identité et de relation — réutilisé plutôt que recréé — apparaît sur l’ensemble du reste de la surface d’intégrité. Dans les workflows d’assistance, ce même regroupement permet de distinguer une véritable défaillance de service d’une personne déposant des réclamations d’apparence similaire sur plusieurs comptes. Dans le cadre des promotions, il détermine l’éligibilité en distinguant un nouveau client d’une personne ayant déjà bénéficié d’une offre sous une autre identité. En matière de sécurité des comptes, il signale une connexion effectuée avec le mot de passe correct mais dont le comportement ne correspond pas à celui du titulaire du compte. À plus grande échelle, passant d’une seule personne à plusieurs, une couche connexe mais distincte — l’intelligence relationnelle, et non la résolution d’identité — permet de mettre au jour les abus coordonnés ; ceux-ci peuvent prendre la forme d’un réseau de comptes qui semblent indépendants individuellement mais qui, une fois leurs liens cartographiés, apparaissent comme fonctionnant comme une seule et même opération. Dans la lutte contre les bots, ce système distingue un humain confronté à des difficultés d’utilisation d’un script fonctionnant à grande échelle. 

Aucun d’entre eux ne nécessitait un nouveau type de signal, mais simplement le même, acheminé vers une décision différente à chaque fois. C’est ce que permet une plateforme partagée : un seul substrat, de multiples décisions. Et une fois cette plateforme mise en place, elle ne se limite pas nécessairement aux identifiants directs.

L'identité, c'est bien plus qu'un simple identifiant

Les identifiants directs constituaient bien sûr le point de départ évident : un identifiant d’appareil, un numéro de téléphone, une adresse e-mail ou une carte enregistrée. Il s’agit là de signaux puissants, difficiles à falsifier, qui suffisent souvent à eux seuls à répondre avec certitude à la question « qui est-ce ? ». Mais un malfaiteur suffisamment déterminé peut toujours les contourner en utilisant un nouvel appareil, un nouveau numéro, une nouvelle adresse e-mail ou une nouvelle carte, ce qui fait perdre la trace directe.

Le comportement permet de combler cette lacune. La manière dont une personne évolue sur une place de marché — le rythme de ses actions, ses habitudes de navigation, ses actions lors du paiement ou ses interactions avec le service client — constitue également une forme d’identité, qui a tendance à perdurer même lorsque les identifiants qui l’entourent sont modifiés. Cela ne remplace pas les signaux directs ; il s’agit d’une couche complémentaire pour les cas où les signaux directs ne suffisent pas à eux seuls.

Ce recadrage est important car il modifie la définition de « la même personne ». Deux comptes associés à des appareils et des moyens de paiement totalement différents peuvent tout de même être identifiés comme appartenant à la même personne si l'on tient compte du comportement. Deux comptes qui semblent n'avoir aucun lien selon tous les identifiants directs peuvent néanmoins justifier un examen plus approfondi si leur comportement présente trop de similitudes pour être une simple coïncidence.

L'avenir de l'identité à l'ère de l'IA

La meilleure façon d’évaluer une plateforme comme celle-ci ne réside pas dans une réussite ponctuelle, mais dans les clients qui ne remarquent même pas ce qui s’est passé, tout en bénéficiant d’une expérience plus fluide. L’intelligence d’identité élimine les obstacles que les clients honnêtes étaient contraints de surmonter ; un système plus fiable, capable de déterminer plus rapidement à qui il a affaire, les soulage de ce fardeau. 

Ce même principe peut s'appliquer à des données d'entrée plus riches. Aujourd'hui, nos signaux comportementaux reposent encore largement sur des résumés numériques. Mais les modèles LLM et d'IA générative pourraient nous permettre, à l'avenir, d'extraire des informations à partir de textes non structurés, d'images et de conversations spontanées, et ce à des coûts de développement bien inférieurs à ceux d'aujourd'hui. 

Contrairement à la création à partir de zéro de sous-composants de texte et d’image dans les modèles traditionnels de réseaux neuronaux, nous pouvons désormais soit utiliser des points de terminaison genAI prêts à l’emploi, soit exploiter la couche de sortie de grands modèles pré-entraînés pour générer des caractéristiques liées au texte ou à l’image, telles que l’analyse des sentiments dans la description d’un problème ou la vérification des images en double. De plus, nous pouvons explorer des architectures de modèles basées sur les transformateurs afin de créer des représentations d’identité des utilisateurs susceptibles de révolutionner la manière dont nous définissons les clusters dans le graphe d’identité. Dans l’architecture ci-dessus, celles-ci apparaissent sous la forme de deux chemins distincts (figure 1) : un LLM extrayant des caractéristiques directement à partir de requêtes libres, et des représentations textuelles devenant un nouveau type d’arête dans le graphe d’identité. 

Cela dit, les mêmes avancées en matière d’IA qui facilitent la création d’un signal d’identité fiable permettent également d’en falsifier un plus facilement, grâce à un comportement synthétique plus convaincant, à des variations automatisées entre les comptes ou à une réaction hostile plus rapide à nos nouvelles politiques. Considérer l’identité comme une plateforme plutôt que comme un ensemble disparate de contrôles ponctuels permet de rester à la page en offrant un point central où intégrer un nouveau type de signal, au lieu de s’appuyer sur une douzaine de systèmes distincts qui attendent chacun leur tour pour rattraper leur retard.

À terme, notre objectif est de réduire le recours à des solutions d'identité sur mesure et ponctuelles en mettant en place une infrastructure d'identité et de relations cohérente, capable de répondre à tous les besoins en matière de prise de décision.

Restez informé grâce aux mises à jour hebdomadaires hebdomadaires

Abonnez-vous à notre blog d'ingénierie pour obtenir des mises à jour régulières sur tous les projets les plus intéressants sur lesquels notre équipe travaille. projets les plus intéressants sur lesquels notre équipe travaille
Lorsqu'un consommateur demande à Ask DoorDash de «repasser commande de mes produits habituels », la demande semble simple. DoorDash dispose déjà de l'historique de ses commandes ; pourquoi ne pas récupérer les produits qu'il achète le plus souvent et les ajouter à une liste de courses ?

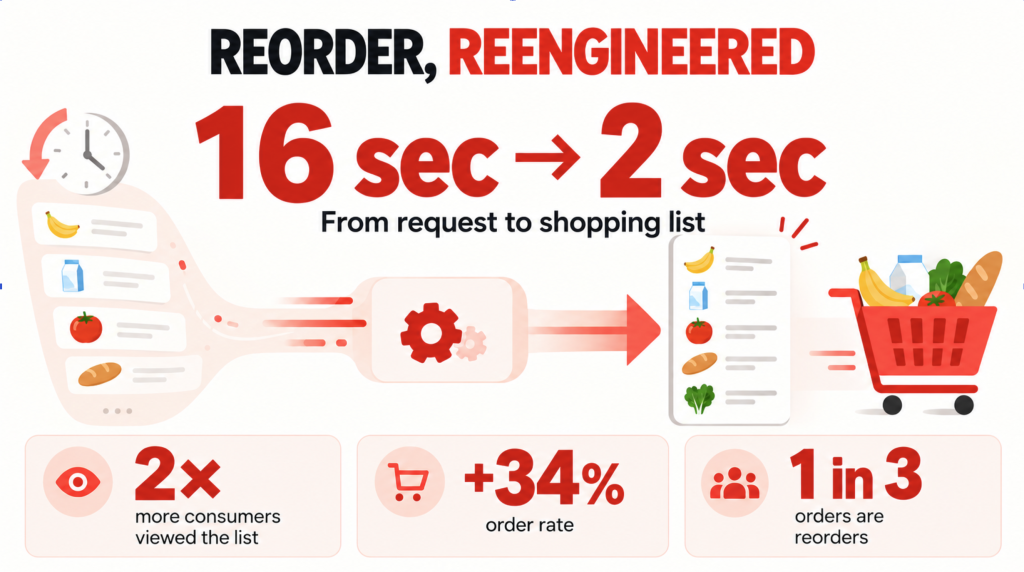
La commande de réapprovisionnement est l'un de nos cas d'utilisation les plus courants, représentant environ une commande sur trois. Or, le parcours agentique initial pouvait prendre plusieurs dizaines de secondes pour générer une liste. En anticipant le raisonnement historique stable avant la requête et en recourant à une exécution déterministe, dans laquelle le produit connaît déjà l'intention du consommateur, nous avons réduit la durée d'un parcours de commande de réapprovisionnement d'environ 16 secondes à environ 2 secondes, et doublé le taux de consultation de la liste générée par les consommateurs. 

Le fait de traiter le raisonnement historique hors ligne a également permis d'assouplir la contrainte de latence liée à la génération, ce qui nous a permis d'utiliser des modèles plus performants pour produire des résultats de meilleure qualité. Cette amélioration s'est traduite par une augmentation d'environ 34 % du taux de commande pour ce flux.

Le défi réside dans le fait qu'accélérer le processus de commande ne peut pas se résumer à simplement repasser en revue l'historique. L'historique des commandes indique ce qu'une personne a acheté, mais pas ce dont elle aura besoin ensuite.

Le lait acheté une fois par semaine correspond sans doute à un besoin récurrent. Un grand paquet de papier essuie-tout acheté à peu près à la même fréquence n'en est peut-être pas un. L'achat de six unités en une seule livraison n'est pas comparable à celui d'une seule unité répartie sur six livraisons. Un yaourt qu'un consommateur achète régulièrement peut être un produit de base ; l'achat de trois parfums, à raison d'un de chaque, relève plutôt de l'expérimentation.

Répondre à la question« acheter mes produits habituels »nécessite donc de faire preuve de discernement en se basant sur le comportement passé. Parallèlement, la réponse finale doit s'appuyer sur un catalogue en constante évolution : les articles sont parfois en rupture de stock, les fiches produits changent, et il se peut que le produit exact qu'un consommateur a acheté précédemment ne soit pas disponible dans le magasin où il fait ses achats aujourd'hui.

Pour une demande de réapprovisionnement classique formulée librement, l’agent Grocery charge la compétence « Réapprovisionnement », récupère le contexte du consommateur et l’historique des commandes nécessaires à la demande, détermine quels achats antérieurs doivent figurer dans le prochain panier, répond à ces besoins en se référant au catalogue actuel, puis établit la liste de courses. Cette flexibilité permet à un même flux de traiter toute une gamme de demandes de réapprovisionnement, tout en mobilisant plusieurs composantes différentes du système Ask DoorDash pour générer une liste de courses en apparence simple.

Les articles précédents de cette série ont abordé tour à tour les thèmes de l'intelligence, de l'évaluation, de la plateforme et de l'expérience utilisateur. Le « réordonnancement » est le processus au cours duquel ces quatre éléments doivent concorder simultanément : la liste doit être personnalisée, vérifiable, rapide et permettre de passer commande. Cet article suit le parcours d'une requête unique à travers chacune de ces étapes.

Le « reorder » va au-delà de la simple rediffusion

La fonctionnalité « Ask DoorDash » prend en charge toute une série de demandes de commande récurrente. Un client peut par exemple taper «Quels produits d'épicerie est-ce que j'achète habituellement ?», «Repasse ma commande habituelle », «Quel lait ai-je acheté la dernière fois ?» ou encore «Repasse ma commande habituelle, mais moins chère».

Ces demandes peuvent sembler similaires, mais elles nécessitent en réalité des décisions différentes. Rechercher un produit figurant dans la dernière commande n’est pas la même chose que déterminer quels achats constituent les habitudes d’un consommateur ; demander des versions moins chères ajoute une nouvelle série de contraintes.

Comme l'explique notre présentation technique, l'architecture multi-agents de DoorDash achemine d'abord une demande d'épicerie vers l'agent « Grocery ». Lorsque la demande concerne une nouvelle commande, l'agent peut activer la compétence « Reorder ».

La compétence « Reorder » fournit à l'agent des instructions spécifiques à chaque tâche pour traiter ces demandes en s'appuyant sur le contexte et les outils à sa disposition. Plutôt que de définir un workflow distinct pour chaque formulation possible, elle propose à l'agent un processus général lui permettant de déterminer ce que la demande implique et de transformer le résultat en une liste d'achats concrète.

D'un point de vue conceptuel, ce processus comporte cinq étapes :

  1. Définir le contexte. Identifier le magasin dans lequel effectuer ses achats lorsque celui-ci n'est pas encore connu, et récupérer des informations pertinentes sur le consommateur.
  2. Récupérer l'historique. Lire l'historique des commandes d'épicerie nécessaire à la requête et le reformater en une représentation sur laquelle le modèle peut raisonner.
  3. Sélectionnez ce qui compte. Déterminez quelles parties de cet historique répondent à la demande du consommateur. Pourles «habitués », cela implique de distinguer les besoins récurrents des achats ponctuels.
  4. Identifier les produits. Effectuer une recherche dans le catalogue DoorDash actuel, en conservant autant que possible les informations telles que la marque, la taille et la variante.
  5. Construisez le résultat. Posez une question de clarification au consommateur lorsqu'il reste un choix véritablement ambigu, puis créez la liste de courses modifiable.

D'autres compétences peuvent s'intégrer à ce processus. Si un client demande « ses produits habituels, mais moins chers », par exemple, la compétence « Reorder » peut déterminer ce dont il a généralement besoin, tandis que le raisonnement sur l'accessibilité financière prend en compte les produits et les prix actuellement disponibles.

Cette flexibilité est essentielle pour un langage libre. Un utilisateur qui saisit une requête dans Ask n'a pas sélectionné une opération API ; il a exprimé une intention, et l'agent doit déterminer quelle tâche cette intention implique.

Chacune de ces cinq étapes repose sur une hypothèse qui n'est pas prise en compte par l'outil. Quel magasin choisir, quelle marque privilégier, si ce consommateur a même envie d'huile d'olive cette semaine… Rien de tout cela ne relève de la commande. Cela relève du consommateur.

Renseignements : ce que l'agent sait déjà à votre sujet 

L'historique des commandes nous indique ce qu'un consommateur a acheté, mais il ne nous dit pas comment interpréter chaque achat. Comme décrit dans l'article « Création d'Ask DoorDash (2e partie) : Intelligence », Ask DoorDash peut intégrer des éléments de contexte tels que les préférences en matière de magasins, les affinités avec certaines marques, les préférences alimentaires et l'état du garde-manger, en puisant dans la mémoire à long terme, la mémoire conversationnelle et la mémoire de session.

Pour les commandes automatiques, ces signaux ne constituent pas une source supplémentaire de produits. Ils permettent d'interpréter l'historique d'achat du consommateur. Si une personne achète systématiquement une marque de lait en particulier, par exemple, cette préférence doit être prise en compte dans la liste générée. Si elle a récemment indiqué à Ask qu'elle avait un stock suffisant d'huile d'olive, cette information peut permettre d'exclure l'huile d'olive de sa prochaine commande automatique, même si celle-ci apparaît fréquemment dans son historique.

C'est important, car les consommateurs savent déjà quels sont leurs «produits habituels». Le moindre écart au niveau du magasin, de la marque ou du contenu de leur garde-manger est immédiatement perceptible et peut rapidement ébranler leur confiance dans le reste de la liste.

L’intelligence offre donc un meilleur point de départ à la fonctionnalité « Reorder », mais elle ne répond pas à la question fondamentale : quels achats figurant dans l’historique du consommateur constituent réellement des besoins récurrents ? Cette décision doit encore être prise — et évaluée de manière cohérente.

Évaluation : vérifier si la liste est correcte

Nous avions besoin d’un moyen d’évaluer la décisionrelative aux « commandes habituelles » avant qu’elle ne parvienne au consommateur. Comme décrit dans « Créer Ask DoorDash (3e partie) : Évaluation », l’évaluation de l’agent porte à la fois sur le chemin d’exécution et sur le résultat. Pour les commandes récurrentes, cela signifie vérifier si l’agent a récupéré le bon contexte et l’historique, s’il a suivi le flux attendu et s’il a généré une liste de courses exploitable — ainsi que si les articles figurant sur cette liste reflètent réellement les besoins récurrents du consommateur.

Ces critères de sélection sont concrets. Si un consommateur commande à plusieurs reprises trois yaourts, la liste tient-elle compte de cette habitude et de cette quantité ? Un produit qui n’est apparu qu’une seule fois reste-t-il exclu de ses «achats habituels »? Si le consommateur a indiqué qu’il avait déjà un produit chez lui, cela se reflète-t-il dans le résultat ?

L'historique des commandes évoluant au fil du temps, nous utilisons le simulateur de conversation basé sur des scénarios pour reproduire des scénarios de renouvellement de commande à partir d'un historique d'achats fixe. Des grilles d'évaluation sous forme de liste de contrôle nous permettent ensuite de tester les articles récurrents, les achats ponctuels, les quantités et les préférences connues en nous référant aux mêmes données de référence à mesure que la mise en œuvre évolue.

Une liste correcte n'est utile que si elle parvient au client pendant qu'il fait encore ses courses. Notre processus initial prenait environ 16 secondes.

Plateforme : Il n'est pas nécessaire de prendre cette décision pendant que vous attendez 

Cette latence s’explique en partie par la manière dont Ask DoorDash traite les requêtes des agents. Comme décrit dans « Building Ask DoorDash (Partie 4) : Une plateforme pour créer et faire évoluer des agents », au cours d’un seul cycle utilisateur, le modèle peut prendre une décision, appeler un outil, analyser le résultat et utiliser ces informations pour déterminer la suite des opérations. Dans un flux type lié à l’épicerie, cela peut nécessiter 6 à 8 appels au LLM ainsi que plusieurs appels à des outils.

Cette flexibilité est importante lorsque chaque étape dépend des informations recueillies au cours de la requête. Cependant, le réordonnancement nous a montré que plusieurs de ces étapes s'appuyaient sur des données historiques qui évoluent lentement.

Les consommateurs reviennent souvent dans un nombre relativement restreint de supermarchés. Au lieu de sélectionner un magasin, de récupérer l'historique de ses commandes et de déterminer les besoins récurrents du consommateur à chaque demande, nous pouvons effectuer ce travail à l'avance en nous appuyant sur les données historiques.

D'autres éléments du processus doivent rester à jour. Les stocks et les prix évoluent, les produits peuvent être en rupture de stock et les fiches produits peuvent changer d'une visite à l'autre.

Cela nous a fourni une limite naturelle : précalculer les magasins susceptibles d’intéresser le consommateur et ses besoins récurrents, puis utiliser le chemin de requête en temps réel pour répondre à ces besoins à partir du catalogue actuel et établir la liste de courses.

Cette distinction a servi de base à notre processus de transition du hors ligne vers le en ligne.

Figure 1 : Ask DoorDash affecte chaque demande de renouvellement de commande à un chemin d’exécution en fonction du domaine auquel elle appartient. Pour la demande « renouveler mon dernier panier », une portée de session typée permet à un plugin backend de récupérer le panier précédent sans recourir au modèle de sélection d’outils. Pour les achats récurrents, un pipeline quotidien combine 90 jours d’historique de commandes avec des signaux de profil pertinents pour la tâche, sélectionne les consommateurs pour lesquels les données sont suffisantes, exécute une inférence LLM par lots et valide le résultat sous la forme d’un ensemble réutilisable de produits habituels. La requête « Renouveler mes produits habituels » lit directement cet ensemble, tandis que « Renouveler mes produits habituels, mais moins chers » le complète avec les prix actuels, les promotions, les tailles d’emballage, les stocks et les contraintes du consommateur. Ces trois voies convergent vers une résolution en temps réel du catalogue, qui tente d’abord l’identifiant d’article du magasin, puis l’identifiant produit du catalogue, et enfin un terme de recherche avant de créer une liste de courses modifiable. L’agent « Grocery » reste disponible pour clarifier les choix ambigus, expliquer les substitutions et remédier aux résultats manquants ou inutilisables.

Génération des commandes habituelles avant même que le consommateur ne les demande. 

Sélection des cohortes et matérialisation des données d'entrée

Tous les historiques de commandes ne contiennent pas suffisamment d'éléments permettant de déduire l'existence de besoins récurrents. Une simple livraison de courses nous indique ce qu'un consommateur a acheté une seule fois, mais ne permet pas de savoir si certains de ces articles font partie de ses produits de base. Appliquer ce processus à l'ensemble des consommateurs entraînerait donc des coûts supplémentaires tout en produisant des résultats peu fiables.

Nous considérons la sélection des cohortes à la fois comme un critère de qualité et comme un mécanisme de maîtrise des coûts. Une tâche Spark quotidienne identifie les consommateurs dont l'activité récente en matière d'achats alimentaires ou de vente au détail est suffisante pour permettre la génération de données.

Pour chaque consommateur sélectionné, nous préparons deux ensembles de données : un profil synthétique reprenant les signaux à long terme les plus pertinents pour la commande, tels que les centres d'intérêt par catégorie de produits et les affinités avec certaines marques, ainsi que l'historique des commandes au niveau des articles pour les 90 derniers jours.

Ces deux éléments ont des fonctions différentes. Le profil fournit des informations contextuelles sur le consommateur ; l'historique des commandes apporte les données concrètes, au niveau des événements, nécessaires pour déduire des besoins récurrents. Une préférence pour une marque peut nous indiquer, par exemple, quel yaourt un consommateur est susceptible de vouloir, tandis que l'historique des achats nous permet de savoir si le yaourt fait partie de ses achats habituels.

Conformément à l’approche de « context trimming » spécifique à la tâche issue de nos travaux sur les modèles de langage de grande envergure (LLM) hors ligne pour la personnalisation en ligne, nous ne transmettons que les signaux de profil pertinents pour cette tâche, plutôt que le profil complet du consommateur. Cela réduit le coût des données d’entrée et évite que des éléments contextuels non pertinents ne viennent concurrencer les données d’achat sur lesquelles repose la décision.

Définir «vos choix habituels »

Une fois que l'on a défini ce qu'est «habituel », établir un classement est un jeu d'enfant. Le plus difficile a été de définir ce terme.

La fréquence constitue un critère de référence raisonnable, mais elle indique ce qu’un consommateur a acheté le plus souvent plutôt que ce dont il est susceptible d’avoir à nouveau besoin. Le lait et un grand paquet de papier essuie-tout peuvent apparaître dans le même nombre de commandes tout en présentant des schémas de réapprovisionnement très différents. Six bouteilles livrées en une seule fois constituent également une indication moins forte d’une habitude récurrente qu’une seule bouteille achetée au cours de six livraisons distinctes. La récence, à elle seule, ne permet pas non plus de lever cette ambiguïté.

Nous utilisons un modèle de langage de grande envergure (LLM) car ces signaux interagissent d’une manière difficile à prendre en compte dans une seule règle de classement. Le modèle suit un ordre qualitatif explicite : la fréquence des livraisons distinctes constitue le principal indicateur d’un besoin récurrent, la récence indique si ce besoin est toujours d’actualité, et les caractéristiques de réapprovisionnement permettent de distinguer les produits à consommation rapide de ceux à longue durée de vie. L’affinité pour une marque peut affiner le choix, mais elle ne l’emporte pas sur les données directes relatives aux achats.

Le stock disponible ajoute une dimension supplémentaire. Un lot de plusieurs unités d'un produit non périssable acheté récemment peut descendre dans la liste, tandis qu'un produit périssable qui figurait régulièrement dans le passé mais qui n'a pas été acheté récemment peut y remonter.

Regrouper la décision en un dossier

Le modèle applique ce raisonnement de manière indépendante pour chaque magasin concerné et renvoie les articles récurrents qu'il identifie. Le nombre maximal d'articles constitue un plafond, et non un objectif : si les données ne permettent d'identifier qu'une poignée d'articles habituels, le modèle renvoie cet ensemble restreint plutôt que de remplir la liste avec des hypothèses moins fiables. Si l'historique ne permet pas de constituer un ensemble pertinent, il peut s'abstenir complètement.

Le résultat est limité aux données issues des données d'entrée. Les identifiants des magasins et des articles doivent provenir de l'historique du consommateur ; les achats récurrents sont privilégiés par rapport aux achats ponctuels, et les variantes quasi-identiques sont regroupées plutôt que de remplir plusieurs emplacements dans le lot. Pour chaque article, nous conservons des indicateurs tels que la fréquence d'achat, la date du dernier achat et la quantité habituelle, afin que le résultat puisse être fourni sans avoir à refaire en ligne le raisonnement basé sur l'historique.

Indiquez le besoin, et non la référence produit

Un article bien classé reste inutilisable si le catalogue change avant que le consommateur ne revienne. L'annonce exacte peut être republiée sous un nouvel identifiant propre au commerçant ou disparaître complètement. Ne conserver que l'identifiant historique de l'article en magasin rendrait l'ensemble fragile ; ne conserver qu'un terme générique tel que « lait d'avoine » ferait perdre la spécificité de ce que le consommateur achète réellement.

Nous représentons donc chaque besoin à trois niveaux : l'identifiant de l'article en magasin pour une correspondance la plus précise possible, un identifiant de produit au niveau du catalogue permettant d'identifier le même produit sous-jacent dans différentes fiches, et un terme de recherche générique en guise de solution de secours. Au moment de la requête, le moteur de recherche les teste dans l'ordre du plus spécifique au plus général et s'arrête sur le premier produit éligible disponible.

Cette hiérarchie reflète clairement la distinction entre le hors ligne et le en ligne. Le modèle hors ligne détermine quels besoins, issus de l'historique du consommateur, méritent d'être pris en compte ; le système en ligne détermine quel produit peut satisfaire ce besoin immédiatement.

Avant la publication d'un bundle, une validation déterministe s'intercale entre la génération du modèle et le contrat de mise à disposition. Elle distingue une abstention explicite d'une sortie mal formée, supprime les identifiants inutilisables, normalise les quantités et filtre les résultats qui ne répondent pas aux exigences d'un bundle utile. Le modèle prend la décision sémantique ; le code déterministe décide si le résultat peut être mis à disposition en toute sécurité.

Production et diffusion à grande échelle

La génération de ces lots pour une vaste cohorte de consommateurs nécessite un système de traitement par lots capable de tolérer des défaillances partielles. Nous utilisons une infrastructure Metaflow segmentée afin que les lots puissent s'exécuter de manière indépendante et que les segments ayant échoué puissent faire l'objet d'une nouvelle tentative sans que le travail déjà effectué avec succès ne soit perdu.

Une fois validés, les paquets ainsi générés sont publiés dans un magasin clé-valeur à faible latence. Le chemin de service peut alors récupérer le paquet d’un consommateur pour un magasin donné sans avoir à répéter le raisonnement historique, tandis que les paquets manquants ou inutilisables entraînent une réponse vide plutôt qu’un échec du tour « Grocery ».

Comme le faisceau est généré indépendamment d'Ask, ce même signal peut également prendre en charge d'autres interfaces personnalisées sans qu'il soit nécessaire de répéter l'inférence.

Le consommateur n'a rien de tout cela sous les yeux. Ce qu'il voit, c'est une liste de courses — et selon la manière dont il est entré dans le processus, il peut la voir apparaître en environ deux secondes.

Expérience utilisateur : une seule liste, plusieurs façons d'y accéder

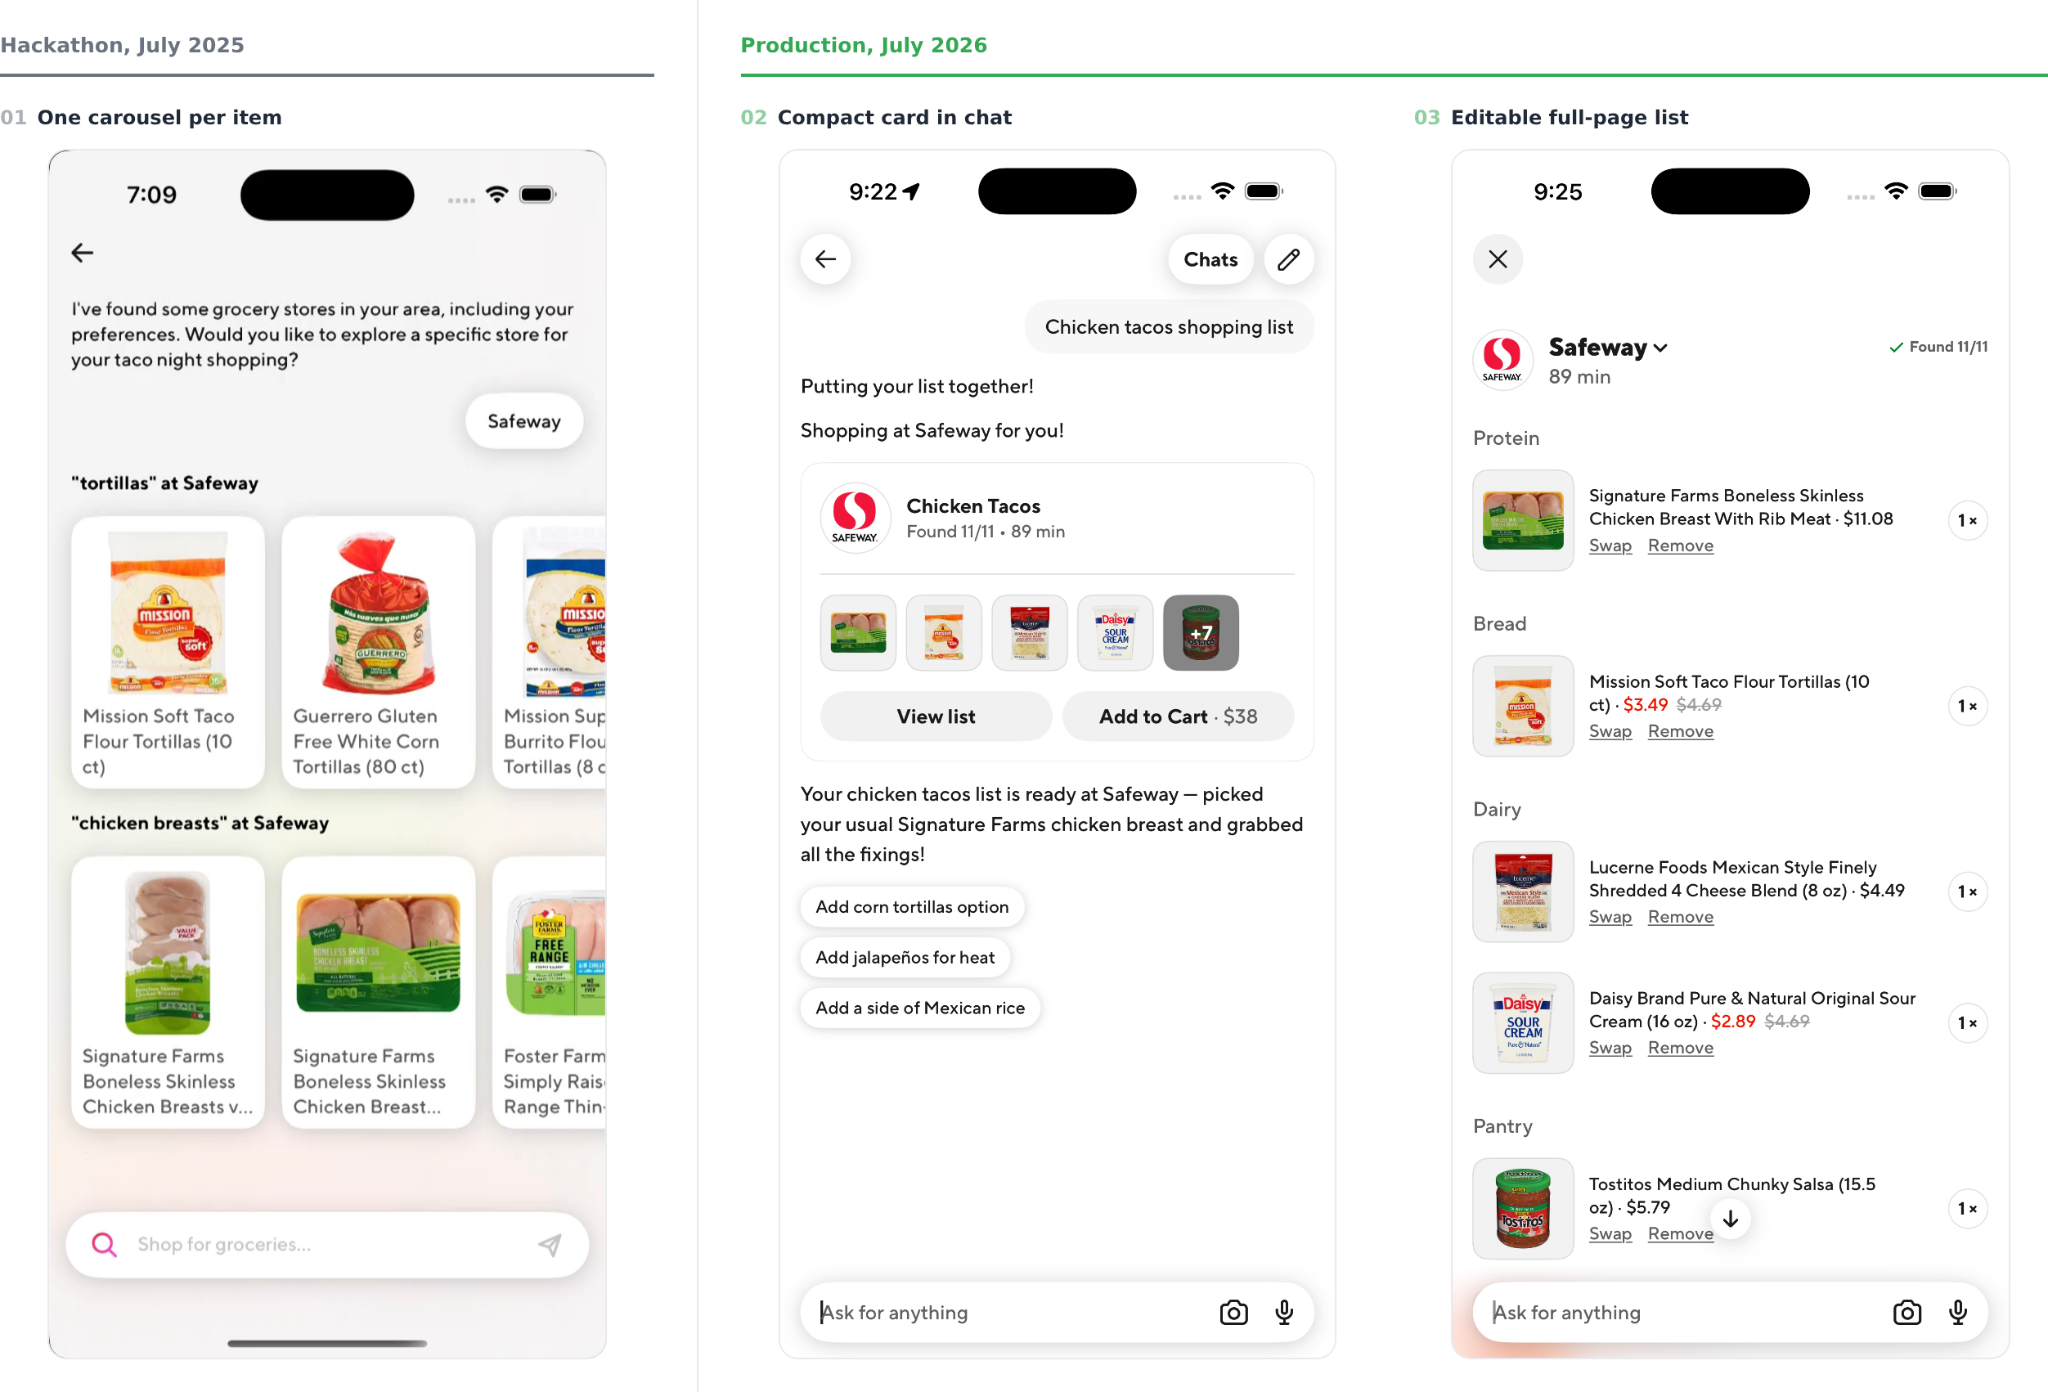
Un consommateur ne passe pas toujours par le même chemin pour passer une nouvelle commande. Il peut taper directement «commander mes plats habituels »dans Ask, ou bien accéder à la fonctionnalité via une interface contextuelle où DoorDash a déjà une idée de ce qu’il cherche à faire.

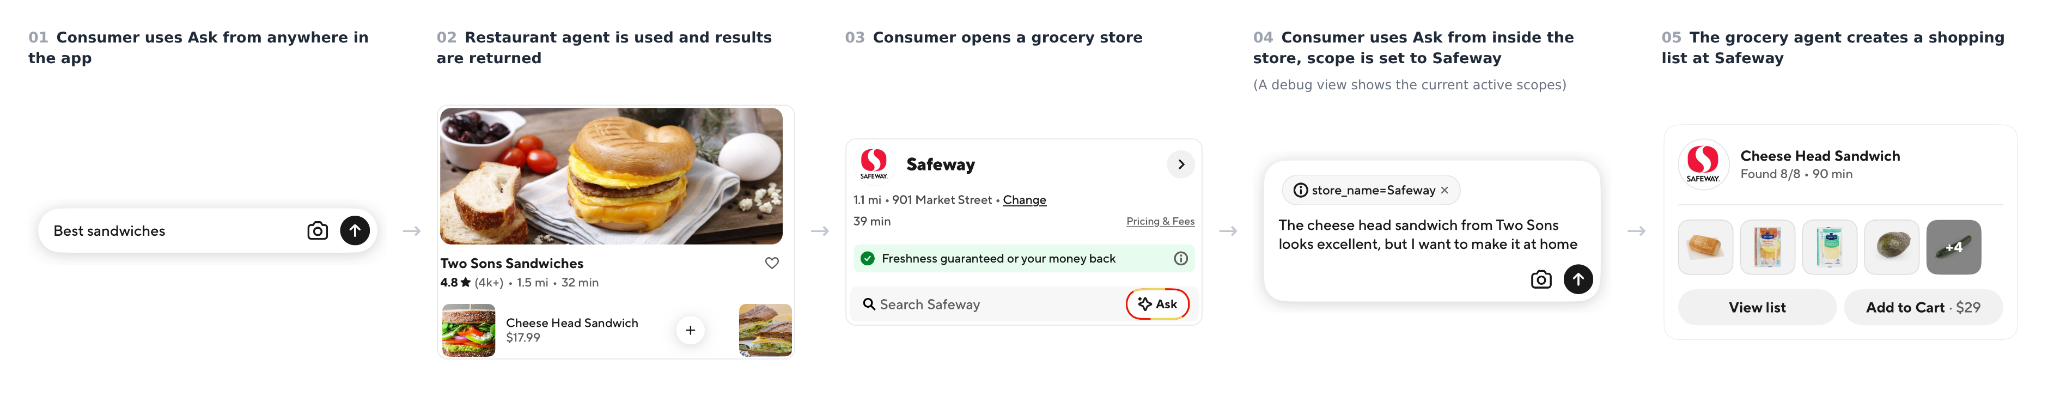
Cette distinction est importante, car le contexte fourni par l’expérience peut alléger la charge de travail dans la conversation. Comme décrit dans l’article « Building Ask DoorDash (Partie 5) : Une interface ancrée pour les agents d’achat », le client associe une portée à une requête, en transmettant des informations telles que le sujet et le magasin depuis lequel le consommateur s’est connecté. Le système peut alors utiliser ce contexte au lieu de demander au consommateur de répéter des informations dont il dispose déjà.

Pour une requête en langage naturel telle que «Renouveler ma commande habituelle », l’agent Grocery interprète toujours la requête via la compétence « Reorder ». Mais lorsqu’un consommateur accède à l’application via une action dédiée «Renouveler ma commande habituelle », l’intention est déjà définie par le produit. Comme illustré ci-dessous, nous associons une portée prédéfinie, invisible pour le consommateur, et acheminons la requête via un chemin déterministe.

Combiné au « bundle » précalculé de la section « Plateforme », cela réduit le travail en temps réel à la récupération du « bundle » et à la résolution de ses éléments par rapport au catalogue actuel. Le parcours n’a plus besoin que le LLM interprète la demande ou reconstitue les habitudes du consommateur à partir de l’historique, ce qui ramène la latence d’environ 16 secondes à environ 2 secondes.

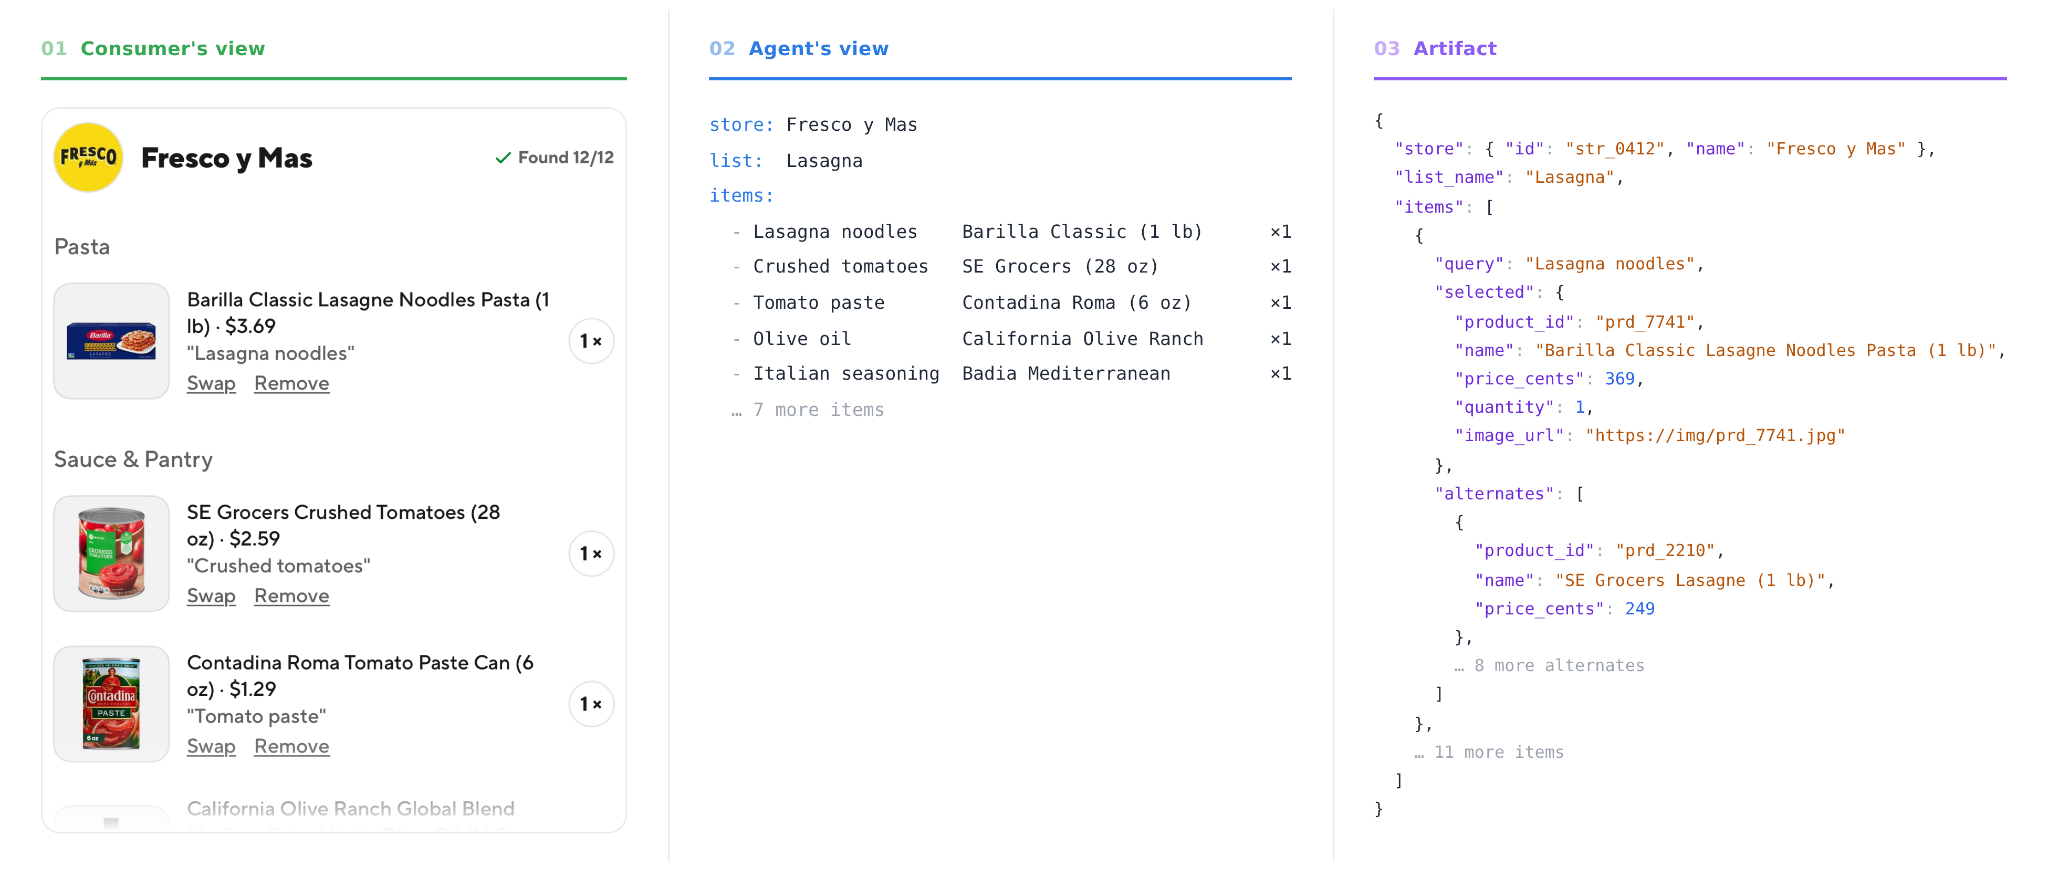
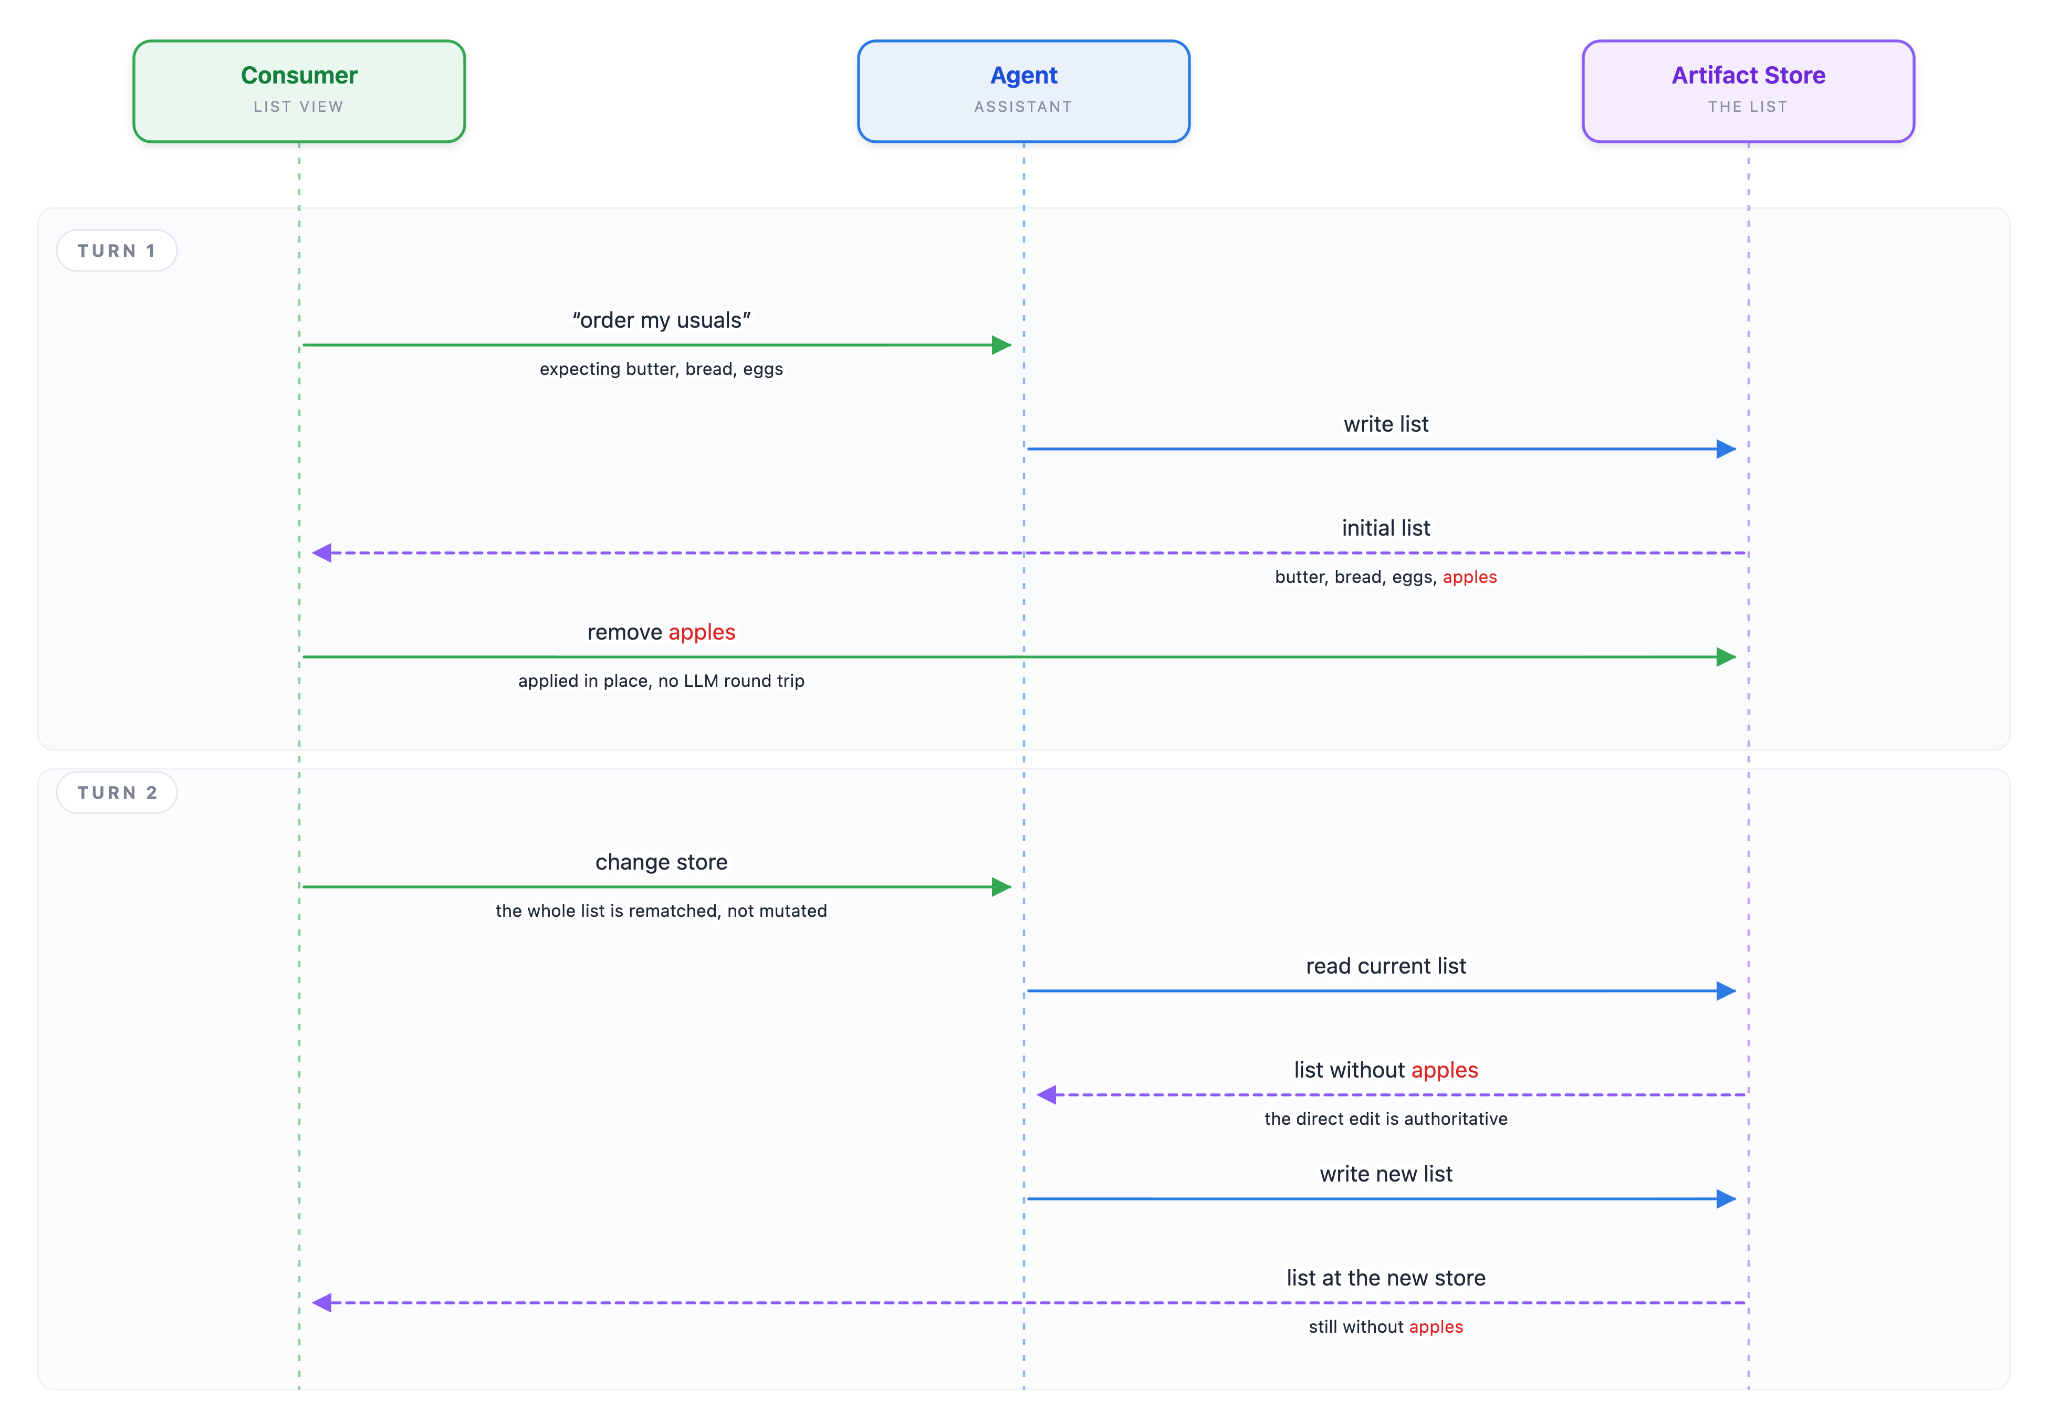
Que le consommateur accède à la fonctionnalité via une saisie libre ou un point d'entrée contextuel, le résultat est le même : une liste de courses structurée. À partir de là, il peut modifier les quantités, supprimer un article qu’il possède déjà, remplacer un produit ou ajouter la liste finalisée à son panier. Ces modifications structurées s’effectuent directement sur la liste, sans nécessiter un nouvel aller-retour avec le LLM.

Le conseiller reste disponible lorsque la demande nécessite davantage de discernement. Un client peut par exemple demander «mes produits habituels, mais moins chers », et le conseiller peut alors partir de ces mêmes besoins récurrents tout en analysant les prix actuels et les alternatives possibles.

Différents points d'entrée peuvent générer des charges de travail très variables en arrière-plan, tout en aboutissant à une expérience de commande en ligne homogène.

Conclusion

« Commander mes produits habituels »semble être une demande simple, mais pour qu’elle soit utile, il faut prendre les bonnes décisions au bon moment. Le contexte du consommateur aide à interpréter l’historique des achats ; les besoins récurrents peuvent être anticipés ; les stocks, les prix et la mise à jour du catalogue sont mis à jour en temps réel ; et les points d’entrée contextuels permettent d’éviter de refaire un travail déjà effectué par le produit.

La leçon générale à en tirer est que l'amélioration d'un agent ne consiste pas toujours à demander au modèle d'en faire davantage. Il s'agit plutôt de déterminer ce qui doit faire l'objet d'un raisonnement au moment de la requête, ce qui peut être connu à l'avance et ce qui doit être déterministe.

Lorsque ces limites sont bien définies, la complexité disparaît pour le consommateur. Il demande à DoorDash de lui proposer à nouveau ses commandes habituelles et obtient une liste qui lui semble personnalisée, à jour et prête à être commandée.

Restez informé grâce aux mises à jour hebdomadaires hebdomadaires

Abonnez-vous à notre blog d'ingénierie pour obtenir des mises à jour régulières sur tous les projets les plus intéressants sur lesquels notre équipe travaille. projets les plus intéressants sur lesquels notre équipe travaille

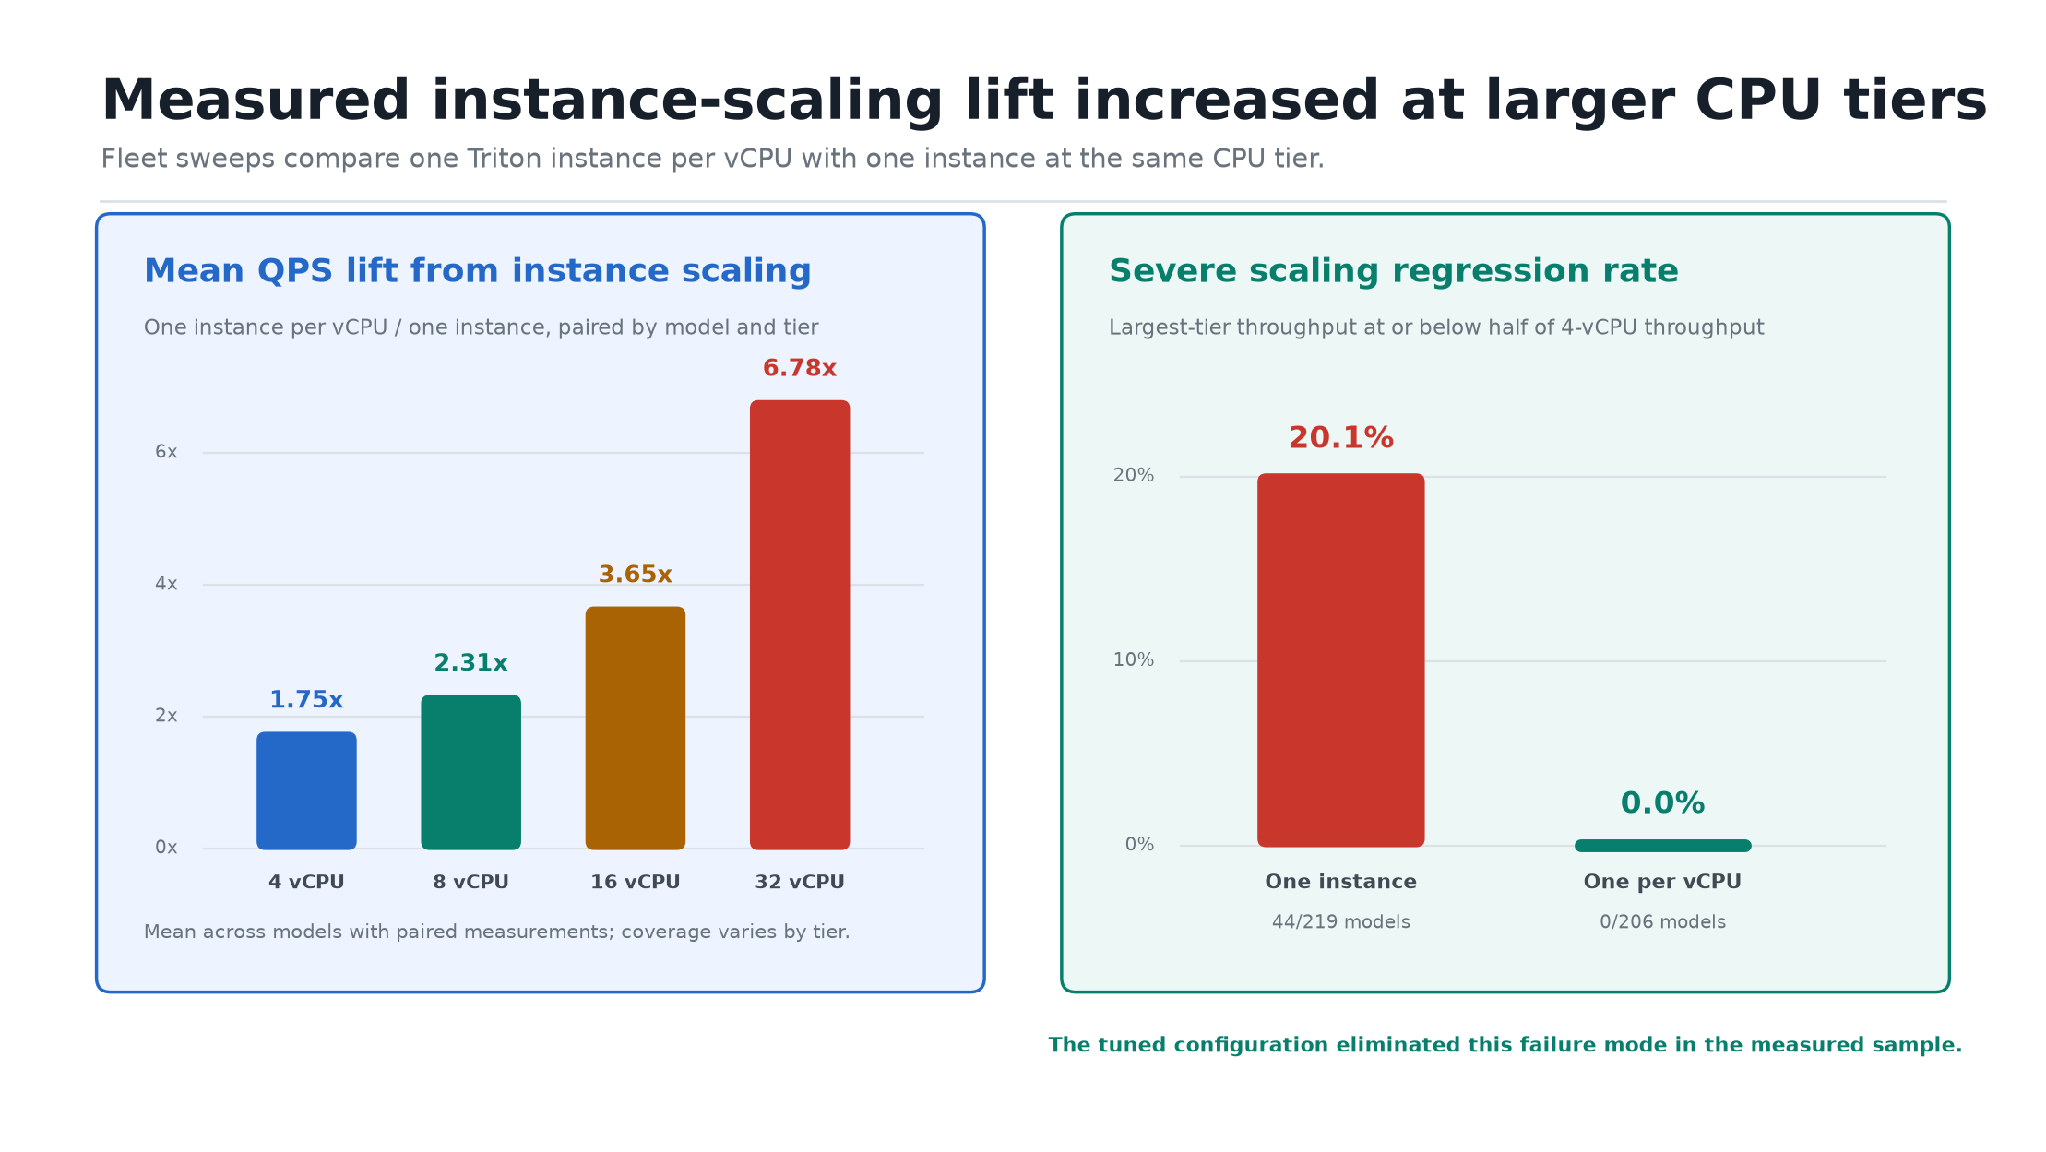
Comment une flotte de référence réutilisable a permis de quantifier la configuration de Triton sur des centaines de modèles de production et de simulation, avec une augmentation moyenne du QPS passant de 1,75 fois avec 4 vCPU à 6,78 fois avec 32 vCPU.

Première partie d'une série en plusieurs volets. Cet article traite des modèles Triton basés sur le processeur (CPU). Un prochain article expliquera comment nous étendons le système à l'inférence sur GPU.

Sur un modèle de production, un même artefact exécuté sur le même pod de 32 vCPU a généré soit 68 QPS, soit 863 QPS, en fonction uniquement de sa configuration de service. Après optimisation, la latence p99 est passée de 126 ms à 14 ms et l'utilisation du processeur est passée de 67 % à 16 %.

1,75 à 6,78 foisaugmentation moyenne du QPS grâce à la mise à l'échelle des instances, par catégorie de processeurDes centainesmodèles de production et modèles fantômes pris en charge20,1 % contre 0 %taux de régression grave : un cas contre un par vCPU252emplacements de pods de référence réutilisables

Quand une puissance de calcul accrue a ralenti certains modèles

Chez DoorDash, les modèles PyTorch s'exécutent sur le serveur d'inférence NVIDIA Triton dans le cadre de différents cas d'utilisation, tels que la recherche, le classement, la répartition des commandes, la lutte contre la fraude et la publicité. Chaque modèle dispose de plusieurs options de déploiement : architecture CPU, taille du pod, nombre d'instances Triton, nombre de threads OpenMP et nombre de requêtes simultanées. Une valeur par défaut raisonnable pour un modèle peut entraîner un gaspillage de capacité ou ne pas respecter les objectifs de latence pour un autre. 

Cette nouvelle analyse a porté sur 264 modèles disposant de données de balayage exploitables. Parmi les modèles présentant des résultats comparables en configuration à instance unique, 44 sur 219 ont vu leur débit par rapport à celui obtenu avec 4 vCPU diminuer de moitié ou plus au niveau de capacité le plus élevé testé. Parmi les 206 modèles présentant des résultats comparables en configuration d’une instance par vCPU, aucun n’a connu cette baisse. 

L'erreur a consisté à considérer la taille du pod comme le principal critère de performance. En réalité, la taille du pod dépend à la fois du nombre d'instances du modèle Triton et du nombre de threads utilisés par chaque instance. Un nombre plus élevé de cœurs peut entraîner davantage de conflits d'accès lorsque ces paramètres ne sont pas coordonnés. 

Quelle configuration complète de serveurs offre le débit et la latence requis tout en minimisant le coût des ressources ?

Répondre à cette question pour un seul modèle constitue un point de référence. Pour y répondre de manière cohérente pour des centaines de modèles, il faut un système. 

Un système de réglage réutilisable

Nous avons développé une plateforme d’optimisation automatique qui compare les artefacts des modèles de production et des données d’entrée représentatives à une matrice de configurations contrôlée, puis sélectionne la configuration la moins coûteuse qui répond aux exigences du modèle en matière de latence et de capacité. 

  1. Orchestration
    Un AutoTuneFlow détermine l'artefact du modèle, les entrées représentatives, le trafic de production, l'objectif de latence et la matrice de configurations candidates. 

  2. de mesure Un ensemble de tests de référence partagé exécute les candidats sur le même environnement d'exécution Triton que celui utilisé en production et enregistre le débit, la latence et l'utilisation du processeur au niveau du cgroup. 
  3. Sélection
    Le flux rejette les candidats qui ne respectent pas les limites de latence ou d'utilisation du processeur, combine les mesures de capacité restantes avec le QPS de production, puis génère des modifications de déploiement. 

Les équipes chargées des modèles n'ont pas besoin de comprendre le fonctionnement du pool de référence, et la couche de mesure n'a pas besoin de connaître le contexte métier qui sous-tend l'objectif de latence d'un modèle. La couche d'orchestration intègre ces différents aspects pour aboutir à une recommandation prête à être mise en production. 

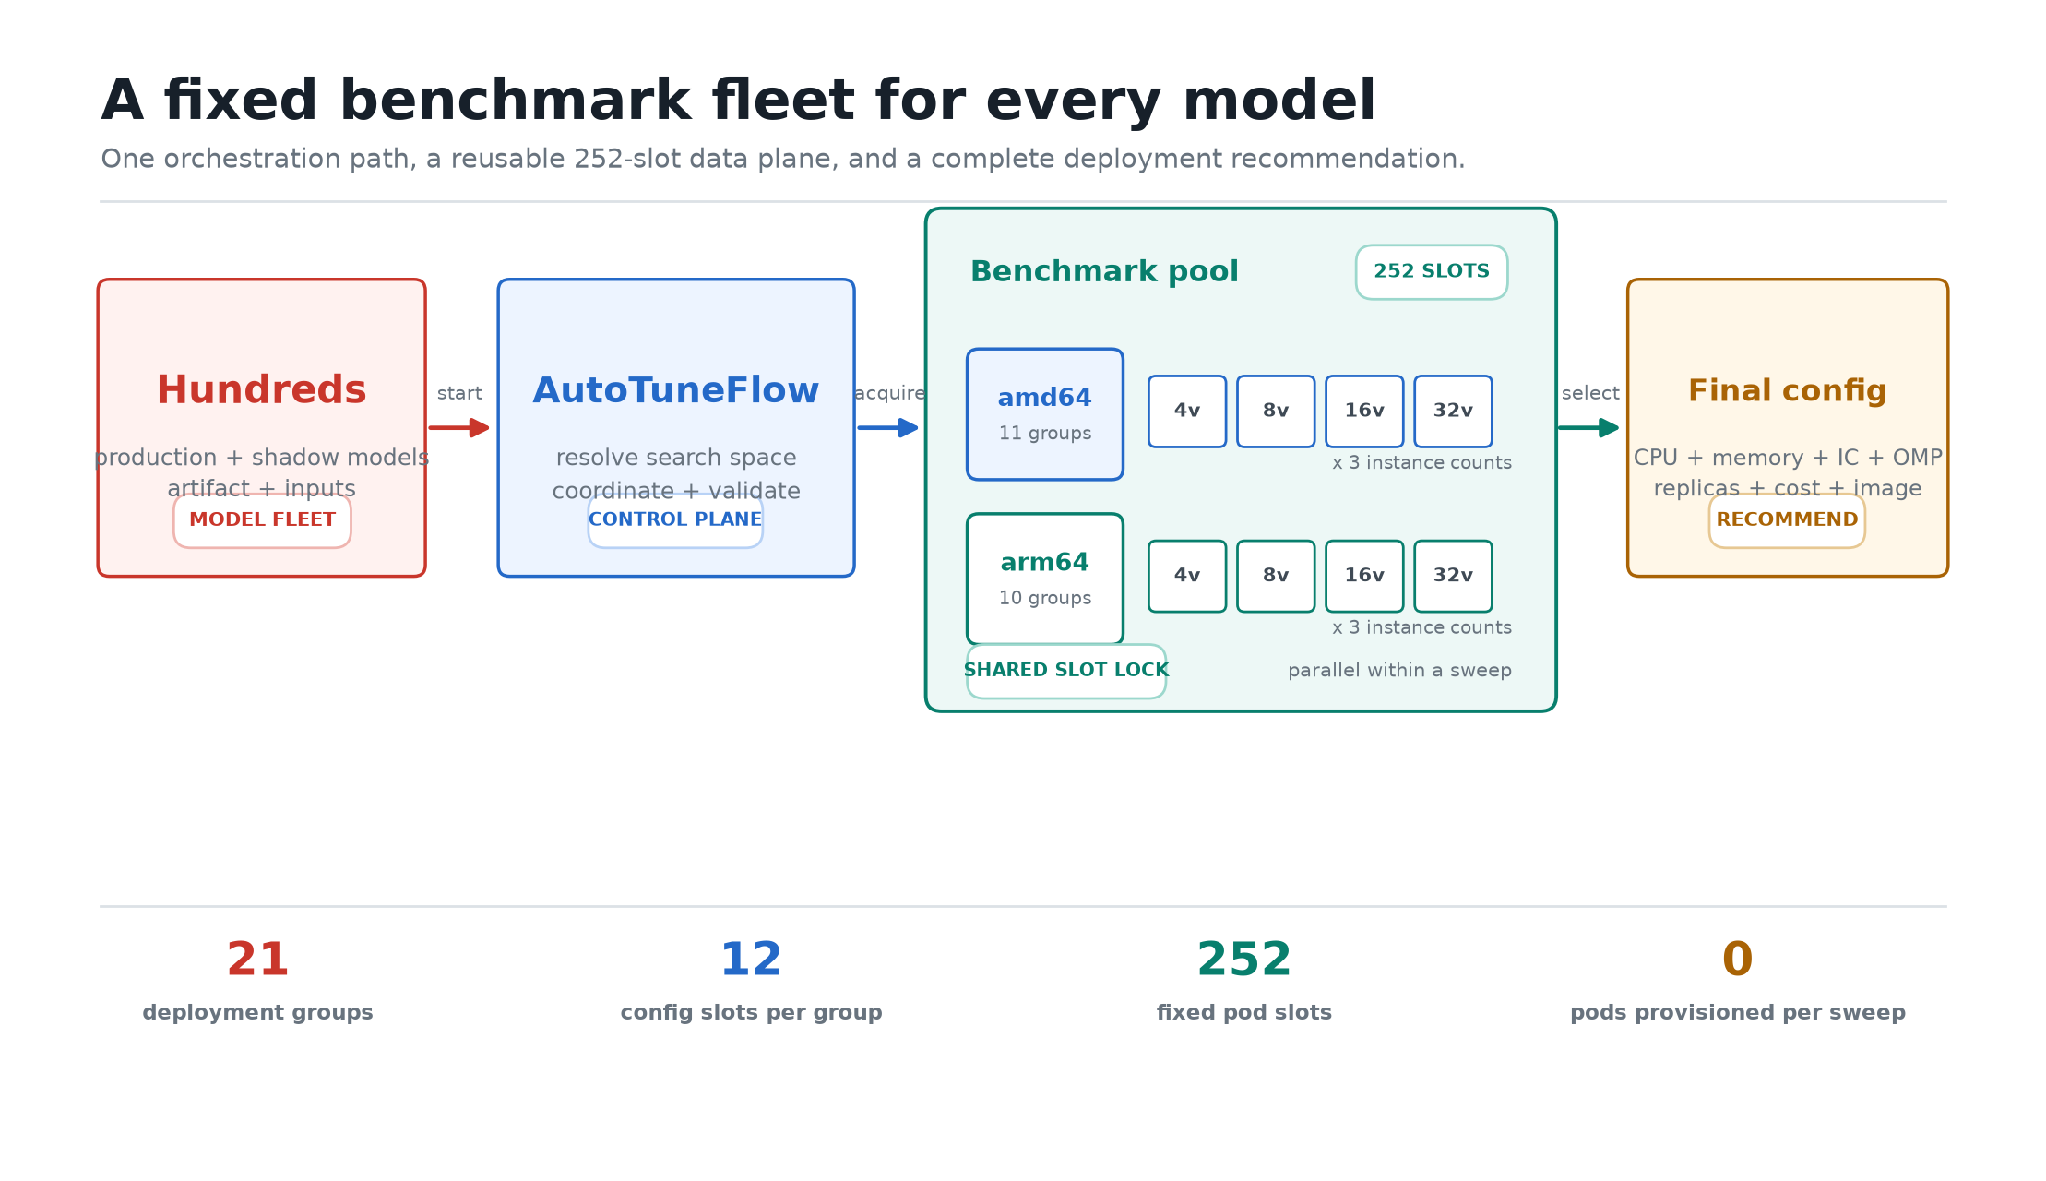
Le plan de données de référence comprend 252 emplacements de pods préconfigurés répartis dans 21 groupes de déploiement sur les architectures amd64 et arm64.

Un pool fixe plutôt qu'une infrastructure spécifique à chaque modèle

Chaque groupe de déploiement contient 12 emplacements dédiés couvrant quatre niveaux de CPU (4, 8, 16 et 32 vCPU) et trois nombres d'instances Triton pour chaque niveau. Un balayage acquiert un groupe disponible et exécute en parallèle les combinaisons de niveaux et de nombres d'instances. Différents modèles peuvent utiliser simultanément différents groupes de déploiement. 

Un verrou basé sur S3 gère les accès. Si un groupe est occupé ou présente un dysfonctionnement, l'orchestrateur bascule vers un autre groupe disponible. Cela nous offre deux types de parallélisme : les candidats s'exécutent simultanément au sein d'un balayage, et plusieurs modèles peuvent être optimisés simultanément au sein de la flotte partagée. 

Le pool fixe de 252 emplacements permet d'optimiser des centaines de modèles de production et de modèles « shadow ». L'augmentation du nombre de modèles accroît le taux d'utilisation de la plateforme, et non l'infrastructure requise pour chaque exécution individuelle. 

Test de performances avec l'outil perf_analyzer de NVIDIA

Chaque pod de benchmark lance l’outil perf_analyzer de NVIDIA via un petit modèle de benchmark s’exécutant parallèlement au modèle cible. perf_analyzer envoie des requêtes gRPC asynchrones via localhost à chaque niveau de concurrence demandé, tandis que le programme d’exécution enregistre le débit et la latence et lit les compteurs CPU du cgroup du pod. Cela permet d’obtenir une mesure cohérente du QPS, de la latence p99 et du même signal CPU que celui détecté par l’HPA de Kubernetes. 

Le programme d'exécution « in-pod » regroupe la génération de trafic, les mesures des modèles et l'utilisation du processeur par cgroup en un seul résultat pour chaque configuration candidate.

Reconfigurer Triton sans redémarrer les pods

Les pods de référence exécutent Triton en mode de contrôle explicite du modèle. Pour chaque candidat, le tuner charge le modèle cible via l'API de contrôle de modèle de Triton et transmet le ModelConfig du candidat en tant que paramètre de remplacement. Il peut ensuite décharger le modèle et réutiliser le pod pour le balayage suivant. 

Ce cycle de vie évite une modification S3, un délai d'interrogation du référentiel ou un redémarrage du pod pour chaque candidat. Une seule mesure suit la même séquence : 

  1. Constituer un groupe de référence.
  2. Chargez le programme d'exécution du test de performance et le modèle cible.
  3. Vérifier la validité des données d'entrée et préchauffer le modèle.
  4. Exécutez perf_analyzer pour différents niveaux de concurrence.
  5. Enregistrer les mesures de QPS, de latence et d'utilisation du processeur.
  6. Déchargez le modèle et libérez le groupe.
Chaque niveau et chaque emplacement de nombre d'instances suivent ce cycle de vie en parallèle. Les résultats sont renvoyés vers le même flux pour la configuration et la sélection des coûts.

Le nombre exact de mesures dépend des architectures de processeur, des niveaux de service, du nombre d'instances, de la taille des lots et des niveaux de concurrence demandés. Étant donné que les combinaisons les plus coûteuses en termes de niveau de service et de nombre d'instances s'exécutent en parallèle, l'élargissement de la matrice de recherche ne se traduit pas directement par une augmentation du temps réel. 

Pourquoi la configuration a-t-elle autant influencé les performances ?

L'inférence CPU de PyTorch offre deux formes de parallélisme. Triton peut exécuter plusieurs copies d'un modèle en parallèle, tandis que chaque copie peut utiliser plusieurs threads OpenMP au cours d'une inférence. Ces paramètres sont utiles pris individuellement, mais ils doivent être réglés conjointement. 

La configuration par défaut d'un pod à N cœurs consiste souvent en une seule instance Triton utilisant N threads. Pour bon nombre de nos modèles, une meilleure configuration consistait à utiliser N instances à thread unique : 

instance_group.count = vCPU
OMP_NUM_THREADS = 1
OMP_DYNAMIC = FALSE
INTRA_OP_THREAD_COUNT = 1

Cela permet de transformer un seul worker d'inférence hautement multithreadé en plusieurs workers indépendants. Cela évite également le pire scénario, dans lequel plusieurs instances de Triton créeraient chacune un pool de threads complet et se disputeraient les mêmes cœurs. 

Le tuner considère donc le nombre d'instances et le nombre de threads comme un seul et même paramètre de configuration. En général, il conserve : 

instance_group.count × OMP_NUM_THREADS ≈ vCPU

Le choix entre un plus grand nombre d'instances et un plus grand nombre de threads dépend toujours du modèle ; c'est pourquoi nous procédons à des mesures plutôt que de définir une réponse unique valable pour l'ensemble de la flotte. 

ConfigurationQPSlatence p99Processeur
1 instance, 32 threads68126 ms67%
32 instances, 1 thread chacune86314 ms16%

Dans le cadre de cette nouvelle analyse, la comparaison entre une instance Triton par vCPU et une instance unique du même niveau a permis d’observer des augmentations moyennes du QPS brut de 1,75 fois pour 4 vCPU, 2,31 fois pour 8 vCPU, 3,65 fois pour 16 vCPU et 6,78 fois pour 32 vCPU. L’artefact du modèle et le niveau matériel sont restés inchangés ; seule la configuration de service a été modifiée. 

Le gain de performance mesuré augmentait avec la taille du pod. Des baisses importantes de débit ont été observées dans 44 des 219 résultats comparables obtenus avec une seule instance, contre aucune parmi les 206 résultats obtenus avec une instance par vCPU.

La documentation de PyTorch sur le multithreading CPU décrit plus en détail l'interaction entre le parallélisme inter-op et intra-op. 

Ce que nous avons appris à l'échelle de la flotte

Laissons le « Sweep » choisir le niveau de processeur

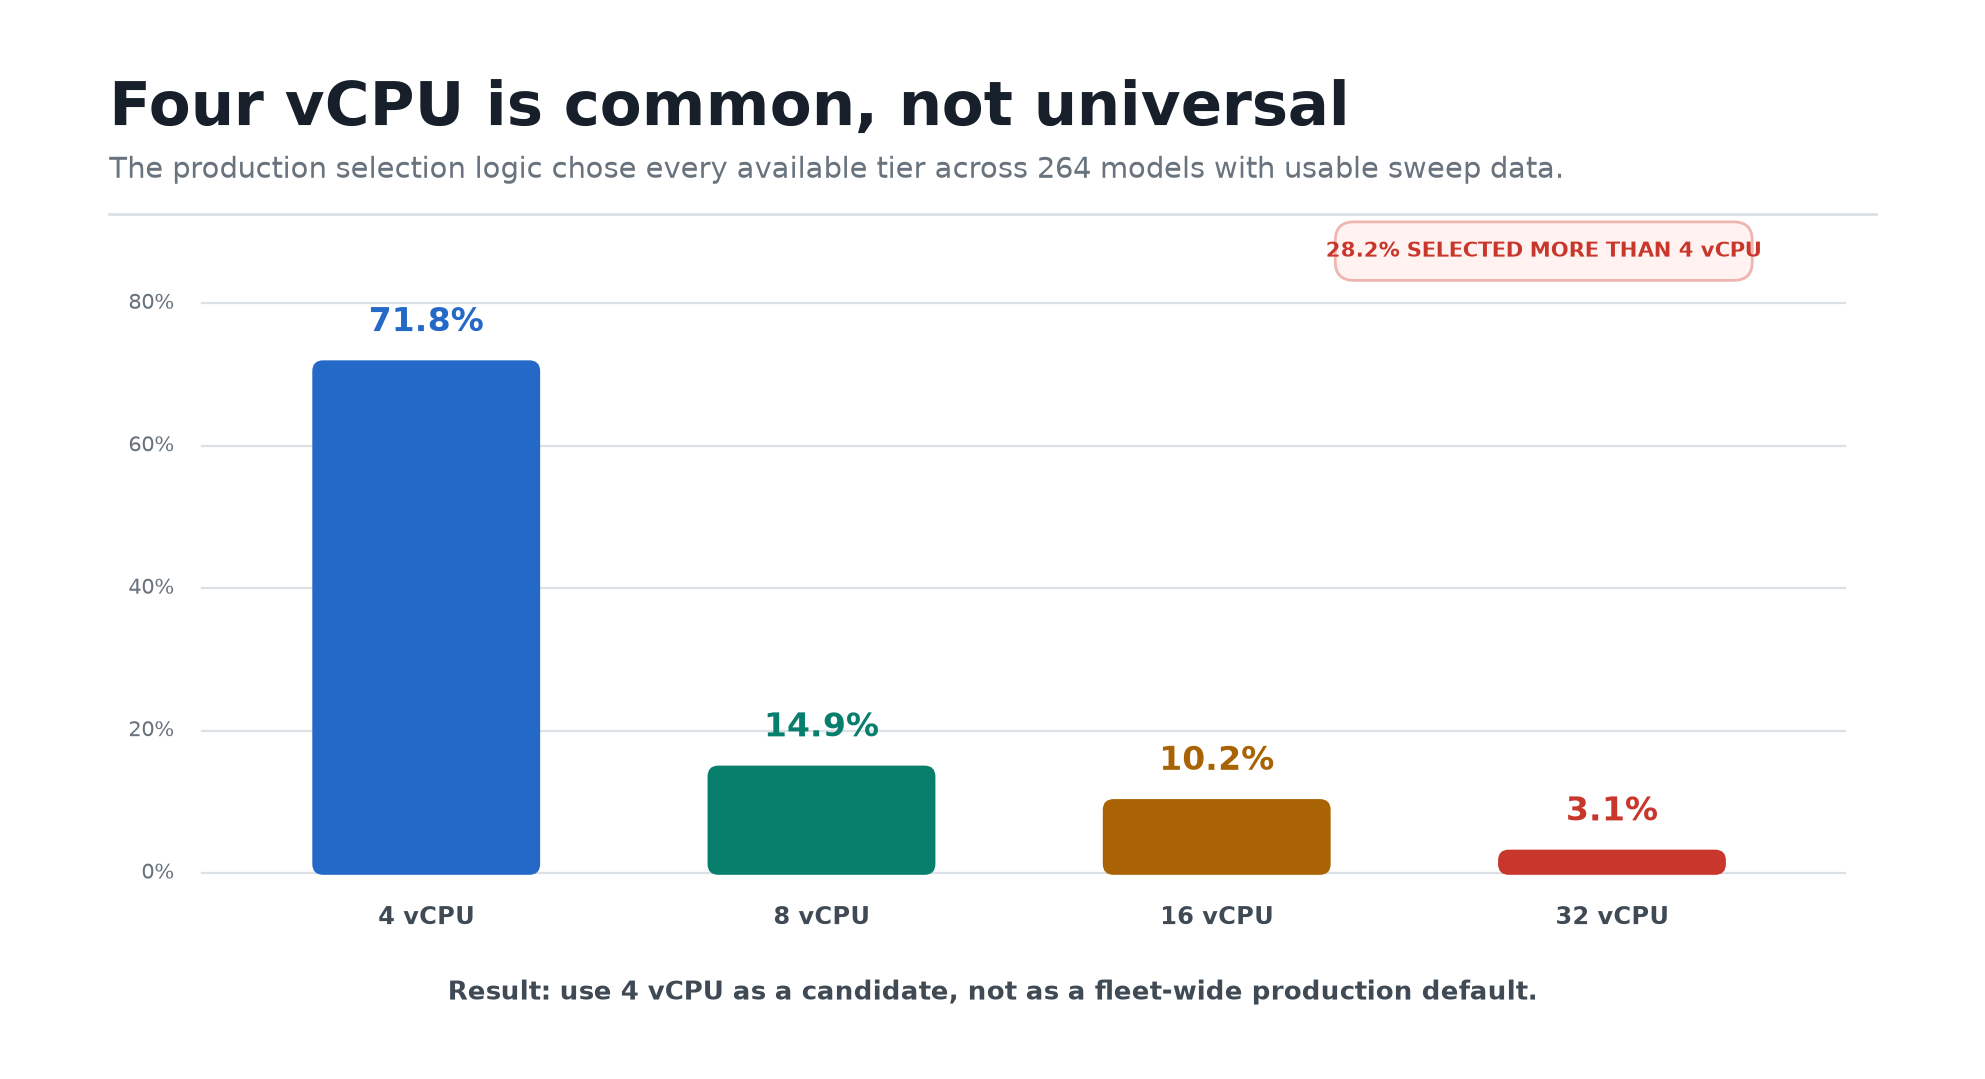
L'analyse actualisée portant sur 264 modèles a révélé que la configuration à 4 vCPU était la plus courante (71,8 %), suivie de celle à 8 vCPU (14,9 %), à 16 vCPU (10,2 %) et à 32 vCPU (3,1 %). Les niveaux de capacité supérieurs ont été retenus pour 28,2 % des modèles. 

Chaque niveau de puissance de calcul disponible s'est avéré optimal pour au moins certains modèles.

Quatre vCPU constituent une option de départ utile, mais ne constituent pas une valeur par défaut pour la production. L'outil d'optimisation évalue les niveaux disponibles et sélectionne celui qui offre la meilleure capacité en termes de rapport coût-performance tout en respectant l'objectif de latence du modèle. 

Le CPU à lui seul ne permet pas toujours d'évaluer la saturation

L'HPA de Kubernetes estime généralement la capacité en ajustant le débit observé proportionnellement à l'utilisation du processeur : 

QPS prévu = QPS actuel × (CPU cible / CPU mesuré)

Cela fonctionne lorsque le processeur est la ressource limitante. Cela ne fonctionne plus dès que le débit atteint un plateau. Lors d'un test avec 8 vCPU, l'utilisation du processeur s'est stabilisée à 26 % ; un objectif HPA de 40 % impliquait donc une capacité de 1 252 QPS. Le modèle a atteint sa saturation à 829 QPS, soit une surestimation de 1,5 fois. 

Triton fournit des signaux relatifs aux files d'attente, tels que `nv_inference_pending_request_count` et la durée d'attente, qui décrivent plus directement la saturation. Nous nous orientons vers un signal d'auto-scaling qui combine l'utilisation du processeur et la charge des files d'attente. 

Des résultats des tests de performance à la configuration de production

L'outil d'optimisation ne se contente pas de classer les lignes des tests de performance. Il combine la capacité mesurée par pod avec la plage de QPS en production du modèle, calcule les besoins en répliques et le coût prévisionnel, valide la modification proposée et génère les règles de déploiement utilisées par le workflow de mise en production. 

  • Architecture du processeur et niveau de vCPU
  • Allocation de mémoire
  • Nombre d'instances Triton
  • Paramètres des threads OpenMP
  • QPS prévu et latence p99
  • Nombre minimal et maximal de répliques
  • Image de service
  • Coût prévisionnel

Cela permet de combler l'écart entre un benchmark et une configuration de production opérationnelle. Cela rend également la recommandation reproductible : les mesures, la configuration choisie et les données relatives aux coûts sont enregistrées ensemble, au lieu d'être consignées uniquement dans le carnet de notes d'un ingénieur. 

Accompagnement des migrations de plateformes et formation continue

Le tuner prend désormais en charge deux workflows récurrents liés à la plateforme. Lors des migrations de plateforme, il attribue à chaque modèle une configuration adaptée à l'environnement de déploiement cible, au lieu de reprendre les hypothèses de la plateforme précédente. Cette même intégration permet aux workflows d'apprentissage continu de réévaluer les nouveaux artefacts du modèle au fur et à mesure de leur production, afin que les paramètres de déploiement puissent évoluer en même temps que le modèle. 

Ces deux workflows utilisent le pool de tests de performance partagé et la même logique de sélection. Cela permet d'assurer une validation cohérente des performances lors de la migration et du réentraînement, sans que les équipes chargées des modèles aient à mettre en place une infrastructure de tests de performance distincte. 

La leçon à retenir

La configuration des services influe sur les performances du modèle. Le réentraînement et l'optimisation du code sont importants, mais aucun des deux n'est indispensable pour récupérer la capacité perdue en raison des paramètres par défaut d'exécution. 

À l'échelle d'une flotte, ce qui importe, ce n'est pas une règle isolée telle que « utiliser des pods à 4 vCPU » ou « régler OpenMP sur 1 ». Il s'agit plutôt d'un système reproductible capable de tester ces hypothèses pour chaque modèle, dans des conditions cohérentes, et de transformer le résultat en une configuration prête à être déployée. 

Pour notre parc, ce système a permis d’observer des gains moyens en termes de QPS compris entre 1,75x et 6,78x selon les niveaux de CPU, a démontré pourquoi le niveau de CPU devait être évalué au cas par cas pour chaque modèle, et a remplacé le dimensionnement manuel par une procédure d’optimisation commune applicable à des centaines de modèles. Le pool de tests de performance est resté inchangé malgré l’augmentation du nombre de modèles qui l’utilisaient. 

Et ensuite ?

Ce premier article était consacré aux modèles Triton s'appuyant sur un processeur (CPU). Dans le prochain volet, nous expliquerons comment nous étendons ce même workflow d'optimisation automatique aux modèles s'appuyant sur un processeur graphique (GPU), notamment en abordant l'espace de configuration du GPU, les signaux de capacité spécifiques à l'accélérateur et les modifications nécessaires au niveau de la couche de mesure. Les couches d'orchestration et de sélection restent réutilisables, offrant ainsi aux modèles GPU le même parcours reproductible, depuis l'artefact du modèle jusqu'à la configuration de production validée. 

Remerciements

  • Plateforme de service ML Arvind Kalyan, Kyoungah Kim, Haifeng Geng, Emmanuel Khayat, Jeffery Ni, Songze Li, Teer Ying, Feijin Deng, Zhe Liu, Zhengyang Wang
  • Équipe Ads ML : Utsaw Kumar, Kin Sum Liu, Benjamin Yang, Praveen Gondhi

Restez informé grâce aux mises à jour hebdomadaires hebdomadaires

Abonnez-vous à notre blog d'ingénierie pour obtenir des mises à jour régulières sur tous les projets les plus intéressants sur lesquels notre équipe travaille. projets les plus intéressants sur lesquels notre équipe travaille
L'équipe Data de DoorDash est chargée de fournir des analyses précises et d'apporter des réponses aux questions stratégiques clés de l'entreprise : 

  • Pourquoi le volume des commandes a-t-il baissé en Californie la semaine dernière ? 
  • Comment se vend ce nouveau produit depuis son lancement ? 
  • Quels sont les commerçants susceptibles de se détourner de nos produits marketing ?
  • Affiche-moi les commandes annulées par heure au cours des 90 derniers jours chez Arby’s

Les modèles agentiques de pointe, associés à des plateformes d’agents telles que Codex et Claude Code (CC), constituent des outils puissants pour interagir avec nos données et répondre à ce type de questions. Cependant, leurs performances sont souvent en deçà de l’optimum lorsqu’ils sont confrontés aux vastes volumes de données semi-structurées courants dans les grandes entreprises. Il est difficile de garantir que toutes les fonctions métier — notamment les opérations, l’ingénierie, le marketing et le produit — aient accès à des données à jour et exactes, à partir desquelles elles puissent tirer les bonnes conclusions.

« Le problème, en réalité, c’est que nos sources de données en amont sont extrêmement fragmentées », a fait remarquer un responsable senior de l’analyse en examinant nos anciens outils. Ces outils étaient soit très spécialisés dans un domaine précis, soit très généraux mais peu approfondis. 

C’est pourquoi nous avons développé Vera, un agent conversationnel interne dédié aux données. Nous avons constaté que la conception et le réglage de toutes les étapes du pipeline — formulation des requêtes, classement et extraction des données, ainsi que les compétences spécifiques au domaine — ont permis d’améliorer considérablement les performances par rapport aux agents standard dotés de simples connecteurs de données. « Cela a bien fonctionné pour les questions financières stratégiques, quel que soit leur niveau de difficulté. J’ai été très impressionné », a déclaré un directeur financier après plusieurs semaines de test de Vera.

Pourquoi nous avons développé cette solution en interne

Les agents contemporains sont généralement capables de répondre à des questions relatives aux données dans un environnement épuré. Cependant, une couche de données sémantique solide est essentielle pour garantir que ces agents fournissent des réponses fiables auxquelles l'entreprise peut se fier. Lever les ambiguïtés et résoudre les conflits de sens sémantique à l'échelle de l'organisation n'est pas une mince affaire ; développer cette couche de données tout en préservant la précision constitue un défi urgent. 

Selon nous, la clé pour développer Vera à grande échelle consiste à permettre aux responsables de domaine — c’est-à-dire les personnes les plus proches des données — de contribuer à l’élaboration des évaluations et de les valider. Un responsable de domaine est l’expert en la matière chargé de définir les critères de mesure d’un domaine d’activité. Il est plus facile de mettre en place cette boucle de retour d’information étroite lorsque nous exerçons un contrôle total sur la pile technologique. 

Dans cet article, nous passons en revue la conception globale de Vera ainsi que ses mesures de performances, en abordant les choix architecturaux et en présentant des études comparatives entre différents types de modèles et différentes approches de raisonnement.

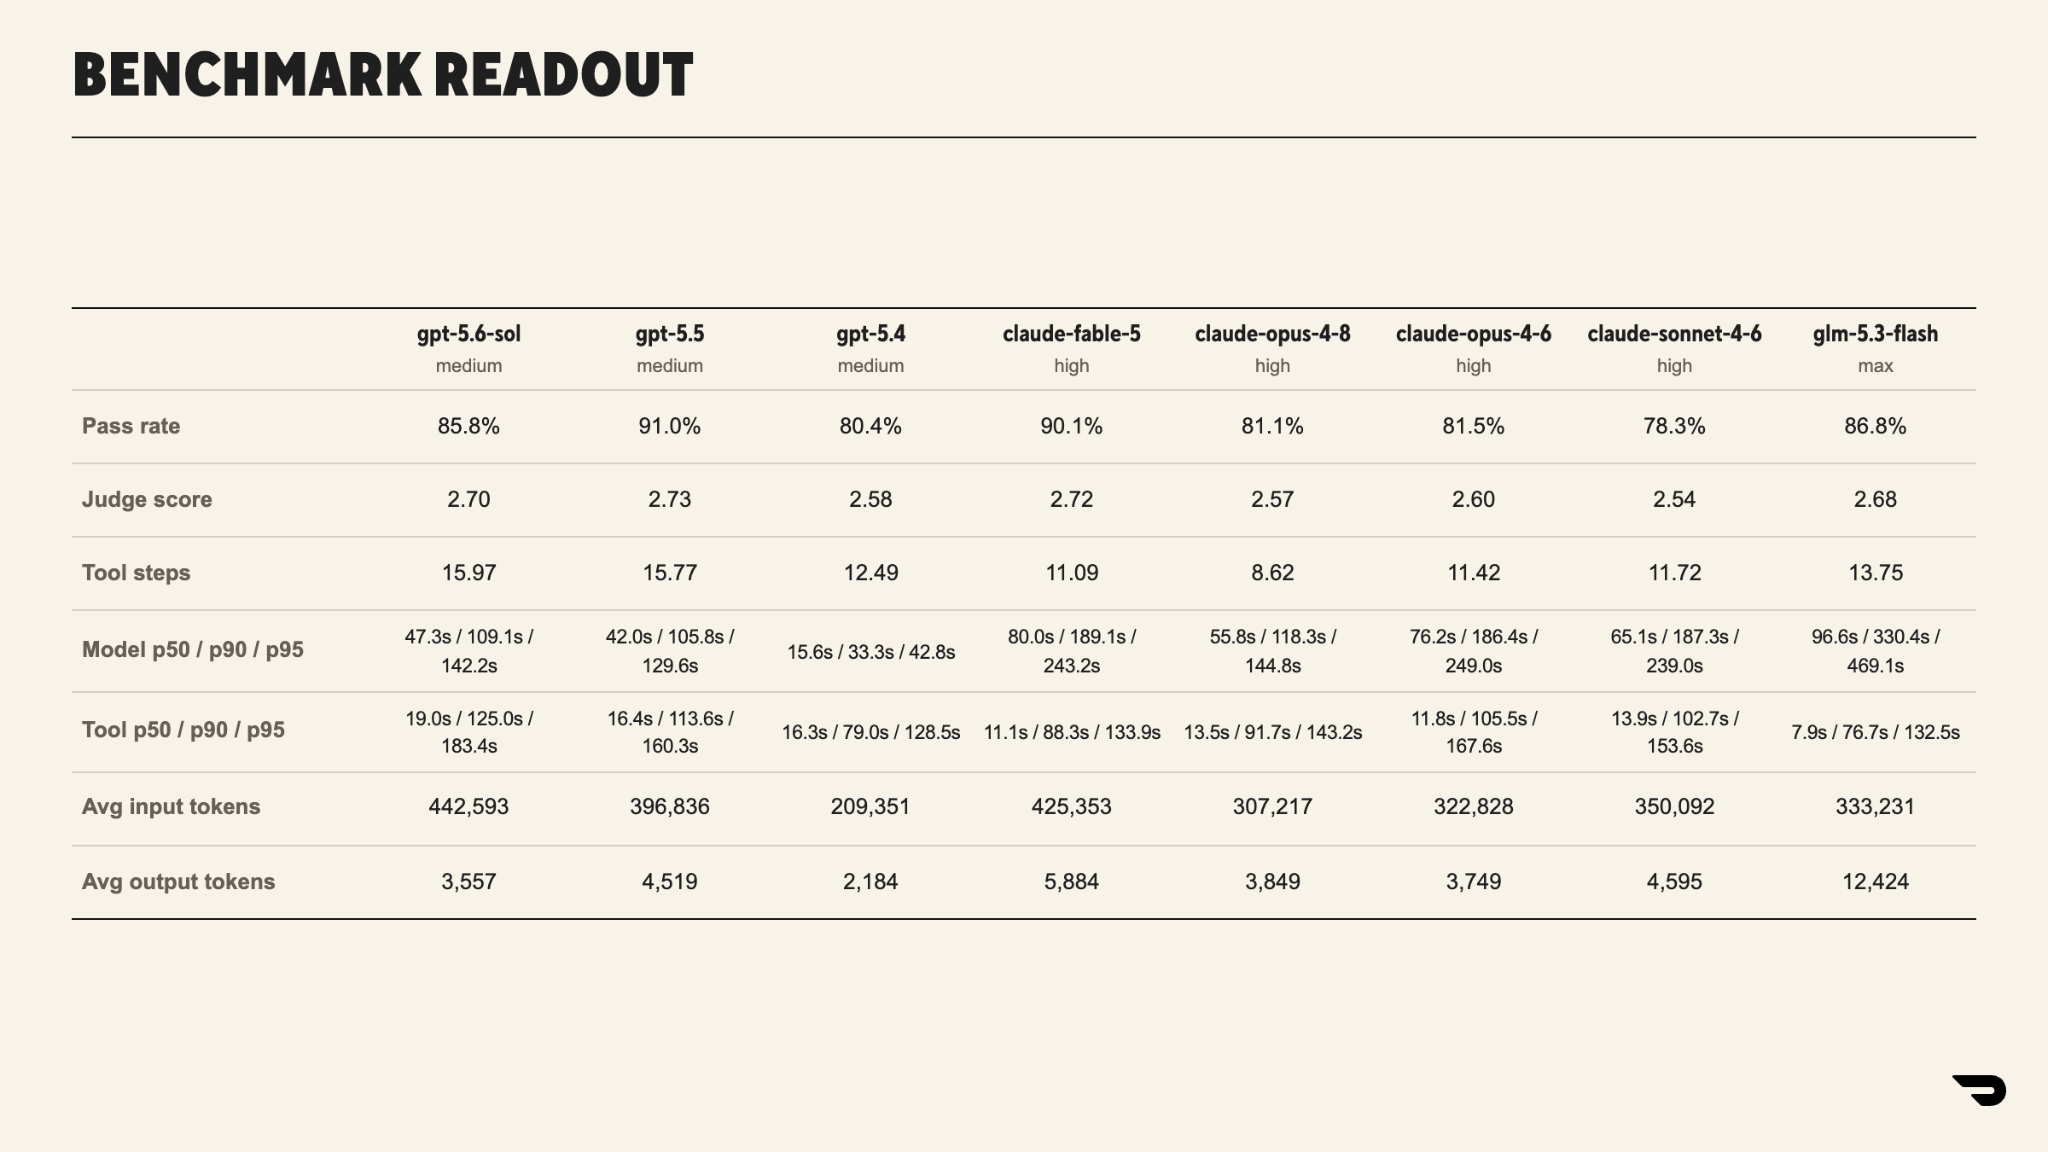
Tableau 1 : Une seule exécution complète du benchmark, tous les modèles intégrés dans le même harnais. Les modèles de la frontière se situent à quelques points les uns des autres en termes de score ; ce sont donc la latence, le nombre d’étapes et le nombre de tokens qui les distinguent.

Notre ensemble de données d'évaluation couvre 19 domaines verticaux dans les secteurs des ventes, de la finance, des produits et des opérations chez DoorDash, avec plus de 1 900 évaluations fournies. Celles-ci présentent des niveaux de complexité variés, certaines questions nécessitant de nombreux appels à des outils et un raisonnement approfondi. 

Le modèle de production actuel – GPT 5.5 – obtient le meilleur score global lors du test de performance. Cela n’a rien de surprenant, car nous avons optimisé les prompts et les compétences spécifiquement pour ce modèle, et nous comptons bientôt reproduire cette optimisation à l’ensemble des familles de modèles.  

Les réponses finales sont notées par un juge LLM selon trois critères : l’utilisation des outils, le choix des tables et l’exactitude globale de la réponse. Lorsque les évaluations ne comportent pas de requête SQL sans ambiguïté, des experts du domaine fournissent des grilles d’évaluation détaillées. La note maximale dans ce cadre est de 3,0 ; comme le montre le tableau 1, les modèles de pointe d’Anthropic et d’OpenAI se situent à quelques points les uns des autres.

Nous indiquons également les appels d'outils et les taux de réussite. Les modèles générant eux-mêmes leur code SQL, une exécution complète déclenche de nombreuses requêtes lourdes en parallèle. Certaines d'entre elles atteignent le délai d'expiration de la base de données, ce qui est considéré comme un échec dans le calcul du taux de réussite, et non comme une réponse erronée.  

L'écart d'une exécution à l'autre de l'indice de référence est d'environ quatre points de pourcentage du taux de réussite, quel que soit le modèle ; les différences inférieures à cette valeur sont considérées comme du bruit. Un contributeur veille à ce que les évaluations elles-mêmes restent à jour. Une évaluation qui spécifie une fenêtre temporelle relative — par exemple, « Quel était le débit de commandes de ce magasin la semaine dernière ? » — perd rapidement de sa pertinence.

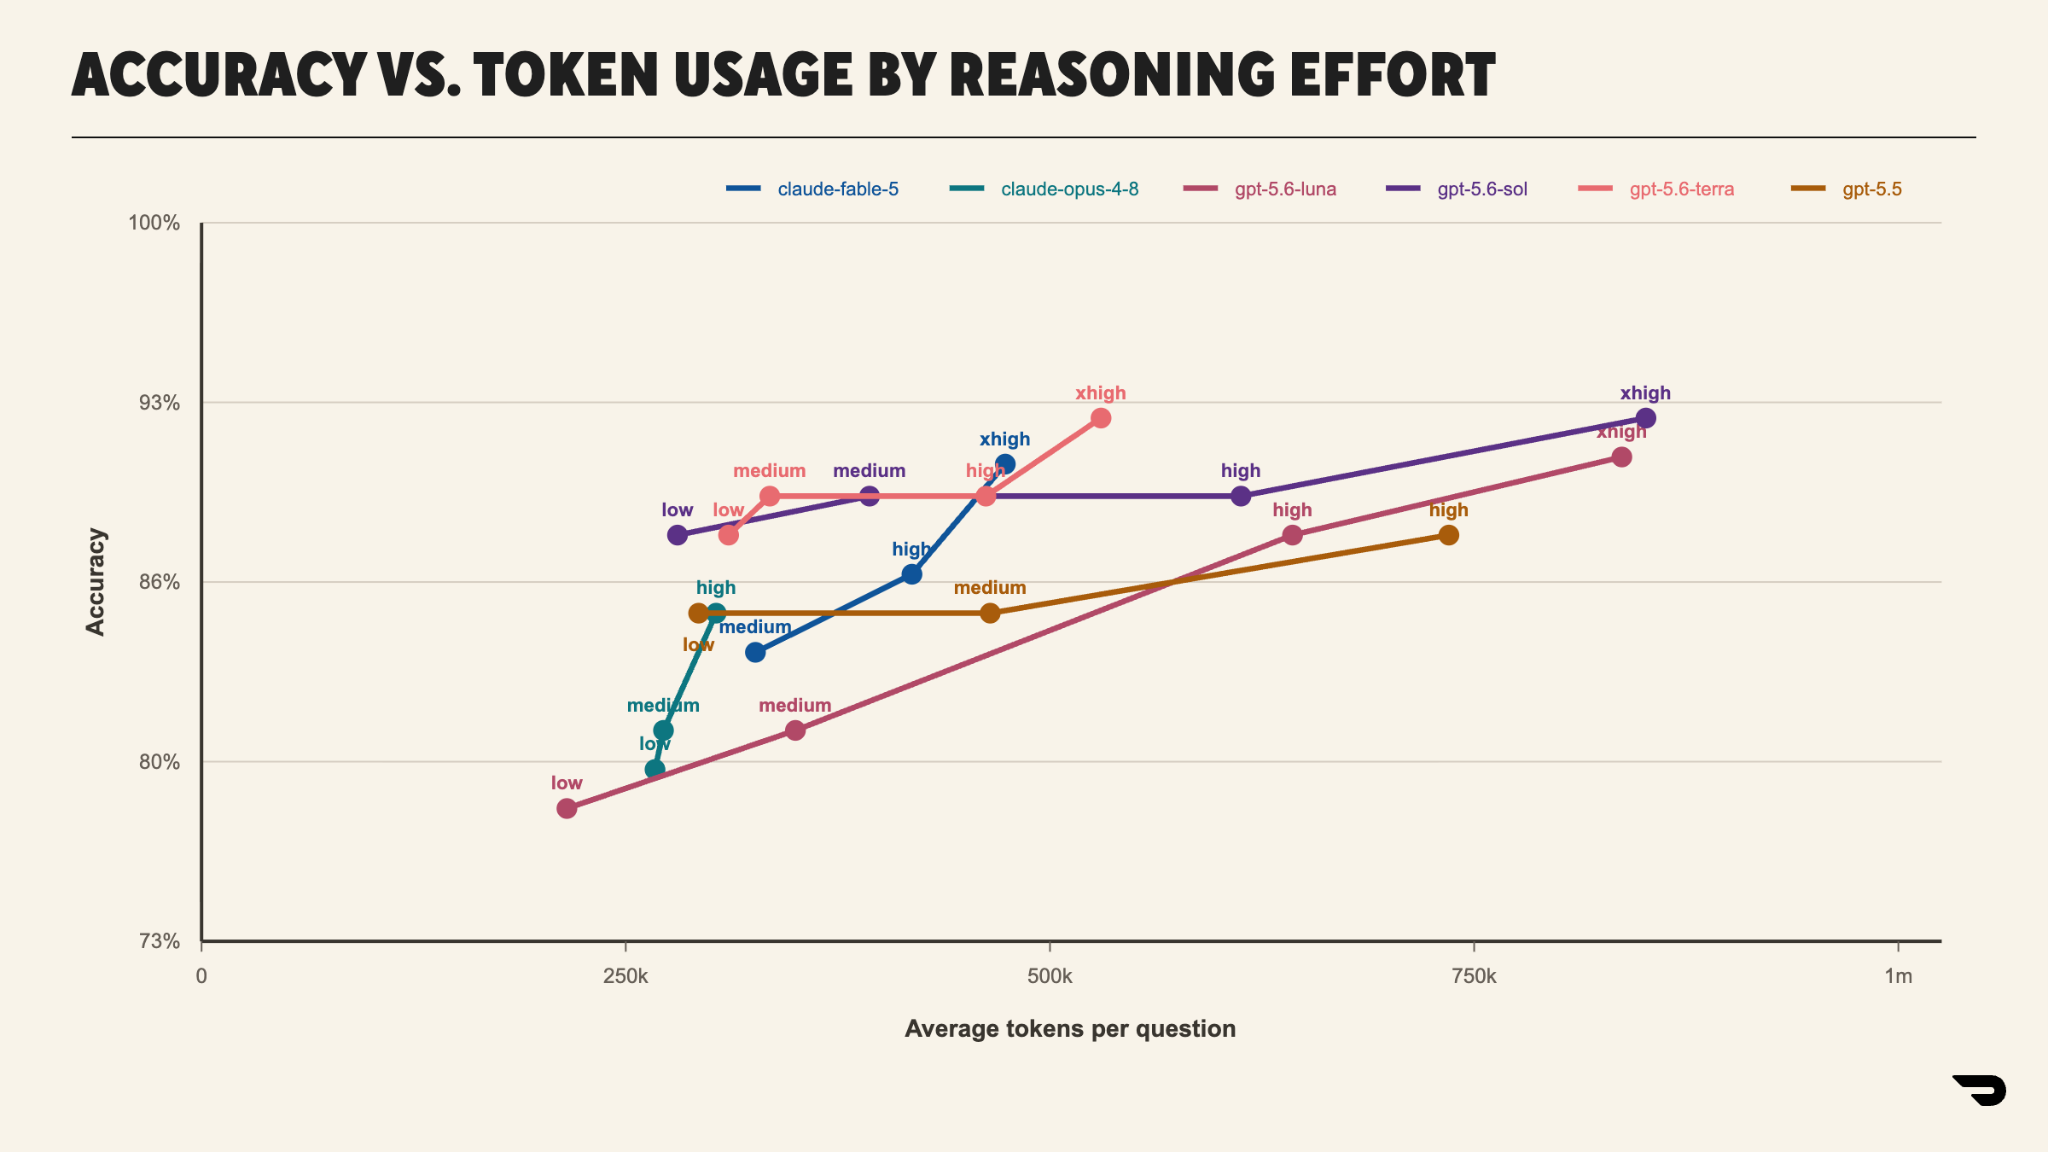
Bien que les modèles de pointe affichent de bonnes performances avec notre ensemble de tests sur ce benchmark, il existe différents compromis à prendre en compte en matière de latence, d’utilisation d’outils et de coût selon le modèle et le fournisseur. Nous choisissons le modèle de production de Vera en fonction de ces compromis plutôt qu’en nous basant uniquement sur le score global, et nous réexécutons le benchmark à mesure que de nouveaux modèles sont mis à disposition. Ces tests d’ablation sont effectués sur un sous-ensemble de 100 questions ; par conséquent, des différences de quelques points relèvent de ce que nous considérons comme du bruit. Quel que soit le type de modèle, un effort de raisonnement accru améliore le score.

Figure 1 : Précision en fonction du nombre de tokens par question sur le sous-ensemble de 100 questions. Chaque courbe augmente avec l'effort et toutes convergent vers le haut ; l'effort est donc un facteur important, au même titre que le choix du modèle, et se mesure en tokens.

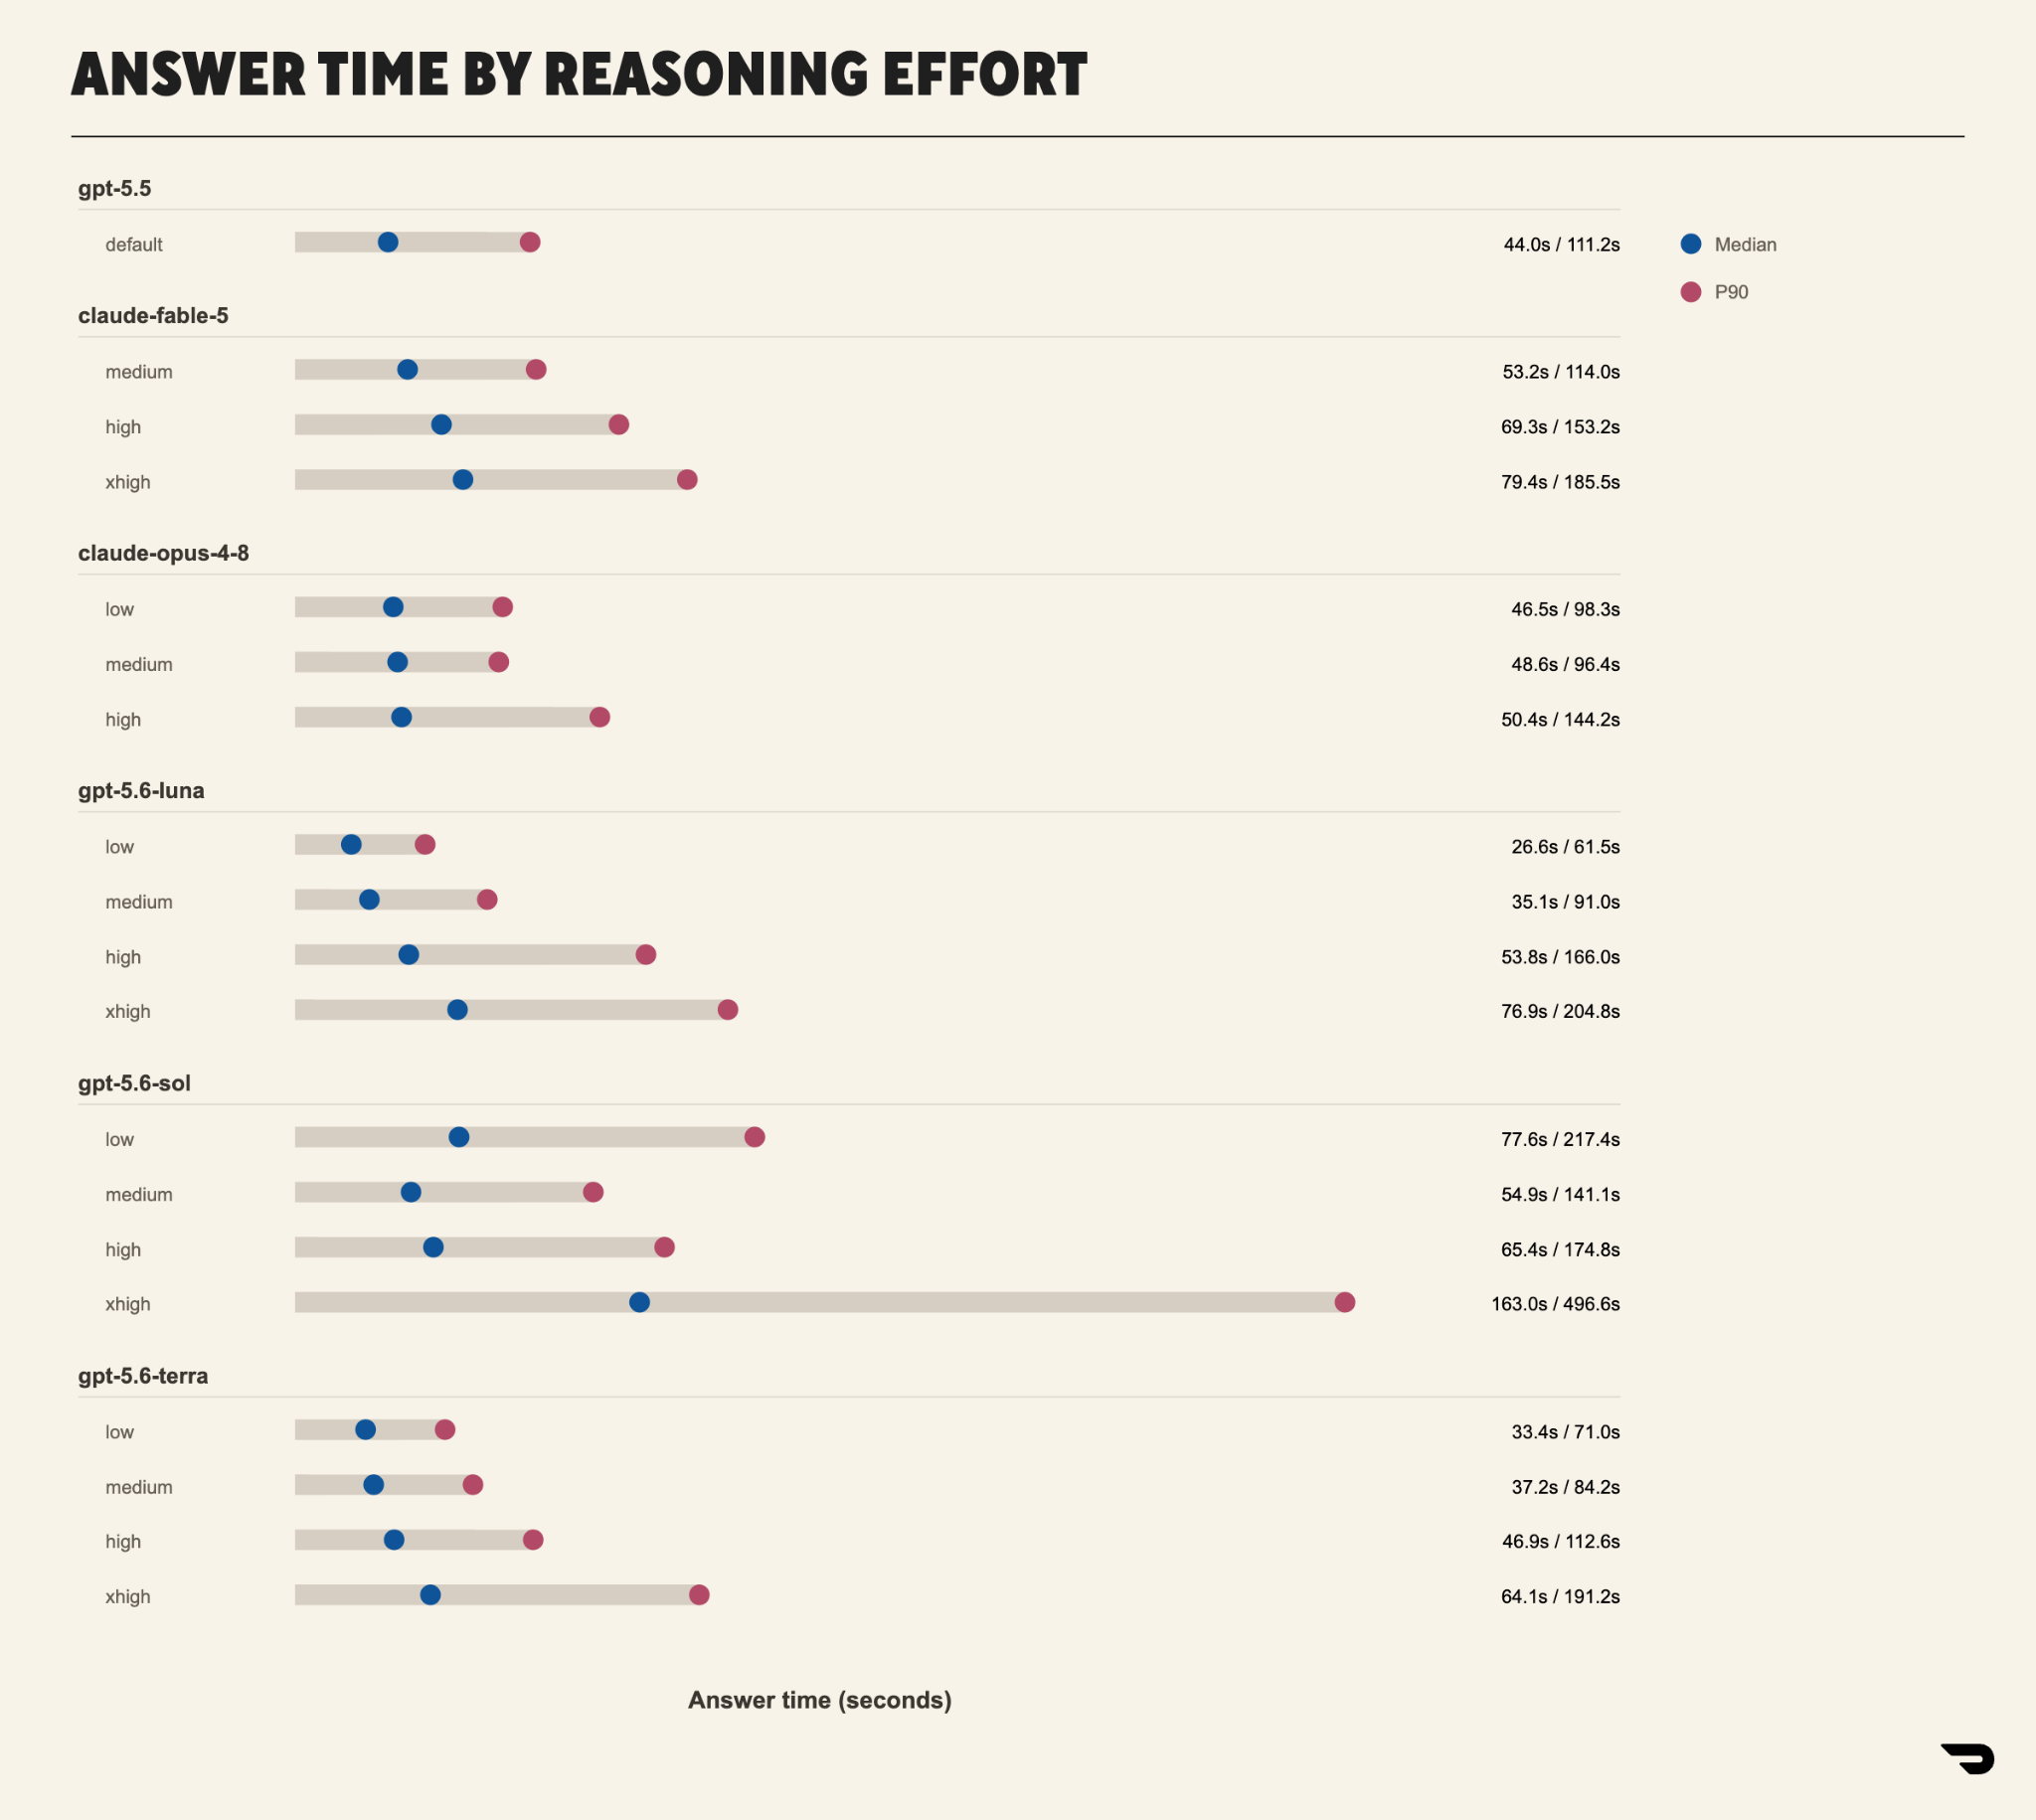
L'écart de performances à la frontière est faible, les modèles d'OpenAI et d'Anthropic obtenant des scores similaires lorsqu'on leur consacre davantage de ressources. Naturellement, l'augmentation du budget de raisonnement entraîne une augmentation de la latence.

Figure 2 : Temps de réponse médian et p90 pour les mêmes modèles et niveaux d'effort. Un effort plus important permet d'améliorer la précision au prix d'un temps de traitement plus long.

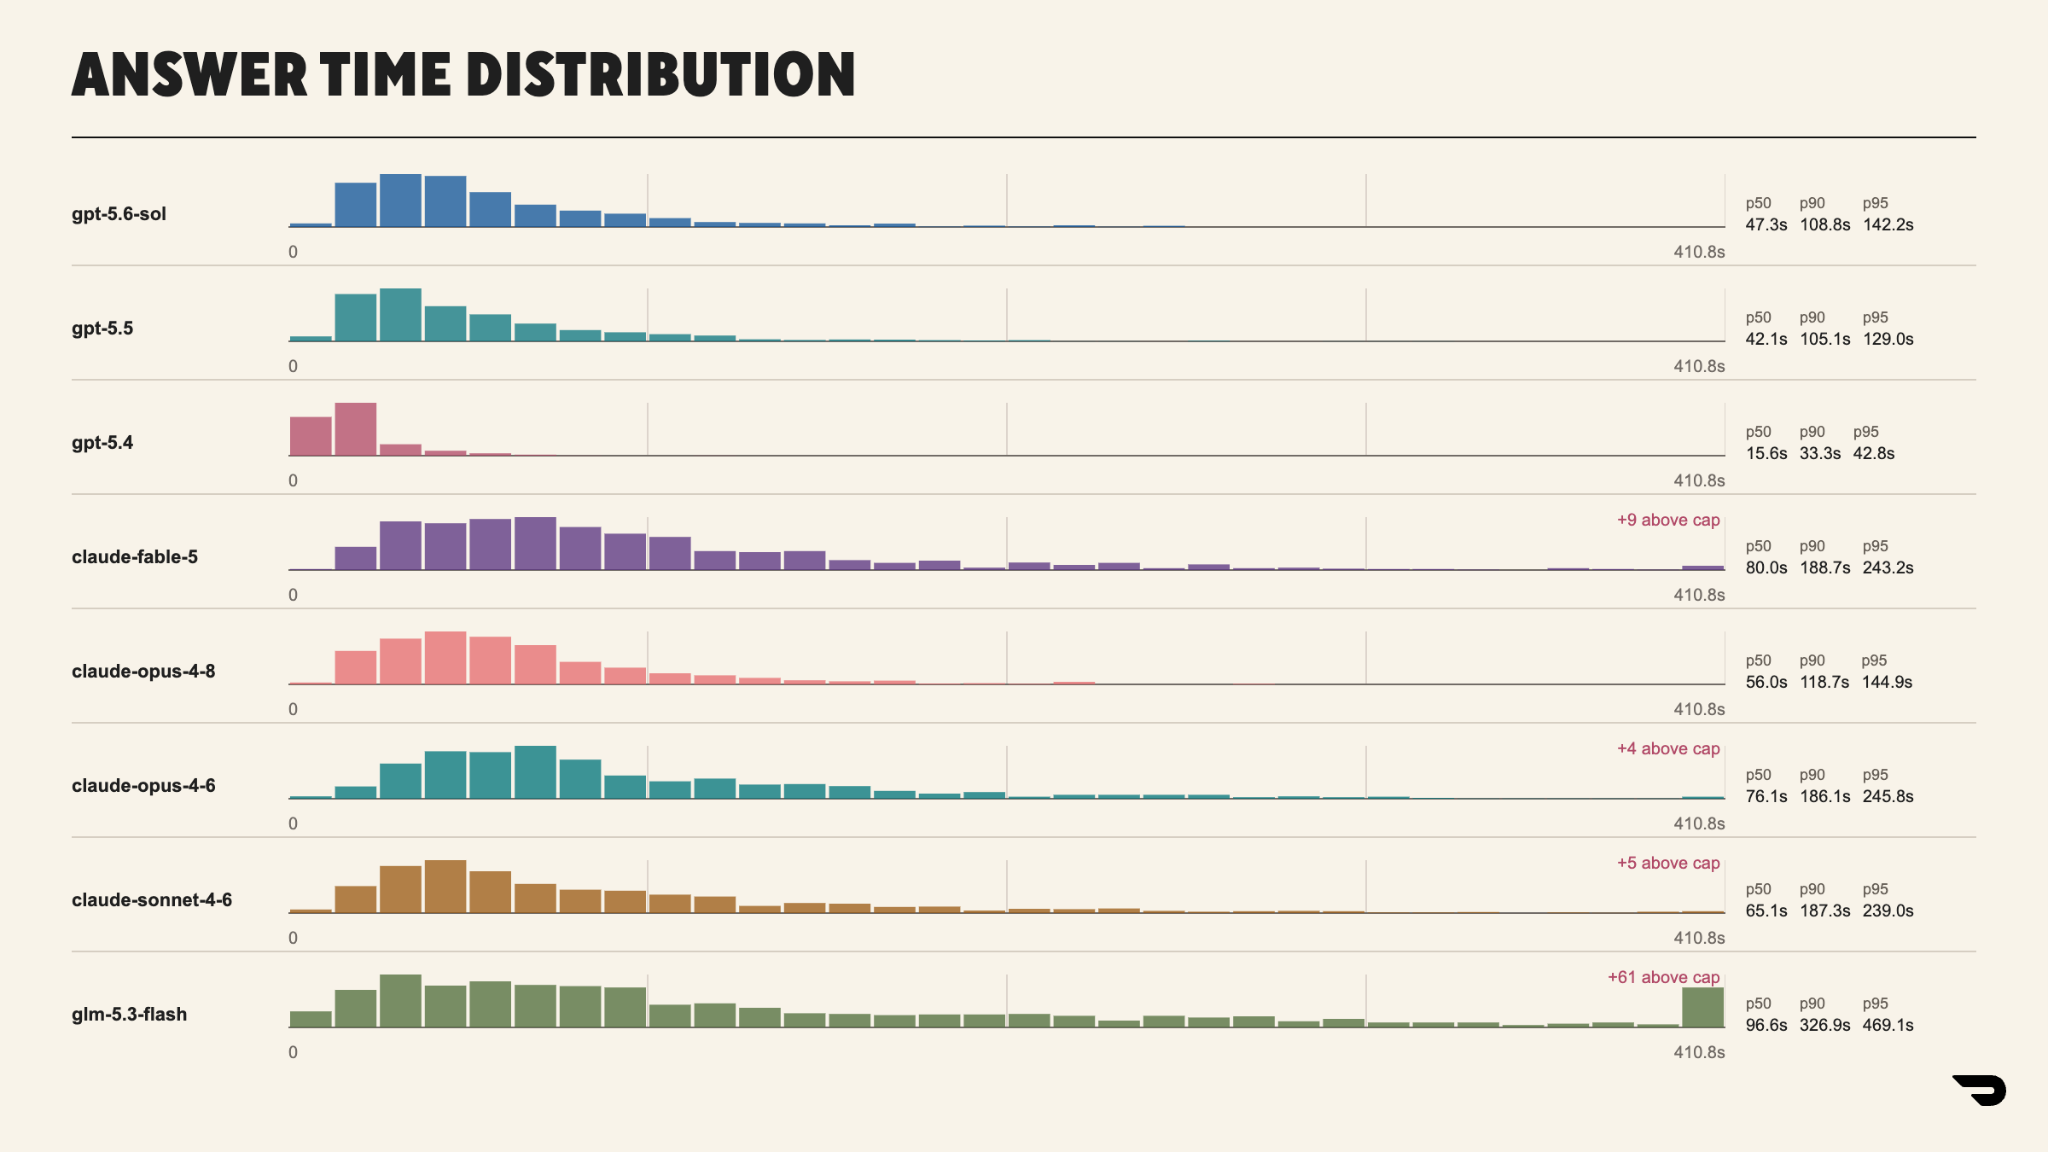
Si un effort de raisonnement accru entraîne une augmentation monotone du score de référence, cet effet peut s'avérer néfaste pour le système dans son ensemble, sous la forme de réponses plus longues à l'utilisateur et d'appels plus fréquents de l'outil vers le magasin de données, ce qui augmente le risque de délais d'attente et de résultats partiels. Nous avons observé les distributions de temps suivantes selon les modèles, comme le montre la figure 3 :

Figure 3 : Répartition des temps de réponse par modèle sur l'exécution complète. C'est la queue de la distribution, et non la médiane, qui est à l'origine des dépassements de délai et des résultats partiels.

Dans notre environnement, la latence de queue des modèles Anthropic était plus longue que celle de leurs équivalents OpenAI. Nous avons hébergé une instance interne de GLM 5.3 Flash via des points de terminaison Modal à titre de comparaison approximative, bien que son caractère non optimisé ait entraîné d’importants délais d’expiration en cas de charge importante. 

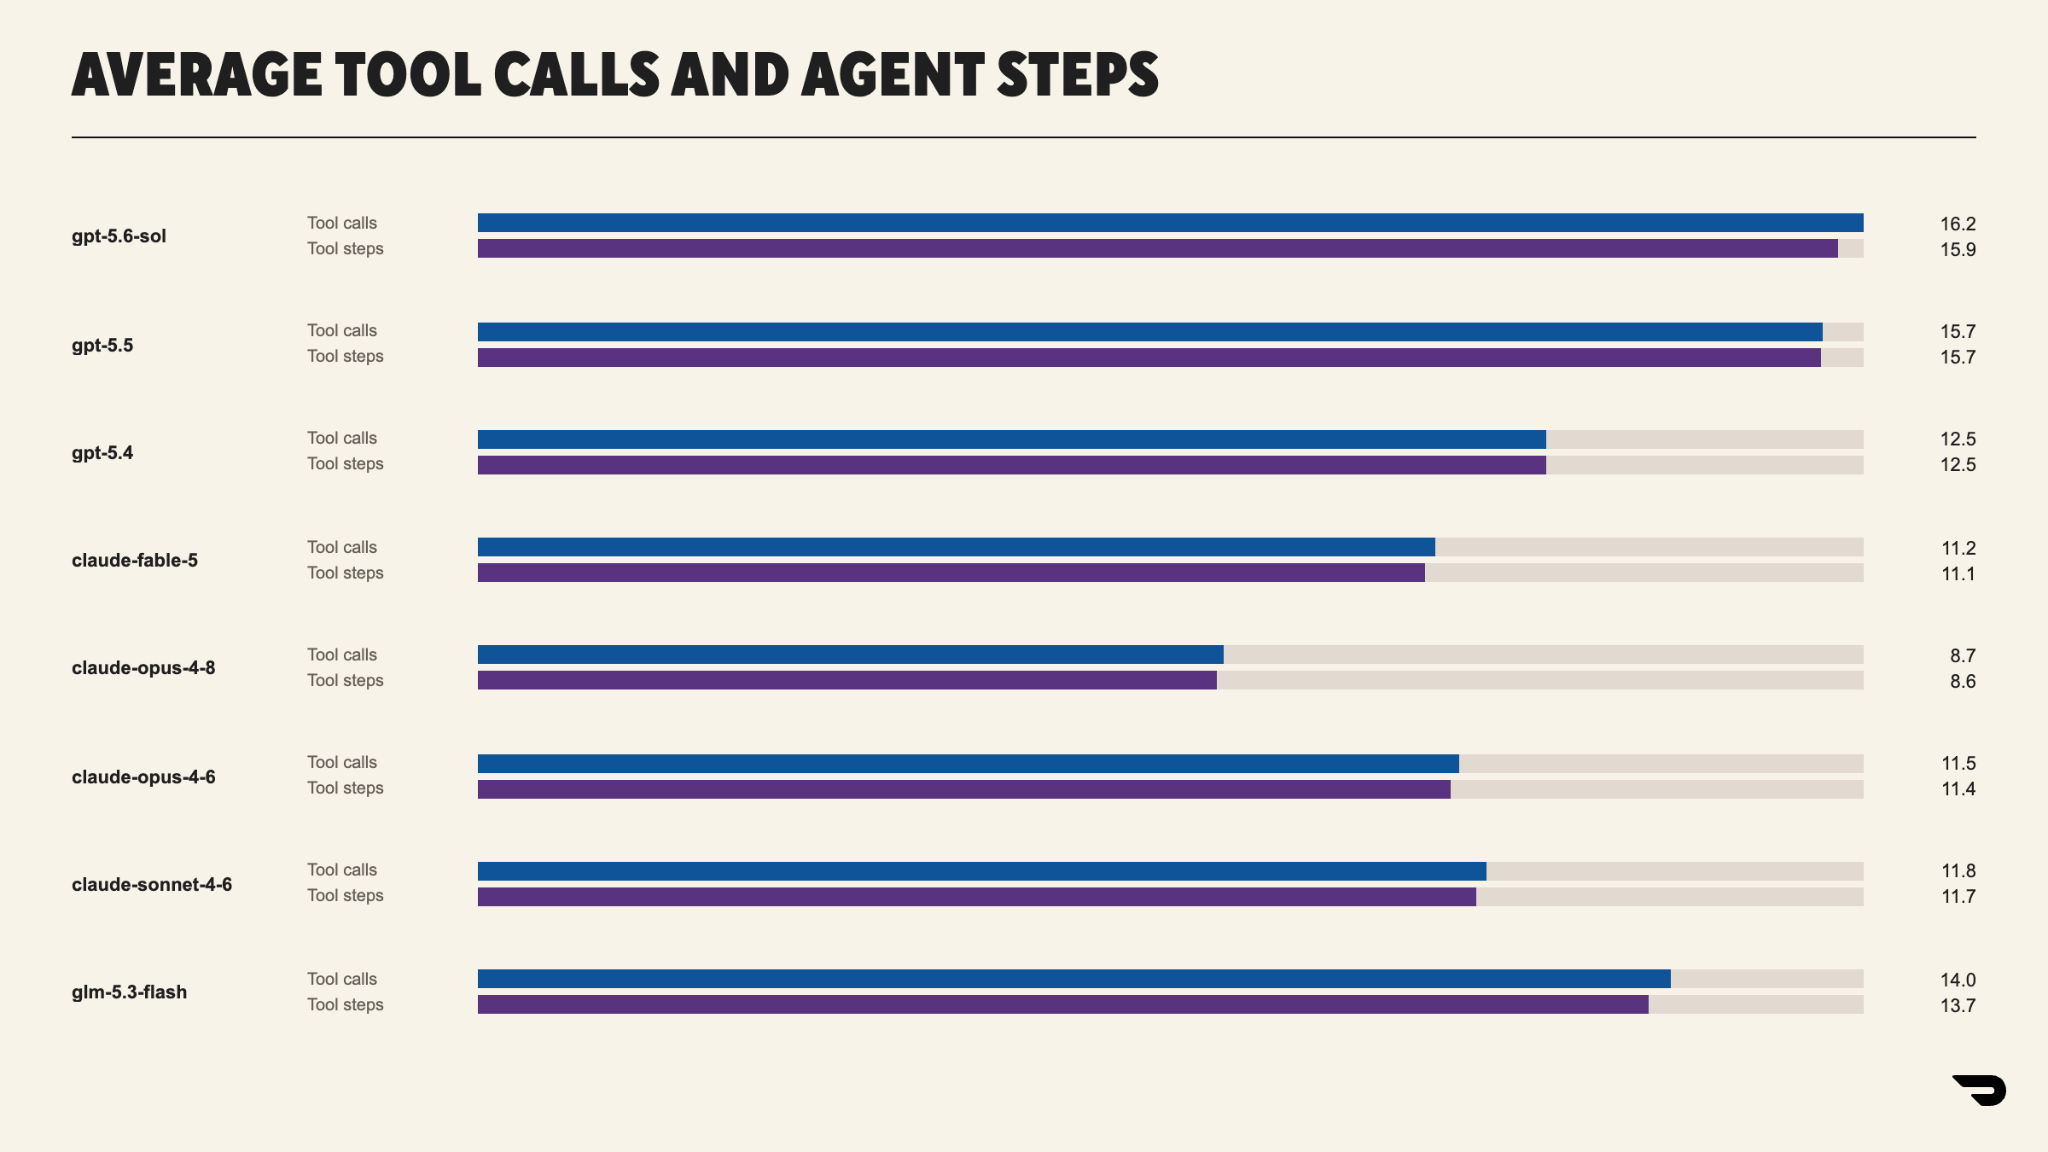
Claude Fable 5 a nécessité moins d'étapes d'usinage que les modèles GPT, mais a pris plus de temps par étape et a pratiquement doublé la durée d'exécution. Cela apparaît clairement lorsque l'on compare les trajectoires d'outils des différents modèles, comme le montre la figure 4 :

Figure 4 : Nombre moyen d'appels d'outils et d'étapes d'agent par question. Un nombre d'étapes plus faible ne signifie pas nécessairement une réponse plus rapide, car les modèles qui nécessitent moins d'étapes consacrent plus de temps à chacune d'entre elles, comme le montre la figure 3.
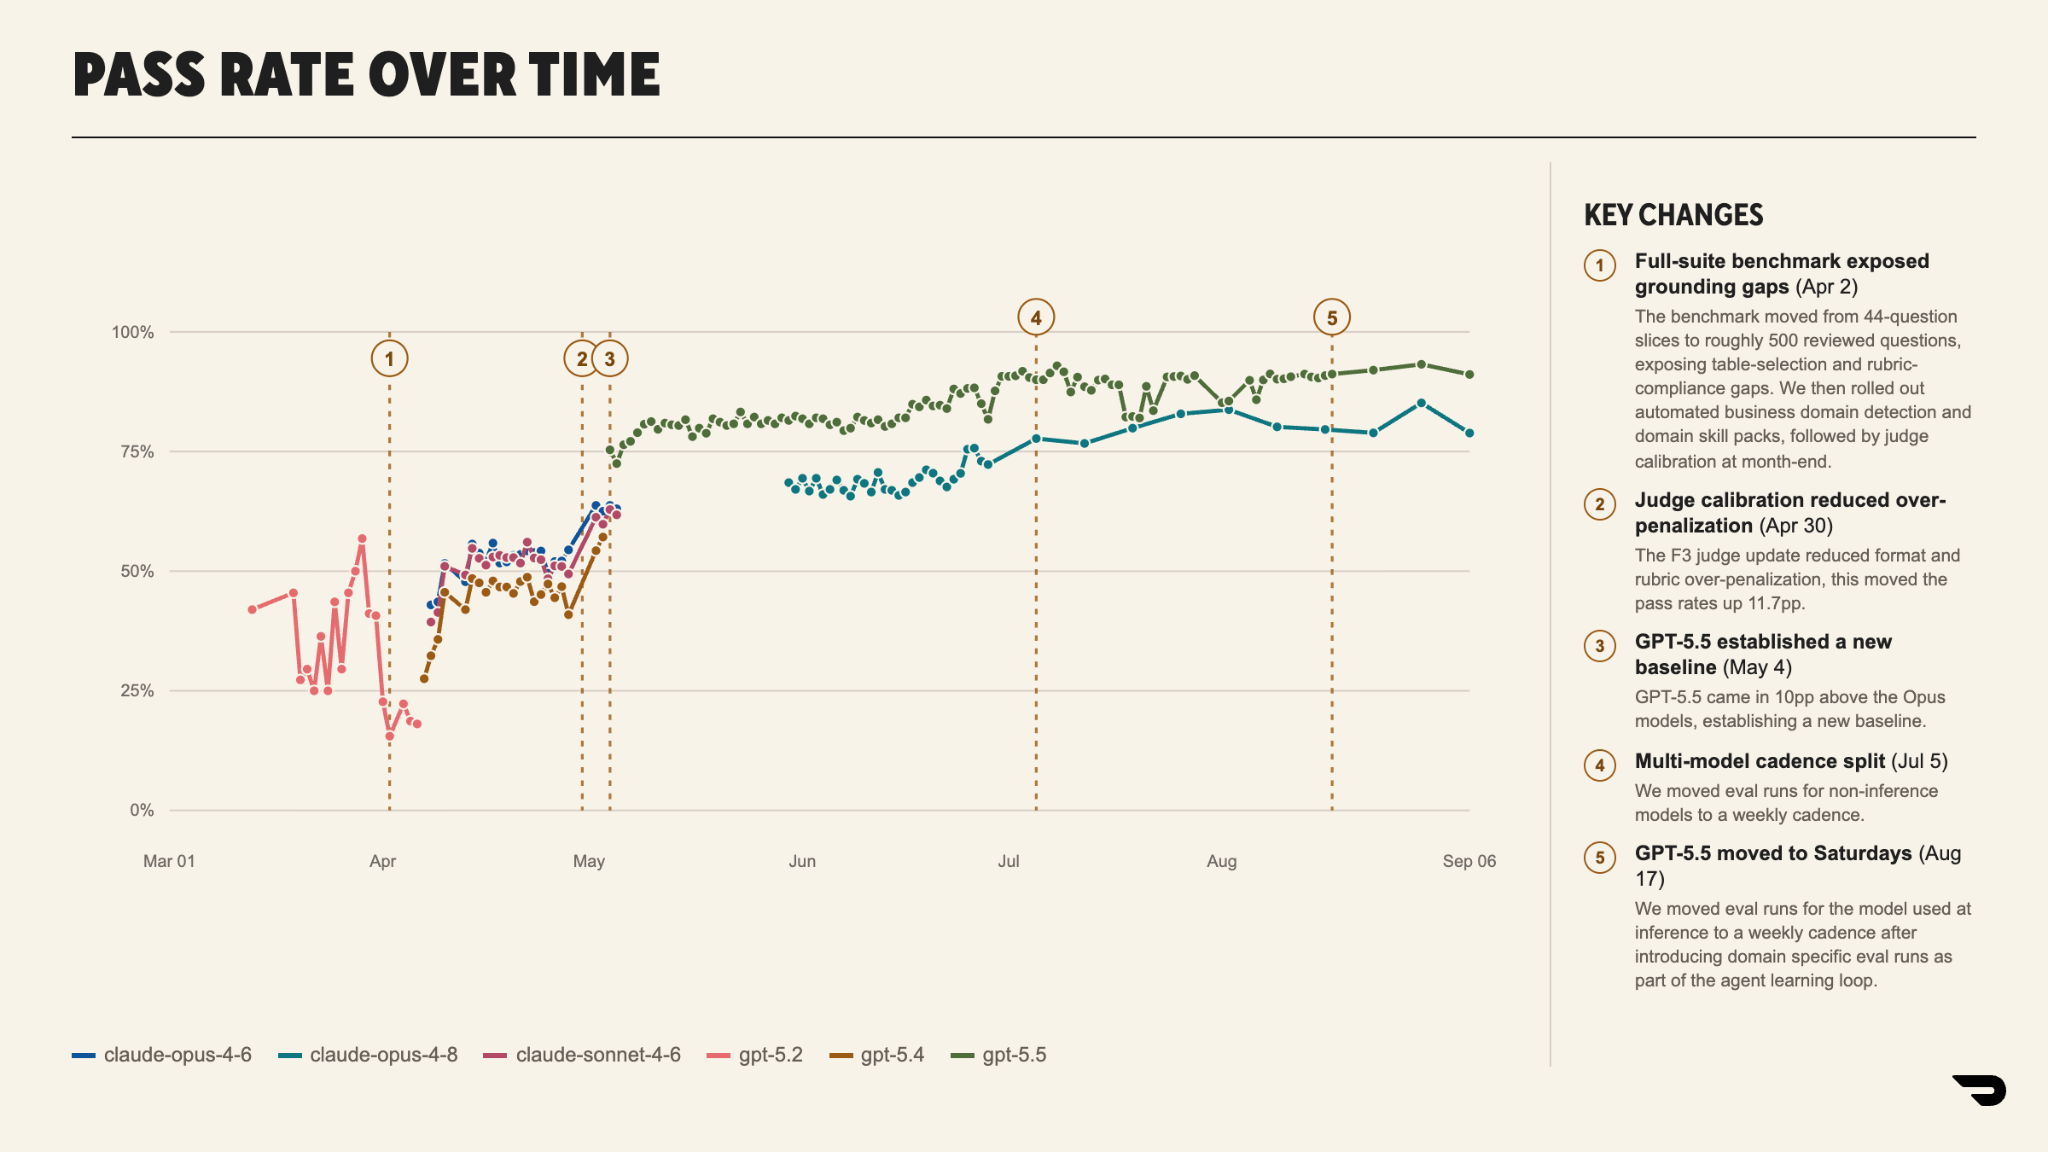
Bien que nous ayons historiquement constaté des améliorations progressives des scores de référence pour les nouvelles variantes de modèles, l'impact des mises à jour s'est progressivement stabilisé, comme le montre la figure 5 :
Figure 5 : Taux de réussite par modèle de mars à septembre, avec les changements qui l'ont influencé.

Cela montre clairement que l’intelligence brute du modèle n’est plus le principal facteur contribuant aux améliorations de Vera, et que l’ensemble des fonctionnalités du modèle — qui intègre le contexte métier, la recherche de connaissances, la modélisation des données, la validation SQL et l’exécution — constitue désormais le principal vecteur d’amélioration pour l’avenir. 

Pour valider cette hypothèse, nous avons testé à la fois Claude Code et Vera avec un modèle commun, Opus 4.8. Nous avons doté CC de nos outils d'accès SQL et des mêmes compétences que celles utilisées par Vera.

Nous avons testé 100 échantillons représentatifs sur chaque système. Vera a obtenu un score de 2,60/3,0, soit un taux de réussite de 73 %, tandis que CC a obtenu un score de 2,16/3,0, soit un taux de réussite de 48 %. Cet écart se situait bien en dehors de la marge d'erreur estimée. Nous avons constaté que CC avait du mal à interroger efficacement les tables modélisées pour tirer des conclusions correctes, ce qui a mis en évidence la nécessité d’une couche de données efficace, comprenant notamment un catalogue des tables modélisées, des heuristiques de jointure, etc. À suivre : comment nous construisons et interrogeons cette couche. 

Extraction et classement

Chez DoorDash, plus de 10 000 personnes s'appuient sur un écosystème de données qui s'est développé pour inclure plus de 200 000 ensembles de données, 350 pétaoctets de données et 10 sources de connaissances institutionnelles, allant des dépôts de code aux wikis. Face à une telle quantité de données disponibles, le défi consiste souvent à savoir lesquelles utiliser et à quel moment. L'étape d'extraction et de classement fournit ces sources de données à jour, précises et sans contradiction. 

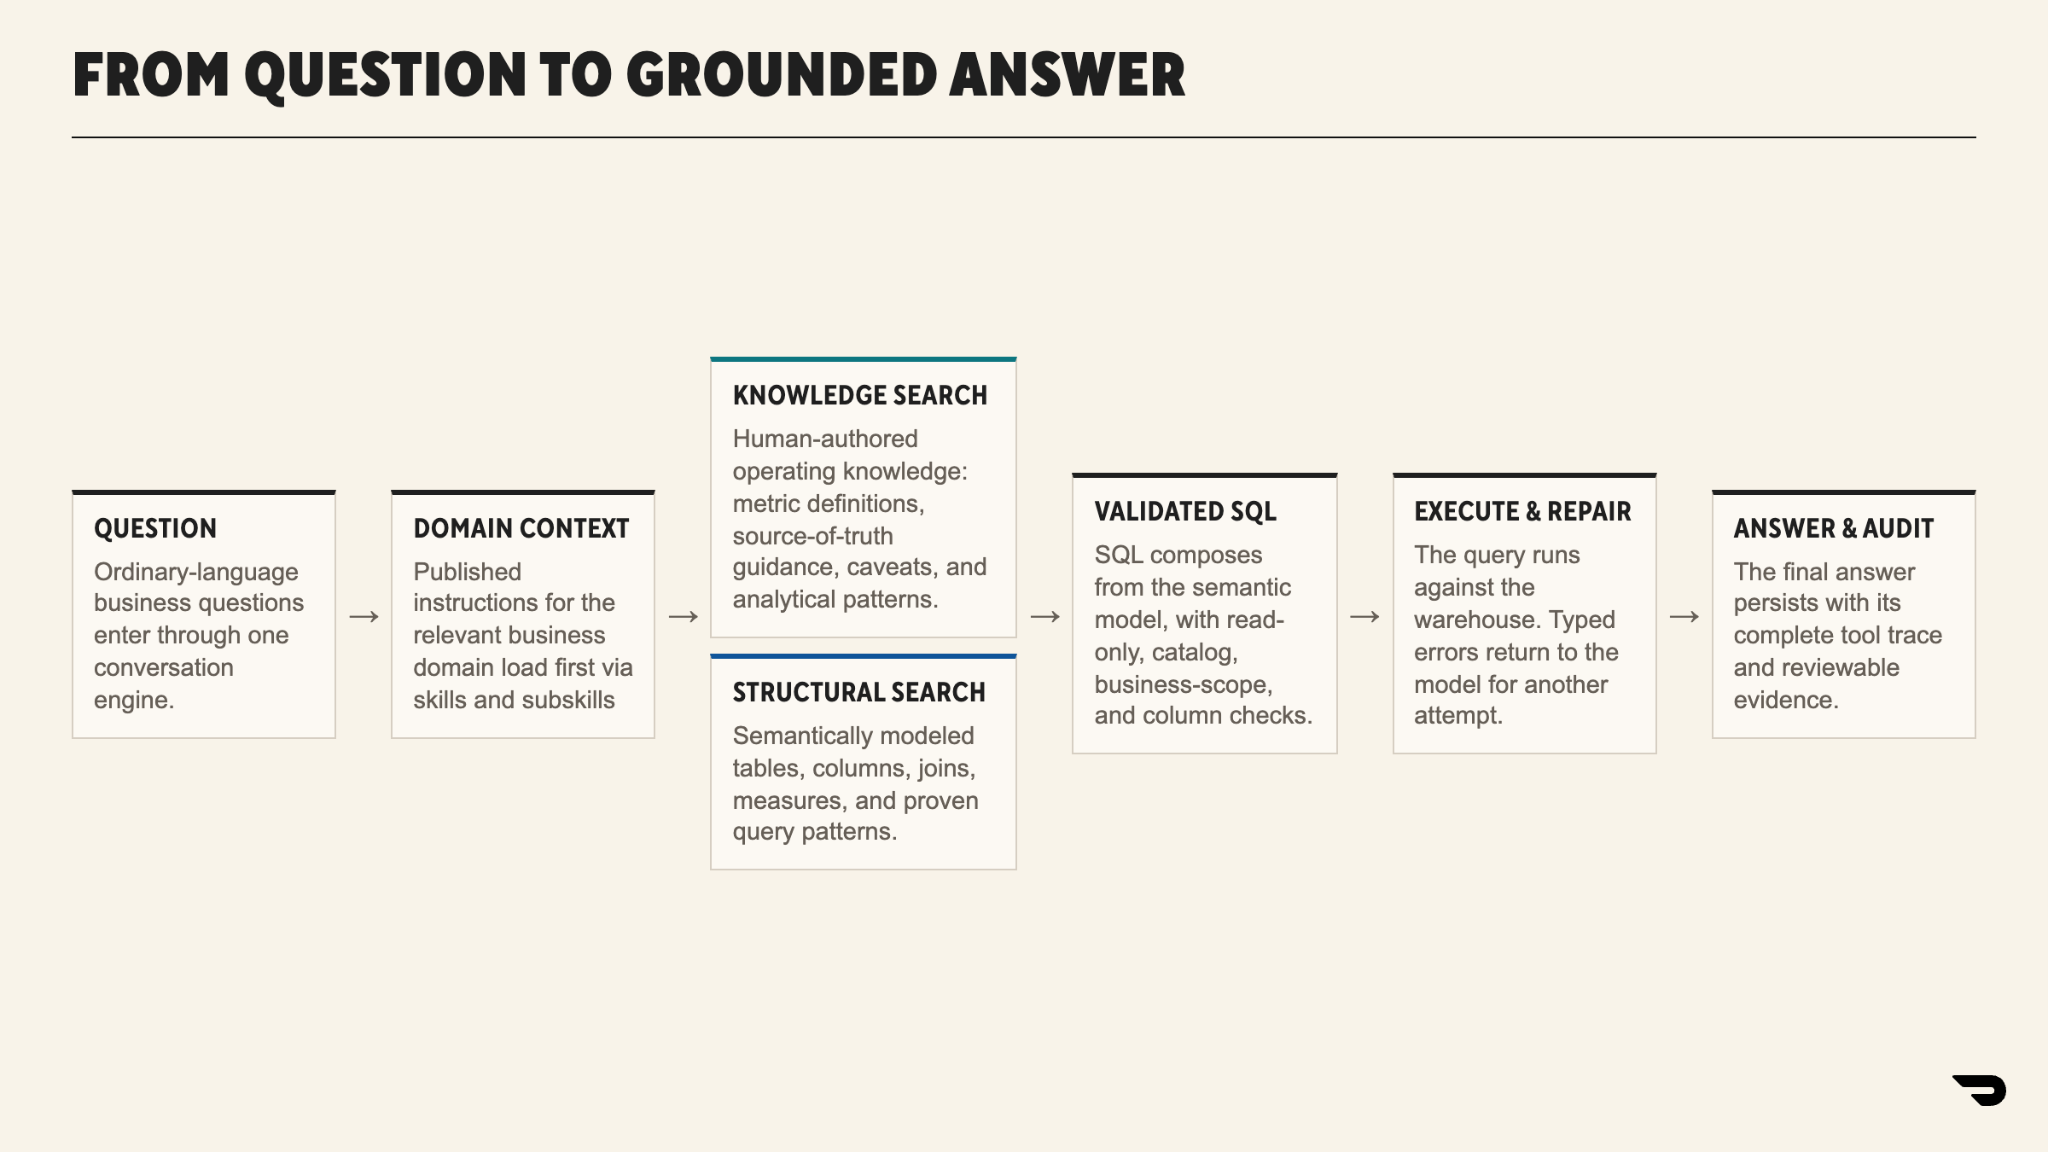
Figure 6 : Le parcours de Vera, de la question à la réponse étayée. Le système de recherche effectue deux recherches en parallèle : l'une sur les connaissances rédigées par des humains et l'autre sur les tables modélisées ; toutes les étapes en aval sont alors contraintes par ce modèle.

Par souci de simplicité, un seul modèle d'intégration est utilisé pour l'ensemble des bases de connaissances. Les tables de données principales sont indexées hors ligne à intervalles réguliers, ce qui nous permet de filtrer les requêtes peu pertinentes et d'éliminer les éléments standardisés. Nous apprenons les schémas de jointure et d'autres aspects sémantiques à partir des modèles d'utilisation restants, des métadonnées des tables, des références de code et des pages wiki afin de construire un modèle de données riche. 

Le modèle de données impose des contraintes au comportement d'exécution ; l'accès aux sources non modélisées ou non vérifiées est bloqué au niveau du harnais. L'un des inconvénients réside dans le décalage entre le moment où les données deviennent disponibles et celui où Vera peut les interroger. Les nouvelles tables sont détectées et indexées à la fois de manière autonome au moment de l'inférence et périodiquement en arrière-plan. Ce compromis en termes de précision en vaut la peine, car la grande majorité des tables métier essentielles ont une longue durée de vie et sont déjà indexées. 

Nous devons également réfléchir à la manière de gérer l'ajout de nouvelles informations. Comment déterminer si de nouveaux modèles de jointure ou de nouvelles intégrations de documents apportent une valeur ajoutée aux requêtes des utilisateurs ? Par défaut, ces sources sont marquées comme inactives et doivent franchir un seuil d'évaluation avant qu'un propriétaire de domaine ne les valide. Les propriétaires de domaine peuvent également activer la validation entièrement automatisée pour leur domaine. 

De plus, chaque source de connaissances et chaque compétence intègre des informations permettant de remonter jusqu’au document source ; un processus de détection des modifications vérifie régulièrement s’il existe des différences par rapport au document source. Les modifications importantes donnent lieu à une proposition de modification qui suit un parcours de validation et est soumise aux mêmes critères de validation que les évaluations.

Évaluations et notation

Plus de 1 900 évaluations ont été fournies tant par des propriétaires de domaines que par des utilisateurs lambda ; chaque contribution d'utilisateur est vérifiée par un propriétaire de domaine avant d'être prise en compte. Chaque évaluation est notée par un juge LLM sur la base de trois questions : 

  1. L'agent a-t-il utilisé les bons outils ?
  2. Cette méthode a-t-elle utilisé les tables appropriées ?
  3. La réponse finale était-elle correcte ?

Nous présentons la moyenne pondérée de ces réponses comme note globale. Le modèle d’évaluation a été calibré de manière itérative à plusieurs étapes clés. L’écart le plus notable était une tendance à pénaliser excessivement les réponses correctes lorsque les tableaux étaient équivalents mais pas identiques. Les recalibrages ont permis de garantir que le modèle d’évaluation soit résistant aux imprécisions numériques, qu’il accepte les sources de données équivalentes et qu’il ignore les différences mineures de mise en forme. 

La question opérationnelle centrale est la suivante : comment obtenir, à l'échelle de l'entreprise, des évaluations qui soient pertinentes, non redondantes et représentatives d'un véritable travail d'analyse, sans pour autant alourdir la charge de travail des responsables de domaine ? 

Nous avons intégré à Vera des outils qui complètent les évaluations manuelles en exploitant les résultats du travail quotidien, tels que les fils de discussion Slack et les tickets Jira. Un modèle de pointe analyse chaque livrable et rédige une proposition d'évaluation complète, comprenant la question, une requête SQL ou une grille d'évaluation, ainsi qu'une note de complexité. 

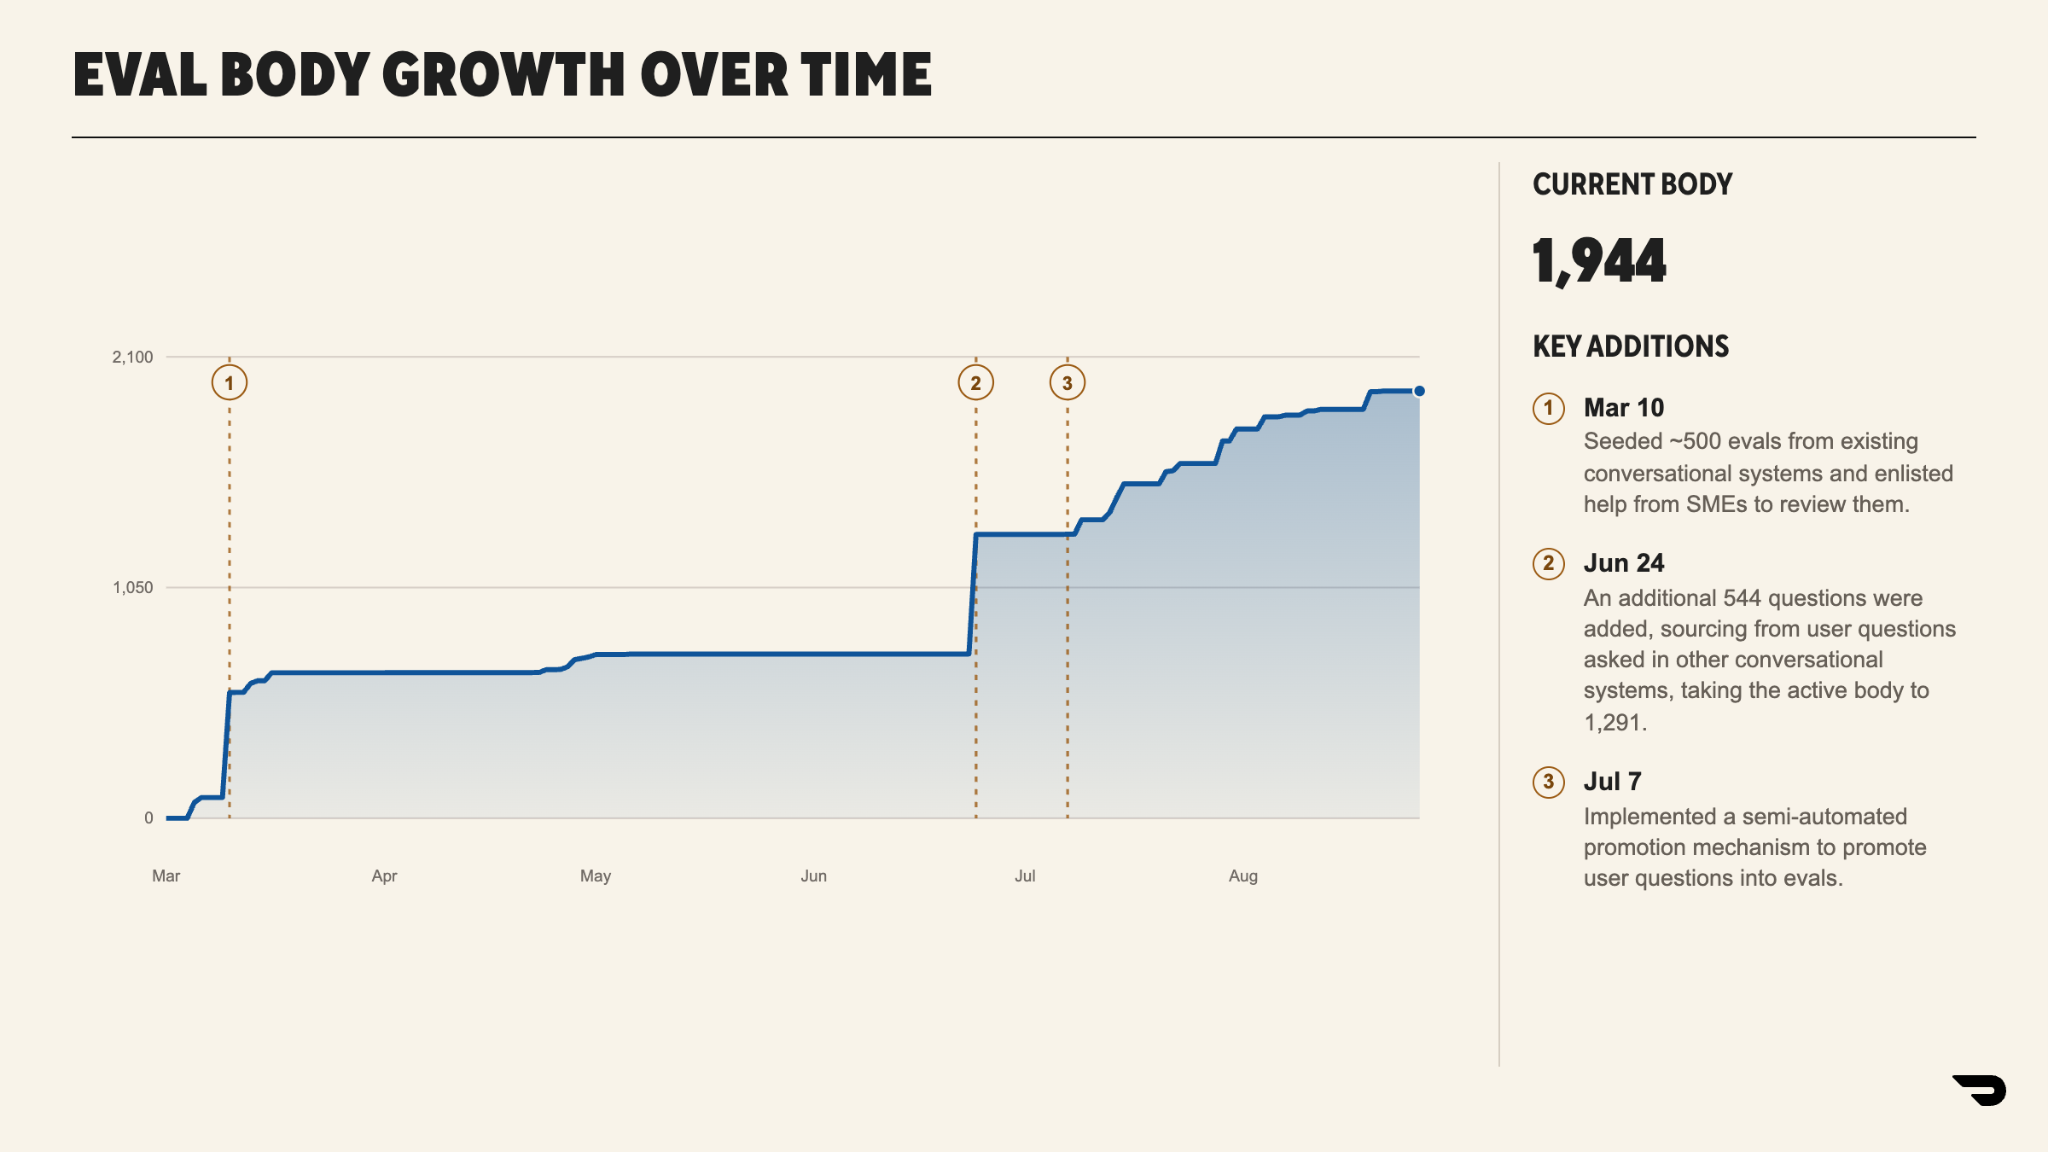
Les propriétaires de domaines examinent ensuite chaque proposition et décident soit de l'ajouter à l'ensemble d'évaluations, soit de l'en retirer. Nous avons constaté que cette méthode permettait de mieux exploiter le temps des experts que de leur demander de rédiger des évaluations à partir de zéro. Cela s'est traduit par un nombre nettement plus élevé d'évaluations, offrant ainsi une couverture plus large, comme le montre la figure 7 : 

Figure 7 : Évolution de l'ensemble d'évaluation, avec les trois ajouts qui l'ont constitué. Les deux pics correspondent à des importations en masse vérifiées par les propriétaires de domaines, tandis que la hausse régulière observée après juillet correspond au processus d'extraction et de promotion.

Garantir la qualité à cette échelle devient plus difficile. Nous supprimons automatiquement les questions quasi-identiques à l'aide d'un indicateur de similarité ; les responsables de domaine acceptent 95 % des questions restantes lors de la révision. 

Faire face à la complexité

Bien que Vera soit principalement conçue pour répondre à des questions de nature conversationnelle, les connaissances générales et les comportements acquis lors de l’entraînement ultérieur des modèles sous-jacents lui permettent de traiter des questions nettement plus complexes. Nous utilisons une taxonomie sommaire de la difficulté des problèmes :

  • Niveau 1: Questions descriptives avec des définitions connues et des modèles préétablis, notamment l'extraction de métriques, l'analyse des tendances, les ventilations et les contrôles de cohérence
  • Niveau 2: Analyses susceptibles d'influencer les décisions commerciales ou relatives aux produits, notamment la hiérarchisation des priorités, le ciblage, l'évaluation des opportunités et l'affectation des ressources
  • Niveau 3: Questions nécessitant une interprétation plus approfondie et une plus grande responsabilité, notamment l'analyse causale, les résultats d'expériences, les prévisions fermes et l'aide à la décision dans des situations à enjeux élevés

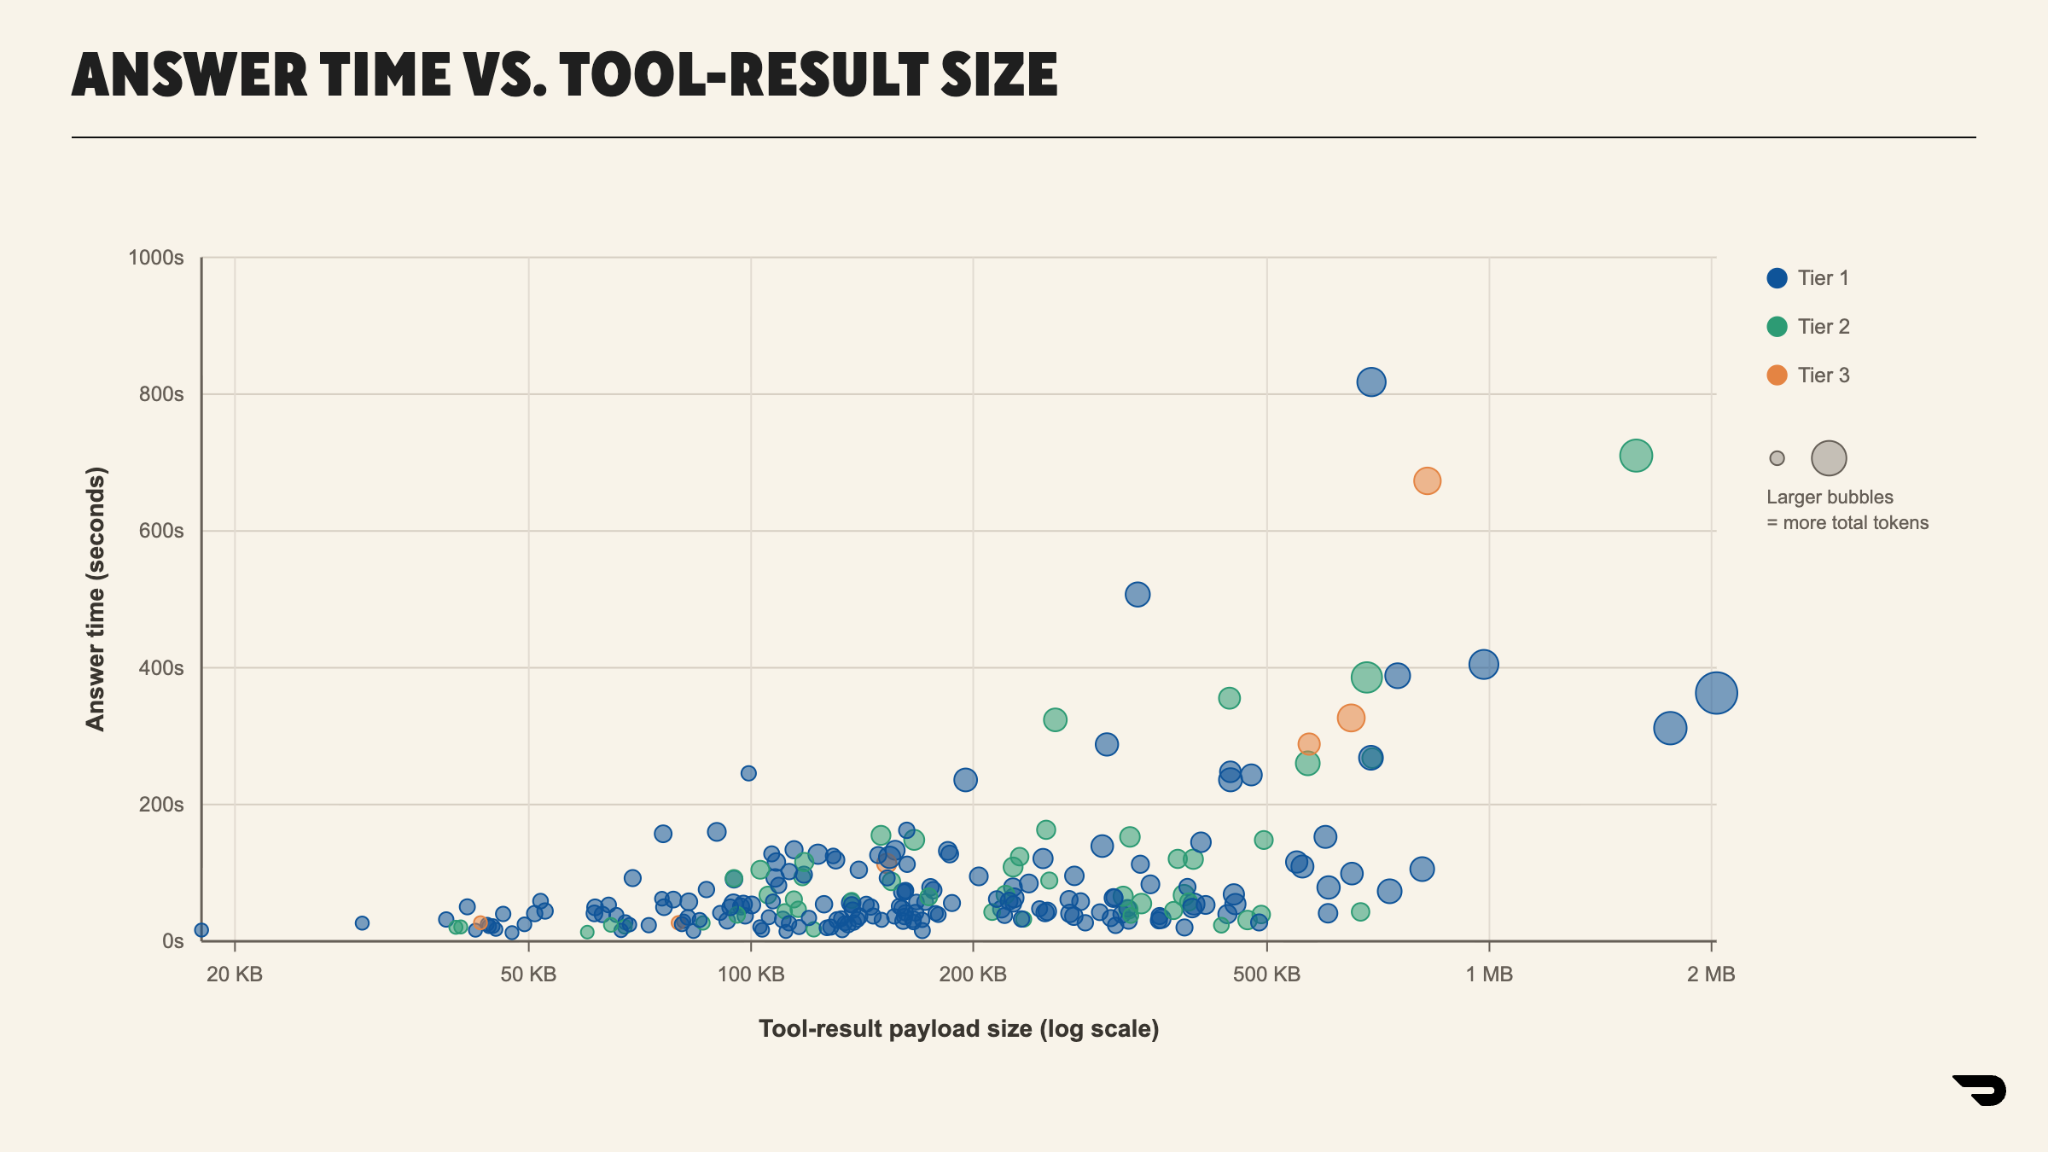
Étant donné que le chevauchement entre les niveaux est important, il peut s'avérer difficile de classer les requêtes dans des catégories distinctes ; cela permet toutefois de mieux comprendre l'effort requis par le modèle pour traiter les requêtes les plus complexes, comme le montre la figure 8 : 

Figure 8 : Temps de réponse en fonction du volume de données récupérées par les outils à chaque exécution. Les questions de niveaux 2 et 3 se concentrent sur les charges utiles plus importantes et les exécutions plus longues ; ainsi, les questions plus complexes nécessitent davantage de données et de temps, et pas seulement de raisonnement.

Pour les requêtes plus complexes du niveau 3, nous avons remarqué que les modèles avaient tendance à s'arrêter prématurément et de manière trop optimiste. Il existait pourtant des informations pertinentes pour répondre à la requête, mais le modèle renvoyait souvent des réponses superficielles — bien que plausibles — sans approfondir la question. 

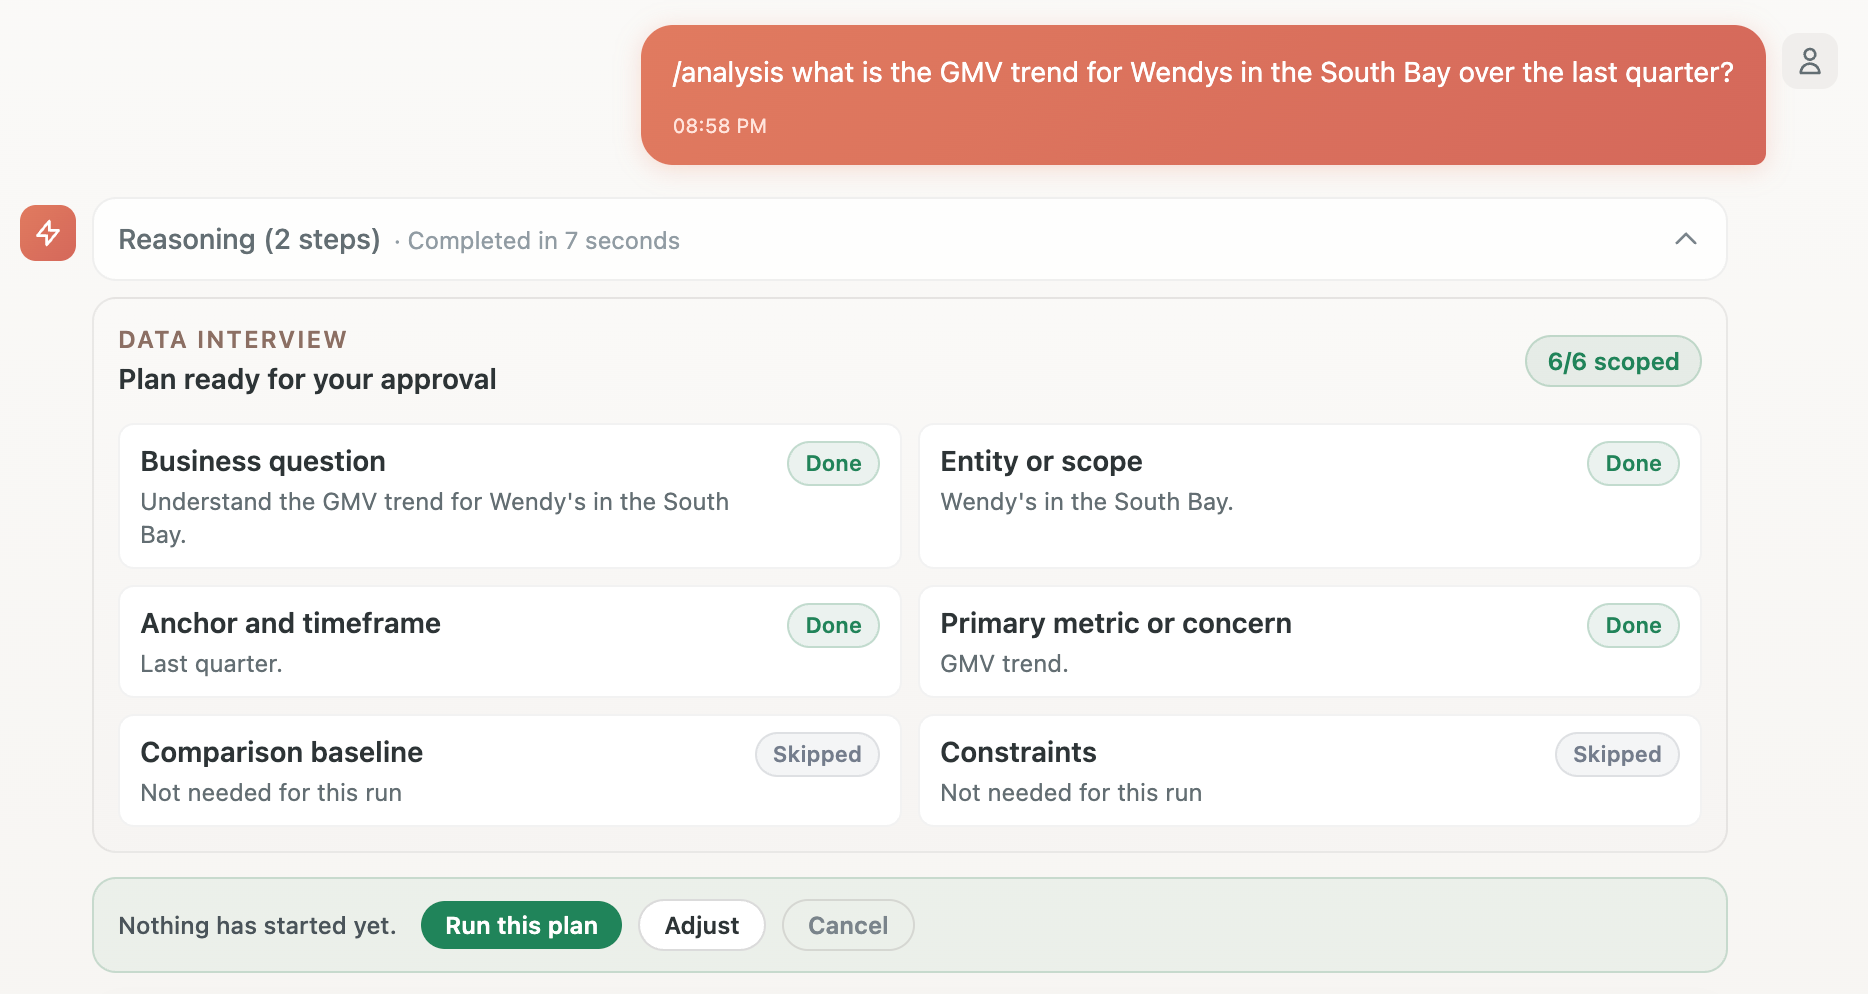
Pour ces questions, nous avons mis en place un flux d'analyse qui a permis au modèle de procéder à l'identification du problème et à la planification avant l'exécution, comme le montre la figure 9 : 

Figure 9 : Déroulement de l'analyse de Vera concernant une question relative aux tendances des commerçants. Le plan est affiché avant l'exécution de toute requête, et aucune opération n'est effectuée tant que l'utilisateur ne l'a pas approuvé ou modifié.

C’est à ce stade que l’agent définit les délais, les indicateurs souhaités, le périmètre pertinent et les éventuelles contraintes que l’utilisateur souhaite imposer. Nous avons constaté qu’une étape de planification structurée améliore les performances de ces évaluations de niveau 3, mais avec une grande variabilité — un taux de réussite compris entre 64 % et 100 % — sur un petit échantillon de 14 cas, ce qui souligne la nécessité d’un retour d’expérience plus large et plus approfondi de la part d’experts dans ces domaines. 

À l'avenir, nous nous concentrerons principalement sur ces questions plus complexes et plus subjectives du niveau 3. 

Points à retenir

Au cours du projet, le taux de réussite est passé de 43 % à 90 %, tandis que la taille de l'ensemble d'évaluation a doublé à deux reprises. Les améliorations apportées à la sophistication des modèles sous-jacents ont contribué à renforcer les performances, mais c'est l'ingénierie des données autour du harness qui s'est avérée la plus déterminante. 

De nombreuses questions restent en suspens :

  1. Comment pouvons-nous continuer à garantir la qualité tout en réduisant le coût par réponse ?
  2. Comment mettre en place des évaluations autour de questions d'analyse de données et de reporting plus complexes ?
  3. En quoi des analyses plus rapides et plus performantes influencent-elles les indicateurs clés de l'activité ?

Au fur et à mesure que nous développons nos capacités d'analyse de données chez DoorDash, nous aborderons ces questions en suspens dans les prochains articles de cette série.

Contributeurs : Pavel Astakhov, Andy Fang, Jash Radia, Naveen Srinivasan, Helen Lin, Lokesh Sharma, Adnan Sheikh, Gun Johnson, Harsha Venkat Annapa Reddy

Chez DoorDash, nous disposons de nombreuses équipes d'ingénierie qui prennent en charge nos différents domaines techniques. Ce document présente une vue d'ensemble de nos domaines techniques et des équipes qui les prennent en charge :

  1. Dasher & Logistics
  2. Principes fondamentaux
  3. LaunchPad et la recherche en IA
  4. Place de marché
  5. Plateforme destinée aux commerçants et aux consommateurs
  6. Nouveaux produits verticaux
  7. Excellence opérationnelle
  8. Services de plateforme
  9. DashOS
  10. Argent
  11. Annonces et promotions

Nous espérons que ces profils vous seront utiles pour répondre à notre enquête sur la composition des équipes. 

Nos équipes étant en constante évolution, ce document présente un aperçu de notre structure actuelle au sein du département Ingénierie. Veuillez garder à l'esprit qu'elle est susceptible de changer d'ici votre date d'entrée en fonction. C'est pourquoi, lors du processus d'affectation aux équipes, nous nous concentrerons sur le type de poste qui vous intéresse. Outre vos préférences et votre parcours technique, nous tiendrons compte de la capacité d'accueil des équipes et d'autres facteurs organisationnels.

Remarque : les abréviations désignant nos principaux segments de clientèle apparaissent tout au long du document – Commerçant (Mx), Consommateur (Cx), Livreur (Dx) – ainsi que Restaurants (Rx).


Dasher & Logistics

L'équipe Dasher & Logistics (DxLx) est le moteur du réseau de livraison de DoorDash : elle assure l'exécution de chaque commande avec intelligence, précision et à grande échelle. Du « cerveau » logistique qui gère les itinéraires des Dashers et équilibre l'offre et la demande, aux plateformes et produits qui créent une expérience cohérente et enrichissante pour les Dashers, cette équipe veille à ce que chaque livraison soit effectuée de manière efficace et fiable.

Notre vision consiste à mettre en place un réseau de logistique de la plus haute qualité et au coût le plus bas, afin qu'il devienne le choix privilégié des travailleurs indépendants et des commerçants du monde entier. DxLx repose sur deux piliers principaux :

  • Logistique : Développe une plateforme logistique mondiale de premier plan dédiée au « dernier kilomètre », à la pointe de l’ingénierie, de la science et des infrastructures. L’équipe repousse sans cesse les limites en matière de rapidité, de coût, d’efficacité et de fiabilité, permettant ainsi la réalisation de millions de livraisons chaque jour.
  • Dasher : Notre mission est d'offrir aux Dashers davantage de choix, de stabilité et d'opportunités. Notre équipe s'attache à créer la meilleure plateforme de missions ponctuelles au monde, en favorisant la fidélisation, la croissance et la satisfaction grâce à des modèles d'emploi innovants, des systèmes de récompenses et des programmes d'engagement.

DxLx est au cœur de l'expérience DoorDash : il révolutionne la manière dont les marchandises circulent dans les villes et facilite la vie de millions de personnes à travers le monde.


Principes fondamentaux

L'équipe « Foundations » met en place l'infrastructure de base, les données et les plateformes de développement qui sous-tendent l'ensemble des produits et services de DoorDash. Véritable pilier technique de l'entreprise, elle associe infrastructure et données pour créer une base homogène, sécurisée et évolutive, s'appuyant sur notre écosystème cloud AWS. Cette organisation repose sur trois piliers clés :

  • Plateforme pour développeurs : permet aux ingénieurs d'avancer rapidement et de développer en toute confiance grâce à une expérience développeur de premier ordre, reposant sur des plateformes modernes, fiables et hautement performantes.
  • Infrastructure de base : fournit des systèmes sécurisés, efficaces et résilients qui permettent aux ingénieurs de développer d'excellents produits rapidement et à grande échelle.
  • Données fondamentales : ce service coordonne les activités d'ingénierie des données et de la plateforme de données afin de garantir que l'entreprise s'appuie sur des données fiables et de haute qualité, et d'accélérer l'innovation produit basée sur les données au sein de DoorDash.

En septembre 2025, les équipes « Foundations » de DoorDash et de Wolt se sont unies pour développer Pedregal et construire ensemble l’avenir, en s’appuyant sur des principes communs : assurer la continuité des activités, mettre en place un leadership unifié, favoriser la responsabilité géographique, respecter les fuseaux horaires et affecter les talents les plus adaptés aux problèmes à résoudre.

« Foundations » est la plateforme sur laquelle repose l'ensemble de notre activité, et il reste encore beaucoup à faire pour définir comment elle évoluera au fur et à mesure que DoorDash se développe, afin de garantir la fiabilité, la performance et la rapidité dans toutes nos activités.


LAUNCHPAD ET RECHERCHE EN IA

La mission de LaunchPad est d’innover, d’expérimenter et de faire émerger des idées audacieuses. L’équipe est conçue pour agir rapidement, en transformant sans délai les idées prometteuses en prototypes concrets afin que DoorDash puisse déterminer dans quels projets il vaut la peine d’investir davantage. Parallèlement à LaunchPad, DoorDash AI Research est une équipe de recherche appliquée qui explore comment les dernières avancées en matière d’IA peuvent transformer le fonctionnement de l’entreprise DoorDash.

L'organisation couvre deux domaines principaux :

  • Projets « 0 à 1 » : LaunchPad se consacre à des idées novatrices et à fort potentiel au sein de l'écosystème de produits DoorDash, c'est-à-dire à des projets susceptibles de déboucher sur une nouvelle activité majeure ou d'ouvrir la voie à une nouvelle fonctionnalité significative pour la plateforme. 
  • Recherche en IA : explore comment les dernières avancées en matière d'IA peuvent améliorer DoorDash, qu'il s'agisse d'accroître la productivité des ingénieurs, de développer des agents IA capables d'agir au nom des clients, des commerçants et des Dashers, ou encore d'aider l'entreprise à mieux comprendre et exploiter ses propres données.

Étant donné que LaunchPad et AI Research ont tous deux pour mission de tester les innovations à venir avant qu’elles ne s’imposent comme des éléments à part entière de l’activité, rejoindre cette structure, c’est travailler sur certaines des idées les plus novatrices et les plus exploratoires de DoorDash.

LaunchPad est dirigé par Andy Fang, cofondateur de DoorDash.


Place de marché

Présentation du marché  

L'organisation Marketplace facilite les échanges de biens entre acheteurs et vendeurs dans de nombreux secteurs d'activité, en garantissant confiance, qualité et fluidité à très grande échelle. Sa mission consiste à développer des composants fondamentaux et évolutifs qui permettent aux équipes de déployer des fonctionnalités innovantes avec confiance et rapidité. Marketplace s'articule autour de trois piliers fondamentaux, chacun contribuant à l'expérience client de manière unique et significative :

  • Core Consumer : gère l'ensemble du parcours de commande, en offrant à chaque client, où qu'il se trouve, une expérience d'achat rapide, intuitive et agréable.
  • Croissance de la clientèle : accélère l’expansion de DoorDash grâce à des analyses fondées sur les données, à l’expérimentation et à une optimisation continue, de la connexion au paiement et au-delà.
  • DashPass : supervise notre activité d'abonnement, en mettant l'accent sur la croissance, l'engagement et la fidélisation. L'équipe chargée de l'engagement favorise l'intégration et l'adoption rapide du service, en aidant les clients à profiter de la valeur ajoutée de DashPass dès le premier jour, tandis que l'équipe chargée de la fidélisation veille à ce que les membres restent connectés et continuent à percevoir la valeur ajoutée tout au long de leur parcours.

L'équipe Marketplace pose les bases de l'expérience DoorDash : elle met en relation des millions de clients avec les commerces locaux qu'ils apprécient, de manière plus rapide et plus fiable que jamais.


PLATEFORME COMMERCIANTE-CONSOMMATEUR

L'équipe de la plateforme MxCx développe des plateformes de classe mondiale qui accélèrent le développement des produits et garantissent une fiabilité, une observabilité et une sécurité exceptionnelles. Sa mission est de donner les moyens à nos clients de se développer, tout en accompagnant la croissance de DoorDash à tous les niveaux de l'expérience client.

L'équipe se concentre à la fois sur l'expérience des commerçants (Mx) et celle des consommateurs (Cx), en prenant en charge l'ensemble du processus, de l'intégration des commerçants aux applications clients hautement performantes. Ses principaux domaines d'intervention sont les suivants :

Acquisition de commerçants : identifie et intègre de nouveaux restaurants partenaires à l'aide de données intelligentes et d'outils en libre-service faciles à utiliser.

  • Mx Tablet : le matériel et l'application qui permettent aux commerçants de gérer leurs commandes en magasin.
  • Business Manager : une application mobile qui permet aux chefs d'entreprise de gérer et de développer leur activité à tout moment et en tout lieu.
  • Plateforme de commande : le pilier de la gestion du cycle de vie des commandes chez DoorDash, qui permet aux ingénieurs de développer de nouvelles fonctionnalités avec rapidité et fiabilité.
  • Plateforme client MxCx : permet aux ingénieurs client de Consumer de développer de manière sûre et efficace des applications performantes et fiables pour le Web, iOS et Android, garantissant ainsi qualité et cohérence à grande échelle.

L'équipe de la plateforme MxCx constitue la colonne vertébrale de l'écosystème DoorDash : elle développe les outils, les systèmes et les plateformes clients qui favorisent chaque jour la croissance de millions d'utilisateurs et d'entreprises.


NOUVEAUX SECTEURS D'ACTIVITÉ

L'équipe New Verticals (NV) étend l'activité de DoorDash au-delà des restaurants : elle développe une plateforme dédiée au commerce de proximité et permet aux clients d'accéder à tout ce dont ils ont besoin dans leur ville. Des produits d'épicerie et de première nécessité aux articles pour animaux de compagnie, en passant par l'alcool, les articles pour la maison et les produits de beauté, NV redéfinit la façon dont les gens font leurs achats au niveau local.

Notre mission est de faire de DoorDash le partenaire incontournable pour les produits de première nécessité, en aidant les familles et les particuliers à obtenir ce dont ils ont besoin, quand ils en ont besoin. L'équipe s'attaque aux défis complexes propres à la logistique du commerce de détail : elle adapte les systèmes pour gérer des stocks volumineux et dynamiques, améliore la précision des données et optimise l'expérience des livreurs (Dasher) pour divers modèles de livraison, tels que les courses alimentaires et la livraison à l'unité.

Au sein de NV, cinq piliers principaux (NV Categories, NV Consumer, NV Fulfillment, NV Merchant + Selection et NV Machine Learning) s’appuient sur de nombreuses sous-équipes chargées de mener l’innovation. Par ailleurs, l’équipe DashMart est responsable de la supérette et du magasin de proximité virtuels de Dash, dont l’entreprise est l’unique propriétaire, qu’elle exploite et dont elle gère le contenu afin d’offrir une expérience d’achat de nouvelle génération, où « tout est disponible à la demande ».

Les ingénieurs de l'équipe NV ne manqueront jamais de défis à relever et bénéficieront d'opportunités incroyables pour laisser leur empreinte sur le commerce local !


EXCELLENCE OPÉRATIONNELLE 

La mission de l'équipe « Excellence opérationnelle » (OpEx) consiste à instaurer la confiance et à améliorer l'efficacité grâce à l'innovation et à l'automatisation. Si les consommateurs, les commerçants ou les livreurs ne peuvent pas avoir confiance dans l'équité et la fiabilité de notre plateforme, notre activité n'a pas de raison d'être. L'équipe OpEx s'articule autour de quatre axes principaux :

  • Expérience de livraison : garantit un suivi fluide et transparent des commandes ainsi qu'une assistance dès qu'une commande est passée.
  • Fraude : veille à l'équité de la place de marché en prévenant et en détectant les activités frauduleuses.
  • Confiance et sécurité : renforce la confiance entre les livreurs, les commerçants et les consommateurs en vérifiant l'identité des utilisateurs et en veillant au respect des règles.
  • Plateforme de gestion des risques et des identités : permet de déployer efficacement ces initiatives grâce à des plateformes dédiées à la gestion des risques, des données et des comptes, ainsi qu’à des solutions d’apprentissage automatique et d’intelligence artificielle.

En tant qu'ingénieur au sein de l'équipe OpEx Engineering, vous contribuerez au bon fonctionnement des systèmes qui garantissent l'efficacité, l'équité et la sécurité de notre plateforme à très grande échelle. Qu'il s'agisse de lutter contre la fraude en temps réel, d'assurer la fluidité des paiements, d'améliorer l'expérience de livraison ou de renforcer la confiance et la sécurité, votre travail aura un impact sur des millions de personnes. Vous développerez du code pertinent, collaborerez avec des équipes transversales et évoluerez rapidement dans un environnement dynamique où chacun assume pleinement ses responsabilités.


SERVICES DE LA PLATEFORME

L'équipe « Platform Services » développe le système d'exploitation destiné à tous les restaurants, supermarchés et commerces de détail, permettant ainsi aux entreprises locales de prospérer dans l'économie de la proximité. Sa mission consiste à créer les logiciels et le matériel qui aident les commerçants à dynamiser et à développer leurs propres activités en direct. Les ingénieurs de l'équipe interviennent dans cinq domaines à fort impact :

Commandes en ligne : une solution en marque blanche qui s'appuie sur la technologie et l'envergure de DoorDash pour aider les commerçants à développer leurs ventes en ligne directes.

  • Fidélité omnicanale : un programme de fidélité à l'image de la marque du commerçant qui permet aux clients de gagner et d'utiliser des récompenses en toute simplicité, que ce soit en ligne, en magasin ou sur DoorDash.
  • Commande vocale : un service vocal haut de gamme qui permet aux employés en magasin de se concentrer sur les clients pendant que nous nous chargeons des appels.
  • Drive : une solution de « logistique à la demande » qui permet aux commerçants de faire appel à la flotte Dasher pour livrer les commandes passées directement auprès d'eux.
  • DoorDash for Business (DDfB) : des solutions d'entreprise qui permettent aux sociétés d'offrir à leurs employés des avantages alimentaires tels que DashPass for Work, le remboursement des repas, les commandes groupées et les cartes-cadeaux d'entreprise.
  • L'équipe « Platform Services » pose les bases de la prochaine génération du commerce de proximité, en aidant chaque commerçant à entrer en contact avec ses clients à tout moment et en tout lieu.

DashOS

DashOS est une équipe d'ingénieurs créée pour mettre en relation les commerçants et leurs clients de bout en bout. Elle regroupe au sein d'une seule et même équipe des compétences qui étaient auparavant réparties entre différents produits et différentes régions.

DashOS couvre trois domaines principaux :

  • Opérations en magasin : les systèmes utilisés par les commerçants pour gérer leurs activités au quotidien : terminaux de point de vente, bornes interactives et écrans de commande en cuisine.
  • Vitrine en ligne et fidélisation : les outils qui permettent aux commerçants de créer leur propre vitrine en ligne à l'image de leur marque et de gérer leurs propres programmes de fidélité et de récompenses.
  • Restauration et réservations : le volet de l'activité destiné aux consommateurs, qui aide ces derniers à découvrir, réserver et profiter d'expériences gastronomiques et d'accueil.

DashOS réunissant des équipes qui travaillaient auparavant séparément, rejoindre cette organisation, c’est contribuer à la création de plateformes communes à l’échelle mondiale, tout en continuant à façonner l’expérience produit vécue par les commerçants et les clients sur chaque marché local.


Argent

La mission de l'équipe Money est de proposer des solutions de paiement et des services financiers innovants et attrayants pour les segments Cx, Dx et Mx, et de jouer un rôle catalyseur dans la croissance du chiffre d'affaires et des résultats nets de l'entreprise.

Fonctionnant à la fois comme une plateforme et comme une équipe produit, leur principale mission consiste à gérer l'ensemble des transactions financières sur notre plateforme. Cela englobe toutes les opérations, de la facturation des clients au paiement des Mx et Dx, tout en veillant à ce que chaque dollar soit comptabilisé avec précision.

L'organisation repose sur trois piliers :

  • Paiement : l'infrastructure centrale qui sous-tend chaque transaction sur DoorDash — la manière dont les clients paient, dont les livreurs et les commerçants sont rémunérés, et dont les abonnements tels que DashPass sont facturés.
  • Produits financiers : Produits financiers destinés directement aux Dasher, aux consommateurs et aux commerçants, tels que les cartes-cadeaux, la carte Crimson et d’autres avantages réservés aux Dasher, ainsi que les solutions de financement pour les commerçants.
  • Conformité financière : veille à ce que chaque dollar transitant par DoorDash soit correctement suivi, rapproché et conforme aux réglementations financières en vigueur dans le monde entier.

L'équipe Money traite des milliards de dollars chaque année, et ses innovations en matière de paiement, telles que les cartes-cadeaux, ont généré des millions de dollars supplémentaires en valeur brute des commandes annuelles, ce qui souligne l'impact considérable des systèmes financiers et des produits de l'équipe Money sur l'activité de DoorDash !


Publicités et promotions

L'équipe « Publicité et promotions » aide les restaurants, les commerçants et les marques à toucher leurs clients et à développer leur activité sur DoorDash. Cette organisation s'articule autour de deux volets : la publicité et les promotions.

  • Publicité : En associant des données pertinentes à un ciblage intelligent, l’équipe Publicité met les annonceurs en relation avec les audiences adéquates, ce qui favorise la visibilité, la conversion et la croissance. Son fonctionnement repose sur trois piliers : l’offre (l’expérience client), la demande (l’expérience annonceur) et la diffusion (le moteur basé sur l’apprentissage automatique qui relie les deux en temps réel). L’équipe gère deux secteurs d’activité : « Restaurant Ads », qui aide les restaurants à se démarquer auprès des clients affamés, et « CPG Ads », qui met en avant les marques du quotidien, avec le soutien en coulisses des équipes « Ads Foundation » et « Ads Data ».
  • Promotions : permet de proposer les réductions et les offres que les clients voient dans toute l'application – de la page d'accueil jusqu'au paiement –, aidant ainsi les commerçants à générer davantage de commandes tout en permettant aux clients de faire des économies.

À l'avenir, l'équipe s'efforce de rapprocher les publicités et les promotions afin d'offrir aux commerçants une expérience unique et davantage automatisée. Ces deux activités connaissent une croissance rapide, et nous n'en sommes qu'au début : rejoignez-nous pour construire le prochain moteur de croissance de DoorDash.


Cet article aborde les limites du client et de la plateforme qui sous-tendent l’expérience utilisateur et les interactions avec Ask DoorDash : comment nous sommes passés des carrousels de hackathon à ce modèle, comment un seul élément sert trois lecteurs, et comment le contexte et l’état restent cohérents à mesure que les consommateurs naviguent sur DoorDash. Il fait suite à « Créer l’assistant DoorDash : aperçu technique » et nos analyses approfondies Développement d’Ask DoorDash (2e partie) : l’intelligence, Développement d’Ask DoorDash (3e partie) : Évaluation, et Développement d’Ask DoorDash (4e partie) : une plateforme pour créer et faire évoluer des agents.


Ask DoorDash transforme des demandes telles que « Prépare-moi un dîner à 60 $ pour 10 personnes », « Aide-moi à faire des tacos au poulet » ou encore « Des en-cas pour la semaine » en listes de courses modifiables. L’application génère une liste comprenant des produits disponibles à l’achat, leurs prix, des photos, des contrôles de quantité, ainsi que des boutons simples permettant de remplacer n’importe quel article et de passer commande. Pour les demandes liées aux restaurants, le système renvoie des établissements et des plats qui s’intègrent directement dans le flux d’achat natif. Ces deux fonctionnalités s’exécutent sur le même client et la même infrastructure de plateforme. Cet article se concentre sur le cas d’utilisation des courses alimentaires, car c’est celui qui met le plus à l’épreuve toutes les complexités majeures liées à la création d’une interface intuitive pour les achats pilotés par l’utilisateur. Les listes de courses contiennent généralement dix à vingt articles, font l’objet de plusieurs cycles de révision et doivent facilement tenir compte des contraintes des consommateurs, telles que le budget et les restrictions alimentaires.

Les sessions utilisateur de juillet 2026 ont montré que, lors des sessions consacrées à l’épicerie où une liste de courses était affichée, les consommateurs effectuaient en moyenne près de deux interactions avec l’interface utilisateur chacun. Environ un tiers de ces sessions aboutissaient à l’ajout de la liste au panier. L’assistant saisit l’intention générale des consommateurs et la synthétise. Le résultat se présente sous forme de composants natifs, qui permettent aux consommateurs d’affiner leur sélection de manière précise. Les modifications simples mettent immédiatement à jour un artefact de référence, tandis que les changements nécessitant un raisonnement déclenchent un nouveau tour de l’agent.

Afin d’offrir une expérience d’achat collaborative efficace entre le consommateur et l’agent, ces derniers doivent s’intégrer à une interface interactive s’appuyant sur des données commerciales en temps réel et sur le contexte actuel de l’application utilisée par le consommateur. Lorsqu’un consommateur effectue des achats dans une application, il s’attend à voir d’un seul coup d’œil des articles réels qu’il peut acheter. Le texte peut décrire cet environnement, mais ce sont les composants interactifs basés sur l’image qui permettent aux consommateurs de s’y déplacer concrètement. Le contexte a également son importance. Les consommateurs qui ouvrent DoorDash ont des attentes différentes de celles qu’ils ont vis-à-vis d’une application de chat polyvalente. Ils font leurs achats en parcourant les boutiques et les pages, plutôt qu’en décrivant ce qu’ils souhaitent. Les rencontrer là où ils se trouvent est une pièce essentielle du puzzle.

Les grandes choses ont souvent des débuts modestes

L’assistant d’épicerie de DoorDash a vu le jour dans le cadre d’un hackathon. Nous savions dès le départ que l’intégration des composants existants de DoorDash serait un élément clé de tout ce que nous allions développer. Les premières versions s’appuyaient largement sur des carrousels : d’abord une liste de magasins à proximité, puis un carrousel de résultats de recherche pour chaque article recherché par l’utilisateur. Ils s’affichaient en ligne, chacun accompagné de son terme de recherche. Le résultat ressemblait essentiellement à une transcription de discussion dans laquelle des résultats commerciaux avaient été collés.

D'un point de vue fonctionnel, cela ressemblait beaucoup à ce que nous proposons aujourd'hui. En termes d'expérience utilisateur, c'était moins abouti, et il est intéressant d'en examiner les détails.

Après avoir trouvé un ensemble de magasins, l’assistant demandait lequel explorer et attendait que la réponse soit saisie. Chaque carrousel représentait un article dont le consommateur avait besoin, et le fait de choisir une option y ajoutait cet article au panier. Chacun s’affichait avec ses options étalées sur toute la largeur de l’écran, le choix restant ouvert. Ainsi, préparer ses courses pour la semaine consistait à parcourir la liste une sélection à la fois, sans possibilité d’accepter un ensemble d’articles en une seule fois.

Derrière tout cela se cachait un défaut qui se manifestait dans les deux sens : l’interface avait été conçue avant tout pour présenter le travail de l’assistant. Chaque carrousel était précédé de la requête qui l’avait généré, et les résultats s’affichaient dans l’ordre où ils avaient été récupérés. Les termes de recherche et les ensembles de résultats bruts constituent la matière première d’un agent. Présenter directement les résultats revient, dans le contexte de l’interface, à afficher une trace de pile. L’assistant s’en remettait tout aussi volontiers à l’interface, traitant les éléments un par un, car l’écran ne pouvait afficher qu’une pile de carrousels, un par élément. Chacun avait été conçu en fonction des limites de l’autre plutôt qu’en fonction de l’utilisateur.

La leçon à retenir n’était pas que la réutilisation de composants existants était une erreur ; c’est justement grâce à leur caractère familier que l’assistant donne l’impression d’être DoorDash. Nous avions simplement créé un « conteneur » inadapté pour les accueillir. C’est ce conteneur qui détermine l’ordre dans lequel ils apparaissent, ce à côté de quoi ils sont placés, et ce qu’un consommateur peut en faire. Avant tout, un utilisateur a besoin d’une interface d’achat plutôt que d’une interface conversationnelle. Nous avions conçu une interface conversationnelle qui, par hasard, contenait des composants d’achat. La réutilisation des composants nous a fourni le vocabulaire. Les assembler pour former une interface d’achat était la partie la plus difficile.

Ce qui a survécu au hackathon, c'est la base : l'expérience repose aujourd'hui sur cette même infrastructure de streaming mise en place à l'époque. En revanche, la couche de décodage qui transformait les résultats des outils en interface utilisateur n’a pas perduré. L’assistant n’affiche désormais plus du tout les résultats des outils. À la place, nous avons consacré du temps à mettre en place une architecture d’artefacts qui sépare les besoins des utilisateurs de ceux liés au stockage et aux agents. En d’autres termes : nous avons cessé de décoder les données de travail de l’agent pour les afficher et avons commencé à construire le système autour des besoins des différents composants et utilisateurs du système.

Figure 1 : La même demande d'achats, à un an d'intervalle. La version développée lors du hackathon affichait un carrousel par article, chacun étant précédé de la requête qui l'avait généré ; le choix était laissé au consommateur. Aujourd'hui, l'assistant affiche chaque liste sous forme de carte dans la conversation, les articles les plus demandés étant déjà sélectionnés.

Un objet, trois objectifs

Une liste de courses compte trois lecteurs : le service qui la stocke, l'agent qui la modifie et la personne qui fait ses courses. Chacun d'entre eux doit voir des informations différentes. C'est en les séparant que les modifications apportées par le consommateur s'affichent immédiatement et restent définitives, sans nécessiter un nouveau cycle de traitement.

Le formulaire enregistré constitue la source de référence : il s'agit d'un blob JSON conservé en tant qu'artefact dans Managed Agent Services, comme décrit dans l'article consacré à la plateforme. Il doit être complet et constitue la seule copie faisant autorité.

L’agent ne lit pas directement ce bloc de données. Une liste de courses interactive contient bien plus de détails que ce dont un modèle a besoin pour la plupart des échanges suivants. Répéter à chaque tour de conversation le nom de chaque produit, son prix, sa quantité, ses substituts et toutes les métadonnées d’affichage viendrait faire double emploi avec ce que le consommateur a réellement demandé. Ainsi, lorsqu’un agent génère un widget, ce qui reste dans le contexte de la conversation est un résumé concis : le magasin et le contenu de la liste. Lorsqu’un tour de conversation nécessite l’état exact, l’agent lit l’artefact et renvoie une vue réduite dont les métadonnées d’affichage ont été supprimées. Cette vue est sans ambiguïté et suffisamment concise pour permettre un raisonnement peu coûteux. Une liste médiane occupe entre 40 et 60 Ko au format JSON. Ce qui reste dans le contexte de la conversation est une seule ligne d’environ 240 caractères, soit environ 250 fois plus petite.

Ce que voit le consommateur est encore différent, et cela prend plusieurs formes. Dans la conversation, la liste s’affiche sous la forme d’un widget compact : le magasin, le nom de la liste, l’heure d’arrivée estimée, quelques photos d’articles et un bouton « Ajouter au panier » indiquant le montant total estimé. Cela suffit pour évaluer la liste d’un seul coup d’œil sans quitter le chat. Un bouton « Voir la liste » ouvre la vue en pleine page, qui présente la liste complète et tout ce dont on a besoin pour la parcourir en détail. Les deux vues sont conçues pour être comprises immédiatement et permettre d’agir directement.

Un détail illustre à quel point ces points de vue divergent. Lorsque l’agent choisit un produit pour un article de la liste, il conserve les autres produits correspondant à la même recherche, et le consommateur peut passer de l’un à l’autre d’un simple geste. Il conserve dix candidats par article, et 99,7 % des articles présentent suffisamment de résultats pour remplir ce quota ; ainsi, presque chaque ligne affichée au consommateur comporte une sélection et neuf alternatives. La vue du consommateur affiche chacune de ces alternatives. La vue de l'agent n'en affiche aucune, car c'est au consommateur qu'il revient de faire son choix (à moins qu'on ne le demande explicitement à l'assistant).

Figure 2 : Une liste, trois points de vue. Le consommateur voit les prix, les photos et une option d’échange derrière chaque ligne. L’agent ne voit que le magasin et le contenu de la liste. L’artefact contient toutes ces informations, y compris neuf alternatives rien que pour les feuilles de lasagnes.

Garder les pieds sur terre

Dans le cas d’un panier contenant un yaourt à la framboise, en cliquant sur « Recommander des associations pour ce panier », deux suggestions s’affichent : du muesli, « car cela se marie bien avec votre yaourt », et des myrtilles, « pour ajouter des fruits à votre yaourt » (voir figure 3). Le cas de contraste existe déjà dans notre propre produit, sur le même écran : la page du panier comporte un carrousel d’articles complémentaires qui propose des articles qu’un consommateur pourrait souhaiter ajouter, sans aucune justification. Notre agent de panier aurait très bien pu renvoyer exactement cela : une liste d’articles plausibles. Les articles auraient très bien pu être les mêmes dans les deux cas. C’est la justification qui indique au consommateur que la suggestion est raisonnée plutôt que simplement plausible, et comme chaque widget est également un lieu d’action, cette distinction a une réelle utilité.

C’est ce qu’apporte l’ancrage : la différence entre une expérience d’achat captivante et une simple nouveauté. Si le résultat fourni par l’assistant n’est pas concret, les consommateurs n’ont guère de raison de délaisser l’expérience riche que l’application DoorDash leur offre déjà. Le texte continue de jouer un rôle, mais dans un second plan. Nous avons délibérément intégré la logique de l’assistant au sein des widgets et autour de ceux-ci, au lieu d’afficher les cellules d’éléments exactement comme elles apparaissent ailleurs dans l’application.

L'ancrage doit également s'appliquer au niveau des données, et c'est là que le travail est réparti. Un agent choisit un type de contenu pris en charge et fournit les données commerciales correspondantes ; le client iOS se charge de la présentation et de l'interaction, en mappant ce contenu sur les composants natifs du système de conception de DoorDash. Une demande d'épicerie génère une liste de courses modifiable avec les quantités, les substitutions et un sous-total. Une demande de restaurant peut générer des fiches de magasin, des fiches d'articles ou des suggestions de panier.

C’est cette séparation qui assure la fiabilité des données elles-mêmes. Les informations commerciales contenues dans un widget ne proviennent pas du modèle. Les prix, les stocks, les horaires d’ouverture et le contenu du panier sont extraits des mêmes systèmes de référence que ceux utilisés par le reste de l’application ; ainsi, un prix affiché dans Ask correspond au prix indiqué sur la page de la boutique à ce moment-là. Le contenu typé établit également un contrat stable entre le backend et le client. La prise en charge d’un nouveau widget ne se résume pas à une simple modification de l’invite. L’agent doit savoir quand l’utiliser et quoi y insérer, et le client a besoin d’un schéma nommé ainsi que du code permettant de le décoder et de l’afficher. Au-delà de cela, un nouveau widget parvient au consommateur via les mêmes mécanismes de conversation et de diffusion en continu que tous les autres.

Figure 3 : Deux types de suggestions concernant le même panier. Une seule d'entre elles explique pourquoi.

Les widgets en tant que canaux d'E/S

Chaque nouveau widget que nous avons intégré a renforcé le caractère fonctionnel de l’assistant. Cela tient autant aux données d’entrée qu’aux données de sortie. Une règle régit l’ensemble : une modification déterministe reste au niveau du client et s’applique directement à l’artefact, tandis qu’une modification nécessitant un jugement déclenche un tour d’agent. Les exemples ci-dessous s’articulent autour de cette distinction.

La version du hackathon demandait au consommateur quel magasin il souhaitait, puis attendait qu’il le saisisse. Elle n’avait aucun moyen de choisir elle-même ; aujourd’hui, ce choix est automatique. De nombreuses autres questions nécessitent encore l’intervention du consommateur, et la saisie directe de texte peut s’avérer peu efficace pour recueillir les réponses. La saisie de texte est une contrainte à thread unique : le consommateur connaît peut-être toutes les réponses, mais ne peut les fournir qu’à la vitesse à laquelle il tape ou parle.

C'est là que les widgets prennent tout leur sens. Un consommateur peut avoir dix opérations à effectuer sur une liste de courses, chacune d'entre elles étant simple. Prises individuellement, elles sont insignifiantes ; mais décrites en mots, elles constituent une tâche complexe. C'est la différence entre regarder par-dessus l'épaule de quelqu'un et lui dire sur quels boutons appuyer, et appuyer soi-même sur ces boutons.

Les questions de clarification structurées constituent l’exemple le plus évident, et ce modèle est emprunté aux agents de codage : l’outil AskUserQuestion de Claude Code remplit la même fonction pour les développeurs. Nous proposons un widget qui interrompt le consommateur avec une petite série de questions (à choix multiples et à sélection multiple), lui permettant ainsi d’orienter la conversation à des moments véritablement ouverts. Ce widget est devenu un pilier central du modèle d’interaction de l’agent dédié à l’épicerie, et il est désormais adopté par l’agent dédié à la restauration afin de simplifier ce même type d’échange. Nous l’intégrons à notre plateforme de mémoire client, qui réduit considérablement les choix possibles, mais il subsiste néanmoins des lacunes dans les connaissances qui nécessitent l’intervention du consommateur. Il est inévitable de poser des questions. Mais nous pouvons le faire d’une manière qui permette au consommateur de répondre facilement et efficacement.

C’est dans la vue en liste pleine page que la collaboration entre les entrées et les sorties prend tout son sens. Un consommateur peut modifier la quantité d’un article, supprimer un article, le remplacer par l’une des alternatives que l’assistant a trouvées à côté, et ajouter la liste finale à son panier. Chacune de ces actions manipule directement l’artefact. Aucune ne nécessite que l’assistant agisse au nom du consommateur, et aucune n’entraîne d’allers-retours avec le LLM. Le cas du remplacement permet de mieux exploiter les ensembles de candidats générés lors du hackathon. Les alternatives parmi lesquelles le consommateur fait son choix sont les autres candidats que l’assistant a récupérés lors de la sélection de l’article. La liste de toutes les options disponibles pour le consommateur remplissait auparavant un carrousel. Désormais, elles se trouvent à un simple clic de la décision, au lieu d’être dispersées devant le consommateur sous la forme d’une question ouverte.

Changer de magasin est l’exception, et c’est justement cette exception qui présente un intérêt particulier. Il ne s’agit pas d’une modification de la liste existante. Cela se transforme en une demande d’assistance qui génère une nouvelle liste pour l’autre magasin. Cette interaction est également rare : elle a constitué la première action dans 0,1 % des sessions engagées, ce qui correspond à peu près à ce à quoi on pourrait s’attendre si la limite était fixée à peu près au bon endroit. Si cette limite est mal placée, soit l’utilisateur attend que l’assistant fasse quelque chose qu’il aurait pu faire d’un simple geste, soit il effectue lui-même une série de gestes alors qu’il aurait pu bénéficier du jugement de l’assistant.

L'artefact garantit la sécurité de la séparation, et les deux parties y écrivent différemment. Une modification de quantité, une suppression ou un échange empruntent la voie rapide : le client met à jour la liste sur place et la modification apparaît immédiatement. Une modification de stockage déclenche en revanche un tour d'agent, car la liste entière doit être recoupée avec un catalogue différent. Une révision d'agent n'écrase pas ce qui s'y trouvait ; elle produit une nouvelle liste dérivée de la précédente.

Il en résulte qu'une modification directe fait autorité. Avant qu'un tour de parole ne modifie la liste, l'agent consulte la liste actuelle plutôt que de se baser sur la transcription ; ainsi, si le consommateur supprime le lait d'avoine, le tour de parole suivant commence à partir d'une liste ne comportant plus de lait d'avoine.

Le comportement observé sur cette même période permet de déterminer où se situe cette limite. Immédiatement après la première requête, près des trois quarts des premières actions suivantes ont été effectuées via un composant. À partir du deuxième message, la tendance s'inverse, et les actions de suivi saisies au clavier constituent la majorité à tous les niveaux de profondeur que nous avons mesurés. Les commandes absorbent les ajustements immédiats et structurés ; le langage prend le relais lorsque le changement est plus important ou plus difficile à exprimer par un simple clic.

Figure 4 : La liste à la limite d'un tour. Le consommateur retire les pommes directement dans la vue de la liste, sans aller-retour avec le modèle. Lorsque le magasin change de tour, l'agent lit l'artefact plutôt que la transcription ; ainsi, la liste qu'il reconstitue dans le nouveau magasin ne contient toujours pas ces pommes.

Chaque révision effectuée par un assistant reste active

Lorsque l'assistant modifie une liste de courses, la version qu'il remplace reste affichée à l'écran et reste utilisable.

Ce n'était pas notre première implémentation. La première version masquait les listes obsolètes : dès qu'une révision était publiée, la liste qu'elle remplaçait ne pouvait plus être consultée ni modifiée. Une seule liste active, sans encombrement. Cela semblait être un comportement plus ordonné. En réalité, cela donnait l'impression que les révisions avaient un coût élevé. Si le fait de demander une modification risquait d'effacer une liste qui vous convenait, la solution la plus sûre était de cesser de demander, ce qui allait à l'encontre de l'intérêt même d'un processus collaboratif.

Ainsi, chaque modification apportée par un assistant génère désormais un nouvel élément dérivé du précédent, et chacun reste à l'endroit où il a été créé dans la conversation. Il suffit de remonter dans l'historique pour retrouver toutes les versions antérieures, toujours accessibles : un consommateur peut ouvrir une liste antérieure, la modifier ou l'ajouter à son panier à la place de la dernière version. Demander une modification ne coûte rien, car ce qu'il avait il y a un instant est accessible d'un simple glissement de doigt.

Toutes les listes créées par l’assistant ne deviennent pas forcément des versions visibles par le consommateur. Lorsqu’il établit une liste de propositions et conclut que le magasin ne dispose pas des articles demandés, cette liste n’est jamais affichée. Le consommateur est informé par un message écrit que certains articles manquaient en magasin et qu’une nouvelle liste est en cours de préparation. C’est l’un des rares cas où le texte remplit directement cette fonction, et c’est là la raison qui sous-tend tout le reste de cet article : l’interaction sert à simplifier, tandis que le texte sert à justifier.

Quand une liste se transforme en panier

Un assistant qui modifie directement le panier peut supprimer un article que le client souhaitait acheter ou en ajouter un qu'il n'a jamais confirmé, sans même lui demander son avis. Une seule erreur de ce genre suffit à perdre la confiance du client, car cette erreur passe inaperçue et concerne précisément l'article qu'il s'apprête à payer.

Nous proposons donc à la place une « liste de courses ». Celle-ci peut contenir des dizaines d'articles et faire l'objet de plusieurs itérations : qu'il s'agisse de supprimer un produit que le consommateur possède déjà, de modifier une quantité, de remplacer un produit ou de réadapter une partie d'une recette, aucune de ces modifications n'affecte le panier. Pour valider la liste, il faut cliquer explicitement sur « Ajouter au panier » : c'est la structure la plus simple que nous ayons trouvée pour donner au consommateur un réel contrôle sans qu'il ait à superviser chaque étape.

Il faut encore faire le rapprochement entre ces deux éléments, et la question intéressante est de savoir qui s’en charge. L’assistant analyse le contenu du panier tout en établissant la liste, mais il ne modifie pas automatiquement cette dernière pour l’aligner : si une recette nécessite deux bananes, la liste en demande deux, qu’il y en ait déjà quatre dans le panier ou non. Établir la liste en fonction de ce qui a été demandé exactement, puis la faire correspondre avec le contenu du panier lors d’une étape distincte, permet de regrouper toutes les décisions au même endroit.

Cette étape intervient au moment de la validation. Lorsque la liste et le panier se recoupent, le consommateur voit s'afficher les doublons et choisit soit de remplacer ces quantités, soit de les ajouter. C'est un petit moment, mais ce sont justement ces petits moments qui font que l'on gagne ou que l'on perd la confiance.

Prise en compte du contexte dans l’ensemble de DoorDash

Il ne suffit pas que l’assistant soit présent à un seul endroit ; il doit être accessible depuis n’importe où dans l’application. Le fait d’ouvrir l’assistant est déjà un signal fort d’intention, mais qui reste ambigu. À ce moment-là, un consommateur peut être en train de passer commande auprès de son restaurant préféré, de faire ses courses pour la semaine, de chercher une nouvelle paire d’écouteurs ou de demander de l’aide concernant une commande passée. Un consommateur qui s’est rendu sur la page d’une épicerie en particulier envoie un signal beaucoup plus précis : il est probable qu’il ait l’intention de remplir son panier dans ce magasin. C’est en transmettant ce contexte à l’assistant que celui-ci peut se concentrer sur l’intention probable au lieu de poser des questions.

Le système de portée que nous avons conçu à cet effet couvre à la fois le client et la passerelle. Le client associe à chaque requête des éléments clés du contexte de la demande : la catégorie sous laquelle l'utilisateur s'est connecté (épicerie, restaurant), le magasin qu'il consulte, ainsi que quelques identifiants associés. La passerelle utilise la catégorie pour déterminer vers quel agent acheminer la requête, et les autres éléments pour fournir aux outils les identifiants dont ils ont besoin.

Scope est délibérément conçu comme un ensemble plat de paires clé-valeur plutôt que comme un schéma typé, et c’est le client qui décide de son contenu. Les clés non reconnues sont transmises telles quelles au lieu d’être rejetées, ce qui permet à une nouvelle interface de commencer à envoyer du contexte sans attendre une modification de la passerelle. La seule exception concerne le sujet lui-même : en ajouter un nouveau implique d’indiquer à la passerelle vers quel agent elle doit l’acheminer. Ainsi, si la création d’une nouvelle interface est peu coûteuse, celle d’un nouveau domaine ne l’est pas.

Le sujet correspond également à la partie qui s’applique uniquement au premier message d’un contexte. Cela donne à l’assistant une base solide sur laquelle s’appuyer sans être trop contraignant, et c’est ce qui permet aux utilisateurs de sortir d’un contexte lorsqu’ils en font le choix explicite. Un utilisateur qui utilise l’assistant dans un restaurant peut quitter complètement le contexte du restaurant en lui demandant : « Trouve-moi une recette pour ce plat et prépare-moi une liste de courses pour que je puisse le préparer chez moi. » Cette demande a un coût, mais celui-ci se traduit par un simple détournement du parcours plutôt que par une impasse : l’agent « restaurant » doit reconnaître que la demande sort de son domaine de compétence et la renvoyer avant qu’un autre agent ne la reprenne.

Dans certains cas, les scopes peuvent également nous permettre de contourner complètement le modèle. Prenons l’exemple du point d’entrée « Repasser la commande de mon dernier panier ». On pourrait simplement envoyer cette phrase à l’assistant sous forme de message, et bien que cela fonctionne, l’ajout d’un scope nous permet d’être plus précis. Le cas « repasser la commande » est en effet déterministe ; nous pouvons donc contourner le LLM et renvoyer une liste de courses presque immédiatement. Ce que l’on obtient en retour est un widget de liste de courses classique : le consommateur peut modifier les quantités, échanger des produits ou demander à l’assistant de la réviser dans le chat, exactement comme il le ferait avec n’importe quelle autre liste. Notez que ce contournement ne fonctionne que si le magasin dispose encore de tous les articles du panier précédent ; si un article n’est pas disponible, la demande est transmise à l’agent chargé des courses, qui reconstitue la liste de la même manière que s’il s’agissait d’une demande saisie manuellement.

La gestion de la portée est également ce qui permet d'avoir une conversation unique et continue tout au long d'une session d'application, mais cela ne fonctionne que parce que la portée, l'association à un agent et l'état de la session sont maintenus séparés. Nous considérons la portée comme un contexte propre à chaque tour de parole. L’association, décrite précédemment dans cette série d’articles, permet de maintenir les tours de parole suivants avec l’agent qui a résolu le tour précédent. L’association et la transcription (la conversation proprement dite) sont toutes deux associées à la conversation plutôt qu’à la portée ; ainsi, un client passant d’un magasin à un autre peut réorienter l’association vers un nouvel agent de domaine sans perdre le fil de la conversation. Plusieurs agents se spécialisent en arrière-plan, et l’ensemble continue de se comporter comme un seul et même assistant.

Figure 5 : Une même conversation, lancée depuis deux endroits différents. La portée suit chaque requête ; ainsi, une requête effectuée depuis Safeway alimente la liste de Safeway.

Conclusion

L'intégration des agents dans les produits grand public n'en est encore qu'à ses débuts. Cependant, les fondements commencent à se dessiner clairement. Les widgets constituent l'espace où les consommateurs effectuent leurs tâches, tandis que la conversation entre le consommateur et l'agent sert à les guider. Il existe actuellement trois « lecteurs » de notre artefact « liste de courses », chacun ayant besoin d'une vue différente de celle-ci. Nous utilisons la partie visible par l’utilisateur pour ancrer le consommateur dans des produits réels et pour permettre d’effectuer des modifications courantes d’un simple clic. À mesure que les agents prennent en charge une plus grande partie du travail, nous nous attendons à ce que ce que le consommateur doit voir et ce sur quoi l’agent doit raisonner continuent d’évoluer, et la frontière entre une interface d’application et une interface de chat deviendra de plus en plus difficile à tracer.

La plateforme d’expérimentation de DoorDash gère plus de 60 000 « feature flags » répartis dans environ 623 dépôts. Nous avons identifié plus d’un millier de « feature flags » obsolètes ; en d’autres termes, la fonctionnalité qu’ils contrôlaient autrefois est désormais pleinement déployée, mais le « flag » et sa logique de branchement restent présents dans le code, où ils ne servent plus à rien. Le nettoyage manuel d’un seul de ces « feature flags » prend entre une et deux heures à un ingénieur. Avec environ 2 300 nouveaux « flags » créés chaque mois, le retard ne fait que s’accumuler.

Nous avons donc mis au point un système LLM multi-agents qui traite de bout en bout les signalements obsolètes, depuis un ticket Jira jusqu’à une pull request (PR) prête à être fusionnée, sans aucune intervention humaine, à l’exception d’un ingénieur chargé de confirmer la valeur cible et la validation de la PR. Sur les 50 indicateurs obsolètes les plus récents qu’il a traités, le système a généré des PR exploitables pour 45 d’entre eux, à un coût moyen de 4,79 $ et en 13,8 minutes par indicateur, permettant ainsi d’économiser d’innombrables heures de travail d’ingénierie. Le système que nous avons développé devait non seulement être efficace, mais sa fiabilité devait reposer sur l’exhaustivité plutôt que sur l’exactitude ; en cas d’échec de l’agent, celui-ci devait échouer en toute sécurité, sans apporter de modifications au code susceptibles de provoquer des dysfonctionnements.

Cet article explique pourquoi les outils prêts à l'emploi ne permettaient pas d'atteindre cet objectif dans notre base de code, comment nous avons conçu le système et les enseignements que nous avons tirés lors de son déploiement. Remarque : cet article a fait l'objet d'une évaluation par les pairs et a été accepté dans le cadre du volet « industrie » de la conférence ICSME 2026.

Pourquoi il vaut mieux automatiser la suppression des « feature flags » obsolètes

Les « feature flags » constituent un pilier de la mise en production moderne des logiciels. Ils nous permettent de déployer des fonctionnalités progressivement, de mener des tests A/B et d’activer des « kill switches » en cas de problème. Mais chaque « feature flag » a un cycle de vie, et une fois qu’une fonctionnalité est entièrement déployée, son « feature flag » devient obsolète. Les « feature flags » obsolètes sont souvent considérés comme une dette technique, car le temps d’un ingénieur a plus de valeur lorsqu’il est consacré au développement de nouvelles fonctionnalités plutôt qu’à leur nettoyage. 

Sa logique conditionnelle n'a plus aucune utilité, mais elle ne reste pas pour autant inoffensive :

  • Les « feature flags » obsolètes peuvent rester dans le code pendant des années. Des études antérieures ont montré qu'environ 25 % des « feature flags » persistent pendant plus de huit ans dans les projets open source ; les professionnels du secteur signalent régulièrement que leur suppression est fastidieuse et qu'elle est sans cesse reportée.
  • Un indicateur obsolète constitue une dette technique. Chaque indicateur obsolète ajoute une branche, un cas limite et un peu plus de texte à lire et à analyser, ce qui peut s’avérer particulièrement pénible en cas d’incident.
  • Les indicateurs obsolètes peuvent constituer un risque opérationnel. Un indicateur obsolète maintient actif un chemin d'exécution inactif qui peut être réactivé par accident. Dans un cas bien documenté, une société de courtage a réutilisé un indicateur obsolète lors d'un déploiement, ce qui a déclenché pour 460 millions de dollars de transactions non intentionnelles en seulement 45 minutes.

Si l'on multiplie ces dizaines de milliers de drapeaux par un taux de création mensuel à quatre chiffres, il apparaît clairement que le nettoyage manuel ne peut tout simplement pas suivre le rythme. Éliminer manuellement notre arriéré d'anciennes données nécessiterait des milliers d'heures de travail d'ingénierie qui seraient mieux employées à développer de nouvelles fonctionnalités.

Valeurs dynamiques

Chez DoorDash, les « feature flags » sont appelés « valeurs dynamiques » (DV). Ils s'appuient sur notre plateforme d'expérimentation. Dans cet article, le terme « DV » est synonyme de « feature flag ».

Le cycle de vie d'un DV suit le schéma suivant : création → expérimentation → déploiement → obsolescence → suppression. Nous considérons qu'un DV est obsolète lorsqu'il répond à l'ensemble des critères suivants :

  1. Il n'a pas été modifié depuis 90 jours.
  2. Il est toujours référencé dans le code.
  3. Il n'est pas encore en fin de vie (archivé ou retiré).
  4. Il ne figure pas sur la liste des exclusions.

Une tâche cron quotidienne crée un ticket Jira « STALEDV » pour chaque DV obsolète identifié et l'attribue à son créateur. Cela marque le début de la file d'attente à partir de laquelle notre système de nettoyage opère.

Flux de travail agentique vs outils de nettoyage basés sur l'AST

L'approche automatisée la plus connue pour le nettoyage des indicateurs est Piranha et son successeur polyglotte, qui simplifient les conditions dépendantes d'indicateurs en effectuant une correspondance de motifs dans l'arbre de syntaxe abstraite (AST). Cela fonctionne bien lorsqu'un indicateur est lu via un appel direct à l'API, ce qui permet à une règle de réécriture d'effectuer une correspondance de motifs.

Mais ce n’est pas ainsi que l’on accède aux DV chez DoorDash. Nos services utilisent un modèle de wrapper à trois couches avec injection de dépendances :

// Layer 1: RuntimeKeys.kt – the DV name as a string constant
object RuntimeKeys {
  const val ENABLE_X = “enable_feature_x”
}

// Layer 2: FeatureFlags.kt – a DI wrapper that calls the DV client
@Singleton
class FeatureFlags @Inject constructor(
    private val dvClient: DynamicValuesClient
) {
  fun shouldEnableX(userId: String): Boolean =
    dvClient.getBoolean(ENABLE_X, withContext(“user_id” to userId), false)
}

// Layer 3: business logic – uses the flag via dependency injection
class MyService @Inject constructor(
    private val featureFlags: FeatureFlags
) {
  fun process(userId: String) {
    if (featureFlags.shouldEnableX(userId)) handleNewPath()
    else handleOldPath()
  }
}

Il s'agit là d'une séparation claire des préoccupations, mais cela signifie que le nom du DV, l'appel d'API et la logique conditionnelle se trouvent chacun dans un fichier différent, reliés uniquement par des appels de méthode et l'injection de dépendances. Il s'agit là de relations sémantiques, et non syntaxiques ; les comparateurs de motifs AST ne peuvent pas les suivre. 

Détermination de la valeur cible

Il existe un autre problème qu’un outil fonctionnant uniquement à partir du code source ne peut pas résoudre : la détermination de la valeur cible et la consultation en temps réel de l’état de déploiement. Un outil qui se contente de lire le code source pourrait, sans s’en rendre compte, coder en dur une valeur erronée et modifier le comportement de l’application sans le signaler. Pour s’assurer que l’outil effectue correctement le nettoyage du code, il est nécessaire de connaître l’état de déploiement en temps réel du drapeau de fonctionnalité, qui réside dans la plateforme d’expérimentation et non dans le dépôt. Par exemple, la plateforme d’expérimentation de DoorDash prend en charge l’utilisation de drapeaux de fonctionnalité de type entier, chaîne de caractères et JSON. Une lecture en temps réel de la valeur cible garantit que l’outil modifie le code avec la valeur correcte du drapeau de fonctionnalité, qui reflète l’état actuel du système. De même, les informations relatives au déploiement constituent également un élément important de l’équation. Une expérimentation peut avoir été déployée à 60 %, puis abandonnée. L’outil devrait disposer de l’intelligence nécessaire pour déterminer qu’il s’agit d’un déploiement partiel et demander confirmation à l’utilisateur avant d’effectuer tout nettoyage. Cela peut soit inciter l’utilisateur à achever le déploiement ou la restauration avant d’utiliser l’outil pour effectuer le nettoyage, soit l’inviter à ignorer le nettoyage pour le moment.

Ampleur et complexité

Enfin, même une simple variable de données booléenne peut concerner entre cinq et vingt fichiers, une fois pris en compte la constante, le wrapper, chaque point d’appel, ainsi que la mise à jour ou la suppression des tests concernés. C’est un travail qui nécessite de comprendre le code, et pas seulement de faire correspondre la syntaxe. C’est exactement pour cette raison que nous avons choisi d’utiliser des agents LLM. Mais la tâche ne se résumait pas à rédiger une instruction et à demander à l’agent d’effectuer le nettoyage ; cela n’aurait pas permis d’obtenir un nettoyage efficace en termes de coûts et de temps, avec des garde-fous à grande échelle.

Un pipeline en deux phases avec intervention humaine

Le système repose sur l'Agent Development Kit (ADK) de Google et se déroule en deux phases, séparées par un seul contrôle manuel, comme le montre la figure 1.

Figure 1 : Architecture du système. Un agent d’orchestration exécute l’analyse de la phase 1, récupère les DV obsolètes depuis Jira, interroge la plateforme d’expérimentation sur l’état du déploiement via le protocole MCP (Model Context Protocol) et effectue une recherche dans la base de code ; un ingénieur vérifie ensuite le rapport. La phase 2 lance alors des agents de nettoyage en parallèle dans des arborescences Git isolées, qui modifient le code, le testent, vérifient la couverture de test et effectuent une analyse syntaxique avant d’ouvrir une pull request.

Phase 1 : Analyse et rapport

Un agent orchestrateur, en l'occurrence Claude Sonnet, traite les requêtes concernant les DV périmées. Pour chaque DV, il :

  1. Récupère les tickets Jira DV périmés via l'outil en ligne de commande d'Atlassian.
  2. Interroge la plateforme d'expérimentation de DoorDash via le protocole MCP (Model Context Protocol) pour obtenir les métadonnées de la variable dépendante (DV) : son UUID, son pourcentage de déploiement et sa valeur cible.
  3. Détecte le référentiel local et recherche toutes les références au code relatives au DV.
  4. Génère un rapport structuré proposant une valeur cible et répertoriant les fichiers concernés pour chaque DV.

Cette intégration MCP est le héros méconnu de la conception. En analysant l'état actuel du déploiement en production, l'agent détermine la valeur cible correcte au lieu de se fier à des suppositions issues du code. Par exemple, une variable de données (DV) introduite pour une fonctionnalité qui a finalement été abandonnée affiche un taux de déploiement de 0 % sur la plateforme ; l'agent sait donc qu'il doit la supprimer en utilisant la valeur de référence, plutôt que de supposer que la fonctionnalité est activée.

Point de contrôle humain

Avant toute modification du code, un ingénieur examine le rapport et valide la valeur cible de chaque DV. Il s’agit d’un mécanisme de sécurité délibéré destiné aux cas ambigus, tels que les déploiements partiels ou les expériences abandonnées, où la réponse correcte nécessite un jugement humain. Par exemple, une expérience peut avoir été déployée à 60 %, puis abandonnée. Ce contrôle humain permet à l’utilisateur d’intervenir en décidant, par exemple, s’il convient de terminer le déploiement ou de revenir en arrière avant que le nettoyage ne soit effectué.

Phase 2 : Nettoyage en parallèle

Pour chaque DV confirmé, l'orchestrateur lance un agent de suppression dédié — Claude Opus —, chacun s'exécutant dans son propre arborescence Git isolée. Jusqu'à quatre agents s'exécutent simultanément par dépôt, ce paramètre étant configurable. Chacun d'entre eux effectue un nettoyage complet et ouvre une pull request attribuée au propriétaire du DV.

À l'intérieur d'un agent de délogement

Chaque agent de suppression exécute un flux de travail itératif comme suit :

  1. Rechercher toutes les occurrences de la variable DV, y compris la constante, la fonction d'encapsulation et chaque point d'appel.
  2. Définissez une stratégie de nettoyage en fonction du type de la variable dynamique (booléenne, entière ou chaîne de caractères) et de son utilisation.
  3. Appliquez les modifications ; remplacez les appels à la fonction wrapper par la valeur cible et simplifiez les conditions qui sont désormais constantes.
  4. Supprimez la fonction d'encapsulation, la définition et la constante.
  5. Mettez à jour ou supprimez les tests concernés, par exemple en supprimant les branches de test « désactivées ».
  6. Vérifiez que la compilation s'effectue correctement.
  7. Vérifiez que les tests sont réussis.
  8. Vérifiez que le taux de couverture des correctifs est d'au moins 95 % sur les lignes modifiées.
  9. Lancez le linter Detekt.
  10. Si une validation échoue, identifiez le problème, corrigez-le, puis réessayez.

L'autonomie sur une base de code ne fonctionne que si les garde-fous sont réels. Quatre mécanismes assurent la sécurité des agents :

  • Isolation de l'arborescence de travail Git : chaque agent travaille dans une arborescence de travail dédiée, ce qui évite tout chevauchement entre les agents simultanés ; en cas d'échec du nettoyage, il suffit de supprimer l'arborescence de travail pour effacer les données.
  • Un délai d'expiration fixe d'une heure par agent : cela permet d'éviter qu'une session bloquée ne s'éternise.
  • Validation de la couverture des correctifs JaCoCo: cette règle impose une couverture de test d'au moins 95 % sur les lignes modifiées par l'agent.
  • Analyse statique Detekt: elle garantit le respect des conventions de style et détecte les problèmes courants.

Nous exécutons également Gradle avec l'option –no-daemon afin d'éviter toute contamination de l'état entre les arborescences de travail lors des exécutions parallèles. Il est essentiel de noter qu'un agent n'est pas autorisé à ouvrir une demande de pull tant que les tests et l'analyse statique n'ont pas été validés localement.

Résultats

Mettre en place un système est une chose, mais une seule question compte lorsqu’il fonctionne à l’échelle de DoorDash : est-ce qu’il fonctionne bien ? Dans ce cas précis, très bien, en effet.  Sur les 50 derniers signalements de code obsolète traités par le système, celui-ci a généré une pull request prête à être fusionnée pour 45 d’entre eux, à un coût moyen de 4,79 $ et en 13,8 minutes par opération de nettoyage, au lieu des une à deux heures qu’aurait nécessité un nettoyage manuel. Le système n’a introduit aucun bug ni aucune régression au cours du processus.

Comment nous l'avons évalué

Nous avons évalué le système sur les 50 DV obsolètes les plus récents qu'il a traités dans plusieurs dépôts Kotlin. Nous avons classé chacun d'entre eux selon leur niveau de complexité : 

  • C'est simple : une seule vérification booléenne dans un ou deux fichiers ; n = 6
  • Moyen — Utilisations multiples sur trois à cinq fichiers avec quelques modifications à titre d'essai ; n = 18
  • Complexe — conditions imbriquées, dépendances entre fichiers, types non booléens ou mises à jour importantes des tests ; n = 26 

Par type, 41 étaient de type booléen, six de type chaîne de caractères et trois de type entier/long. Chaque PR a été évaluée selon trois critères : la réussite des tests d'intégration (y compris le seuil de couverture de 95 % des correctifs), l'exactitude du code et l'avis des développeurs. 

Résultats en fonction du degré de complexité

Figure 2 : Résultats du nettoyage en fonction du niveau de complexité. Les variables dépendantes simples sont acceptées à 100 % dès le premier essai ; celles de complexité moyenne atteignent un taux de nettoyage de 94 % ; les variables dépendantes complexes nécessitent davantage de révisions et enregistrent davantage d'échecs, mais atteignent tout de même un taux de 85 %.

Comme le montre la figure 2, 31 des 50 opérations de nettoyage ont été menées à bien dès le premier essai, 14 ont nécessité une révision mineure et cinq ont nécessité l'intervention d'un ingénieur. La répartition par niveau de complexité met en évidence les limites de fiabilité du système :

  • DV simples : nettoyées à 100 % en un seul passage.
  • DV moyennes : 94 % (17/18) : 14 ont été réalisées en une seule fois, trois après une révision et une a nécessité l'intervention d'un ingénieur.
  • DV complexes : 85 % (22/26), même avec une suppression en cascade des paramètres sur plus de cinq couches de méthodes, des conditions imbriquées et une refactorisation intensive des tests.

Les 14 révisions étaient mineures et se corrigeaient d’elles-mêmes ; six d’entre elles présentaient une couverture insuffisante du correctif, nécessitant une itération supplémentaire pour ajouter des tests, et huit concernaient une suppression incomplète de code mort, avec une variable ou une référence résiduelle enfouie au cœur d’une chaîne d’appels. Toutefois, toutes ont été corrigées en une seule nouvelle requête adressée au LLM.

La conclusion la plus importante concernait la nature des problèmes rencontrés. Sur l’ensemble des 50 PR générés, nous n’avons observé aucun bug ni aucune régression introduits par le code modifié. Chacun des cinq cas nécessitant une intervention s'expliquait par la profondeur de la chaîne d'appels avec un enchaînement de paramètres entre interfaces ; l'agent a correctement supprimé la majeure partie du code mort, mais a manqué un ou deux maillons dans une longue chaîne impliquant plusieurs fichiers. En d'autres termes, la limite de fiabilité du système réside dans l'exhaustivité et non dans l'exactitude, ce qui atténue les craintes selon lesquelles le système pourrait créer des problèmes plus importants en cas d'échec.

Coût et durée

Les coûts et les délais varient en fonction de la complexité, mais restent clairement dans le cadre d’une « mise en œuvre à grande échelle », comme le montrent le tableau 1 et la figure 3. 

Le tableau 1 présente la répartition des indicateurs de performance moyens et médians, notamment en termes de temps et de coût, pour les 50 « feature flags » analysés, classés en fonction de leur complexité. Ces données montrent que, même si les « feature flags » plus complexes nécessitent naturellement davantage de temps et de budget, le système reste très efficace, même pour les tâches de nettoyage les plus difficiles.

ComplexiténDurée moyenneDurée médianeCoût moyenCoût médian
Simple67,5 min8,2 min$2.69$2.50
Moyen1810,4 min9,9 min$3.46$3.42
Complexe2617,7 min14,4 min$6.20$4.50

Tableau 1 : Indicateurs de performance par niveau de complexité pour les 50 « feature flags » évalués.

Figure 3 : Coût de l'API par rapport au temps réel pour chaque DV, classés par couleur en fonction de leur complexité. Les DV simples et moyennes se regroupent dans la zone à faible coût et à faible durée d'exécution. Les DV complexes sont plus dispersées, avec quelques valeurs aberrantes approchant les 40 minutes et les 19 $. Les DV ayant échoué (×) ont tendance à présenter des durées d'exécution plus longues.

Comme l’illustre la figure 3, les DV simples et moyennes se regroupent étroitement dans le coin « bon marché et rapide ». Les DV complexes sont plus dispersées, avec quelques valeurs aberrantes atteignant environ 40 minutes et environ 19 dollars. Même dans le haut de cette fourchette, l’agent permet une réduction spectaculaire de l’effort d’ingénierie et une baisse des coûts, même par rapport à une estimation prudente d’une heure nécessaire pour supprimer manuellement une seule DV.

Ce que nous avons appris

  • La spécialisation des modèles par rôle s'avère payante. Nous utilisons Claude Sonnet pour l'orchestration, notamment pour la prise en compte du contexte global, la collecte de métadonnées légères et la planification, et Claude Opus pour les agents de suppression, notamment pour le raisonnement approfondi sur la sémantique du code, les chaînes d'appels et les dépendances de test. Le fait de réserver le modèle le plus coûteux à la phase d'édition, qui est très exigeante sur le plan cognitif, nous a permis de réduire le coût global de notre API sans nuire à la qualité du nettoyage.
  • L'isolation de l'arborescence de travail est indispensable pour les agents parallèles. Nos premières expériences, menées sans isolation de l'arborescence de travail, ont donné lieu à des conditions de concurrence dans lesquelles des agents simultanés modifiaient les mêmes fichiers, générant ainsi des différences corrompues. Une arborescence de travail dédiée par agent, associée à Gradle avec l'option –no-daemon, a permis de sécuriser le nettoyage parallèle et de rendre les échecs isolés.
  • L'intégration de l'expérimentation en temps réel a été la décision la plus déterminante. Sans l'état actuel du déploiement, toute approche automatisée — qu'elle soit basée sur des règles ou sur un modèle de langage grand (LLM) — risque de coder en dur une valeur erronée et de perpétuer discrètement un comportement incorrect. La lecture via MCP n'a ajouté qu'une latence négligeable et a éliminé toute une catégorie d'erreurs liées aux valeurs cibles.

Toute équipe envisageant une automatisation similaire doit garder à l'esprit que nos résultats mettent en évidence trois conditions préalables concrètes : 

  • Une source fiable d'informations sur l'État du pavillon des navires en service
  • Isolation de l'arborescence de travail pour les modifications en parallèle, et 
  • Des étapes de validation déterministes avant même l'ouverture d'un ticket PR.

Prochaines étapes

Nous étendons le système selon deux axes :

  1. Un score de confiance de phase 1 permettant d'approuver automatiquement les corrections à faible risque. Par exemple, une variable dépendante booléenne dont le déploiement est à 100 % et dont le code par défaut correspond déjà à celui de l'environnement de production, ce qui permet de réserver le contrôle humain aux cas réellement ambigus.
  2. Une vérification de la qualité du code après le nettoyage. Cela permettrait de détecter des problèmes sémantiques, tels que des noms de variables qui ne reflètent plus leur fonction une fois qu'un indicateur a été supprimé.

Le nettoyage des « feature flags » est le genre de tâche qui, prise individuellement, est minime, mais qui, prise dans son ensemble, représente un travail colossal, en particulier à l’échelle de DoorDash, et qui est sans cesse reportée. En combinant un orchestrateur, des agents de suppression parallèles dans des arborescences de travail isolées, des requêtes en temps réel sur la plateforme d’expérimentation et des contrôles de validation stricts, notre système de nettoyage des feature flags transforme un retard accumulé de plusieurs milliers d’heures en un processus d’arrière-plan peu coûteux et fiable qui génère des pull requests prêtes à être fusionnées pour 90 % des flags traités, à un coût d’environ 4,79 $ et 14 minutes par flag, sans aucune régression. La seule limite restante concerne l’exhaustivité des chaînes d’appels les plus profondes, et c’est précisément là-dessus que nous allons concentrer nos efforts prochainement.

Vous souhaitez développer des systèmes comme celui-ci ? L'équipe d'ingénierie de DoorDash recrute : venez nous aider à développer nos solutions à grande échelle.

Flux est la plateforme d’agents basée sur le cloud de DoorDash destinée aux ingénieurs. En un seul mois de 2026, nous avons utilisé Flux pour automatiser 130 000 tâches d’ingénierie. Connaissant une expansion rapide depuis son lancement au premier trimestre 2026, Flux prend déjà en charge des flux de travail en arrière-plan à haut volume au sein de DoorDash, notamment plus de 25 000 revues de code automatisées chaque semaine, ainsi que plus de 300 playbooks uniques et plus de 10 000 invocations utilisées chaque semaine. Ces flux de travail peuvent s'exécuter de manière autonome, en parallèle et 24 heures sur 24.

Dans cet article de blog, nous allons passer en revue les contraintes qui nous ont poussés à aller au-delà des charges de travail des agents locaux exécutés sur des ordinateurs portables, expliquer pourquoi nous avons choisi de développer Flux en interne plutôt que de nous appuyer uniquement sur des agents de codage hébergés, et présenter les éléments fondamentaux de la plateforme, tels que les environnements de test des agents, la passerelle MCP, les playbooks et les interfaces d’invocation, qui permettent de rendre la délégation des agents reproductible et sécurisée.

Cas d'utilisation du workflow de fond de Flux

Tableau 1 : Aperçu de l'utilisation de Flux au sein de DoorDash sur un mois, couvrant les revues de code automatisées, l'exécution des playbooks et la réalisation des tâches en arrière-plan

Nos débuts

Au cours de l'année écoulée, les utilisateurs exécutant des charges de travail de type « agentic » sur leurs ordinateurs portables se sont rapidement heurtés à certaines limites :

  • Ressources et disponibilité. Un ordinateur portable dispose d’un nombre fixe de cœurs de processeur, d’une mémoire limitée et d’une batterie, tous ces éléments étant partagés avec toutes les applications installées. Les workflows d’Agentic doivent souvent exécuter en parallèle des tâches gourmandes en ressources de calcul, telles que des compilations, des tests et des recherches à grande échelle, ce qui épuise rapidement les capacités des ordinateurs portables. Les workflows dépendent également du fait que l’appareil soit allumé, connecté et disponible ; le travail s’interrompt lorsqu’un ingénieur ferme son ordinateur portable, perd la connexion ou s’absente.
  • Contrôles de sécurité. Les ordinateurs portables disposent généralement d’un large accès à des identifiants et systèmes sensibles, notamment des clés SSH, des sessions VPN et des outils nécessitant une authentification. Accorder à un agent autonome ce même niveau d’accès engendre un risque inutile et un champ d’impact potentiellement important. Les environnements locaux compliquent également la définition précise de ce à quoi un agent peut accéder et pendant combien de temps.
  • Visibilité et traçabilité. Lorsque les charges de travail s'exécutent sur des ordinateurs portables individuels, leur exécution est fragmentée et difficile à surveiller. Il devient alors plus compliqué de savoir ce qui s'exécute, où cela s'exécute, pour le compte de qui, et quels systèmes ou fichiers ont été concernés.

Notre approche pour résoudre ces problèmes est simple : 

Confier des tâches à des agents de codage autonomes et sécurisés afin que les ingénieurs puissent consacrer davantage d'énergie à l'innovation, à la réflexion critique et à la résolution de problèmes complexes.

Pourquoi nous avons développé Flux en interne

Les agents de codage hébergés sont utiles, mais ils imposent un compromis difficile : soit envoyer du code sensible et le contexte d’exécution à un tiers, soit ouvrir une voie permettant à ce tiers d’accéder aux systèmes internes. Pour DoorDash, le plus grand défi ne consistait pas simplement à faire en sorte qu’un agent écrive du code ; ce problème est en grande partie résolu. Il s’agissait plutôt de fournir à cet agent l’environnement, les outils, les autorisations, les intégrations et les contraintes appropriés.

Notre stratégie consiste à contrôler les éléments fondamentaux qui entourent l'agent, notamment l'orchestration, les environnements de test, les workflows, les autorisations, les intégrations, ainsi que les agents contextuels spécifiques à DoorDash nécessaires à un fonctionnement efficace. Nous avons également conçu ces éléments fondamentaux de manière modulaire, ce qui nous offre la flexibilité d'utiliser le meilleur outil tiers pour chaque tâche ou de développer en interne lorsque des exigences plus poussées en matière de sécurité, d'intégration, de performances ou de maîtrise de l'expérience utilisateur sont requises. 

Ces primitives démocratisent la création de workflows et rendent les systèmes plus adaptables aux futurs cas d'utilisation. Comme elles peuvent être combinées de différentes manières, les équipes peuvent créer de nouveaux workflows d'agents sans avoir à remanier l'infrastructure sous-jacente ni à imposer à chaque ingénieur la manière dont il doit structurer son workflow. Par exemple, nous exécutons les évaluations liées à notre révision de code sur l'infrastructure Flux.

Des éléments primitifs, pas des flux de travail

Comme le montre la figure 1, Flux s'articule autour de quatre éléments fondamentaux de la plateforme : les sandbox, la passerelle MCP (Model Context Protocol), les playbooks et les interfaces d'invocation. Ensemble, ils permettent de rendre la délégation des agents reproductible. Un playbook définit la tâche à effectuer. Une sandbox cloud offre à l'agent un environnement réel pour l'exécuter. Une passerelle d'agent contrôle les systèmes auxquels l'agent peut accéder. Enfin, les interfaces d'invocation permettent aux ingénieurs de lancer et de recevoir des tâches depuis les outils qu'ils utilisent déjà.

Figure 1 : Les quatre éléments fondamentaux de la plateforme Flux — les environnements de test, la passerelle MCP, les guides opérationnels et les interfaces d’invocation — ainsi que la manière dont ils s’articulent pour transformer une tâche en un travail qu’un agent peut effectuer en toute sécurité

Les « sandboxes » fournissent l'environnement d'exécution

Les agents locaux sont efficaces pour le développement interactif, mais ils ne conviennent pas aux flux de travail sans surveillance. Ils dépendent des ordinateurs portables de chaque ingénieur, se disputent les ressources locales, sont difficiles à contrôler et ne s'adaptent pas efficacement à la multiplication des tâches en parallèle.

Flux transfère l'exécution vers des environnements de test isolés dans le cloud, s'appuyant sur des micro-machines virtuelles (microVM) Firecracker pour assurer une isolation au niveau matériel. Chaque environnement de test est provisionné avec les référentiels, les outils de développement, les secrets et les dépendances d'exécution requis par la tâche, offrant ainsi aux agents un espace de travail d'ingénierie complet tout en fournissant à DoorDash un modèle cohérent en matière d'exécution, de sécurité et d'observabilité.

La maîtrise de cette couche nous permet de prendre en charge de véritables flux de travail d'ingénierie, notamment les modifications portant sur plusieurs dépôts et les demandes de fusion multiples à partir d'une seule session. Flux vise un objectif de niveau de service (95e centile) inférieur à cinq secondes pour la configuration complète de bout en bout — du démarrage de la micro-VM au clonage des dépôts requis, en passant par l'installation des outils de build et la configuration des harnais d'agents de codage pris en charge.

La passerelle MCP offre un accès contrôlé

Les agents doivent pouvoir accéder aux systèmes que les ingénieurs utilisent au quotidien, notamment les systèmes d'intégration continue (CI), les plateformes d'observabilité, les outils de suivi des incidents, les outils de déploiement, les outils de recherche de code, la documentation et les métadonnées des services. Cependant, l'octroi d'un accès étendu et sans restriction ne doit pas être la règle par défaut.

Flux relie les agents aux systèmes internes via une passerelle MCP développée en interne, appelée « Agent Gateway ». Chaque playbook spécifie les outils dont il a besoin, et Flux n'accorde que les autorisations limitées nécessaires à cette tâche. Chaque action est consignée, ce qui permet de disposer d'une piste d'audit claire.

Cette architecture de passerelle nous offre un point de contrôle centralisé pour l'authentification, l'autorisation, la surveillance, le suivi de l'utilisation et l'application des politiques, ce qui rend l'accès aux agents à la fois plus sûr et plus facile à gérer à grande échelle.

Les guides opérationnels définissent le travail

Un « playbook » est une unité réutilisable de travail automatisé — l’équivalent d’un conteneur Docker pour les compétences et les tâches automatisées sur la plateforme Flux. Défini dans un seul fichier YAML de balisage, il regroupe la tâche, les données d’entrée, le contexte, les compétences, les outils, les autorisations, la validation, les résultats attendus et les limites de sécurité nécessaires à l’exécution cohérente du travail.

Les playbooks peuvent combiner des étapes « agentiques », qui offrent flexibilité et marge d'appréciation, avec des étapes déterministes, qui garantissent prévisibilité, coûts réduits et validation simplifiée. Cela permet aux équipes de faire évoluer la logique entre l'exécution pilotée par des agents et le code classique à mesure que les besoins évoluent, sans avoir à repenser le flux de travail.

Les interfaces d'invocation s'adaptent aux besoins des développeurs

Un même scénario peut être déclenché depuis Slack, GitHub, cron, l'interface en ligne de commande (CLI) ou une compétence conversationnelle. Cela signifie que les équipes peuvent définir un workflow une seule fois et l'exécuter depuis l'interface la mieux adaptée à la situation :

  • Slack pour la délégation collaborative
  • GitHub pour l'automatisation des pull requests et de l'intégration continue
  • Cron pour la maintenance périodique
  • Interface en ligne de commande (CLI) permettant un contrôle direct par le développeur, ou pouvant être lancée via une skill

C'est ce qui rend Flux si facile à adopter.

Enseignements tirés

La mise en place de Flux nous a autant appris sur l'adoption d'un produit que sur l'infrastructure, notamment :

  • Commencez modestement pour gagner la confiance de vos collaborateurs. Nous avons commencé par la révision automatisée du code, plutôt que d’essayer d’automatiser l’intégralité du cycle de vie du développement logiciel. La révision du code était fréquente, mesurable et facile à évaluer pour les ingénieurs. Cela nous a permis de mettre en place un workflow de production dans lequel nous pouvions optimiser la qualité, la latence, les coûts et le comportement avant de passer au triage CI, aux tâches de permanence, aux guides de maintenance et au développement piloté par les tickets.
  • Rendre le travail visible. Notre première intégration à Slack créait des canaux privés pour chaque tâche confiée à un agent. Cela rendait Flux utile pour les individus, mais ne favorisait pas l’instauration d’habitudes au sein de l’équipe. Le fait de transférer le travail vers des fils de discussion publics a changé le mode d’adoption. Les ingénieurs pouvaient voir ce que les autres avaient délégué, suivre l’avancement de Flux, examiner les résultats et renforcer la confiance mutuelle.
  • Les guides opérationnels nécessitent une mise en œuvre. Les workflows réutilisables ne se créent pas d'eux-mêmes simplement parce que la plateforme existe. Des ateliers et des hackathons ont aidé les équipes à transformer les tâches opérationnelles récurrentes en guides opérationnels. Les éléments de base ont rendu l'automatisation possible ; la mise en œuvre a aidé les équipes à identifier les workflows qui méritaient d'être codés.

Prochaines étapes

Dans nos prochains articles, nous aborderons plus en détail les éléments fondamentaux de la plateforme qui permettent à Flux de fonctionner, ainsi que l'expérience développeur pour la création de nouveaux workflows. Nous évoquerons également les applications que nous avons développées à partir de cette plateforme, notamment Flux Responder, notre agent Slack interne.

Remerciements

Nous remercions Adam Rogal, Adam Yarger, Andy Fang, Ashwin Kachhara, Fan Xia, Ivan Rudovol, Jason Prasad, Jialu Deng, Justin Block, Justin Deocampo, Justin Fan, Keith Lyall, Praneet Singh, Sean Chen, Tyler Berrett et Volanda Zhu pour leurs contributions à la plateforme et à cet article.

Restez informé grâce aux mises à jour hebdomadaires hebdomadaires

Abonnez-vous à notre blog d'ingénierie pour obtenir des mises à jour régulières sur tous les projets les plus intéressants sur lesquels notre équipe travaille. projets les plus intéressants sur lesquels notre équipe travaille
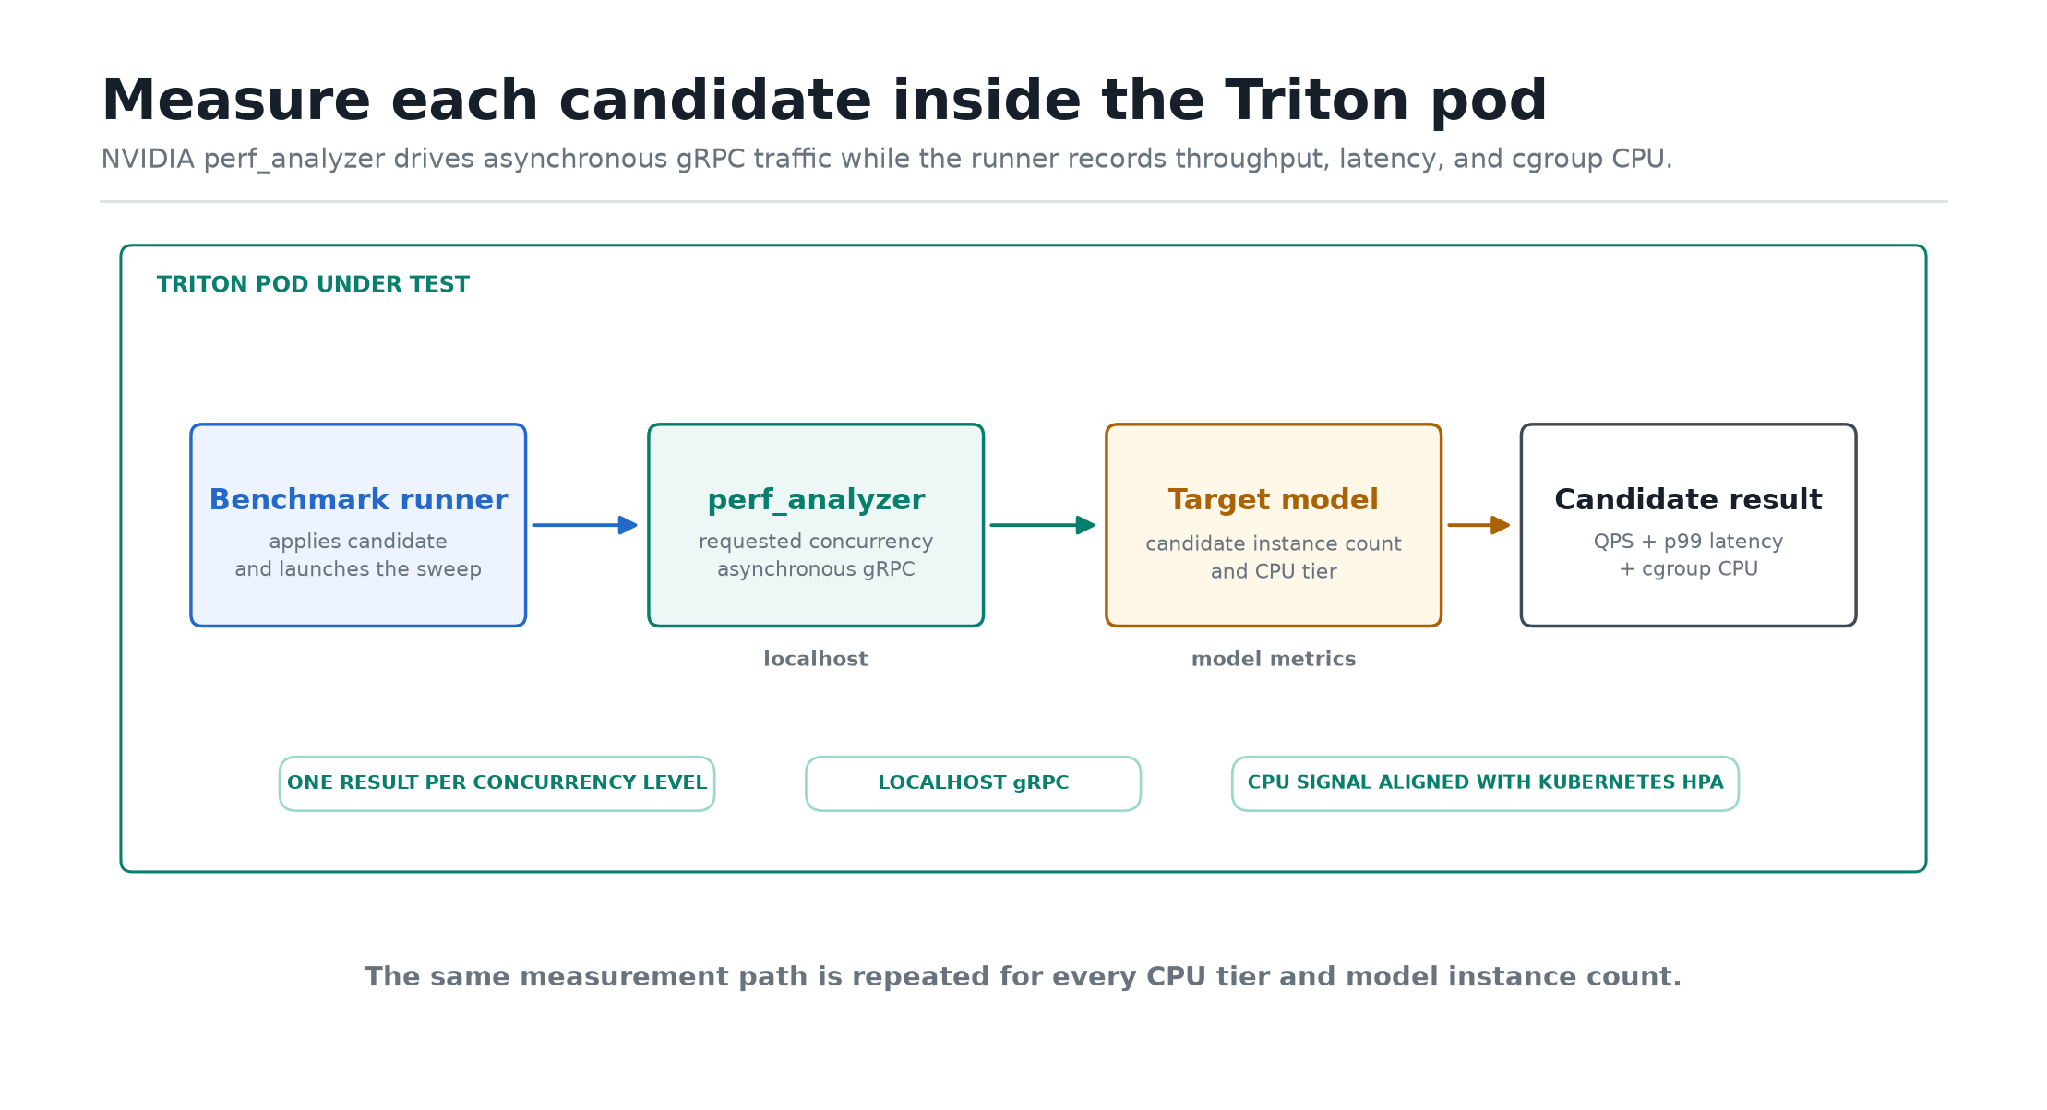
Les agents IA ne sont utiles que lorsqu’ils peuvent intervenir au sein de systèmes réels. Chez DoorDash, cela implique d’accéder à des API internes, à des systèmes d’ingénierie, à des plateformes d’observabilité, à des systèmes de gestion des tickets, à des bases de connaissances et à des produits SaaS tiers. Le protocole MCP (Model Context Protocol) a facilité l’exposition de ces outils en offrant aux agents et aux serveurs un moyen commun de décrire, de découvrir et d’invoquer des fonctionnalités.

Lorsque les agents sont passés des phases d'expérimentation à des flux de travail réels, nous nous sommes heurtés à un autre problème. Si le MCP a permis de normaliser la structure d'un appel d'outil, il n'apportait toutefois pas de réponse aux questions essentielles liées à la production concernant cet appel :

  • Quel agent est autorisé à utiliser cet outil ?
  • Au nom de quel utilisateur, de quelle équipe ou de quel service agit-il ?
  • Quels identifiants faut-il utiliser ?
  • Quel sous-ensemble d'outils l'agent devrait-il même voir ?
  • Comment peut-on révoquer un accès ?
  • Comment savoir ce qui s'est passé après l'appel ?

Ces besoins se multiplient rapidement. Un agent de développement peut avoir besoin de GitHub, de Jira, d’un moteur de recherche de code, d’une intégration continue (CI), d’observabilité et de documentation. Un serveur MCP tiers peut exposer des centaines d’outils alors qu’un workflow n’en nécessite que cinq. Un agent en contact avec les utilisateurs peut avoir besoin d’une autorisation OAuth de l’utilisateur, tandis que l’automatisation d’équipe doit utiliser une entité de service non personnelle. Si chaque équipe résout ces problèmes de manière indépendante, chaque association agent-outil se retrouve avec son propre code d’authentification, son propre flux OAuth, sa propre gestion des secrets, son propre catalogue d’outils, ses propres limites de débit et ses propres journaux.

C’est pourquoi nous avons développé une passerelle pour agents (Agent Gateway) afin d’intégrer l’accès aux outils des agents au cœur de la plateforme. Il s’agit d’un point d’entrée unique et contrôlé à partir duquel les agents peuvent découvrir et invoquer des outils. La passerelle authentifie l’appelant, vérifie son autorisation, n’expose que les outils approuvés, injecte les identifiants appropriés, achemine la requête vers le serveur MCP en aval et enregistre un événement d’utilisation structuré pour chaque appel.

La passerelle n'est pas simplement un proxy. Il s'agit du plan de contrôle de l'écosystème des agents. Elle détermine qui peut accéder aux outils, sélectionne les outils visibles par les agents, regroupe ces derniers au sein d'interfaces axées sur les tâches, et offre à DoorDash un point central pour surveiller, limiter, révoquer et optimiser l'accès des agents aux outils.

Problème : l'accès aux outils comporte trois étapes

Si MCP aide les agents à utiliser des outils, le problème le plus complexe en environnement de production comporte trois aspects :

  1. Le premier point concerne l'accès. La plateforme doit savoir qui appelle, si cette personne est autorisée et quel modèle d'authentification s'applique : identité interne, jeton géré par la passerelle, OAuth par utilisateur ou accès via une entité de service.
  2. Le deuxième point concerne la sélection des outils. Les agents ne doivent pas recevoir une liste brute de tous les outils exposés par les serveurs MCP en aval. Des catalogues plus restreints, adaptés aux tâches à accomplir, améliorent la sécurité, réduisent la confusion des modèles et facilitent l'utilisation des agents.
  3. Le troisième volet concerne les opérations. Les appels aux outils doivent être soumis à des limites de débit, et faire l'objet de traces, de métriques, d'événements d'utilisation, d'une imputation des coûts, de métadonnées de propriété et d'une visibilité en production.

Notre Agent Gateway a été conçue parce que l'accès, la gestion et les opérations doivent être regroupés au sein d'une seule et même plateforme partagée, et non dupliqués sur chaque agent et chaque serveur MCP.

Architecture de passerelle

La passerelle comporte deux éléments principaux : un proxy et un registre, comme le montre la figure 1 ci-dessous. Le proxy constitue le plan de données ; il reçoit chaque requête MCP, authentifie l’appelant, autorise l’action, applique les limites de débit, injecte les identifiants, transfère la requête et génère des données d’observabilité. Le registre est la source de vérité du plan de contrôle ; il stocke les agents, les serveurs MCP, les propriétaires, les configurations de transport, les modes d’authentification, les politiques, les catalogues d’outils détectés et les configurations de surface d’outils.

Figure 1 : Architecture générale de la passerelle d'agents

Cette séparation confère à la passerelle certaines fonctionnalités difficiles à obtenir avec des intégrations point à point :

  • Les agents utilisent un modèle de point de terminaison MCP unique et cohérent, au lieu d'avoir à mémoriser les modèles d'authentification et de routage de chaque serveur en aval.
  • Les propriétaires d'outils enregistrent leurs capacités une seule fois, y associent les droits de propriété et la politique applicable, puis consultent les données d'utilisation en production.
  • Les équipes de sécurité disposent d'un point centralisé pour contrôler les accès, révoquer les autorisations et auditer les appels.
  • Les équipes chargées de la plateforme peuvent optimiser le parcours commun une seule fois, et tous les agents bénéficieront alors de cette amélioration.

Nous séparons également les périmètres de confiance internes et externes. Les flux de travail internes de DoorDash et les cas d’utilisation des agents en contact avec l’extérieur s’exécutent via des plans de proxy distincts, avec des bibliothèques partagées et des concepts de registre communs. Cela permet de limiter la portée des incidents liés à Internet et de laisser chaque modèle d’authentification évoluer de manière indépendante.

Gestion centralisée des identités, des autorisations et des secrets

Chaque requête adressée à la passerelle est associée à un appelant : un utilisateur, un service ou un agent agissant avec un contexte utilisateur délégué. Cette identité est conservée tout au long des processus d'autorisation, d'injection d'identifiants, de routage et d'observabilité, afin que chaque action en aval puisse être attribuée à son auteur.

La passerelle vérifie l'autorisation de manière centralisée. Les critères de politique ne se limitent pas à déterminer si cet appelant peut accéder à ce serveur. Ils peuvent également porter sur :

  • Cet agent peut-il accéder à ce serveur ?
  • Cet utilisateur peut-il lancer cet outil via cet agent ?
  • Cet outil peut-il être exposé dans cet environnement ?
  • Cet appelant peut-il utiliser une variante en écriture, ou uniquement une variante en lecture seule ?
  • Ce workflow peut-il utiliser un identifiant de service d'équipe, ou nécessite-t-il une authentification OAuth par utilisateur ?

Comme la politique de sécurité est gérée au niveau de la passerelle, DoorDash dispose d’un point centralisé pour modifier et révoquer les droits d’accès. Les responsables des outils n’ont ainsi pas à reconfigurer les autorisations pour chaque serveur, et les développeurs d’agents n’ont pas à intégrer les décisions de sécurité dans les invites ou le code des applications.

La gestion des identifiants suit le même schéma, comme le montre le tableau 1 :

Mode d'authentificationQui détient ce titre ?Fonctionnement de la passerelle
Identifiant de service interneInfrastructure de DoorDashTransmet le contexte de l'appelant vérifié aux services internes
jeton détenu par GatewayStockage sécurisé des clés de passerelleInjecte un jeton de fournisseur ou de service sans l'exposer à l'agent
OAuth par utilisateurBase de données des autorisations chiffrée par utilisateurInsère et actualise le jeton de l'utilisateur pour les actions relevant de la portée de l'utilisateur
Service principalDirecteur d'écurie géré par GatewayLes « mints » ou les courtiers émettent des identifiants non personnels à durée de vie limitée

Les agents ne doivent pas détenir d'identifiants bruts, tels que des clés API de fournisseurs, des jetons de rafraîchissement OAuth ou des autorisations humaines empruntées pour les automatisations d'équipe. La passerelle garantit que ces limites restent explicites et vérifiables.

OAuth par utilisateur sans interrompre le tour de l'agent

Les outils tiers fonctionnant au niveau de l'utilisateur nécessitent l'autorisation de ce dernier. Pour consulter la documentation d'un utilisateur, créer un ticket en son nom ou mettre à jour des données SaaS pour son compte, il n'est pas possible d'utiliser une clé partagée en toute sécurité. Avant le déploiement de la passerelle, chaque équipe avait tendance à mettre en place son propre flux OAuth, son propre système de stockage des jetons et sa propre expérience « connexion en premier ».

La passerelle centralise la procédure d'autorisation OAuth. L'accès est limité à l'agent, à l'utilisateur et au serveur. Lors du premier appel nécessitant une autorisation, la passerelle lance le flux OAuth du fournisseur, stocke les jetons d'accès et de rafraîchissement chiffrés ainsi obtenus, puis injecte le jeton de l'utilisateur lors des appels suivants. Les agents n'ont jamais accès au jeton brut.

Pour les clients prenant en charge la procédure d’authentification MCP, la passerelle peut suspendre l’appel de l’outil, demander au client d’afficher une invite de connexion, puis reprendre l’appel initial une fois que l’utilisateur l’a autorisé. Pour les clients ne prenant pas en charge cette procédure, elle renvoie une réponse structurée indiquant qu’une autorisation est requise, accompagnée d’une URL de connexion, comme illustré à la figure 2. Cela permet de transformer une connexion ayant échoué en une étape récupérable de l’appel de l’outil.

Figure 2 : Procédure d'échange d'informations préliminaires

Surfaces d'outils sélectionnées : ensembles et filtrage

Les développeurs ne raisonnent pas naturellement en termes de serveurs MCP. Ils raisonnent en termes de tâches. Un développeur ne souhaite pas que GitHub, Jira, l'observabilité et la documentation constituent des étapes de configuration distinctes ; il souhaite disposer de l'ensemble d'outils nécessaires pour analyser un problème, modifier le code, ouvrir une pull request, inspecter l'intégration continue (CI) et comprendre le comportement en production.

Parallèlement, la plupart des serveurs MCP en aval exposent bien plus d’outils qu’un agent ne devrait en utiliser. Les serveurs tiers peuvent publier des centaines d’opérations, notamment des actions d’administration, des actions destructrices, des API de facturation et des fonctionnalités spécifiques à certains fournisseurs. La plupart des workflows de DoorDash n’ont besoin que d’un petit sous-ensemble approuvé de celles-ci.

La passerelle résout ces deux problèmes grâce à des interfaces d'outils sélectionnées avec soin, comme le montre la figure 3. Les ensembles regroupent des outils provenant de plusieurs serveurs MCP au sein d'un point de terminaison MCP logique unique. Des filtres déterminent quels outils de chaque serveur sont mis à disposition pour un ensemble, un agent, un groupe d'utilisateurs, un environnement ou un public donné.

Par exemple, un ensemble d'outils de développement peut comprendre :

  • une sélection d'outils GitHub pour les workflows liés aux dépôts et aux pull requests ;
  • certaines fonctionnalités de Jira permettant de rechercher et de mettre à jour les tickets ;
  • des outils d'observabilité sélectionnés pour les journaux, les métriques et les traces ;
  • certains outils de recherche de code et de documentation ; et
  • certains outils de déploiement ou de gestion des indicateurs de fonctionnalité.

Figure 3 : Expérience utilisateur avec le pack MCP intégré

L'agent se connecte à une URL de passerelle, telle qu'un point de terminaison des outils de développement. Derrière cette URL, la passerelle répartit la liste des outils (tools/list) entre les serveurs du groupe, applique les filtres d'autorisation et les filtres d'outils, attribue des espaces de noms ou des alias aux noms d'outils si nécessaire, puis renvoie un catalogue cohérent. Lorsque l'agent appelle l'interface tools/call, la passerelle applique à nouveau la politique, achemine l'appel vers le serveur en aval approprié et applique le modèle d'authentification de ce serveur.

Cela offre aux agents une interface de qualité, plutôt qu’un simple ensemble brut de fonctionnalités en aval, et inclut notamment des outils approuvés, des noms stables, des descriptions plus claires, des métadonnées de propriété et des ensembles adaptés à des publics spécifiques. Les équipes d’ingénierie, d’analyse de données, d’assistance et les ensembles externes peuvent toutes utiliser les mêmes primitives de passerelle tout en exposant différentes interfaces d’outils.

Les avantages sont concrets :

  • La configuration de l'agent est plus simple : un seul point de terminaison de passerelle au lieu de plusieurs points de terminaison de serveur.
  • La détection des outils est plus sûre : les agents ne voient que les outils situés à l'intérieur de la zone autorisée.
  • Le comportement des modèles s'améliore : des catalogues plus restreints limitent les choix non pertinents et la confusion liée aux outils.
  • L'autorisation reste centralisée : la détection et l'invocation appliquent la même politique.

C'est là que la passerelle devient bien plus qu'un simple proxy d'accès. Elle détermine ce que les agents peuvent découvrir, ce qu'ils peuvent appeler et la quantité de contexte non pertinent qu'ils transportent. Une interface d'outils soigneusement sélectionnés peut faire la différence entre un agent qui choisit le bon outil et un autre qui se perd dans un catalogue d'API trop vaste.

Observabilité, imputation des coûts et protection en aval

Comme chaque appel transite par la passerelle, chaque requête peut générer un événement structuré comprenant :

  • le serveur, l'outil, le bundle et l'équipe responsable ;
  • l'utilisateur, l'agent, le service et la plateforme impliqués dans l'appel ;
  • résultat de l'autorisation, code d'état, source de l'erreur et répartition des temps de latence ;
  • la taille des requêtes et des réponses ; et
  • les métadonnées relatives aux coûts communiquées en aval, lorsqu'elles sont disponibles.

La passerelle génère également des métriques concernant le volume de requêtes, la latence par outil, les décisions d'autorisation, les résultats des actualisations OAuth, les décisions de limitation de débit, les connexions de streaming et les défaillances en amont. La propagation des traces permet aux équipes de suivre un appel depuis l'agent jusqu'au serveur en aval, en passant par la passerelle.

Cela présente un intérêt opérationnel direct : les équipes de sécurité peuvent contrôler les accès, les équipes chargées des plateformes peuvent identifier les agents qui génèrent trop de données, les responsables des outils peuvent suivre leur adoption et repérer les erreurs, et les équipes chargées de l'infrastructure peuvent attribuer les coûts.

Ce même mécanisme protège les systèmes en aval. Les limites de débit peuvent être définies par serveur, outil, appelant, utilisateur, ensemble ou type d'appelant. Les nouvelles limites peuvent être testées en mode « shadow » avant leur mise en application, ce qui permet de voir ce qui aurait été rejeté sans perturber le trafic de production.

La passerelle transforme la gouvernance en données, au lieu de compter sur chaque équipe pour renseigner les champs appropriés et faire respecter les limites adéquates.

Intégration en libre-service

Une passerelle ne fonctionne que si les équipes préfèrent l'utiliser plutôt que de la contourner. L'enregistrement, la détection, le filtrage et la gestion des bundles doivent tous s'effectuer en libre-service.

Grâce à l'interface utilisateur et à l'API du plan de contrôle, les équipes peuvent enregistrer des serveurs et des agents MCP, configurer l'authentification, détecter des outils, attribuer des droits de propriété, définir des filtres, ajouter des outils à des ensembles et analyser l'utilisation en production.

Le processus d'intégration de la passerelle se déroule selon les étapes suivantes :

  1. Enregistrez le serveur MCP.
  2. Découvrez son catalogue d'outils bruts via tools/list.
  3. Sélectionnez et approuvez les outils que DoorDash souhaite mettre à disposition.
  4. Définir le mode d'authentification, le propriétaire et la politique.
  5. Ajoutez les outils approuvés à un ou plusieurs ensembles.
  6. Surveillez le trafic, la latence, les erreurs, les décisions d'autorisation et les coûts.

Une gouvernance qui nécessite des tickets n'est pas évolutive. La solution toute faite doit être plus simple que de copier une clé secrète dans un agent et de se connecter directement à un serveur.

Qu'est-ce qui a changé ?

La passerelle offre à chaque groupe un avantage différent :

  • Les développeurs d'agents bénéficient d'une intégration unique, d'un catalogue soigneusement sélectionné, et n'ont pas à se soucier de l'authentification en aval, de l'OAuth, de la gestion des secrets ni du routage par outil.
  • Les propriétaires d'outils bénéficient d'un parcours de distribution géré, comprenant un contrôle d'accès, une visibilité approuvée sur les outils et des données d'utilisation en production.
  • Les équipes de sécurité disposent d'une gestion centralisée des politiques, des secrets, des autorisations OAuth, des révocations et des pistes d'audit.
  • Les équipes chargées de la plateforme bénéficient d'un effet de levier ; l'identité, la limitation du débit, l'observabilité, la qualité des outils, l'imputation des coûts et l'expérience des développeurs s'en trouvent toutes améliorées, le tout depuis un seul et même endroit.
  • Les agents bénéficient de catalogues plus concis, de noms d'outils plus clairs, d'offres groupées axées sur les tâches, d'un choix réduit d'options non pertinentes et de flux de connexion récupérables.

Adoption

L'adoption est le véritable test de validité d'une plateforme : les équipes ne l'utilisent que si cela leur facilite la tâche par rapport à un accès direct. À cet égard, l'Agent Gateway est désormais la voie par défaut pour accéder aux outils des agents au sein de l'équipe d'ingénierie de DoorDash :

  • Plus de 200 serveurs MCP sont enregistrés derrière la passerelle ; ensemble, ils mettent à disposition des milliers d'outils regroupés en sous-ensembles approuvés et adaptés à des tâches spécifiques, plutôt que sous forme de catalogues bruts.
  • Plus de 30 agents et services, utilisés par des milliers de collaborateurs, accèdent à ces outils via la passerelle, et aucun d'entre eux ne traite d'identifiants bruts. 
  • Chaque semaine, des millions d'appels vers des outils transitent par l'Agent Gateway ; chacun d'entre eux est authentifié, autorisé et enregistré sous la forme d'un événement d'utilisation structuré.
  • La mise en service est rapide et s'effectue en libre-service. L'enregistrement d'un nouveau serveur MCP et de ses outils ne prend que quelques minutes, et l'association d'un agent à un outil déjà enregistré est encore plus rapide.

Enseignements tirés

La mise en place et le développement de la passerelle ont bouleversé notre façon d'envisager l'accès des agents aux outils. Plusieurs enseignements en ressortent, et pas seulement chez DoorDash :

  • MCP résout les problèmes d'appel, mais pas ceux de gouvernance. L'identité, les politiques, les secrets, la gestion, l'observabilité et la révocation constituent désormais les aspects les plus complexes.
  • Le catalogue d'outils découvert est une interface, ce qui signifie que les noms, les descriptions, les filtres, les regroupements et le public cible ont leur importance.
  • Les « bundles » constituent l'unité idéale pour les flux de travail. Les agents ont besoin de boîtes à outils axées sur les tâches, et non de listes de serveurs.
  • Le filtrage des outils améliore à la fois la sécurité et la qualité des agents en proposant un ensemble d'actions plus restreint et plus clair.
  • Les identifiants doivent être gérés au niveau de la passerelle, où ils peuvent faire l'objet d'une rotation, d'un audit et d'une révocation de manière centralisée.
  • L'absence d'autorisations OAuth correspond à des états normaux, et non à des exceptions, dans le cadre de la gestion de la connexion au sein du protocole.
  • Le parcours guidé doit être en libre-service, sinon les équipes passeront directement par d'autres canaux.

Prochaines étapes

Le prochain investissement majeur portera sur le renforcement de l'identité des agents et de la délégation des droits aux utilisateurs. Le modèle visé attribue à chaque agent une identité cryptographique et permet à la passerelle de générer des identifiants délégués à durée limitée, dont la portée est limitée à l'utilisateur, à l'agent, à la tâche et à l'outil cible. Cela permet à la piste d'audit de disposer de deux entités réelles : l'utilisateur et l'agent.

Nous investissons également dans les outils de développement, notamment les fiches d'évaluation de la qualité et de la sécurité, la vérification des descriptions d'outils présentant des risques, la détection d'informations confidentielles ou à caractère personnel dans les erreurs, la création de serveurs guidée, l'enregistrement automatique, la découverte dynamique d'outils, ainsi que les flux d'événements d'appel d'outils anonymisés à des fins d'analyse et de conformité.

La découverte dynamique s'inscrit dans la même logique. Au lieu de fournir à un agent l'ensemble des outils d'un ensemble, la passerelle peut s'appuyer sur le contexte de la tâche, la politique en vigueur et les signaux d'utilisation pour ne proposer que les outils susceptibles d'être utiles pour la tâche en cours.

Conclusion

La passerelle Agent Gateway transforme l'accès aux outils des agents, qui nécessitait auparavant un travail d'intégration répétitif, en une fonctionnalité de la plateforme partagée. Le MCP a simplifié la description et l'appel des outils ; la passerelle rend cet accès régulé, géré, observable et évolutif.

Remerciements

Introduction

Nous avons développé Ask DoorDash sur une plateforme commune qui permet aux équipes métier de créer et de faire évoluer leurs agents sans avoir à refondre les systèmes sous-jacents. Nous avons évalué cette plateforme à l'aune de deux critères concrets : la rapidité avec laquelle les équipes pouvaient ajouter des fonctionnalités et des domaines, et la rapidité avec laquelle elles pouvaient évaluer et déployer des améliorations en matière de coût, de qualité et de latence.

Nous avons lancé « Ask DoorDash » avec la prise en charge des restaurants et des épiceries en environ deux mois, et la plateforme a depuis traité plus de deux millions de conversations. L'ajout de « Réservations », notre troisième agent thématique, n'a pris qu'une semaine, soit environ dix fois plus vite que la création des premiers agents thématiques.

Notre infrastructure d’évaluation commune et nos contrôles de déploiement fournissent aux équipes des indicateurs de qualité clairs lorsqu’elles mettent en production les modifications. Moins d’une semaine après la sortie d’un nouveau LLM, nous l’avons évalué et déployé, réduisant ainsi la latence p50 de 35 % sans aucune baisse des scores de qualité. Une mise à niveau ultérieure du modèle a permis de réduire encore la latence p50 de 40 %.

Cet article explique comment nous avons déterminé les éléments à intégrer à la plateforme, comment ses composants s'articulent entre eux, ainsi que les compromis qui ont motivé ces choix. Il fait suite à notre présentation générale des aspects techniques, à notre analyse approfondie de l'intelligence et à notre analyse approfondie de l'évaluation. Une analyse approfondie de l'expérience utilisateur suivra.

Comment nous avons choisi les éléments à normaliser

Nous n'avons centralisé une fonctionnalité que lorsque plusieurs domaines en avaient besoin et que des implémentations distinctes auraient pu entraîner des problèmes de fiabilité ou d'exploitation. L'orchestration, la mémoire, l'accès aux modèles, le traçage, l'infrastructure d'évaluation et les contrôles de déploiement répondaient à ces critères. Les équipes métier ont conservé la maîtrise des instructions, des compétences, des outils, des critères d'évaluation et des choix de modèles qui définissent leurs agents.

Lorsqu'une norme industrielle adaptée existait, nous l'avons adoptée. Agent2Agent (A2A) définissait la manière dont les agents communiquaient, tandis que le Google Agent Development Kit (ADK) fournissait le cadre nécessaire à leur développement et à leur exécution. Ces normes ont parfois limité nos choix de conception, mais elles ont permis aux équipes de s'appuyer sur des contrats communs et nous ont évité de devoir développer des équivalents propriétaires.

Pour les problèmes récurrents pour lesquels il n'existait pas de norme adaptée, nous avons développé nous-mêmes les capacités nécessaires. Une régression dans le code partagé pouvant affecter plusieurs agents, des contrôles d'évaluation et de déploiement étaient indispensables. Chaque modification apportée au code partagé devait satisfaire à des contrôles de qualité communs et respecter les mesures de sécurité relatives à la mise en production.

Enquête sur l'architecture de DoorDash

Le choix architectural central consistait à déterminer ce que chaque agent devait partager et ce qui relevait de la responsabilité de chaque domaine. Nous avons mis en place un chemin d'exécution partagé autour d'agents spécialisés, propres à chaque domaine. Un agent unique à usage général serait devenu de plus en plus difficile à appréhender à mesure qu'il assumerait davantage de responsabilités, tandis que des piles d'agents totalement indépendantes auraient entraîné une duplication de l'infrastructure et généré des expériences incohérentes.

Comme le montre la figure 1, chaque requête passe par la passerelle. La passerelle authentifie l’utilisateur, assemble le contexte du point d’entrée et assure la traduction entre les interfaces HTTP et de streaming du client et le protocole A2A de la plateforme. Elle transmet ensuite la requête à l’orchestrateur, qui choisit l’agent de domaine pour chaque tour de parole tout en préservant la continuité à mesure que la conversation passe d’un domaine à l’autre. L’agent sélectionné charge les compétences appropriées et utilise les outils du Model Context Protocol (MCP) pour interagir avec les services DoorDash existants.

Au-delà de ce chemin de requête, la plateforme fournit l'état de session, la mémoire, les artefacts, l'accès aux modèles, le traçage, l'infrastructure d'évaluation et les contrôles de déploiement. Les agents de domaine utilisent ces services communs tout en conservant le contrôle de leurs instructions, de leurs compétences, de leurs outils et de leurs critères d'évaluation.

Figure 1 : Ask DoorDash distingue le comportement spécifique à chaque domaine des agents des capacités d'exécution et de production communes utilisées dans l'ensemble du système.

Une passerelle vers des expériences réactives et multimodales

Les passerelles client DoorDash ont été conçues pour des API qui renvoient rapidement une réponse complète. Les agents fonctionnent différemment. Le premier message peut être prêt alors que l’agent est encore en train d’appeler des outils, et la réponse finale peut combiner du texte avec des fiches interactives de magasins ou d’articles. Nous devions gérer ce flux de travail sans avoir à expliquer à chaque client comment les agents communiquent.

Le Gateway se charge de cette conversion. Il authentifie l'utilisateur, ajoute des informations contextuelles sur l'origine de la conversation et convertit les requêtes HTTP des clients en requêtes A2A. Lors du retour, il utilise le SDK Vercel AI pour envoyer des mises à jour textuelles et des données de widgets aux clients via le protocole SSE (Server-Sent Events). Les clients affichent ces mises à jour au fur et à mesure de leur réception, ce qui permet aux utilisateurs de suivre la progression pendant que l'agent termine son tour de conversation.

La mise en place et l'exploitation de la passerelle ont demandé du travail, mais elles ont permis de centraliser des tâches qui, sans cela, auraient fait l'objet de doublons chez chaque client de DoorDash. Les agents peuvent désormais évoluer dans le cadre d'un contrat client unique et stable, sans qu'il soit nécessaire de coordonner les mises à jour chez chaque client. Un nouvel agent de domaine réutilise le parcours d'authentification et de diffusion existant, au lieu de devoir s'intégrer séparément à chaque application.

Un assistant, des agents spécialisés dans différents domaines

Une conversation peut passer d'un domaine à l'autre sans préavis. Un utilisateur peut commencer par dire : « Je veux me faire livrer une tourte au poulet en moins de 30 minutes », puis décider : « En fait, je préfère la préparer chez moi. » La première demande relève du domaine « Restauration » et la seconde du domaine « Épicerie », mais l'expérience doit donner l'impression de ne former qu'une seule et même conversation.

Nous avons testé une architecture à agent unique, mais les domaines « Restaurant », « Épicerie » et « Réservations » s'appuient sur des outils, des politiques et des critères d'évaluation différents. Les regrouper rendrait l'agent plus difficile à tester et obligerait chaque domaine à suivre le même cycle de déploiement. Chaque domaine dispose donc de son propre agent spécialisé. L'Orchestrator analyse la conversation et achemine chaque tour de parole vers l'agent approprié via A2A.

Ce routage ajoute de la latence et des jetons d’entrée, même lorsque la conversation reste dans le même domaine. Pour réduire ce coût, l’Orchestrator attribue les tours de parole suivants à l’agent de domaine sélectionné. Cette attribution permet à cet agent de traiter directement les requêtes suivantes, sans étape de routage supplémentaire. Si la conversation change de direction, l’agent de domaine reconnaît le message hors champ et rend le contrôle à l’Orchestrator. L’Orchestrator réachemine la requête au cours du même tour, de manière transparente pour l’utilisateur.

Figure 2 : Le « pinning » évite un appel à l'Orchestrator lors des tours suivants, tout en permettant à la conversation de passer d'un domaine à l'autre.

Les compétences permettent de limiter le contexte et les coûts

Des agents spécialisés ont empêché les domaines « Restaurant », « Épicerie » et « Réservations » de partager une seule et même fenêtre de contexte gigantesque. Cependant, à mesure que chaque agent gagnait en capacités, le même problème de contexte est apparu au sein de chaque domaine. Les nouvelles fonctionnalités ajoutaient des instructions et des outils à chaque tour, même lorsque celui-ci ne les utilisait jamais. Cela a augmenté le coût en jetons de saisie, et les instructions qui se chevauchaient ou se contredisaient semaient la confusion chez l'agent.

Nous avons intégré la prise en charge des compétences à notre harnais afin de modulariser les instructions et les outils. À chaque tour, l’agent ne charge que ce qui est pertinent. Un utilisateur peut commencer par dire : « Trouve-moi un restaurant thaïlandais bien noté qui livre en moins de 30 minutes », puis ajouter : « Montre-moi le menu du premier et ajoute le pad see ew à mon panier. » Ces deux demandes sont traitées par l’agent « Restaurant », mais la première charge la compétence de recherche et de découverte, tandis que la seconde charge la compétence de commande via le panier, qui gère la consultation du menu et les actions liées au panier.

Le chargement dynamique pose un problème de sélection. Le sélecteur doit déterminer à quel moment une capacité est nécessaire sans charger trop souvent du contexte non pertinent ; c’est pourquoi nous évaluons la sélection des compétences dans le cadre du comportement de l’agent. Cette complexité supplémentaire en valait la peine, car elle a permis aux équipes d’ajouter des capacités sans avoir à élargir le contexte à chaque tour.

Pour mesurer cet effet, nous avons compté les tokens présents dans la base de l’agent et dans les instructions chargées pour les compétences. Nous avons exclu l’historique des conversations, les messages des consommateurs, les schémas d’outils et les résultats des outils. La réplique médiane relative à une compétence utilisait moins de la moitié du nombre de tokens d’instruction par rapport à la requête du système monolithique.

AgentInstructions de base et de compétences avec toutes les compétences chargéesNombre médian d'instructions liées aux compétences par tourRéduction
Restaurantenviron 42 000 jetons

environ 20 000 jetons50 % et plus
Épicerieenviron 25 000 jetonsenviron 10 000 jetons60%

Accès sécurisé et réutilisable aux services via MCP

Ask DoorDash a besoin d’accéder aux services DoorDash pour rechercher des magasins et des articles, consulter les menus, gérer les paniers et agir au nom de l’utilisateur. Les API qui sous-tendent ces opérations supposent un code d’application déterministe. Un modèle de langage de grande envergure (LLM) choisissant les opérations au moment de l’exécution a besoin d’une interface plus restreinte. Exposer directement les API obligerait le modèle à interpréter des interfaces de bas niveau. Encoder les autorisations et les règles métier uniquement dans la prompt ajouterait du contexte sans garantir leur application.

Nous avons mis en place une couche commune de protocole de contexte de modèle (MCP) entre les agents et les API DoorDash. Chaque outil MCP expose une opération spécifique comprenant les entrées et les sorties dont le modèle a besoin. C'est le modèle qui choisit l'outil à appeler. Un code déterministe valide chaque requête et applique les autorisations et les règles métier avant que l'appel n'atteigne le service sous-jacent.

Les invites aident le modèle à choisir l'opération appropriée, mais ces indications ont un caractère purement consultatif. La validation et l'application des règles s'effectuent au niveau du code de l'outil à chaque appel, ce qui garantit une limite de sécurité stable même lorsque les invites et les modèles évoluent.

La conception d’un outil requiert un certain équilibre. Un outil trop général peut proposer au modèle un choix trop vaste, tandis qu’un outil trop restreint peut transformer une tâche en une longue chaîne d’appels. Notre serveur MCP partagé propose désormais plus de 60 outils répartis entre les workflows publics et internes des agents. Un nouvel agent sélectionne les outils dont il a besoin dans cette bibliothèque, et les améliorations apportées à la validation, à la télémétrie ou à l’intégration des services profitent à tous les agents qui les utilisent.

Figure 3 : Les invites influencent ce que le modèle demande ; le code de l'outil MCP détermine ce qui peut être exécuté.

Prêt pour la production par défaut

ADK nous a fourni les éléments de base nécessaires à la création d'un agent, notamment des instructions, des outils, des callbacks, des sessions et le câblage des modèles. Les agents DoorDash avaient également besoin d'un traçage distribué, d'un accès aux modèles, d'un état durable et de contrôles de déploiement. Sans couche partagée, chaque équipe métier aurait dû prendre ces décisions et gérer l'infrastructure qui en résulte de manière indépendante.

Nous avons développé des modules réutilisables sur la base de l'ADK afin de garantir que certaines fonctionnalités fonctionnent de la même manière d'un agent à l'autre. Les équipes métier continuent de choisir leurs instructions, leurs outils et la configuration de leurs modèles. La plateforme relie ces choix aux systèmes nécessaires pour assurer un fonctionnement fiable des agents en production.

Le traçage en est un exemple. Une équipe l'active via la configuration, et le SDK partagé diffuse un identifiant de traçage à travers les appels A2A, les outils MCP et les services DoorDash en aval. Les ingénieurs peuvent suivre une requête à travers l’Orchestrator, les agents de domaine et les appels d’outils, au lieu de devoir rassembler manuellement les journaux provenant de systèmes distincts. Ces mêmes données de traçage facilitent le débogage et l’évaluation. La mise à disposition du traçage via la plateforme permet d’économiser environ un mois de travail d’observabilité pour chaque lancement d’un nouvel agent.

L'accès aux modèles repose sur le même principe. Les équipes métier choisissent les modèles utilisés par leurs agents, tandis que la plateforme uniformise la manière dont ces modèles sont invoqués, tracés et protégés par un comportement de secours. Les équipes peuvent évaluer et adopter de nouveaux modèles sans avoir à réécrire les intégrations spécifiques à chaque fournisseur. Cette approche commune a permis les mises à niveau rapides des modèles et les améliorations en matière de latence décrites précédemment.

Un état partagé pour des conversations fiables

Les premières tentatives de développement de produits basés sur des agents DoorDash en 2025 ont montré à quelle vitesse l'expérience se détériore lorsque l'état du système n'est pas fiable. Un agent pouvait répondre correctement à une requête, puis oublier ou mal utiliser les informations issues d'un échange précédent. Pour résoudre ce problème, il ne suffisait pas d'ajouter l'historique de la conversation à la consigne.

Ask DoorDash utilise trois types d'état. L'état de session permet de suivre la conversation en cours et les tâches déjà effectuées dans le cadre de celle-ci. La mémoire conserve les informations susceptibles d'être utiles lors de conversations ultérieures, telles que les préférences de l'utilisateur. Les artefacts contiennent les résultats structurés créés et mis à jour par les agents, notamment les listes de courses et les fiches interactives. Chacun d'entre eux présente une durée de vie et un mode d'accès différents.

Auparavant, les projets d’agents DoorDash mettaient en œuvre ces fonctionnalités de manière indépendante. Cela entraînait une duplication des tâches de persistance et faisait dépendre la fiabilité des choix de chaque équipe. Nous les avons centralisées au sein de Managed Agent Services, qui fournit des API compatibles avec l’ADK pour les sessions, la mémoire et les artefacts. Les agents de domaine utilisent les mêmes interfaces sans avoir à gérer leurs propres systèmes avec état.

La centralisation nécessite tout de même des règles distinctes en matière de stockage et de cycle de vie pour les données de session, la mémoire à long terme et les artefacts. Managed Agent Services regroupe ces délimitations en un seul et même endroit. Chaque domaine continue de décider quelles informations son expérience doit enregistrer et récupérer.

Les services d'agents gérés et l'architecture mémoire sont abordés plus en détail dans la deuxième partie.

Restez informé grâce aux mises à jour hebdomadaires hebdomadaires

Abonnez-vous à notre blog d'ingénierie pour obtenir des mises à jour régulières sur tous les projets les plus intéressants sur lesquels notre équipe travaille. projets les plus intéressants sur lesquels notre équipe travaille
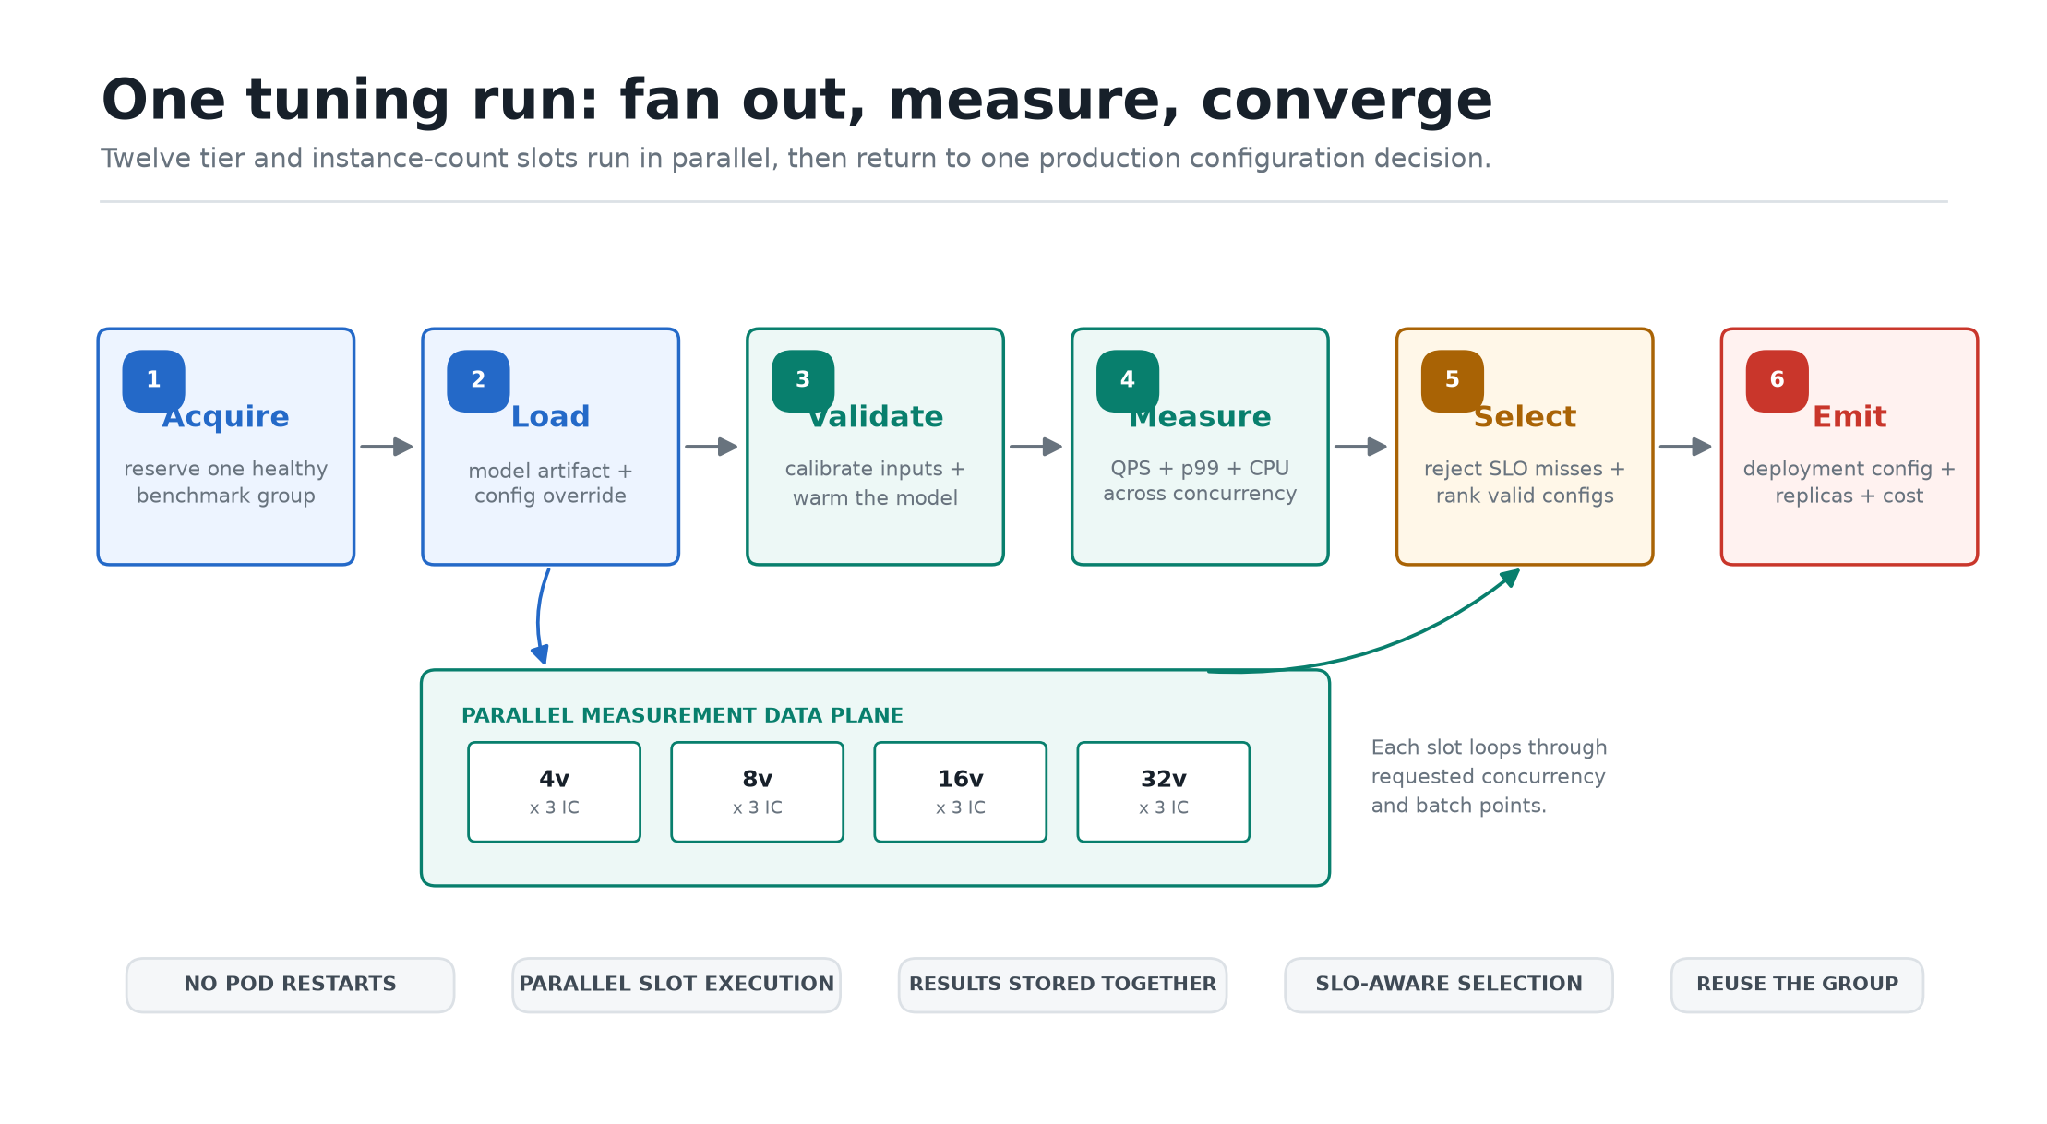
Ce que la plateforme a changé

La fonctionnalité « Réservations » a constitué un test concret de la plateforme. L'équipe a réutilisé le processus de production déjà en place pour les secteurs « Restaurant » et « Épicerie » et a lancé la prise en charge des « Réservations » en une semaine, soit environ 10 fois plus rapidement que si elle avait dû développer les agents de domaine initiaux.

Les équipes métier restent responsables du comportement des agents et des critères de qualité. La plateforme fournit l'infrastructure d'évaluation, les outils MCP, le traçage, l'accès aux modèles et les contrôles de déploiement, de sorte que les améliorations apportées à ces composants profitent à tous les agents qui les utilisent.

Le partage des infrastructures amplifie la portée des erreurs. Un défaut peut affecter plusieurs agents, et une abstraction prématurée peut contraindre différents produits à adopter le même modèle. Nous ne normalisons une fonctionnalité qu’après que plusieurs domaines en aient exprimé le besoin et que des implémentations distinctes risqueraient d’entraîner des problèmes de fiabilité ou d’exploitation.

Rejoignez-nous

Si la création à grande échelle de plateformes d'agents et d'IA destinées aux utilisateurs vous intéresse, consultez nos offres d'emploi en ingénierie sur careersatdoordash.com.